
Corso
Introduzione ai modelli Claude
3 ore
14.7K
Mistral Large 3 è un modello MoE multimodale progettato per leggere, ragionare e strutturare informazioni da documenti visivi complessi. Invece di trattare grafici e PDF come immagini statiche, è pensato per estrarre tabelle, insight e generare narrazioni curate a partire da essi.
In questo tutorial useremo il modello Mistral Large 3 (mistral-large-2512) per creare un Multimodal Intelligence Evaluation Hub in Streamlit. Il flusso è questo:
Tutto questo con un unico modello (mistral-large-2512), un unico endpoint (/v1/chat/completions) e uno stretto JSON Schema per mantenere output strutturati e affidabili.
Ti consiglio di leggere il nostro articolo su Mistral 3, che introduce le caratteristiche chiave dei nuovi modelli. Puoi anche approfondire il fine-tuning di Ministral 3 in un tutorial separato.
Mistral Large 3 è un’architettura sparse mixture-of-experts (MOE) con 41B parametri attivi su 675B totali e un vision encoder da 2,5B parametri per la comprensione delle immagini.
Ecco alcune proprietà chiave rilevanti per questo modello:
La scheda del modello e la documentazione dell’ecosistema evidenziano anche alcune avvertenze importanti:
In questa sezione costruiremo un Multimodal Intelligence Evaluation Hub usando Mistral Large 3 incapsulato in un’app Streamlit. A grandi linee, ecco cosa fa l’app finale:
mistral-large-2512, che usa response_format in modalità JSON Schema per restituire un payload JSON strutturato.Questo trasforma un report visivo statico in un assistente di intelligence interattivo alimentato interamente da Mistral Large 3.
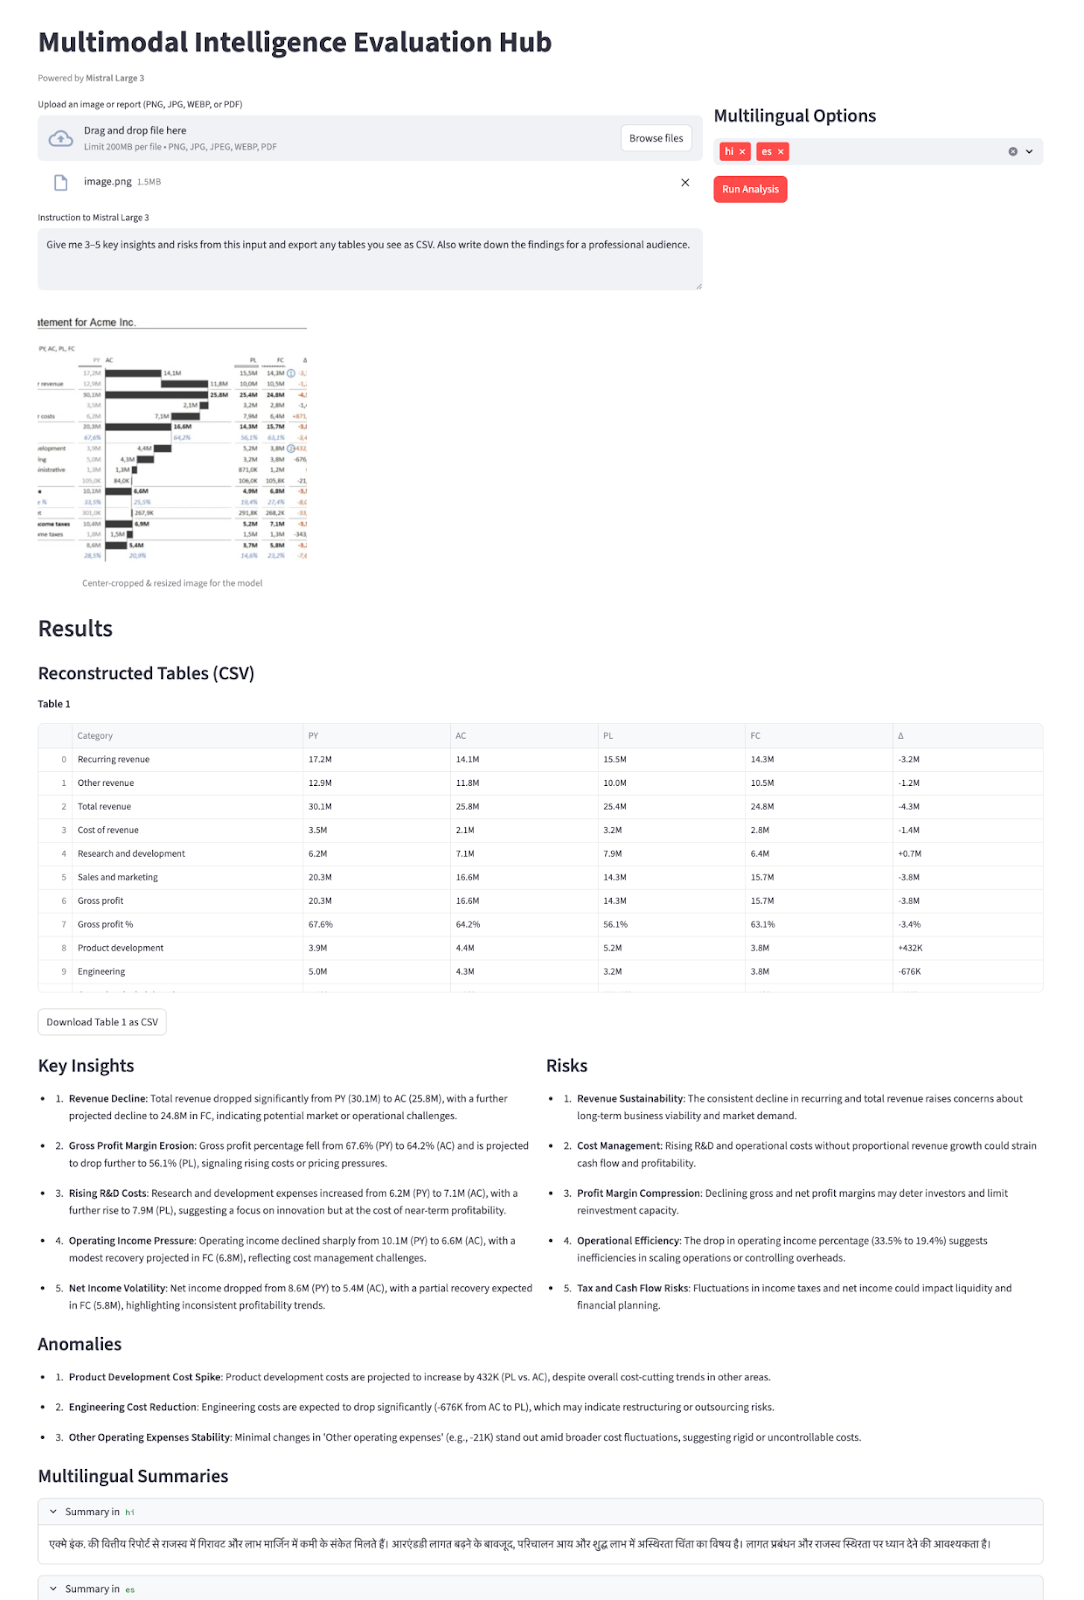
Costruiamolo passo dopo passo.
Prima di creare la nostra demo Streamlit basata su Mistral Large 3, ci serve un ambiente locale di base per dialogare con il modello tramite la Mistral API. Inizia installando alcune librerie di supporto per gestire l’interfaccia, i documenti e la configurazione.
pip install streamlit mistralai pillow pdf2image pandas python-dotenvUseremo le librerie principali sopra, come streamlit per l’UI web interattiva, mistralai per parlare con la Mistral API, pillow e pdf2image per aprire e convertire i PDF in immagini, pandas per gestire dati tabellari o log e python-dotenv per caricare in sicurezza variabili d’ambiente come MISTRAL_API_KEY da un file .env.
Poi accedi alla Mistral AI Platform e vai alla scheda API Keys .
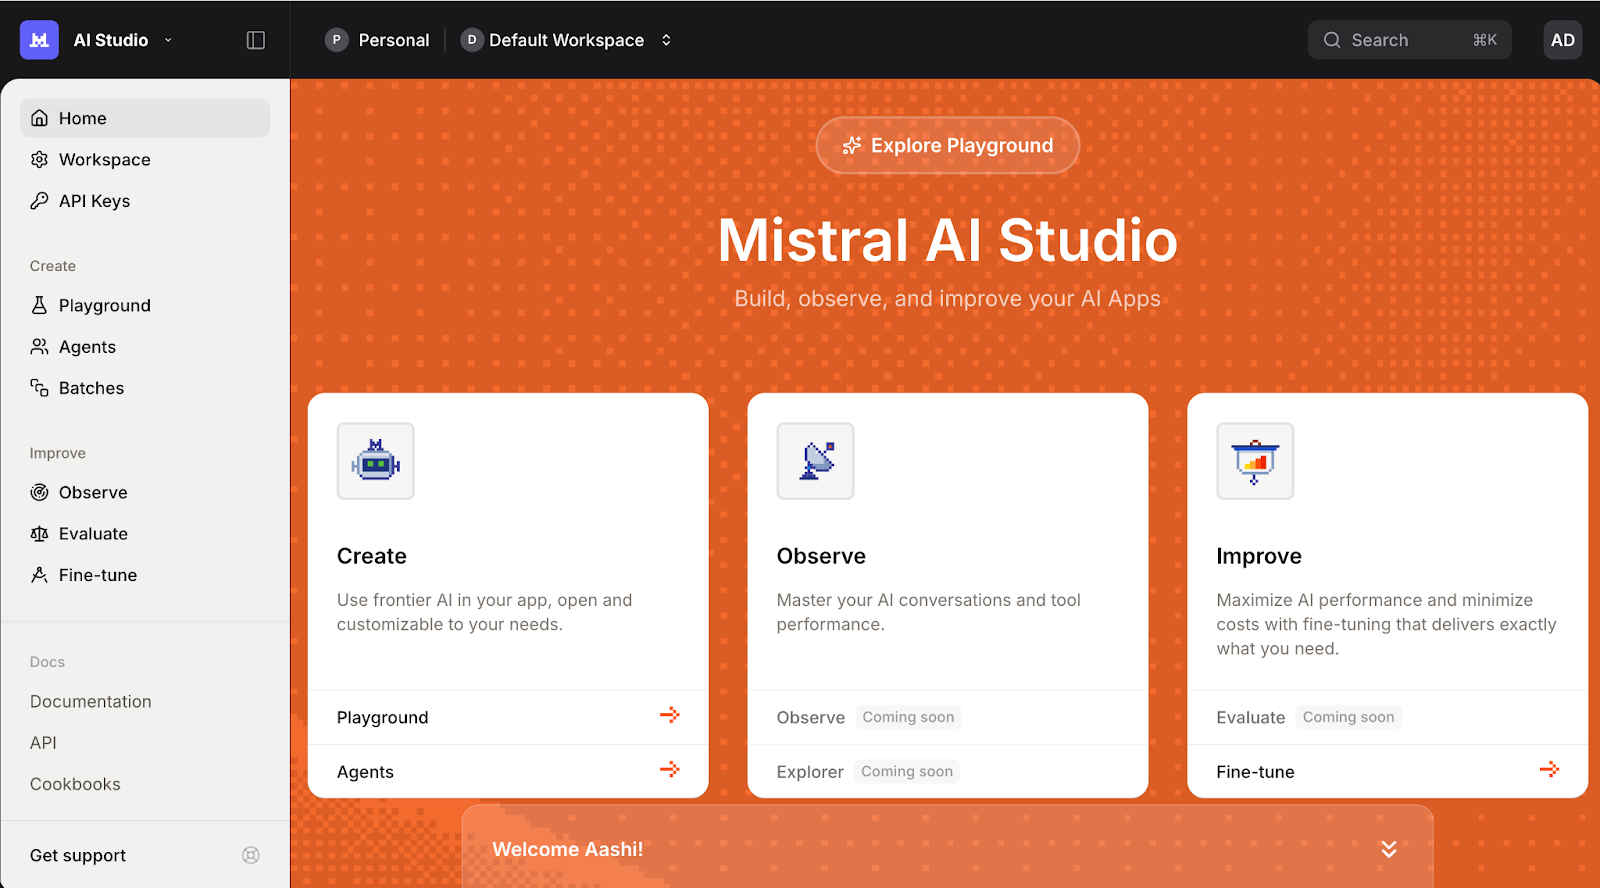
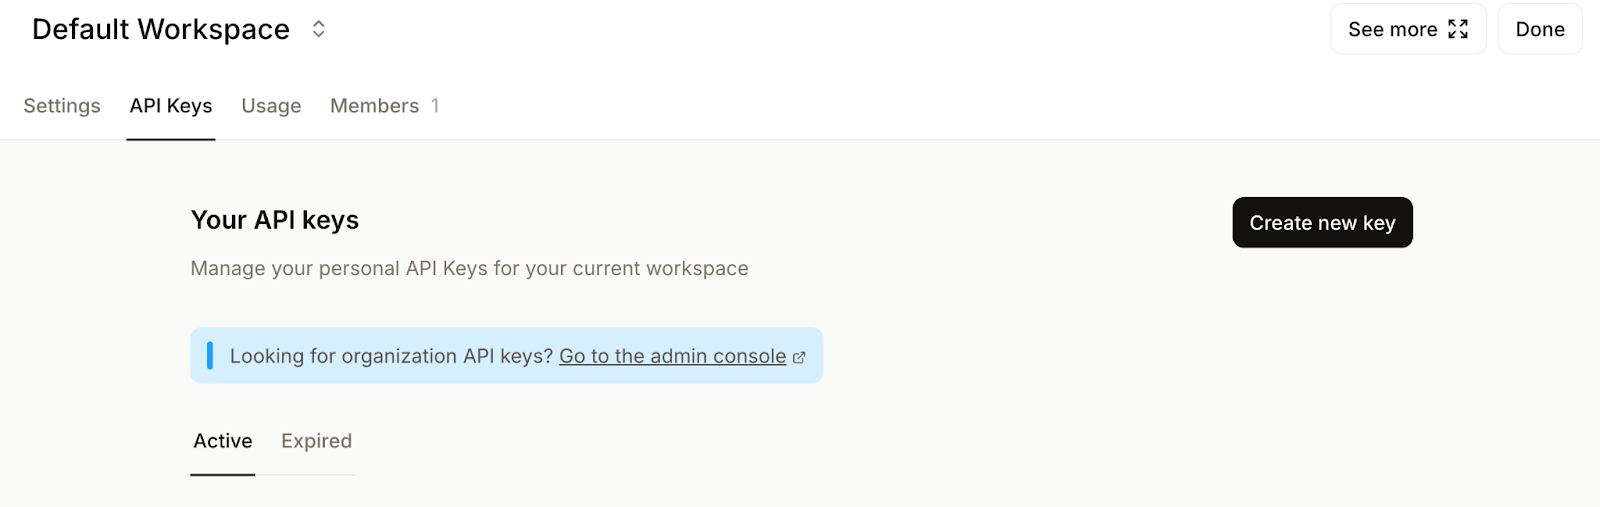
Imposta il tuo workspace predefinito (se richiesto) e fai clic su Create new key.
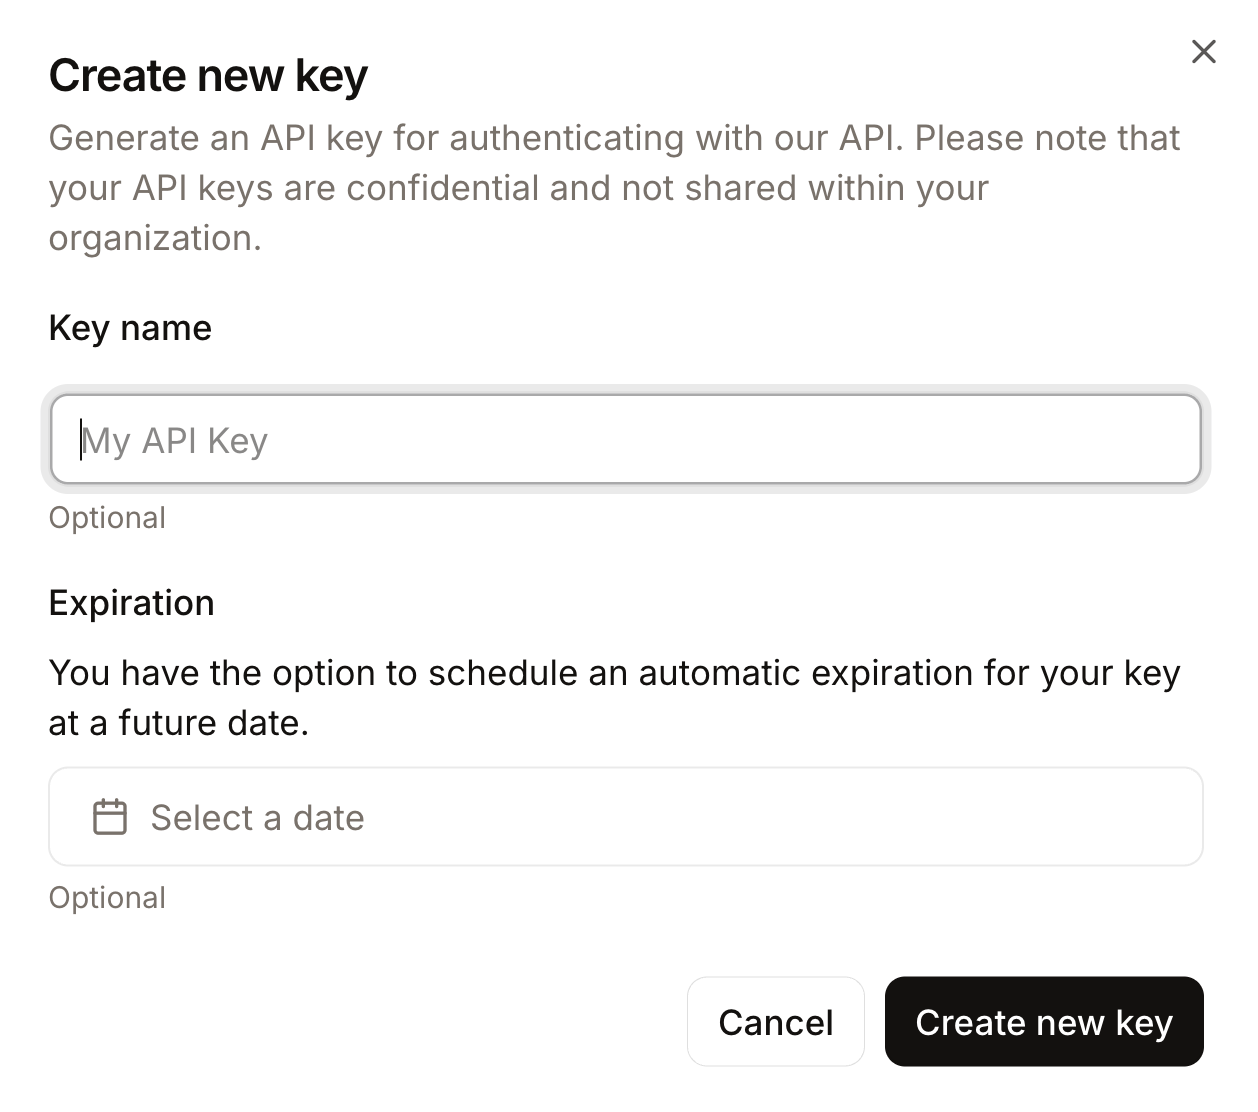
Dai alla chiave un nome significativo e, opzionalmente, imposta una data di scadenza.
Infine, copia la chiave generata ed esportala come variabile di ambiente come segue:
export MISTRAL_API_KEY="your_mistral_api_key_here"A questo punto, il nostro ambiente è pronto per autenticarsi con la Mistral API.
Con l’ambiente configurato e le dipendenze installate, il passo successivo è inizializzare il client Mistral che gestirà tutte le chiamate al modello Mistral Large 3. Questo ci fornisce un punto d’ingresso per inviare prompt dalla nostra app Streamlit a Mistral Large 3.
MISTRAL_API_KEY = os.getenv("MISTRAL_API_KEY")
MODEL_ID = "mistral-large-2512"
if MISTRAL_API_KEY is None:
    raise RuntimeError("Please set the MISTRAL_API_KEY environment variable.")
client = MistralClient(api_key=MISTRAL_API_KEY)
Il blocco di codice sopra fa tre cose:
MISTRAL_API_KEY dall’ambiente e memorizza il nome del modello in MODEL_ID, così da riutilizzarlo in tutta l’app.MistralClient usando l’SDK ufficiale mistralai, che useremo per ogni richiesta successiva al modello.Con il client inizializzato, costruiremo alcune funzioni helper che inviano prompt e gestiscono le risposte all’interno della UI Streamlit.
Prima di inviare immagini o PDF a Mistral Large 3, dobbiamo renderli “model-friendly”. La Vision API dà il meglio quando gli input sono quadrati, di dimensioni ragionevoli e codificati in un formato coerente.
Partiamo caricando l’immagine caricata e convertendola in un crop quadrato.
def load_image_from_upload(uploaded_file) -> Image.Image:
    return Image.open(io.BytesIO(uploaded_file.read())).convert("RGB")
def center_crop_to_square(img: Image.Image) -> Image.Image:
    width, height = img.size
    if width == height:
        return img
    if width > height:
        offset = (width - height) // 2
        box = (offset, 0, offset + height, height)
    else:
        offset = (height - width) // 2
        box = (0, offset, width, offset + width)
    return img.crop(box)
Il codice sopra garantisce che grafici o tabelle caricati vengano convertiti in un crop quadrato prima di passare al modello, in linea con le indicazioni di Mistral per la vision.
Successivamente, ridimensioniamo l’immagine a una dimensione massima (1024×1024) per bilanciare qualità, latenza e costo in token.
def resize_for_vlm(img: Image.Image, max_size: int = 1024) -> Image.Image:
    width, height = img.size
    scale = min(max_size / width, max_size / height, 1.0)
    if scale == 1.0:
        return img
    new_w = int(width * scale)
    new_h = int(height * scale)
    return img.resize((new_w, new_h), Image.LANCZOS)
Qui calcoliamo un fattore di scale che mantiene entrambe le dimensioni sotto max_size preservando il rapporto d’aspetto. Se l’immagine è già abbastanza piccola, la restituiamo così com’è. Altrimenti, calcoliamo le nuove dimensioni e usiamo il ricampionamento LANCZOS per un downscaling di alta qualità.
Questo passaggio evita che le immagini saturino la finestra di contesto o rallentino inutilmente le risposte.
Per i PDF, spesso vogliamo mostrare al modello più di una singola pagina. Un trucco semplice è renderizzare tutte le pagine e impilarle verticalmente in un’unica immagine alta.
def stack_images_vertically(images: List[Image.Image]) -> Image.Image:
    if not images:
        raise ValueError("No images to stack")
    target_width = images[0].size[0]
    resized_images = []
    for img in images:
        if img.size[0] != target_width:
            aspect_ratio = img.size[1] / img.size[0]
            new_height = int(target_width * aspect_ratio)
            img = img.resize((target_width, new_height), Image.LANCZOS)
        resized_images.append(img)
    total_height = sum(img.size[1] for img in resized_images)
    stacked = Image.new('RGB', (target_width, total_height))
    y_offset = 0
    for img in resized_images:
        stacked.paste(img, (0, y_offset))
        y_offset += img.size[1]
    return stacked
def uploaded_file_to_square_base64(uploaded_file) -> Tuple[str, str]:
    mime_type = uploaded_file.type
    raw_bytes = uploaded_file.getvalue()
    if mime_type == "application/pdf":
        pages = convert_from_bytes(raw_bytes)
        pages_rgb = [page.convert("RGB") for page in pages]
        img = stack_images_vertically(pages_rgb)
        img = resize_for_vlm(img, max_size=1024)
        mime_type = "image/png"
    else:
        img = Image.open(io.BytesIO(raw_bytes)).convert("RGB")
        img = center_crop_to_square(img)
        img = resize_for_vlm(img, max_size=1024)
    return mime_type, image_to_base64_data_url(img, mime_type=mime_type)
La funzione stack_images_vertically() prende una lista di immagini PIL, le normalizza a una larghezza comune preservando il rapporto d’aspetto, calcola l’altezza totale e le incolla una sotto l’altra in un unica tela RGB. La funzione uploaded_file_to_square_base64() poi decide cosa fare in base al tipo MIME:
In entrambi i casi, restituisce un’immagine normalizzata insieme a un tipo MIME per il passaggio finale di codifica.
La Vision API di Mistral accetta immagini come oggetti image_url, che possono essere URL reali o URL data:.
def image_to_base64_data_url(img: Image.Image, mime_type: str = "image/png") -> str:
    buffer = io.BytesIO()
    if mime_type == "image/jpeg":
        img.save(buffer, format="JPEG", quality=90)
    else:
        img.save(buffer, format="PNG")
        mime_type = "image/png"
    b64 = base64.b64encode(buffer.getvalue()).decode("utf-8")
    return f"data:{mime_type};base64,{b64}"
Iniziamo scrivendo l’immagine in un buffer in memoria e scegliendo un formato appropriato (come JPEG o PNG), per poi codificare in base64 i byte.
Infine, incapsuliamo la stringa codificata in un URL data:{mime_type};base64 che può essere passato direttamente alla Vision API di Mistral come image_url.
Al termine di questo passaggio, ogni file caricato, che sia un singolo PNG, una dashboard larga o un PDF multipagina, attraversa la stessa pipeline di ritaglio centrale, ridimensionamento, impilamento PDF e conversione in data URL base64.
In questo passaggio racchiudiamo tutto in un’unica funzione helper che invia una richiesta vision + testo e forza il modello a rispondere in formato JSON. Lo facciamo combinando:
response_format così che l’output sia strutturato e facile da analizzare.def call_mistral_large_multimodal(
mime_type: str,
image_data_url: str,
user_instruction: str,
languages: List[str],
) -> Dict[str, Any]:
json_schema = {
"type": "object",
"properties": {
"csv_tables": {
"type": "array",
"items": {"type": "string"},
"description": "Each item is a CSV string representing one table found in the image."
},
"insights": {
"type": "array",
"items": {"type": "string"},
"description": "Up to 5 key insights about the content."
},
"risks": {
"type": "array",
"items": {"type": "string"},
"description": "Up to 5 key risks or red flags."
},
"anomalies": {
"type": "array",
"items": {"type": "string"},
"description": "Any anomalies, outliers, or surprising patterns you detect."
},
"translations": {
"type": "object",
"properties": {
lang: {"type": "string"} for lang in languages
},
"description": "Short high-level summaries in the selected languages."
},
},
"required": ["csv_tables", "insights", "risks"],
"additionalProperties": False,
}
system_prompt = (
"You are a Multimodal Intelligence Evaluator using Mistral Large 3.\n"
"You are given a single document-like image (e.g. chart + table, financial report page).\n\n"
"Your tasks:\n"
"1. Read all visible text and numbers directly from the image.\n"
"2. Reconstruct any clearly visible tables into valid CSV strings.\n"
" - Use the first row as headers when possible.\n"
" - Use commas as separators and newline per row.\n"
"3. Derive up to 5 concise INSIGHTS about trends, patterns, or takeaways.\n"
"4. Derive up to 5 concise RISKS or red flags (business, financial, operational, etc.).\n"
"5. Detect any anomalies or surprising patterns if present (else return an empty list).\n"
"6. Provide short summaries in the requested languages.\n\n"
"You MUST respond ONLY with a JSON object that matches the provided JSON schema.\n"
"Do not include any extra commentary outside of the JSON."
)
messages = [
{
"role": "system",
"content": [
{"type": "text", "text": system_prompt},
],
},
{
"role": "user",
"content": [
{
"type": "text",
"text": user_instruction or "Analyze this financial report page.",
},
{
"type": "image_url",
"image_url": image_data_url,
},
],
},
]
response = client.chat(
model=MODEL_ID,
messages=messages,
temperature=0.2,
max_tokens=2048,
response_format={
"type": "json_schema",
"json_schema": {
"name": "multimodal_intel_eval",
"schema": json_schema,
"strict": True,
},
},
)
content = response.choices[0].message.content
try:
parsed = json.loads(content)
except json.JSONDecodeError:
try:
start = content.index("{")
end = content.rindex("}") + 1
parsed = json.loads(content[start:end])
except Exception:
raise ValueError(f"Model did not return valid JSON. Raw content:\n{content}")
return parsedLa funzione call_mistral_large_multimodal() costituisce il motore centrale della demo di intelligence multimodale.
csv_tables, insights, risks, anomalies e un oggetto translations con chiavi derivate dalla lista languages. call_mistral_large_multimodal() costruisce quindi l’array di messaggi in formato chat combinando le istruzioni di sistema con un messaggio utente che include sia le istruzioni testuali sia il payload image_url. Chiama client.chat() con MODEL_ID mantenendo la temperatura bassa per un output deterministico e response_format={"type": "json_schema",}, così la risposta rispetta lo schema. Infine, proviamo a eseguirne il parse con json.loads.
Con questo in atto, hai un punto d’ingresso robusto per trasformare un grafico o un’immagine di report grezzi in una narrazione strutturata.
Con la pipeline di preprocessing e il client Mistral pronti, l’ultimo passaggio è incapsulare tutto in un’interfaccia Streamlit.
st.set_page_config(
    page_title="Multimodal Intelligence Evaluation Hub - Mistral Large 3",
    layout="wide",
)
st.title("Multimodal Intelligence Evaluation Hub")
st.caption("Powered by **Mistral Large 3**")
col_left, col_right = st.columns([2, 1])
with col_left:
    uploaded_file = st.file_uploader(
        "Upload an image or report (PNG, JPG, WEBP, or PDF)",
        type=["png", "jpg", "jpeg", "webp", "pdf"],
    )
    default_prompt = (
        "Give me 3–5 key insights and risks from this input and export any tables you see as CSV "
        "Also write down the findings for a professional audience."
    )
    user_instruction = st.text_area(
        "Instruction to Mistral Large 3",
        value=default_prompt,
        height=120,
    )
with col_right:
    st.subheader("Multilingual Options")
    languages = st.multiselect(
        "Additional summary languages",
        options=["fr", "de", "es", "hi", "zh", "ja"],
        default=["hi"],
        help="Mistral Large 3 supports dozens of languages; these will receive short summaries.",
        label_visibility="collapsed",
    )
    run_button = st.button("Run Analysis", type="primary")
if run_button:
    if uploaded_file is None:
        st.error("Please upload an image or PDF first.")
        st.stop()
    prep_msg = "Preparing PDF (combining all pages)..." if uploaded_file.type == "application/pdf" else "Preparing image..."
    with st.spinner(prep_msg):
        mime_type, data_url = uploaded_file_to_square_base64(uploaded_file)
    mime, b64_part = data_url.split(",", 1)
    img_bytes = base64.b64decode(b64_part)
    st.image(img_bytes, caption="Center-cropped & resized image for the model", width=400)
    with st.spinner("Processing..."):
        try:
            result = call_mistral_large_multimodal(
                mime_type=mime_type,
                image_data_url=data_url,
                user_instruction=user_instruction,
                languages=languages,
            )
        except Exception as e:
            st.error(f"Error calling Mistral Large 3: {e}")
            st.stop()
    st.header("Results")
    csv_tables = result.get("csv_tables", [])
    if csv_tables:
        st.subheader("Reconstructed Tables (CSV)")
        for i, csv_str in enumerate(csv_tables):
            st.markdown(f"**Table {i+1}**")
            try:
                df = pd.read_csv(io.StringIO(csv_str))
                st.dataframe(df, use_container_width=True)
            except Exception:
                st.text_area(f"Raw CSV for Table {i+1}", value=csv_str, height=150)
            st.download_button(
                label=f"Download Table {i+1} as CSV",
                data=csv_str,
                file_name=f"table_{i+1}.csv",
                mime="text/csv",
                key=f"csv_download_{i}",
            )
    else:
        st.info("No tables were detected or reconstructed.")
    insights = result.get("insights", [])
    risks = result.get("risks", [])
    anomalies = result.get("anomalies", [])
    col_ins, col_risk = st.columns(2)
    with col_ins:
        st.subheader("Key Insights")
        if insights:
            for bullet in insights:
                st.markdown(f"- {bullet}")
        else:
            st.write("_No explicit insights returned._")
    with col_risk:
        st.subheader("Risks")
        if risks:
            for bullet in risks:
                st.markdown(f"- {bullet}")
        else:
            st.write("_No explicit risks returned._")
    st.subheader("Anomalies")
    if anomalies:
        for bullet in anomalies:
            st.markdown(f"- {bullet}")
    else:
        st.write("_No anomalies reported._")
    translations = result.get("translations", {}) or {}
    if translations:
        st.subheader(" Multilingual Summaries")
        for lang_code, summary in translations.items():
            with st.expander(f"Summary in {lang_code}"):
                st.write(summary)
    else:
        st.info("No multilingual summaries were requested or returned.")
    # Raw JSON (debug)
    # with st.expander(" Raw JSON (debug)"):
    #     st.json(result)
Il codice UI di Streamlit sopra fa alcune cose chiave:
Il metodo st.set_page_config divide il layout in due colonne. La parte sinistra gestisce gli input principali (caricamento file e un’area di testo modificabile con istruzioni predefinite). La parte destra offre invece opzioni multilingue tramite st.multiselect e un pulsante principale Run Analysis. Quando si fa clic sul pulsante, l’app verifica che sia presente un file, converte immagini o PDF in un data URL base64 e mostra l’anteprima dell’immagine.
Quando arriva un risultato, le tabelle CSV ricostruite vengono renderizzate come dataframe, insieme a insight, rischi, anomalie ed eventuali riepiloghi multilingue. Facoltativamente, possiamo anche abilitare viste di debug (commentate) per ispezionare il JSON grezzo durante lo sviluppo.
Con questo passaggio completato, puoi salvare tutto come app.py e lanciare l’esperienza completa con:
streamlit run app.pyNel video qui sotto puoi vedere una versione ridotta del workflow in azione con input sia immagine sia PDF:
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



