

Menyiapkan Lingkungan
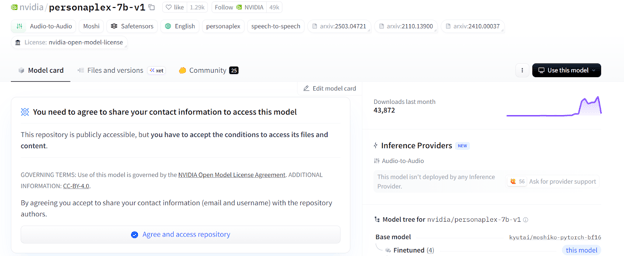
Sebelum mulai, kunjungi halaman model Hugging Face untuk nvidia/personaplex-7b-v1 dan setujui ketentuan penggunaan model.
PersonaPlex adalah model berpintu (gated), jadi Anda memerlukan token API Hugging Face. Hasilkan token dari akun Hugging Face Anda dan simpan, karena nanti kita akan menambahkannya ke variabel lingkungan untuk mengakses model.
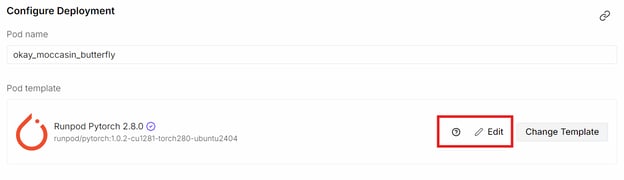
Berikutnya, buka RunPod dan luncurkan GPU A40 baru. Pilih image PyTorch terbaru, lalu klik Edit untuk menyesuaikan lingkungan.
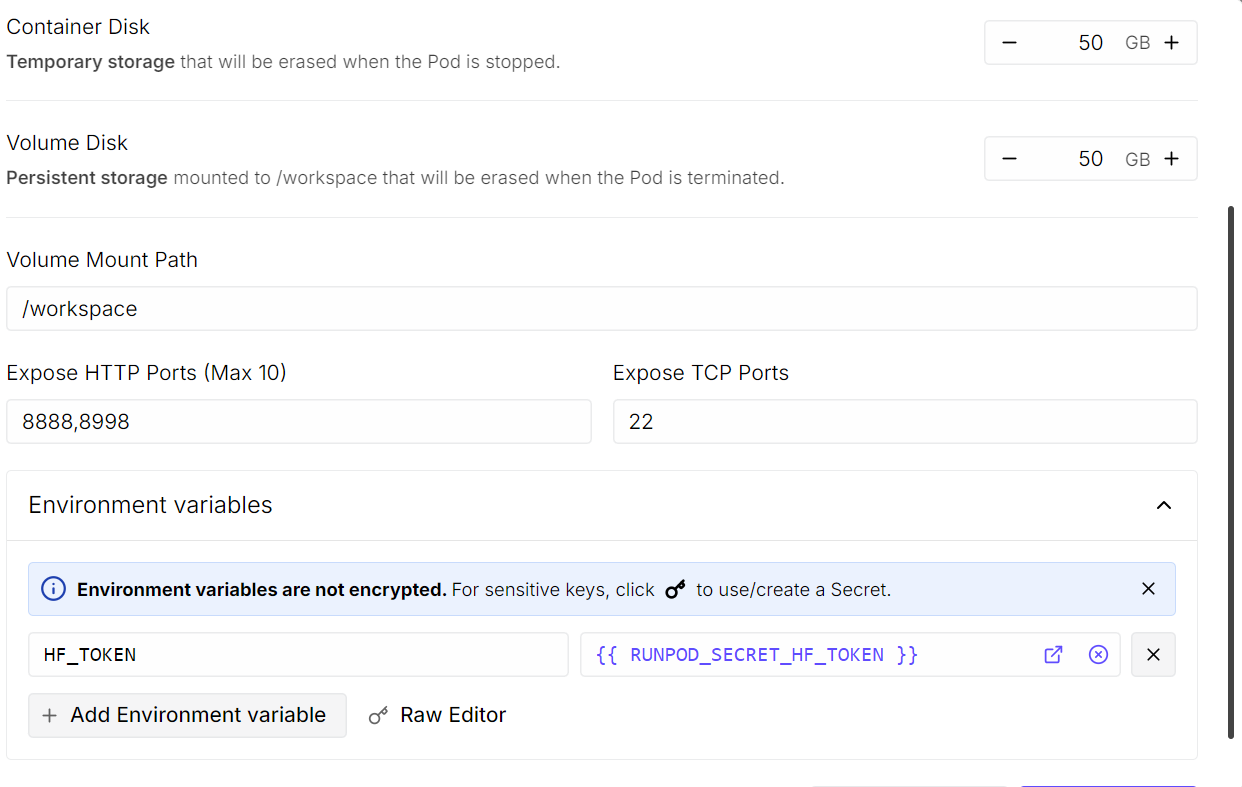
Tingkatkan ukuran disk container menjadi 50 GB, karena ukuran model sekitar 20 GB, dan dependensi tambahan juga akan diunduh. Pada bagian exposed HTTP ports, tambahkan port 8998. Di bawah variabel lingkungan, tambahkan HF_TOKEN dan tempel token API Hugging Face Anda.
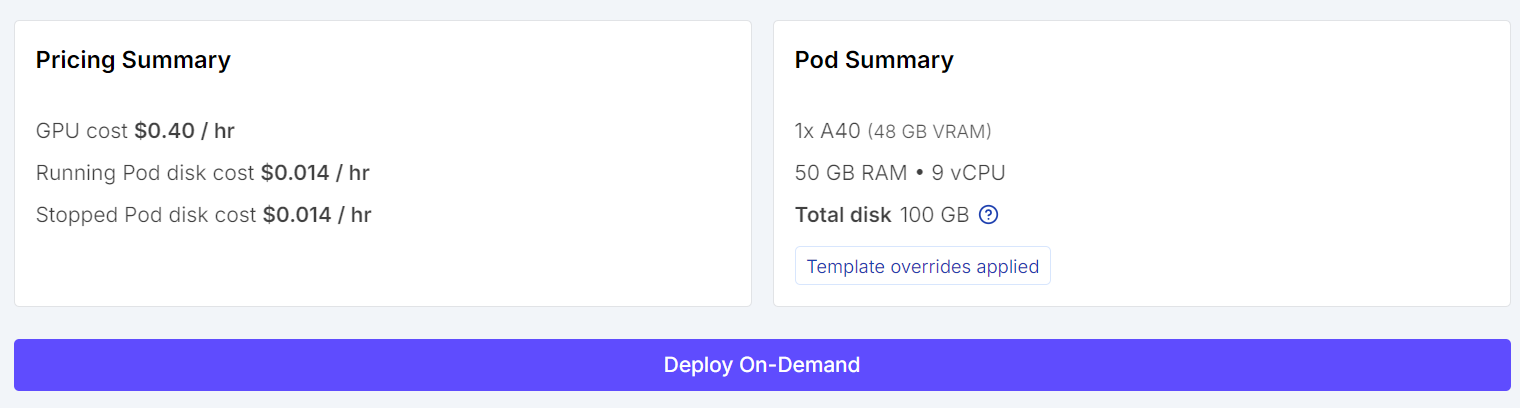
Setelah semuanya dikonfigurasi, simpan override dan deploy pod.
Setelah pod berjalan, Anda akan melihat tautan ke instance JupyterLab. Buka, lalu luncurkan terminal. Anda bisa mengakses mesin melalui SSH atau terminal web, namun menggunakan terminal Jupyter adalah opsi paling sederhana.
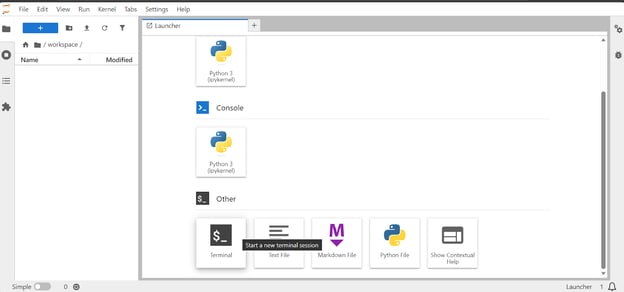
Di terminal, pasang library pengembangan codec audio Opus yang diperlukan untuk pemrosesan audio:
sudo apt update
sudo apt install libopus-dev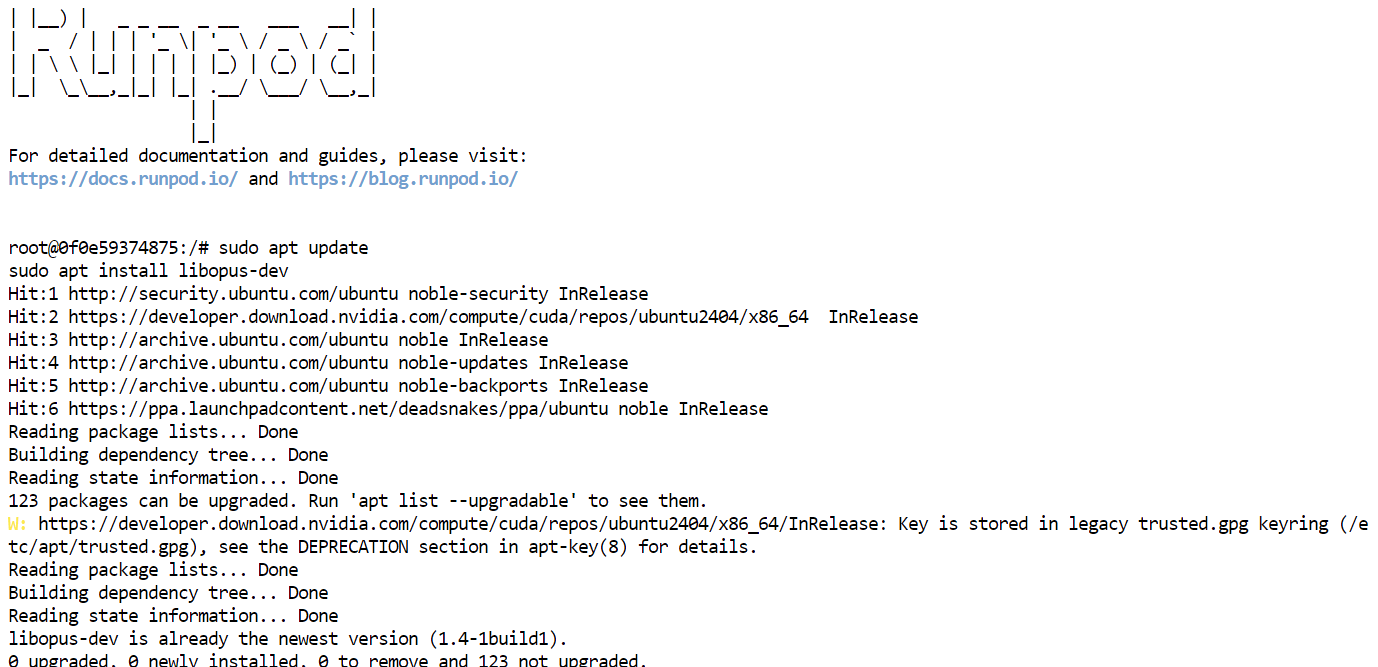
Memasang PersonaPlex Dari Sumber
Basis kode PersonaPlex bersifat open-source oleh NVIDIA dan tersedia di GitHub (NVIDIA/personaplex: Kode PersonaPlex), sehingga mudah dieksplorasi, disesuaikan, dan dijalankan secara lokal.
Memasang dari sumber memberi Anda kontrol penuh atas penyiapan dan memastikan kompatibilitas dengan pembaruan terbaru di repositori.
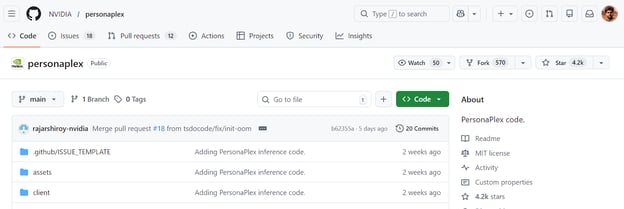
Untuk memulai, klon repositori PersonaPlex:
git clone https://github.com/NVIDIA/personaplex.git
cd personaplex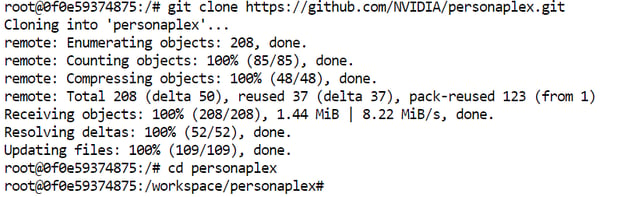
Lalu pasang Moshi, model percakapan full-duplex inti yang menjadi dasar PersonaPlex.
Moshi bertanggung jawab untuk mendengarkan dan berbicara secara real-time, memungkinkan PersonaPlex menangani interupsi, jeda, dan timing percakapan yang natural tanpa bergantung pada pipeline ASR → LLM → TTS tradisional.
Memasangnya dari sumber memastikan semua komponen audio, streaming, dan percakapan tersiapkan dengan benar untuk eksekusi lokal.
pip install moshi/.Setelah Moshi terpasang, lingkungan Anda siap sepenuhnya untuk memulai server PersonaPlex dan mulai berinteraksi dengan model secara real-time.
Menjalankan Server WebUI PersonaPlex
Dengan lingkungan dan dependensi yang telah siap, Anda kini dapat menjalankan server WebUI PersonaPlex. Di terminal, jalankan perintah berikut untuk meluncurkan server Moshi yang menjadi tenaga pendorong PersonaPlex:
python -m moshi.server --host 0.0.0.0 --port 8998Saat pertama kali menjalankan perintah ini, server akan otomatis mengunduh model PersonaPlex dan berkas lain yang diperlukan. Langkah ini dapat memakan waktu beberapa menit, tergantung kecepatan jaringan Anda, karena ukuran model cukup besar.
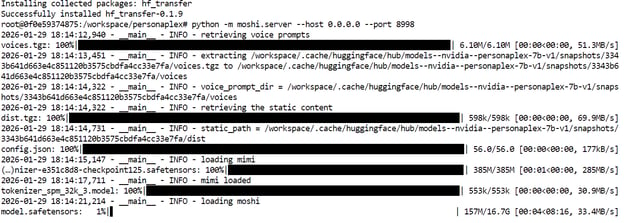
Setelah unduhan selesai, server akan mulai mendengarkan pada port 8998.
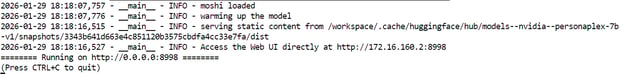
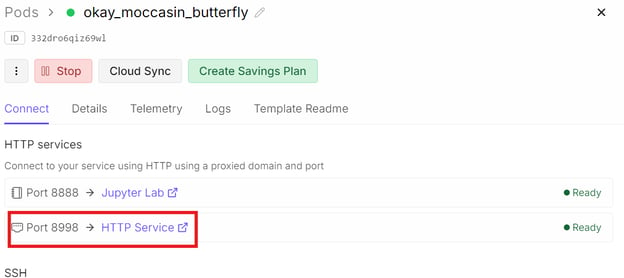
Untuk mengakses WebUI, kembali ke dasbor RunPod Anda.
Di bagian Connect, temukan port 8998 yang diekspos dan klik tautan yang tersedia. Ini akan membuka WebUI PersonaPlex di browser Anda, tempat Anda dapat mulai berinteraksi dengan model melalui percakapan suara real-time.
Menguji PersonaPlex Menggunakan WebUI
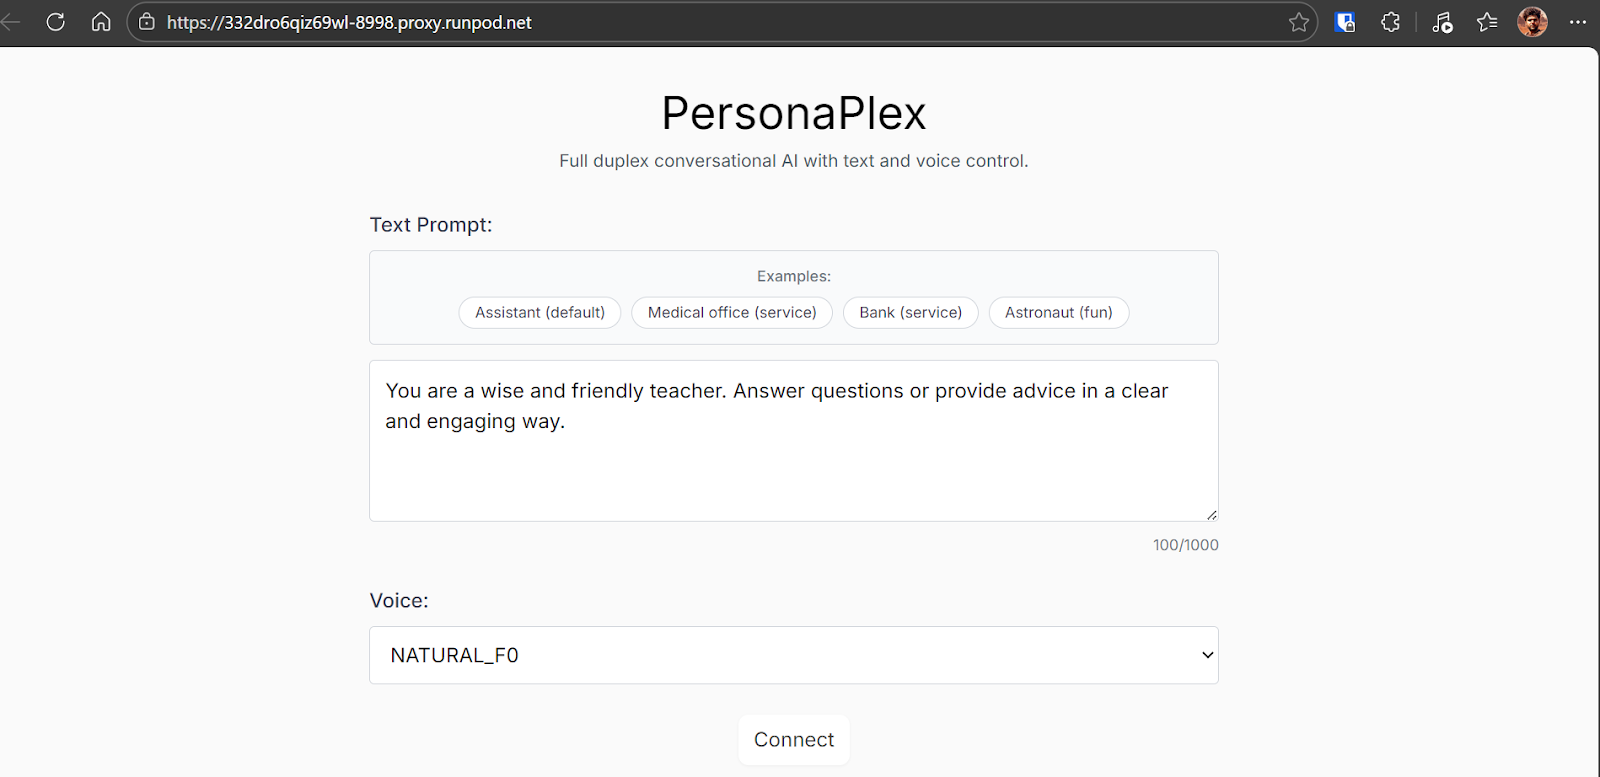
WebUI PersonaPlex hadir dengan beberapa contoh prompt untuk membantu Anda memulai, dan Anda juga dapat membuat prompt kustom untuk mendefinisikan peran dan perilaku asisten.
Anda dapat memilih suara sebelum terhubung, yang menentukan seperti apa persona terdengar selama percakapan.
Untuk tutorial ini, sebaiknya mulai dengan pengaturan default agar Anda dapat merasakan sistemnya.
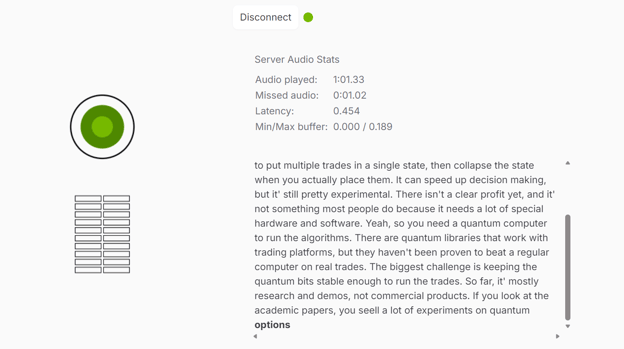
Setelah mengklik tombol Connect, Anda akan dibawa ke sesi interaktif. Di sini, Anda dapat berbicara langsung dengan model, mendengar responsnya secara real-time, dan melihat transkrip langsung percakapan saat berlangsung.
Pengalamannya terasa cair, dengan timing yang natural dan kemampuan untuk menyela atau merespons dengan cepat.
Selama pengujian, interaksinya terasa sangat natural dan menarik.
Saya memang melihat sesekali gagap, yang kemungkinan disebabkan beban browser atau sistem, bukan modelnya sendiri. Selain itu, percakapan terasa sangat mirip berbicara dengan orang sungguhan.
Setelah Anda nyaman, cobalah bereksperimen dengan berbagai prompt dan suara. PersonaPlex mendukung beragam embedding suara siap pakai, termasuk suara percakapan yang lebih natural dan varian yang lebih ekspresif:
- Natural (perempuan): NATF0, NATF1, NATF2, NATF3
- Natural (laki-laki): NATM0, NATM1, NATM2, NATM3
- Varian (perempuan): VARF0, VARF1, VARF2, VARF3, VARF4
- Varian (laki-laki): VARM0, VARM1, VARM2, VARM3, VARM4
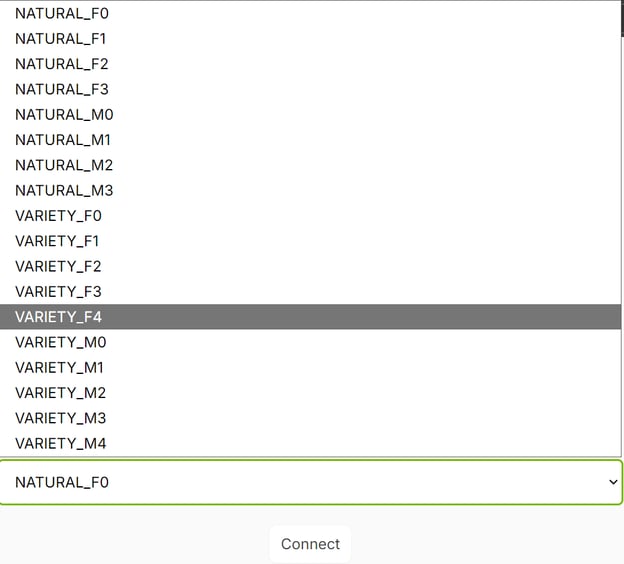
Berganti suara dan prompt adalah cara yang bagus untuk mengeksplorasi bagaimana PersonaPlex mempertahankan kepribadian, nada, dan alur percakapan di berbagai peran dan gaya bicara.
Menjalankan PersonaPlex Offline Dengan Python
WebUI sangat bagus untuk percakapan real-time, tetapi Anda juga bisa menjalankan PersonaPlex secara offline dari Python. Ini berguna saat Anda menginginkan keluaran yang dapat diulang, ingin menguji berbagai prompt dengan cepat, atau ingin menghasilkan berkas audio yang bisa digunakan ulang dalam demo dan eksperimen.
Alurnya sederhana: Anda menyediakan (1) prompt suara, (2) prompt teks, dan (3) berkas WAV masukan. PersonaPlex kemudian menghasilkan respons audio keluaran dan berkas JSON yang berisi transkrip model.
Mulai notebook baru di Jupyter dan ubah direktori ke repositori yang telah diklon:
%cd personaplexJalankan berikut ini di sel baru. Perintah ini memanggil offline runner dan menulis audio yang dihasilkan serta transkrip ke disk:
%%capture
!python -m moshi.offline \
--voice-prompt "NATF2.pt" \
--text-prompt "You are a wise and friendly teacher. Answer questions in a clear, engaging way." \
--input-wav "assets/test/input_assistant.wav" \
--seed 42424242 \
--output-wav "out_teacher.wav" \
--output-text "out_teacher.json"Fungsi setiap flag:
--voice-promptmemilih embedding suara (di sini, suara perempuan natural).--text-promptmendefinisikan peran dan perilaku asisten.--input-wavadalah audio pengguna yang direkam dan akan direspons oleh model.--seedmembuat keluaran lebih dapat direproduksi antar-run.--output-wavadalah respons lisan yang dihasilkan.--output-textmenyimpan keluaran transkrip sebagai JSON.
Setelah perintah selesai, Anda dapat memutar audio respons secara langsung:
from IPython.display import Audio
Audio("out_teacher.wav")Anda akan mendengar respons yang jelas dan natural dalam suara yang dipilih, sesuai dengan persona yang ditetapkan pada prompt teks.
Transkrip JSON terkadang mengandung artefak tokenisasi seperti spasi berlebih di sekitar tanda baca atau potongan kata yang terbelah. Helper di bawah ini memuat JSON dan membersihkannya menjadi teks yang mudah dibaca.
import json
import re
with open("out_teacher.json") as f:
data = json.load(f)
def detokenize(tokens):
# 1) drop padding-like tokens
drop = {"PAD", "EPAD", "<pad>", "</s>", "<s>"}
toks = [t for t in tokens if t not in drop]
# 2) join with spaces first
s = " ".join(toks)
# 3) fix spacing around punctuation
s = re.sub(r"\s+([.,!?;:])", r"\1", s)
# 4) fix common split contractions: "it ' s" -> "it's"
s = s.replace(" ' s", "'s").replace(" n't", "n't").replace(" 're", "'re").replace(" 'm", "'m").replace(" 've", "'ve").replace(" 'd", "'d")
# 5) fix stray spaces around apostrophes
s = re.sub(r"\s+'\s+", "'", s)
# 6) fix cases like "for k" -> "fork" and "fl uff" -> "fluff"
# (general rule: merge single-letter fragments if they look like split wordpieces)
s = re.sub(r"\b([A-Za-z])\s+([A-Za-z]{1,3})\b", r"\1\2", s)
# 7) collapse multiple spaces
s = re.sub(r"\s{2,}", " ", s).strip()
return s
clean_text = detokenize(data) # replace with your list variable
clean_textSekarang Anda akan melihat string transkrip yang mudah dibaca dan sesuai dengan audio yang dihasilkan. Jika keluaran Anda masih berisi pemenggalan aneh (misalnya, “fl uff” atau “afor k”), itu wajar pada beberapa run dan dapat dibersihkan lebih lanjut dengan aturan tambahan, tetapi konten utamanya seharusnya sudah bisa dipahami.
"Hey, let me know if you have any questions.
Hmm, first rinse the rice a couple of times until the water runs clear, that cuts down on starch, then use apot with a tight fitting lid, bring to a boil,
give it a quick stir, then turn the heat down low and cover, let it s immer without lifting it, and when it'done fl uff it with afor k, that usually
You could to ss the hot rice with a nice handful of chopped fresh herbs like basil or par sley, or you could sprinkle a little g rated cheese,
a squeeze of lemon or lime, adr izzle of olive oil, some chopped fresh herbs, or even some to ast ed nuts, that adds color and flavor."Pemikiran Akhir
Menguji PersonaPlex benar-benar mengejutkan saya. Dari interaksi pertama, rasanya bukan seperti bereksperimen dengan model, melainkan seperti melakukan percakapan nyata. Kemampuan untuk menyela secara natural, mendapat respons instan, dan mempertahankan kepribadian yang konsisten sepanjang percakapan membuatnya terasa jauh lebih maju daripada kebanyakan sistem suara yang pernah saya coba. Menjalankan semuanya secara lokal membuat pengalaman semakin mengesankan, tanpa jeda yang terasa atau hilangnya kendali.
Masih ada beberapa kekurangan. Saya melihat sesekali gagap, dan saat percakapan berlanjut, sistem tidak selalu mulus saat kembali ke topik sebelumnya.
Sistem ini juga belum sepenuhnya memahami aksen non-Inggris, yang dapat menyebabkan pelafalan nama yang keliru atau transkripsi yang kurang sempurna. Ini terasa seperti kasus tepi alih-alih masalah mendasar, dan saya yakin hal-hal ini akan cepat membaik.
Saya yakin ke depan masalah-masalah ini akan teratasi, dan kita akan mendapatkan AI percakapan yang lebih baik lagi, sepenuhnya lokal dan real-time, yang menggabungkan kemampuan penalaran GPT-5.2 dengan kualitas suara ElevenLabs.
FAQ PersonaPlex
Perangkat keras apa yang saya butuhkan untuk menjalankan PersonaPlex secara lokal?
NVIDIA merekomendasikan GPU dengan setidaknya 24 GB VRAM (seperti A10G, A40, atau RTX 3090/4090) untuk menjalankan model 7B dengan mulus dan latensi rendah. Anda juga memerlukan lingkungan Linux dengan dukungan CUDA. Walaupun dimungkinkan untuk mengalihkan sebagian layer ke CPU, hal ini akan sangat menurunkan performa real-time yang menjadi keunggulan model ini.
Apakah PersonaPlex dapat berbicara dalam bahasa selain bahasa Inggris?
Saat ini, rilis v1 hanya mendukung bahasa Inggris. Arsitekturnya mendukung banyak bahasa, dan NVIDIA menyatakan dukungan untuk bahasa lain (seperti Spanyol) ada dalam rencana pembaruan mendatang, namun untuk sekarang, model dioptimalkan untuk percakapan bahasa Inggris.
Bisakah saya menggunakan ini untuk aplikasi komersial?
Ya. Bobot model dirilis di bawah NVIDIA Open Model License, yang umumnya mengizinkan penggunaan komersial. Namun, Anda sebaiknya meninjau perjanjian lisensi spesifik pada kartu model Hugging Face untuk memastikan kasus penggunaan Anda (misalnya, menyelenggarakan layanan berbayar) mematuhi ketentuan mereka.
Apa bedanya ini dengan menggunakan faster-whisper dan LLM cepat?
Sistem tradisional bersifat "half-duplex"—mereka menunggu Anda selesai berbicara, menyalin audio, berpikir, lalu berbicara. PersonaPlex bersifat "full-duplex," artinya memproses audio dan menghasilkan token secara berkelanjutan. Ini memungkinkan sistem untuk mendengarkan sambil berbicara, menangani interupsi secara natural, dan menghasilkan backchannel ("uh-huh", "right") tanpa latensi canggung dari sistem berbasis giliran.
Mengapa model terkadang salah melafalkan nama atau memecah kata dalam transkrip?
Karena PersonaPlex melakukan streaming token audio dalam frame real-time (24kHz), token teks terkadang dihasilkan melintasi frame yang terpisah. Ini dapat menghasilkan artefak seperti "fl uff" atau "afor k" dalam transkrip mentah. Ini adalah efek samping normal dari tokenisasi streaming dan dapat dibersihkan dengan skrip pascapemrosesan sederhana.

Sebagai data scientist tersertifikasi, saya bersemangat memanfaatkan teknologi mutakhir untuk menciptakan aplikasi machine learning yang inovatif. Dengan latar belakang kuat di pengenalan ucapan, analisis dan pelaporan data, MLOps, conversational AI, dan NLP, saya mengasah keterampilan dalam mengembangkan sistem cerdas yang berdampak nyata. Selain keahlian teknis, saya juga komunikator andal yang mampu menyederhanakan konsep kompleks menjadi bahasa yang jelas dan ringkas. Karena itu, saya menjadi blogger yang dicari di bidang data science, membagikan wawasan dan pengalaman kepada komunitas profesional data yang terus berkembang. Saat ini, saya berfokus pada pembuatan dan penyuntingan konten, bekerja dengan large language model untuk mengembangkan konten yang kuat dan menarik agar membantu bisnis dan individu memaksimalkan data mereka.



Jika Anda pernah menggunakan ChatGPT dalam mode suara, Anda sudah tahu betapa mengesankannya. Berbicara dengan AI yang mendengarkan, memahami, dan merespons hampir seperti orang sungguhan bisa terasa sangat natural. Terasa seperti percakapan, cerdas, dan responsif. Namun masih ada celah. Sedikit jeda, penanganan interupsi yang terbatas, dan perasaan bahwa Anda tetap berbicara dengan sebuah sistem, bukan seseorang.
Sekarang bayangkan sesuatu yang lebih baik. Di sinilah PersonaPlex hadir.
Bayangkan asisten suara real-time yang merespons seketika, memungkinkan Anda menyela secara natural, beradaptasi di tengah kalimat, dan terasa jauh lebih dekat dengan percakapan manusia sesungguhnya. Tanpa latensi yang terasa. Tanpa jeda canggung. Tanpa ketergantungan cloud. Hanya dialog lokal, real-time, yang mulus dan terasa hidup.
PersonaPlex adalah sistem interaksi suara real-time dan lokal yang dikembangkan oleh NVIDIA. Sistem ini dirancang untuk mendorong AI berbasis suara melampaui pipeline sederhana speech-to-text dan text-to-speech. Sebaliknya, PersonaPlex memungkinkan percakapan streaming berlatensi rendah di mana asisten dapat berbicara, mendengarkan, dan beradaptasi secara berkelanjutan, layaknya orang sungguhan dalam percakapan tatap muka.
Dalam tutorial ini, saya akan memandu Anda melalui PersonaPlex langkah demi langkah. Kita akan mulai dengan memahami apa itu PersonaPlex dan mengapa rasanya sangat berbeda dari asisten suara pada umumnya. Lalu, kita akan menyiapkan lingkungan lokal, memasang PersonaPlex dari sumber, dan menjalankan server WebUI PersonaPlex. Setelah itu, kita akan berinteraksi dengan sistem melalui antarmuka web dan akhirnya menguji percakapan suara real-time menggunakan skrip Python.
Saya menyarankan Anda melihat kursus Spoken Language Processing in Python untuk mempelajari beberapa dasar di balik PersonaPlex.
Apa itu PersonaPlex?
PersonaPlex adalah sistem AI percakapan baru yang membuat interaksi suara terasa benar-benar natural sekaligus memungkinkan Anda menyesuaikan suara dan persona sepenuhnya.
Alih-alih terdengar seperti asisten biasa dengan jeda dan giliran bicara yang kaku, PersonaPlex menghadirkan percakapan real-time yang mulus di mana interupsi, timing, dan nada terasa manusiawi.
Intinya, PersonaPlex menggunakan arsitektur full-duplex, artinya dapat mendengarkan dan berbicara pada saat yang sama.
Alih-alih merangkai model terpisah untuk pengenalan ucapan, pemahaman bahasa, dan generasi ucapan, sistem ini mengandalkan satu model terpadu yang diperbarui secara berkelanjutan saat pengguna berbicara.
Prompt suara menentukan seperti apa suara asisten, sementara prompt teks menentukan siapa dia dan bagaimana seharusnya berperilaku. Kombinasi ini memungkinkan PersonaPlex mempertahankan persona yang konsisten sambil merespons secara seketika dan natural.
Arsitektur PersonaPlex | Sumber: NVIDIA PersonaPlex
PersonaPlex dievaluasi menggunakan FullDuplexBench dan benchmark layanan pelanggan yang diperluas bernama ServiceDuplexBench.
Sistem ini mengungguli sistem open-source dan komersial lain dalam dinamika percakapan, respons berlatensi rendah, penanganan interupsi, dan kepatuhan tugas pada skenario asisten maupun layanan pelanggan.
Dinamika Percakapan (Semakin tinggi semakin baik) | Sumber: NVIDIA PersonaPlex
Dalam demo video di bawah ini, Anda dapat melihat dengan jelas orang tersebut bercakap-cakap secara cair dengan model, saling bertukar canda dan lelucon secara real time.