

De omgeving instellen
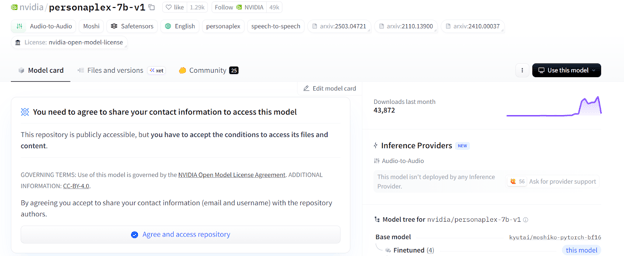
Bezoek voordat we beginnen de Hugging Face-modelpagina voor nvidia/personaplex-7b-v1 en accepteer de gebruiksvoorwaarden van het model.
PersonaPlex is een afgeschermd model, dus je hebt een Hugging Face API-token nodig. Genereer het token vanuit je Hugging Face-account en houd het bij de hand, want we voegen het later toe aan de omgevingsvariabelen om toegang tot het model te geven.
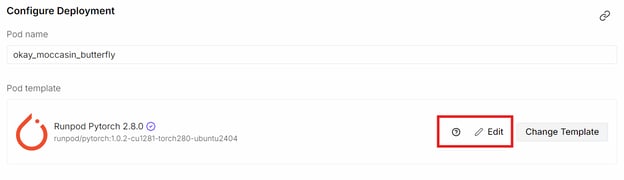
Ga daarna naar RunPod en start een nieuwe A40 GPU-pod. Selecteer de nieuwste PyTorch-image en klik vervolgens op Edit om de omgeving aan te passen.
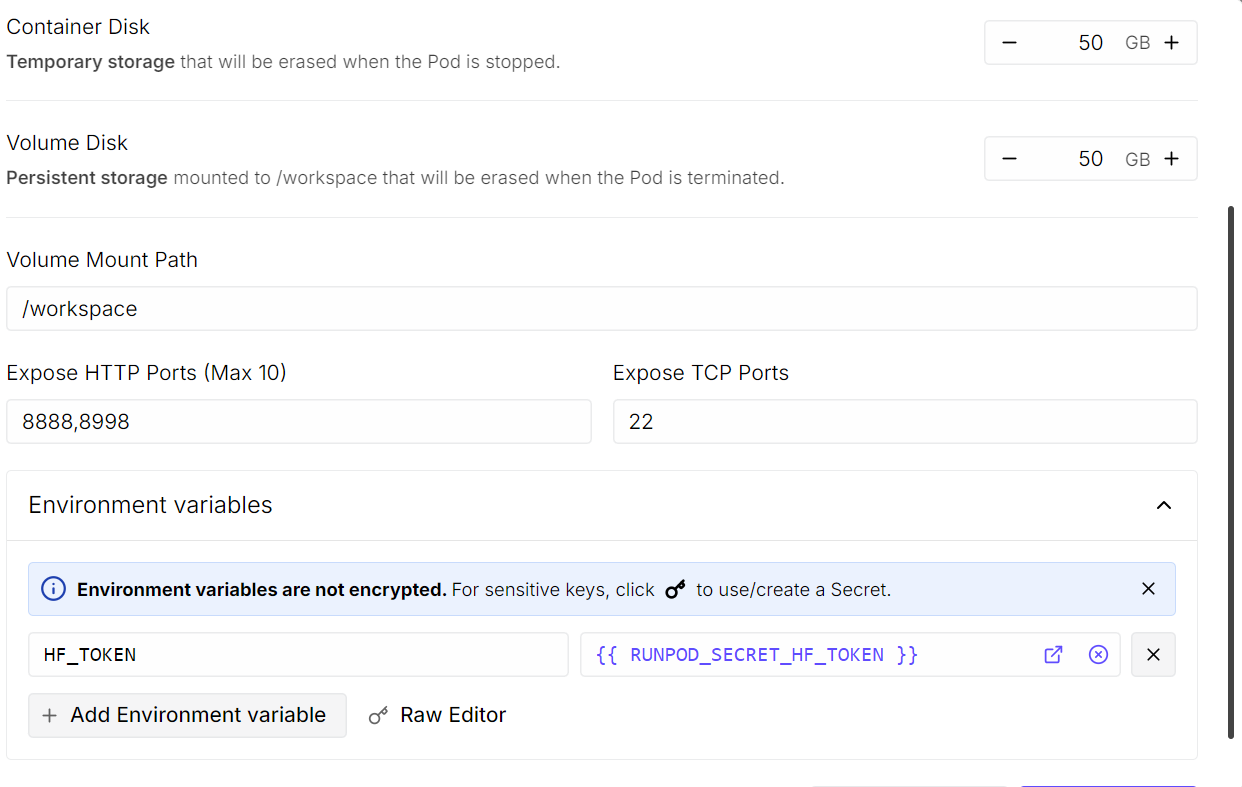
Vergroot de containerschijfruimte tot 50 GB, omdat het model zelf ongeveer 20 GB is en er ook extra afhankelijkheden worden gedownload. Voeg in de sectie met blootgestelde HTTP-poorten poort 8998 toe. Voeg onder omgevingsvariabelen HF_TOKEN toe en plak je Hugging Face API-token.
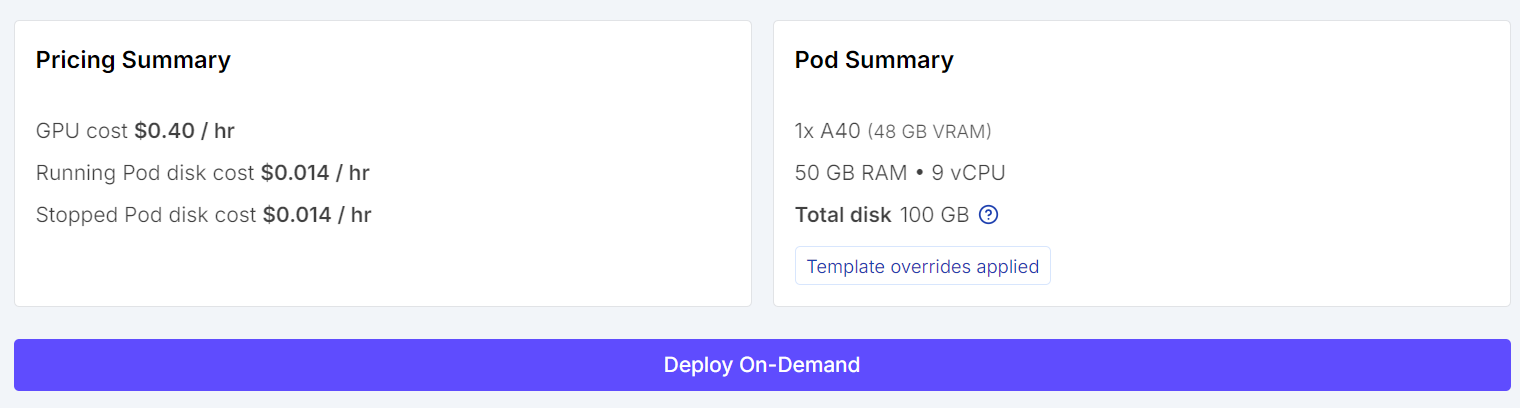
Als alles is geconfigureerd, sla je de overrides op en zet je de pod uit.
Nadat de pod is gestart, zie je een link naar de JupyterLab-instantie. Open die en start vervolgens een terminal. Je kunt de machine via SSH of de webterminal benaderen, maar de Jupyter-terminal is de eenvoudigste optie.
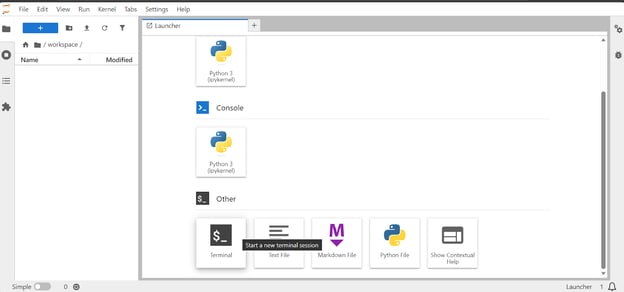
Installeer in de terminal de Opus-audiocodec-ontwikkelbibliotheek, die nodig is voor audioprocessing:
sudo apt update
sudo apt install libopus-dev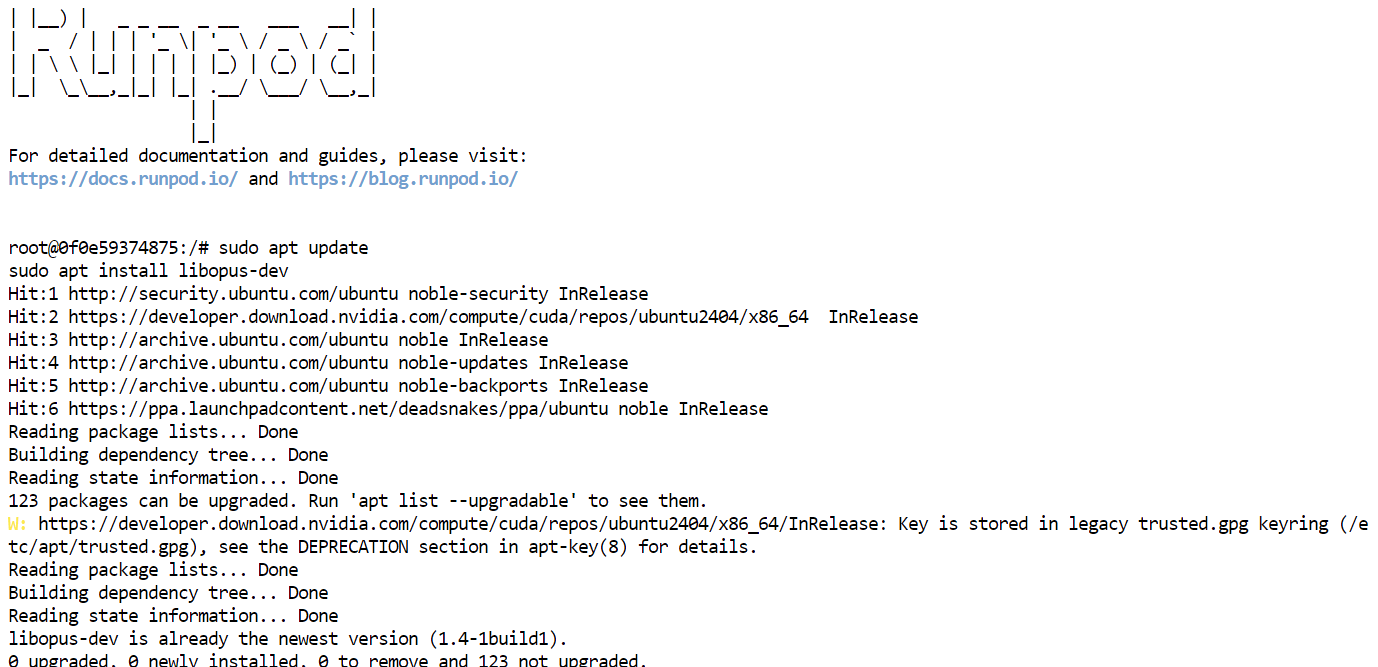
PersonaPlex installeren vanaf de bron
De PersonaPlex-codebase is open source gemaakt door NVIDIA en beschikbaar op GitHub (NVIDIA/personaplex: PersonaPlex code), waardoor je die eenvoudig lokaal kunt verkennen, aanpassen en draaien.
Installeren vanaf de bron geeft je volledige controle over de setup en zorgt voor compatibiliteit met de nieuwste updates in de repository.
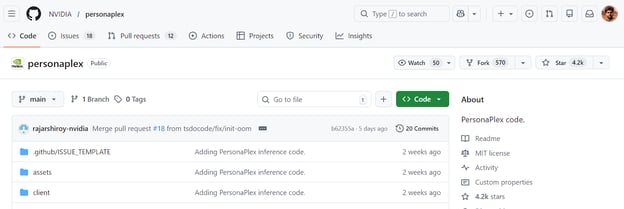
Kloon om te beginnen de PersonaPlex-repository:
git clone https://github.com/NVIDIA/personaplex.git
cd personaplex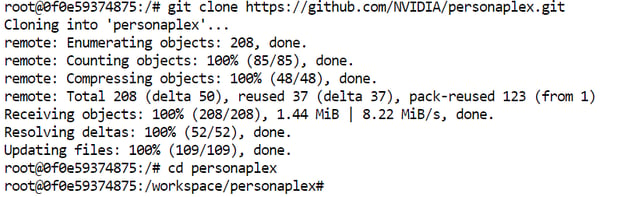
Installeer daarna Moshi, het kernmodel voor full-duplex spraak waarop PersonaPlex is gebouwd.
Moshi is verantwoordelijk voor realtime luisteren en spreken, waardoor PersonaPlex onderbrekingen, pauzes en natuurlijke gesprekstiming kan afhandelen zonder te vertrouwen op een traditionele ASR → LLM → TTS-pijplijn.
Installatie vanaf de bron zorgt ervoor dat alle audio-, streaming- en conversatiecomponenten correct zijn ingesteld voor lokale uitvoering.
pip install moshi/.Zodra Moshi is geïnstalleerd, is je omgeving volledig klaar om de PersonaPlex-server te starten en in realtime met het model te gaan werken.
De PersonaPlex WebUI-server starten
Met de omgeving en afhankelijkheden op hun plek kun je nu de PersonaPlex WebUI-server starten. Voer in de terminal de volgende opdracht uit om de Moshi-server te starten die PersonaPlex aandrijft:
python -m moshi.server --host 0.0.0.0 --port 8998De eerste keer dat je dit commando draait, downloadt de server automatisch het PersonaPlex-model en andere vereiste bestanden. Deze stap kan enkele minuten duren, afhankelijk van je netwerksnelheid, omdat het model vrij groot is.
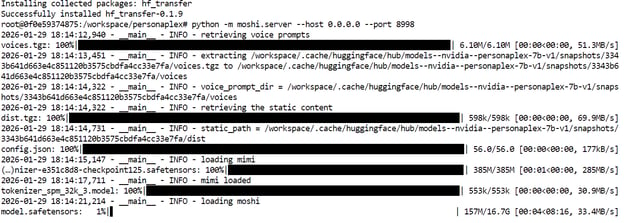
Zodra de download is voltooid, luistert de server op poort 8998.
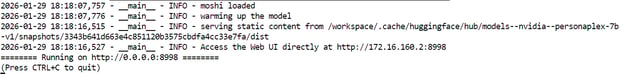
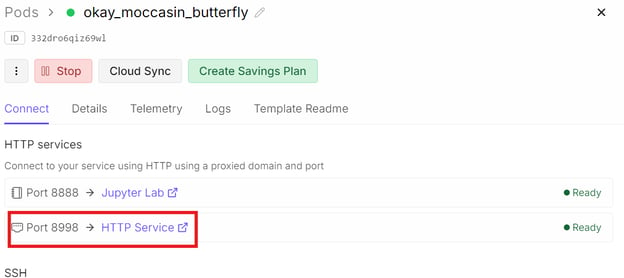
Ga terug naar je RunPod-dashboard om de WebUI te openen.
Zoek in de sectie Connect de blootgestelde poort 8998 en klik op de bijbehorende link. Hierdoor wordt de PersonaPlex WebUI in je browser geopend, waar je kunt beginnen met realtime spraakgesprekken met het model.
PersonaPlex testen met de WebUI
De PersonaPlex WebUI bevat verschillende voorbeeldprompts om je op weg te helpen en je kunt ook je eigen aangepaste prompt maken om de rol en het gedrag van de assistent te definiëren.
Je kunt vóór het verbinden een stem selecteren, wat bepaalt hoe de persona tijdens het gesprek klinkt.
Voor deze tutorial kun je het beste beginnen met de standaardinstellingen om gevoel te krijgen voor het systeem.
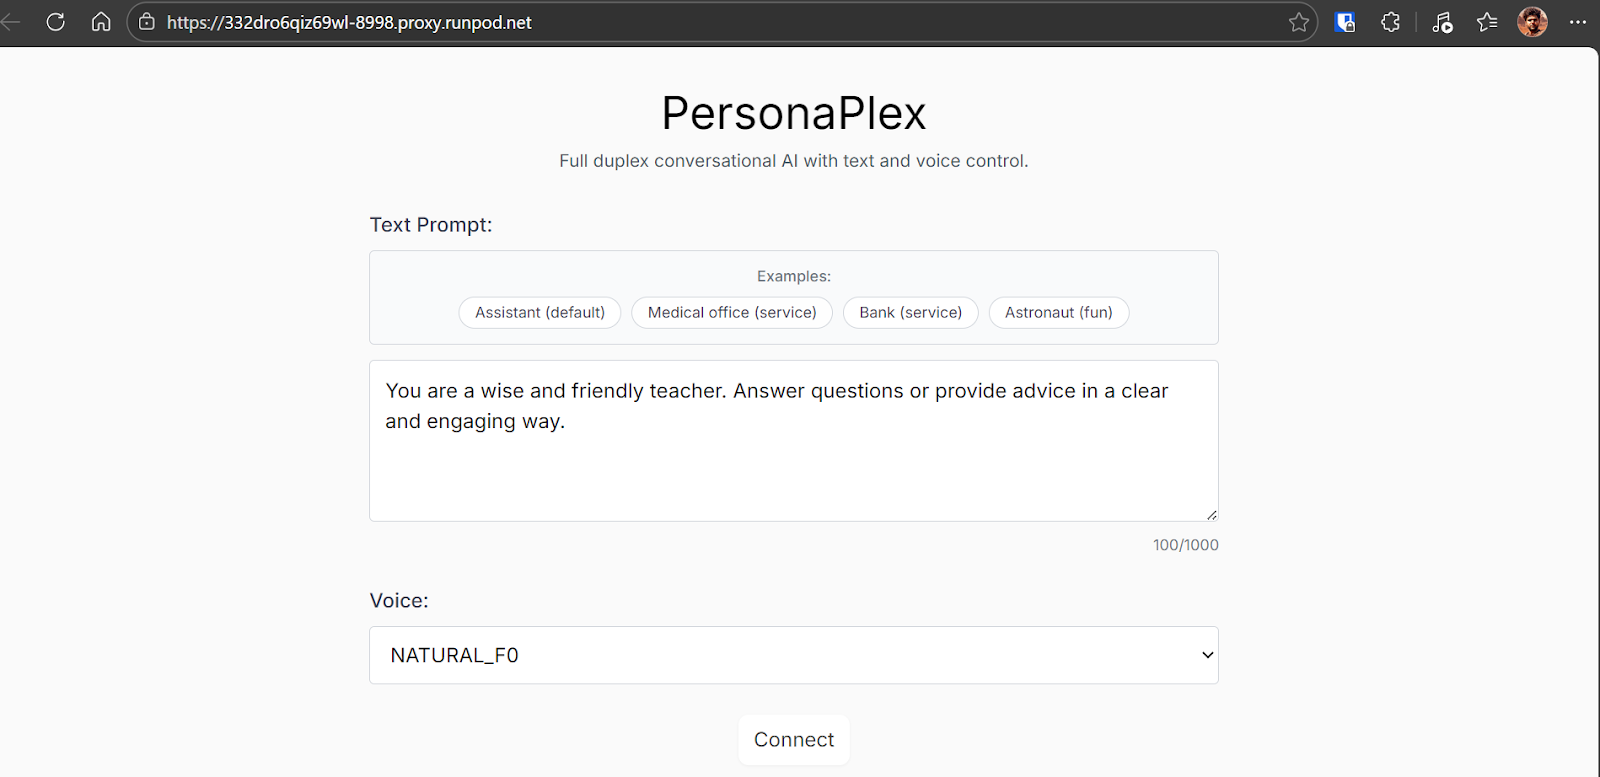
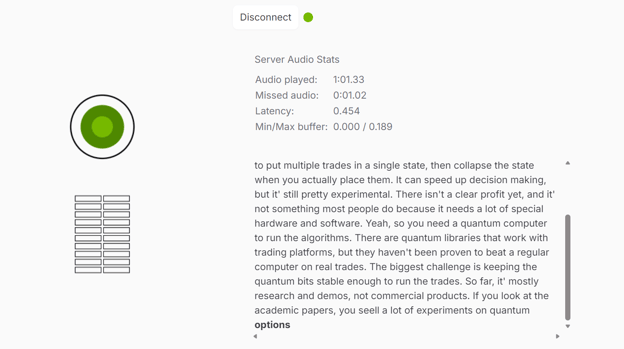
Na op de knop Connect te klikken, ga je naar de interactieve sessie. Hier kun je direct tegen het model praten, de reacties in realtime horen en een live transcript van het gesprek zien terwijl het gebeurt.
De ervaring voelt vloeiend aan, met natuurlijke timing en de mogelijkheid om snel te onderbreken of te reageren.
Tijdens mijn tests voelde de interactie verrassend natuurlijk en boeiend aan.
Ik merkte wel af en toe wat haperingen, waarschijnlijk door browser- of systeembelasting in plaats van het model zelf. Afgezien daarvan voelde het gesprek heel dicht bij praten met een echt persoon.
Als je je op je gemak voelt, experimenteer dan met verschillende prompts en stemmen. PersonaPlex ondersteunt een breed scala aan voorverpakte stemembeddings, waaronder natuurlijkere conversatiestemmen en meer expressieve varianten:
- Natuurlijk (vrouw): NATF0, NATF1, NATF2, NATF3
- Natuurlijk (man): NATM0, NATM1, NATM2, NATM3
- Variatie (vrouw): VARF0, VARF1, VARF2, VARF3, VARF4
- Variatie (man): VARM0, VARM1, VARM2, VARM3, VARM4
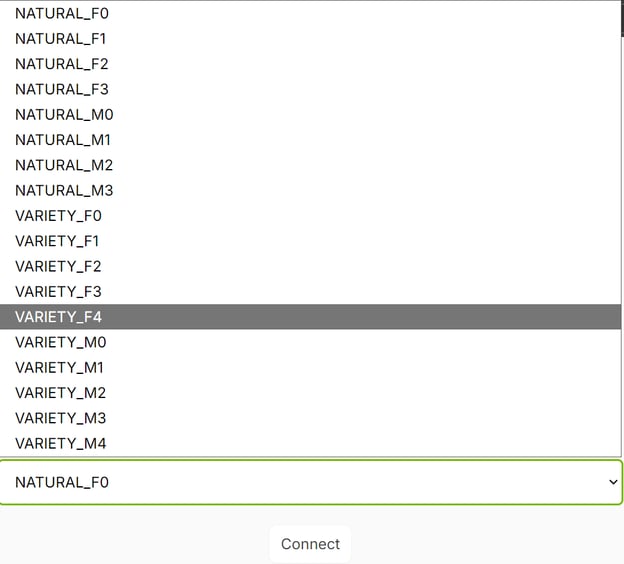
Wisselen van stemmen en prompts is een geweldige manier om te verkennen hoe PersonaPlex persoonlijkheid, toon en gespreksflow behoudt in verschillende rollen en spreekstijlen.
PersonaPlex offline draaien met Python
De WebUI is geweldig voor realtime gesprekken, maar je kunt PersonaPlex ook offline draaien vanuit Python. Dit is handig wanneer je herhaalbare outputs wilt, snel verschillende prompts wilt testen of audiobestanden wilt genereren die je kunt hergebruiken in demo’s en experimenten.
De offline flow is simpel: je levert (1) een spraakprompt, (2) een tekstprompt en (3) een invoer-WAV-bestand. PersonaPlex genereert vervolgens een audiorespons en een JSON-bestand met het transcript van het model.
Start een nieuw notebook in Jupyter en wijzig de map naar de gekloonde repository:
%cd personaplexVoer het volgende uit in een nieuwe cel. Dit roept de offline runner aan en schrijft zowel de gegenereerde audio als het transcript naar schijf:
%%capture
!python -m moshi.offline \
--voice-prompt "NATF2.pt" \
--text-prompt "You are a wise and friendly teacher. Answer questions in a clear, engaging way." \
--input-wav "assets/test/input_assistant.wav" \
--seed 42424242 \
--output-wav "out_teacher.wav" \
--output-text "out_teacher.json"Wat elke vlag doet:
--voice-promptselecteert de stemembedding (hier een natuurlijke vrouwelijke stem).--text-promptdefinieert de rol en het gedrag van de assistent.--input-wavis de opgenomen gebruikersaudio waarop het model reageert.--seedmaakt de output beter reproduceerbaar tussen runs.--output-wavis de gegenereerde gesproken respons.--output-textslaat het transcript op als JSON.
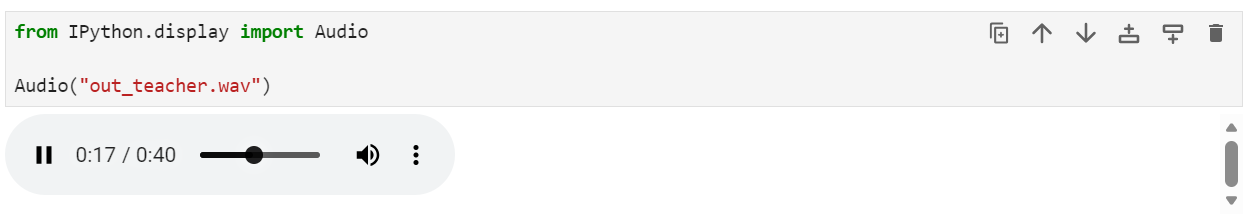
Zodra het commando is voltooid, kun je de responsaudio direct afspelen:
from IPython.display import Audio
Audio("out_teacher.wav")Je hoort nu een heldere, natuurlijke respons in de geselecteerde stem, passend bij de persona die je in je tekstprompt hebt gedefinieerd.
Het JSON-transcript kan soms tokenisatie-artefacten bevatten, zoals extra spaties rond leestekens of gesplitste woorddelen. De helper hieronder laadt de JSON en maakt er leesbare tekst van.
import json
import re
with open("out_teacher.json") as f:
data = json.load(f)
def detokenize(tokens):
# 1) drop padding-like tokens
drop = {"PAD", "EPAD", "<pad>", "</s>", "<s>"}
toks = [t for t in tokens if t not in drop]
# 2) join with spaces first
s = " ".join(toks)
# 3) fix spacing around punctuation
s = re.sub(r"\s+([.,!?;:])", r"\1", s)
# 4) fix common split contractions: "it ' s" -> "it's"
s = s.replace(" ' s", "'s").replace(" n't", "n't").replace(" 're", "'re").replace(" 'm", "'m").replace(" 've", "'ve").replace(" 'd", "'d")
# 5) fix stray spaces around apostrophes
s = re.sub(r"\s+'\s+", "'", s)
# 6) fix cases like "for k" -> "fork" and "fl uff" -> "fluff"
# (general rule: merge single-letter fragments if they look like split wordpieces)
s = re.sub(r"\b([A-Za-z])\s+([A-Za-z]{1,3})\b", r"\1\2", s)
# 7) collapse multiple spaces
s = re.sub(r"\s{2,}", " ", s).strip()
return s
clean_text = detokenize(data) # replace with your list variable
clean_textJe zou nu een leesbare transcriptstring moeten zien die overeenkomt met de gegenereerde audio. Als je output nog steeds vreemde splitsingen bevat (bijvoorbeeld “fl uff” of “afor k”), is dat normaal bij sommige runs en kun je dit verder opschonen met extra regels, maar de hoofdinformatie zou al begrijpelijk moeten zijn.
"Hey, let me know if you have any questions.
Hmm, first rinse the rice a couple of times until the water runs clear, that cuts down on starch, then use apot with a tight fitting lid, bring to a boil,
give it a quick stir, then turn the heat down low and cover, let it s immer without lifting it, and when it'done fl uff it with afor k, that usually
You could to ss the hot rice with a nice handful of chopped fresh herbs like basil or par sley, or you could sprinkle a little g rated cheese,
a squeeze of lemon or lime, adr izzle of olive oil, some chopped fresh herbs, or even some to ast ed nuts, that adds color and flavor."Tot slot
PersonaPlex testen heeft me oprecht verrast. Vanaf de allereerste interactie voelde het minder als experimenteren met een model en meer als een echt gesprek. De mogelijkheid om natuurlijk te onderbreken, direct reacties te krijgen en een consistente persoonlijkheid te behouden, deed het ver uitsteken boven de meeste spraaksystemen die ik heb geprobeerd. Alles lokaal draaien maakte de ervaring nog indrukwekkender, zonder merkbare vertraging of verlies van controle.
Er zijn nog wel wat nadelen. Ik merkte af en toe haperingen, en zodra het gesprek verder ging, ging terugkeren naar een eerder onderwerp niet altijd even soepel.
Het begrijpt ook nog niet volledig niet-Engelse accenten, wat kan leiden tot verkeerd uitgesproken namen of minder perfecte transcripties. Dit voelt als randgevallen en geen fundamentele problemen, en ik ben ervan overtuigd dat dit snel beter wordt.
Ik weet zeker dat deze problemen in de toekomst worden opgelost en dat we een nog betere, volledig lokale en realtime converserende AI krijgen die het redeneervermogen van GPT-5.2 combineert met de geluidskwaliteit van ElevenLabs.
PersonaPlex FAQ’s
Welke hardware heb ik nodig om PersonaPlex lokaal te draaien?
NVIDIA raadt een GPU met minimaal 24 GB VRAM aan (zoals een A10G, A40 of RTX 3090/4090) om het 7B-model soepel en met lage latency te draaien. Je hebt ook een Linux-omgeving met CUDA-ondersteuning nodig. Hoewel het mogelijk is om lagen naar de CPU te offloaden, zal dit de realtime prestaties die het model bijzonder maken aanzienlijk verslechteren.
Kan PersonaPlex andere talen spreken dan Engels?
Op dit moment is de v1-release alleen in het Engels. De architectuur ondersteunt meerdere talen en NVIDIA heeft aangegeven dat ondersteuning voor andere talen (zoals Spaans) op de roadmap staat voor toekomstige updates, maar voor nu is het geoptimaliseerd voor Engelstalige gesprekken.
Kan ik dit voor commerciële toepassingen gebruiken?
Ja. De modelgewichten zijn uitgebracht onder de NVIDIA Open Model License, die commercieel gebruik over het algemeen toestaat. Je moet echter de specifieke licentieovereenkomst op de Hugging Face-modelkaart doornemen om zeker te weten dat jouw usecase (bijv. het hosten van een betaalde dienst) aan de voorwaarden voldoet.
Hoe verschilt dit van faster-whisper met een snel LLM?
Traditionele systemen zijn "half-duplex"—ze wachten tot je klaar bent met spreken, transcriberen de audio, denken, en spreken dan. PersonaPlex is "full-duplex," wat betekent dat het audio en tokens continu verwerkt. Hierdoor kan het tijdens het spreken luisteren, onderbrekingen natuurlijk afhandelen en backchannels genereren ("uh-huh", "right") zonder de ongemakkelijke latency van beurtgebaseerde systemen.
Waarom spreekt het model soms namen verkeerd uit of splitst het woorden in het transcript?
Omdat PersonaPlex audiotokens in realtime frames (24 kHz) streamt, worden teksttokens soms over gesplitste frames gegenereerd. Dit kan artefacten opleveren zoals "fl uff" of "afor k" in het ruwe transcript. Dit zijn normale bijwerkingen van streaming-tokenisatie en kunnen worden opgeschoond met eenvoudige postprocessingscripts.

Als gecertificeerd data scientist haal ik met passie het maximale uit de nieuwste technologie om innovatieve machinelearning-toepassingen te bouwen. Met een sterke achtergrond in spraakherkenning, data-analyse en -rapportage, MLOps, conversationele AI en NLP heb ik mijn vaardigheden aangescherpt in het ontwikkelen van intelligente systemen die echt impact maken. Naast mijn technische expertise ben ik ook een sterke communicator met een talent om complexe concepten terug te brengen tot heldere, beknopte taal. Daardoor ben ik uitgegroeid tot een veelgelezen blogger over data science, waar ik mijn inzichten en ervaringen deel met een groeiende community van data-professionals. Op dit moment richt ik me op contentcreatie en redactie, waarbij ik met large language models werk aan krachtige en aansprekende content die zowel bedrijven als individuen helpt het beste uit hun data te halen.
Als je ooit ChatGPT met spraakmodus hebt gebruikt, weet je hoe indrukwekkend dat voelt. Praten met een AI die luistert, begrijpt en bijna als een echt persoon reageert, kan verrassend natuurlijk zijn. Het voelt gesprekachtig, intelligent en responsief. Maar er is nog steeds een kloof. Kleine vertragingen, beperkte omgang met onderbrekingen en het gevoel dat je nog steeds met een systeem praat in plaats van met een persoon.
Stel je nu iets beters voor. Precies daar komt PersonaPlex om de hoek kijken.
Stel je een realtime spraakassistent voor die direct reageert, je natuurlijk laat onderbreken, zich halverwege een zin aanpast en veel dichter bij een echt menselijk gesprek aanvoelt. Geen merkbare latency. Geen ongemakkelijke pauzes. Geen cloud-afhankelijkheid. Gewoon een soepele, lokale, realtime dialoog die leeft.
PersonaPlex is een realtime, lokaal spraakinteractiesysteem ontwikkeld door NVIDIA. Het is ontworpen om spraakgestuurde AI verder te brengen dan simpele speech-to-text en text-to-speech-pijplijnen. In plaats daarvan maakt het gesprekken met lage latency mogelijk, waarbij de assistent continu kan spreken, luisteren en zich aanpassen, net zoals een echt persoon in een face-to-face gesprek zou doen.
In deze tutorial neem ik je stap voor stap mee door PersonaPlex. We beginnen met wat PersonaPlex is en waarom het fundamenteel anders aanvoelt dan typische spraakassistenten. Vervolgens richten we de lokale omgeving in, installeren we PersonaPlex vanaf de bron en starten we de PersonaPlex WebUI-server. Daarna gaan we via de webinterface met het systeem aan de slag en testen we tot slot realtime spraakgesprekken met een Python-script.
Ik raad aan om de cursus Spoken Language Processing in Python te bekijken om meer te leren over de basis achter PersonaPlex.
Wat is PersonaPlex?
PersonaPlex is een nieuw converserend AI-systeem dat spraakinteracties écht natuurlijk laat aanvoelen, terwijl je de stem en persona volledig kunt aanpassen.
In plaats van te klinken als een typische assistent met pauzes en rigide beurten, maakt het soepele, realtime gesprekken mogelijk waarin onderbrekingen, timing en toon menselijk aanvoelen.
De kern van PersonaPlex is een full-duplexarchitectuur, wat betekent dat het tegelijk kan luisteren en spreken.
In plaats van losse modellen voor spraakherkenning, taalbegrip en spraaksynthese aan elkaar te koppelen, gebruikt het één uniform model dat continu wordt bijgewerkt terwijl de gebruiker spreekt.
Spraakprompts bepalen hoe de assistent klinkt, terwijl tekstprompts bepalen wie het is en hoe het zich moet gedragen. Deze combinatie stelt PersonaPlex in staat een consistente persona te behouden terwijl het direct en natuurlijk reageert.
PersonaPlex-architectuur | Bron: NVIDIA PersonaPlex
PersonaPlex wordt geëvalueerd met FullDuplexBench en een uitgebreide klantenservicebenchmark genaamd ServiceDuplexBench.
Het presteert beter dan andere open-source- en commerciële systemen in gespreksdynamiek, reacties met lage latency, omgang met onderbrekingen en taaktrouw in zowel assistent- als klantenservicescenario’s.
Gespreksdynamiek (hoger is beter) | Bron: NVIDIA PersonaPlex
In de videodemo hieronder zie je duidelijk hoe iemand een vloeiend gesprek voert met het model, met geplaag en grappen in realtime.