

Thiết lập môi trường
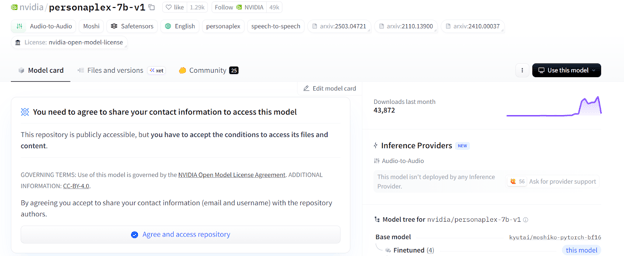
Trước khi bắt đầu, hãy truy cập trang mô hình trên Hugging Face cho nvidia/personaplex-7b-v1 và chấp nhận điều kiện sử dụng mô hình.
PersonaPlex là mô hình có kiểm soát truy cập, nên bạn sẽ cần token API của Hugging Face. Tạo token từ tài khoản Hugging Face của bạn và giữ sẵn, vì chúng ta sẽ thêm nó vào biến môi trường sau để cho phép truy cập mô hình.
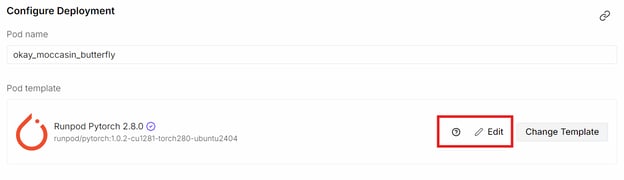
Tiếp theo, vào RunPod và khởi chạy một pod GPU A40 mới. Chọn image PyTorch mới nhất, sau đó nhấp Edit để tùy chỉnh môi trường.
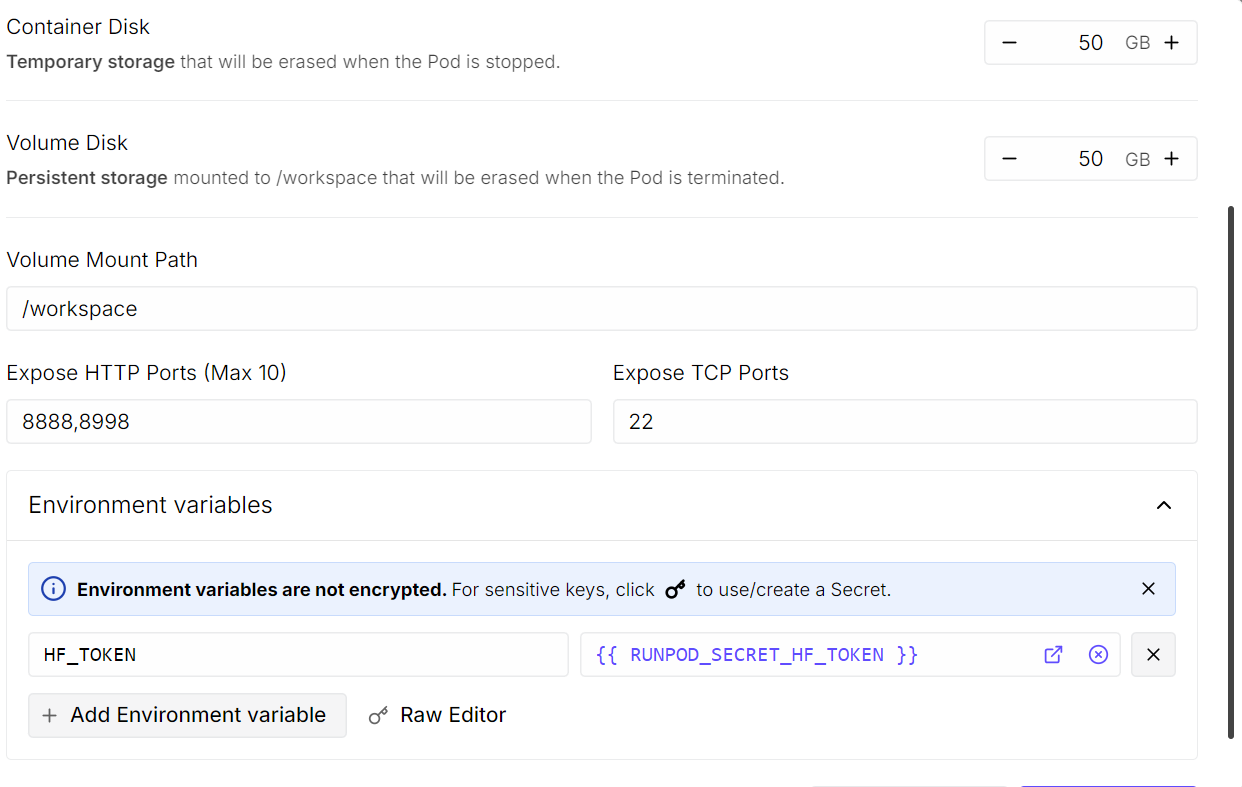
Tăng dung lượng đĩa container lên 50 GB, vì bản thân mô hình khoảng 20 GB và sẽ có thêm các phụ thuộc được tải về. Trong phần cổng HTTP mở, thêm cổng 8998. Ở mục biến môi trường, thêm HF_TOKEN và dán token API Hugging Face của bạn.
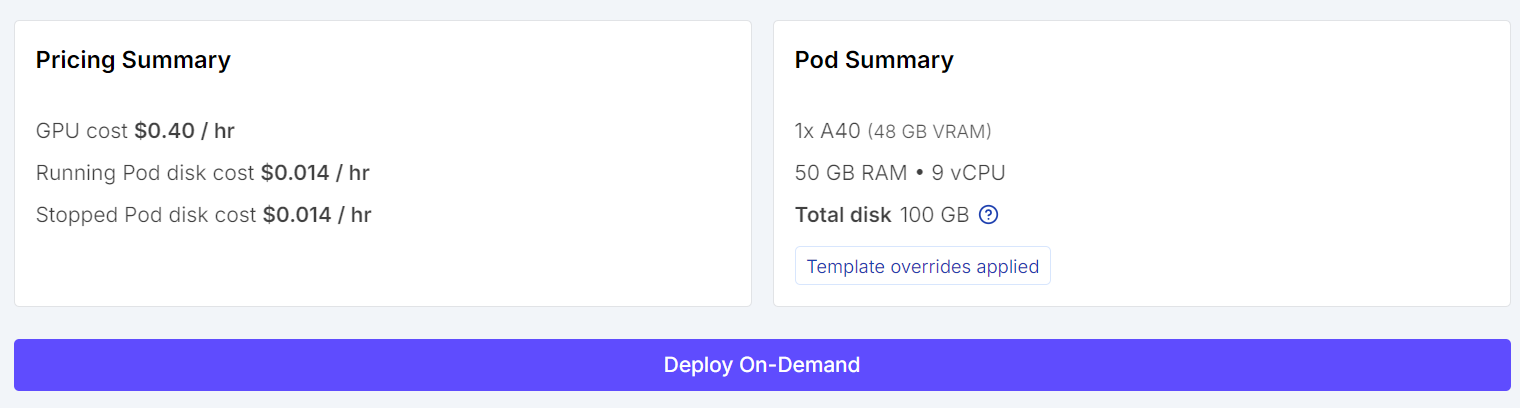
Khi mọi thứ đã cấu hình xong, lưu các thay đổi và triển khai pod.
Sau khi pod khởi động, bạn sẽ thấy liên kết tới phiên bản JupyterLab. Mở nó rồi khởi chạy một terminal. Bạn có thể truy cập máy qua SSH hoặc terminal trên web, nhưng dùng terminal của Jupyter là đơn giản nhất.
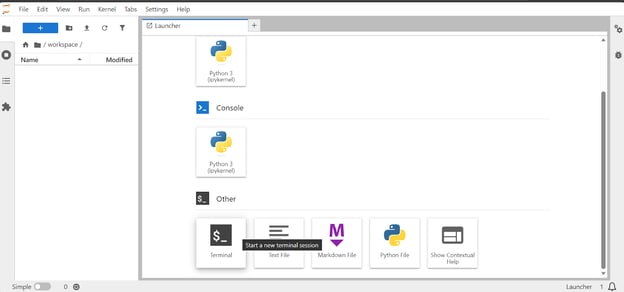
Trong terminal, cài đặt thư viện phát triển codec âm thanh Opus, cần thiết cho xử lý âm thanh:
sudo apt update
sudo apt install libopus-dev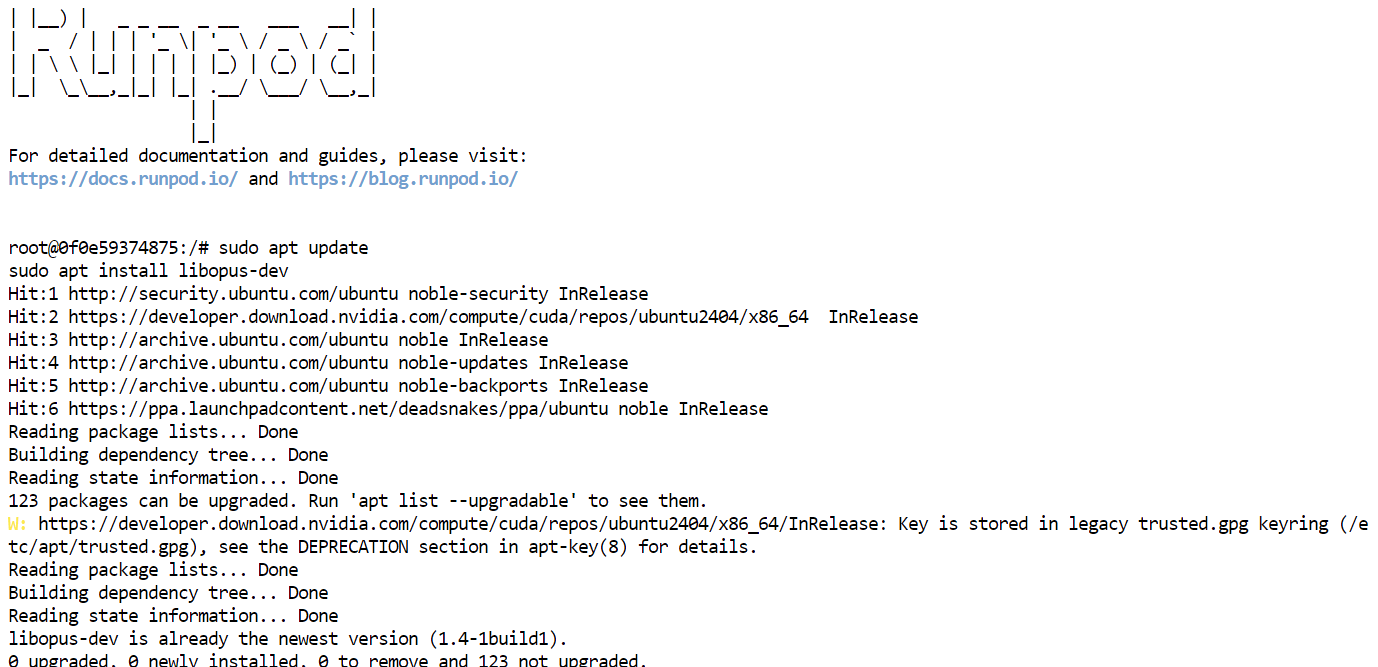
Cài đặt PersonaPlex từ mã nguồn
Bộ mã PersonaPlex được NVIDIA mở nguồn và có sẵn trên GitHub (NVIDIA/personaplex: Mã PersonaPlex), giúp bạn dễ dàng khám phá, tùy chỉnh và chạy cục bộ.
Cài đặt từ mã nguồn cho bạn toàn quyền kiểm soát thiết lập và đảm bảo tương thích với các cập nhật mới nhất trong kho mã.
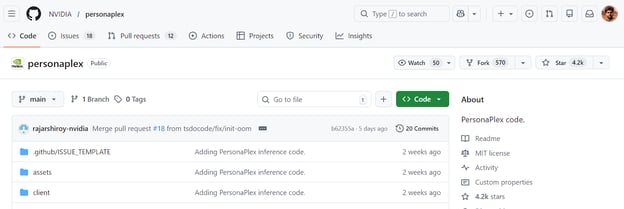
Để bắt đầu, hãy nhân bản kho PersonaPlex:
git clone https://github.com/NVIDIA/personaplex.git
cd personaplex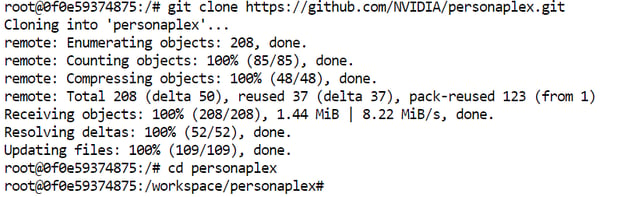
Sau đó cài đặt Moshi, mô hình giọng nói full-duplex cốt lõi mà PersonaPlex xây dựng trên đó.
Moshi chịu trách nhiệm lắng nghe và nói theo thời gian thực, cho phép PersonaPlex xử lý ngắt lời, khoảng dừng và nhịp hội thoại tự nhiên mà không cần dựa vào pipeline ASR → LLM → TTS truyền thống.
Cài đặt từ mã nguồn đảm bảo tất cả thành phần âm thanh, streaming và hội thoại được thiết lập chính xác để chạy cục bộ.
pip install moshi/.Khi Moshi đã được cài, môi trường của bạn đã sẵn sàng hoàn toàn để khởi động máy chủ PersonaPlex và bắt đầu tương tác với mô hình theo thời gian thực.
Khởi động máy chủ PersonaPlex WebUI
Với môi trường và các phụ thuộc đã sẵn sàng, bạn có thể khởi chạy máy chủ PersonaPlex WebUI. Trong terminal, chạy lệnh sau để khởi động máy chủ Moshi vận hành PersonaPlex:
python -m moshi.server --host 0.0.0.0 --port 8998Lần đầu chạy lệnh này, máy chủ sẽ tự động tải về mô hình PersonaPlex và các tệp cần thiết khác. Bước này có thể mất vài phút tùy tốc độ mạng, vì mô hình khá lớn.
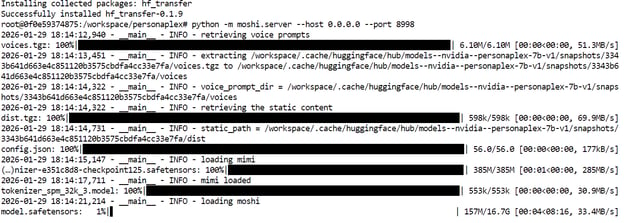
Khi tải xong, máy chủ sẽ bắt đầu lắng nghe trên cổng 8998.
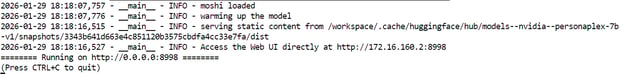
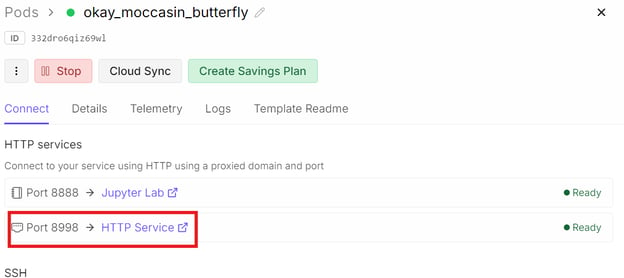
Để truy cập WebUI, quay lại bảng điều khiển RunPod của bạn.
Trong phần Connect, tìm cổng 8998 đã mở và nhấp vào liên kết. Điều này sẽ mở PersonaPlex WebUI trong trình duyệt của bạn, nơi bạn có thể bắt đầu tương tác với mô hình qua hội thoại giọng nói thời gian thực.
Kiểm thử PersonaPlex bằng WebUI
PersonaPlex WebUI có sẵn một số prompt mẫu để bạn bắt đầu, và bạn cũng có thể tạo prompt tùy chỉnh để xác định vai trò và hành vi của trợ lý.
Bạn có thể chọn giọng trước khi kết nối, điều này quyết định giọng của persona trong cuộc trò chuyện.
Trong hướng dẫn này, tốt nhất là bắt đầu với thiết lập mặc định để làm quen hệ thống.
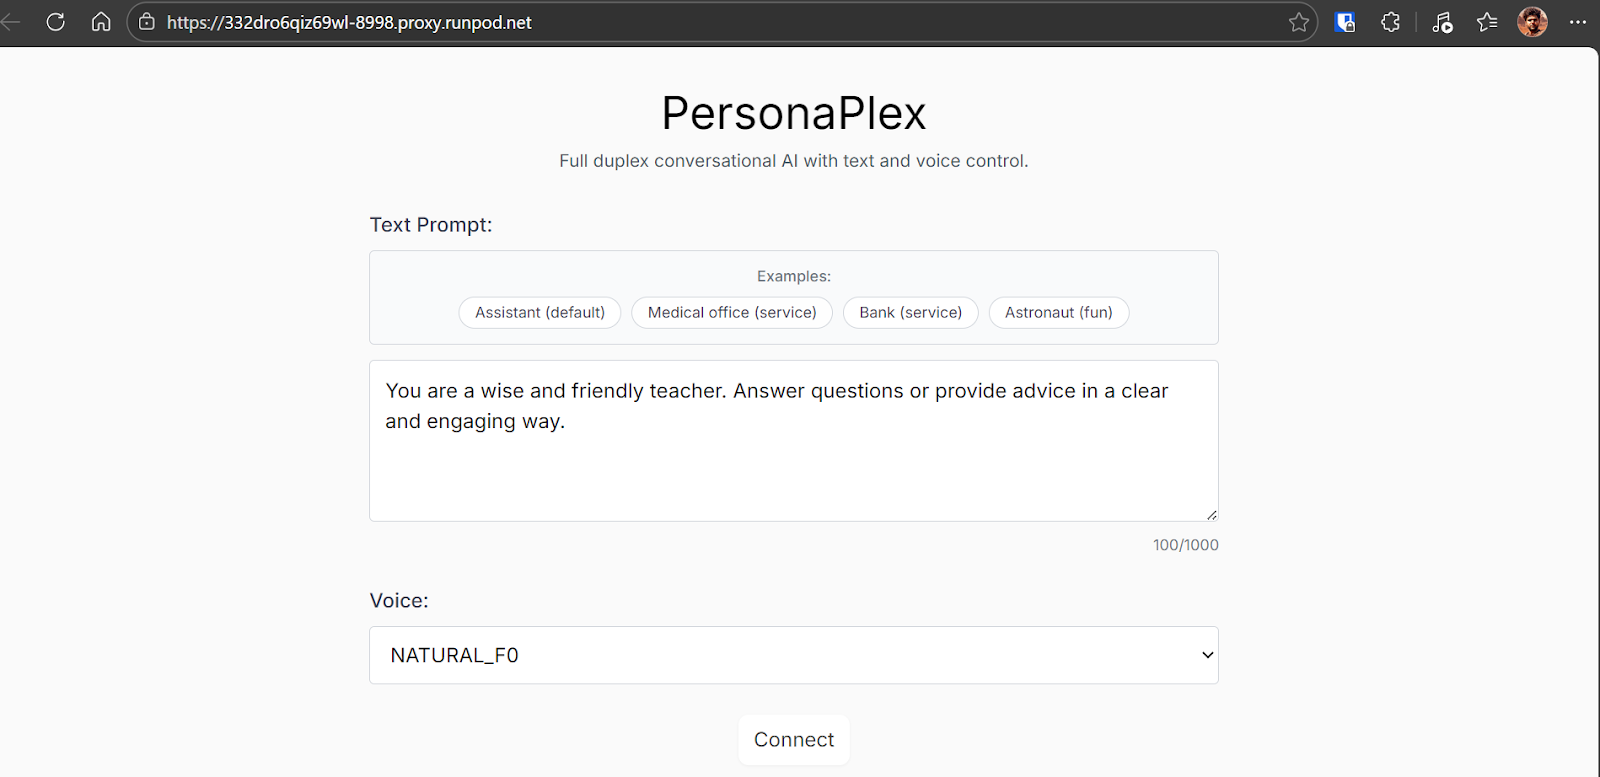
Sau khi nhấp nút Connect, bạn sẽ vào phiên tương tác. Tại đây, bạn có thể nói trực tiếp với mô hình, nghe phản hồi theo thời gian thực và xem bản chép lại trực tiếp của cuộc trò chuyện khi nó diễn ra.
Trải nghiệm liền mạch, với nhịp tự nhiên và khả năng ngắt lời hoặc đáp nhanh.
Trong quá trình thử nghiệm, tương tác mang lại cảm giác tự nhiên và cuốn hút đáng ngạc nhiên.
Tôi có nhận thấy đôi lúc bị lắp bắp, có lẽ do tải của trình duyệt hoặc hệ thống chứ không phải bản thân mô hình. Ngoài ra, cuộc trò chuyện rất gần với cảm giác nói chuyện với một người thật.
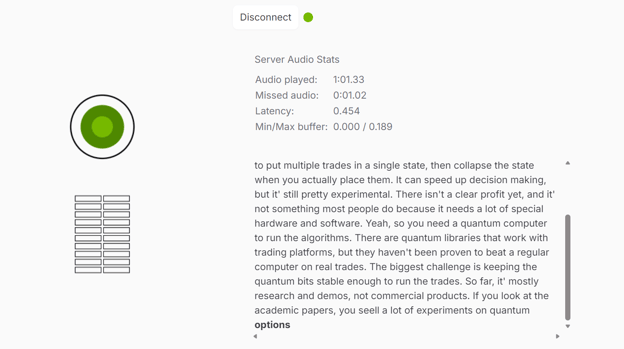
Khi đã quen, hãy thử nghiệm với các prompt và giọng khác nhau. PersonaPlex hỗ trợ nhiều embedding giọng nói đóng gói sẵn, bao gồm giọng hội thoại tự nhiên và các biến thể biểu cảm hơn:
- Tự nhiên (nữ): NATF0, NATF1, NATF2, NATF3
- Tự nhiên (nam): NATM0, NATM1, NATM2, NATM3
- Đa dạng (nữ): VARF0, VARF1, VARF2, VARF3, VARF4
- Đa dạng (nam): VARM0, VARM1, VARM2, VARM3, VARM4
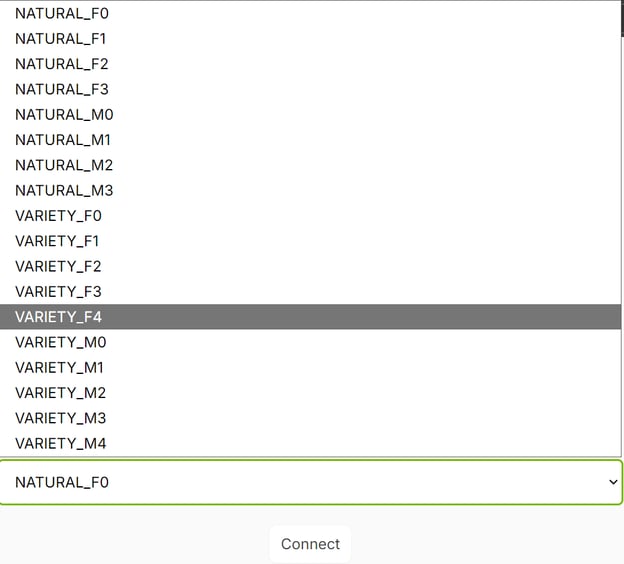
Việc chuyển đổi giọng và prompt là cách tuyệt vời để khám phá cách PersonaPlex duy trì cá tính, giọng điệu và dòng chảy hội thoại qua các vai trò và phong cách nói khác nhau.
Chạy PersonaPlex ngoại tuyến bằng Python
WebUI rất phù hợp cho hội thoại thời gian thực, nhưng bạn cũng có thể chạy PersonaPlex ngoại tuyến từ Python. Điều này hữu ích khi bạn muốn đầu ra có thể lặp lại, muốn thử nhanh các prompt khác nhau, hoặc muốn tạo tệp âm thanh để tái sử dụng trong demo và thử nghiệm.
Quy trình ngoại tuyến rất đơn giản: bạn cung cấp (1) một voice prompt, (2) một text prompt, và (3) một tệp WAV đầu vào. PersonaPlex sau đó tạo phản hồi âm thanh đầu ra và một tệp JSON chứa bản chép của mô hình.
Tạo notebook mới trong Jupyter và chuyển thư mục làm việc tới kho đã nhân bản:
%cd personaplexChạy lệnh sau trong một ô mới. Lệnh này gọi trình chạy ngoại tuyến và ghi cả âm thanh sinh ra lẫn bản chép xuống đĩa:
%%capture
!python -m moshi.offline \
--voice-prompt "NATF2.pt" \
--text-prompt "You are a wise and friendly teacher. Answer questions in a clear, engaging way." \
--input-wav "assets/test/input_assistant.wav" \
--seed 42424242 \
--output-wav "out_teacher.wav" \
--output-text "out_teacher.json"Ý nghĩa từng cờ:
--voice-promptchọn embedding giọng (ở đây là giọng nữ tự nhiên).--text-promptđịnh nghĩa vai trò và hành vi của trợ lý.--input-wavlà âm thanh người dùng đã ghi mà mô hình sẽ phản hồi.--seedgiúp đầu ra có thể tái lập giữa các lần chạy.--output-wavlà phản hồi giọng nói được tạo.--output-textlưu bản chép dưới dạng JSON.
Khi lệnh hoàn tất, bạn có thể phát trực tiếp âm thanh phản hồi:
from IPython.display import Audio
Audio("out_teacher.wav")Bạn sẽ nghe phản hồi rõ ràng, tự nhiên bằng giọng đã chọn, khớp với persona được xác định trong text prompt.
Bản chép JSON đôi khi có thể chứa hiện tượng token hóa như thừa khoảng trắng quanh dấu câu hoặc tách rời các mảnh từ. Trình trợ giúp bên dưới sẽ tải JSON và làm sạch thành văn bản dễ đọc.
import json
import re
with open("out_teacher.json") as f:
data = json.load(f)
def detokenize(tokens):
# 1) drop padding-like tokens
drop = {"PAD", "EPAD", "<pad>", "</s>", "<s>"}
toks = [t for t in tokens if t not in drop]
# 2) join with spaces first
s = " ".join(toks)
# 3) fix spacing around punctuation
s = re.sub(r"\s+([.,!?;:])", r"\1", s)
# 4) fix common split contractions: "it ' s" -> "it's"
s = s.replace(" ' s", "'s").replace(" n't", "n't").replace(" 're", "'re").replace(" 'm", "'m").replace(" 've", "'ve").replace(" 'd", "'d")
# 5) fix stray spaces around apostrophes
s = re.sub(r"\s+'\s+", "'", s)
# 6) fix cases like "for k" -> "fork" and "fl uff" -> "fluff"
# (general rule: merge single-letter fragments if they look like split wordpieces)
s = re.sub(r"\b([A-Za-z])\s+([A-Za-z]{1,3})\b", r"\1\2", s)
# 7) collapse multiple spaces
s = re.sub(r"\s{2,}", " ", s).strip()
return s
clean_text = detokenize(data) # replace with your list variable
clean_textGiờ bạn sẽ thấy một chuỗi bản chép dễ đọc khớp với âm thanh được tạo. Nếu đầu ra vẫn còn các tách ghép lạ (ví dụ “fl uff” hoặc “afor k”), đó là bình thường trong một số lần chạy và có thể làm sạch thêm bằng các quy tắc bổ sung, nhưng nội dung chính đã có thể hiểu được.
"Hey, let me know if you have any questions.
Hmm, first rinse the rice a couple of times until the water runs clear, that cuts down on starch, then use apot with a tight fitting lid, bring to a boil,
give it a quick stir, then turn the heat down low and cover, let it s immer without lifting it, and when it'done fl uff it with afor k, that usually
You could to ss the hot rice with a nice handful of chopped fresh herbs like basil or par sley, or you could sprinkle a little g rated cheese,
a squeeze of lemon or lime, adr izzle of olive oil, some chopped fresh herbs, or even some to ast ed nuts, that adds color and flavor."Tổng kết
Việc thử nghiệm PersonaPlex thực sự khiến tôi bất ngờ. Ngay từ lần tương tác đầu tiên, cảm giác không còn là đang thử một mô hình mà là đang trò chuyện thật sự. Khả năng ngắt lời tự nhiên, phản hồi tức thì và duy trì cá tính nhất quán xuyên suốt khiến nó vượt xa hầu hết hệ thống giọng nói tôi từng dùng. Việc chạy mọi thứ cục bộ càng làm trải nghiệm ấn tượng hơn, gần như không có độ trễ hay mất kiểm soát.
Dĩ nhiên vẫn có điểm trừ. Tôi nhận thấy đôi lúc bị lắp bắp, và khi cuộc trò chuyện chuyển chủ đề, nó không phải lúc nào cũng xử lý trơn tru khi quay lại chủ đề cũ.
Nó cũng chưa hiểu hoàn toàn các giọng tiếng Anh không chuẩn, có thể dẫn đến phát âm sai tên riêng hoặc bản chép chưa hoàn hảo. Những điều này có vẻ là trường hợp biên hơn là vấn đề cốt lõi, và tôi tin chúng sẽ được cải thiện nhanh chóng.
Tôi chắc rằng trong tương lai, các vấn đề này sẽ được giải quyết, và chúng ta sẽ có một AI hội thoại hoàn toàn cục bộ, thời gian thực còn tốt hơn nữa, kết hợp năng lực suy luận của GPT-5.2 với chất lượng giọng của ElevenLabs.
Câu hỏi thường gặp về PersonaPlex
Tôi cần phần cứng gì để chạy PersonaPlex cục bộ?
NVIDIA khuyến nghị GPU với ít nhất 24 GB VRAM (như A10G, A40 hoặc RTX 3090/4090) để chạy mô hình 7B mượt mà với độ trễ thấp. Bạn cũng cần môi trường Linux có hỗ trợ CUDA. Dù có thể offload một số lớp sang CPU, điều này sẽ làm giảm đáng kể hiệu năng thời gian thực vốn là điểm đặc biệt của mô hình.
PersonaPlex có thể nói các ngôn ngữ khác ngoài tiếng Anh không?
Hiện tại, bản phát hành v1 chỉ hỗ trợ tiếng Anh. Kiến trúc hỗ trợ đa ngôn ngữ và NVIDIA cho biết hỗ trợ các ngôn ngữ khác (như tiếng Tây Ban Nha) đang nằm trong lộ trình các bản cập nhật tương lai, nhưng hiện giờ mô hình được tối ưu cho hội thoại tiếng Anh.
Tôi có thể dùng mô hình cho ứng dụng thương mại không?
Có. Trọng số mô hình được phát hành theo Giấy phép Mô hình Mở của NVIDIA, nhìn chung cho phép sử dụng thương mại. Tuy nhiên, bạn nên xem lại thỏa thuận cấp phép cụ thể trên thẻ mô hình Hugging Face để đảm bảo trường hợp sử dụng của bạn (ví dụ: cung cấp dịch vụ trả phí) tuân thủ các điều khoản.
Khác gì so với việc dùng faster-whisper và một LLM nhanh?
Các hệ thống truyền thống là "half-duplex"—chúng đợi bạn nói xong, chép lại âm thanh, suy nghĩ rồi mới nói. PersonaPlex là "full-duplex," nghĩa là nó xử lý âm thanh và sinh token liên tục. Điều này cho phép nó lắng nghe trong khi đang nói, xử lý ngắt lời tự nhiên và tạo các tín hiệu lắng nghe ("uh-huh", "right") mà không có độ trễ gượng gạo của hệ thống theo lượt.
Vì sao mô hình đôi khi phát âm sai tên riêng hoặc tách từ trong bản chép?
Bởi vì PersonaPlex stream các token âm thanh theo khung thời gian thực (24kHz), token văn bản đôi khi được sinh ra xuyên qua các khung tách rời. Điều này có thể tạo ra hiện tượng như "fl uff" hoặc "afor k" trong bản chép thô. Đây là tác dụng phụ bình thường của token hóa dạng streaming và có thể làm sạch bằng các script xử lý hậu kỳ đơn giản.

Là một nhà khoa học dữ liệu được chứng nhận, tôi đam mê tận dụng công nghệ tiên tiến để tạo ra các ứng dụng học máy đổi mới. Với nền tảng vững chắc về nhận dạng giọng nói, phân tích và báo cáo dữ liệu, MLOps, AI hội thoại và NLP, tôi đã rèn giũa kỹ năng phát triển các hệ thống thông minh có thể tạo ra tác động thực sự. Bên cạnh chuyên môn kỹ thuật, tôi cũng là một người truyền đạt tốt, có khả năng chắt lọc các khái niệm phức tạp thành ngôn ngữ rõ ràng, súc tích. Nhờ đó, tôi trở thành một blogger được nhiều người quan tâm trong lĩnh vực khoa học dữ liệu, chia sẻ góc nhìn và kinh nghiệm với cộng đồng các chuyên gia dữ liệu ngày càng lớn. Hiện tại, tôi tập trung vào sáng tạo và biên tập nội dung, làm việc với các mô hình ngôn ngữ lớn để phát triển nội dung mạnh mẽ và hấp dẫn, giúp doanh nghiệp và cá nhân tận dụng tối đa dữ liệu của mình.


Nếu bạn từng dùng ChatGPT ở chế độ giọng nói, hẳn bạn biết trải nghiệm đó ấn tượng thế nào. Trò chuyện với một AI biết lắng nghe, thấu hiểu và phản hồi gần như một người thật có thể tự nhiên đến bất ngờ. Nó cho cảm giác đối thoại, thông minh và nhanh nhạy. Nhưng vẫn còn khoảng cách. Độ trễ nhỏ, khả năng xử lý ngắt lời còn hạn chế, và cảm giác rằng bạn vẫn đang nói chuyện với một hệ thống chứ không phải một con người.
Giờ hãy tưởng tượng một thứ còn tốt hơn. Đó chính là nơi PersonaPlex xuất hiện.
Hãy hình dung một trợ lý giọng nói thời gian thực phản hồi tức thì, cho phép bạn ngắt lời tự nhiên, thích ứng ngay giữa câu, và mang lại cảm giác gần với một cuộc trò chuyện người-với-người hơn rất nhiều. Không độ trễ đáng chú ý. Không khoảng ngắt gượng gạo. Không phụ thuộc đám mây. Chỉ là một đối thoại cục bộ, thời gian thực, mượt mà và sống động.
PersonaPlex là hệ thống tương tác giọng nói cục bộ, thời gian thực do NVIDIA phát triển. Nó được thiết kế để đưa AI dựa trên giọng nói vượt khỏi các pipeline chuyển giọng nói thành văn bản và văn bản thành giọng nói đơn thuần. Thay vào đó, nó cho phép hội thoại dạng streaming với độ trễ thấp, nơi trợ lý có thể nói, lắng nghe và thích ứng liên tục, giống cách một người thật làm trong cuộc trò chuyện trực tiếp.
Trong hướng dẫn này, tôi sẽ đưa bạn đi qua PersonaPlex từng bước. Chúng ta sẽ bắt đầu bằng việc hiểu PersonaPlex là gì và vì sao nó cho cảm giác khác biệt căn bản so với các trợ lý giọng nói điển hình. Sau đó, chúng ta sẽ thiết lập môi trường cục bộ, cài đặt PersonaPlex từ mã nguồn và khởi chạy máy chủ PersonaPlex WebUI. Tiếp theo, chúng ta sẽ tương tác với hệ thống qua giao diện web và cuối cùng là kiểm thử hội thoại giọng nói thời gian thực bằng một script Python.
Tôi khuyến nghị bạn xem khóa học Xử lý ngôn ngữ nói bằng Python để nắm một số nền tảng phía sau PersonaPlex.
PersonaPlex là gì?
PersonaPlex là một hệ thống AI hội thoại mới giúp tương tác bằng giọng nói trở nên thật sự tự nhiên đồng thời vẫn cho phép bạn tùy biến hoàn toàn giọng và cá tính.
Thay vì nghe như một trợ lý điển hình với các khoảng dừng và lượt thoại cứng nhắc, nó cho phép các cuộc trò chuyện mượt mà, thời gian thực, nơi ngắt lời, nhịp điệu và ngữ điệu đều mang cảm giác tự nhiên như con người.
Cốt lõi của PersonaPlex là kiến trúc full-duplex, nghĩa là nó có thể vừa lắng nghe vừa nói cùng lúc.
Thay vì xâu chuỗi các mô hình riêng rẽ cho nhận dạng giọng nói, hiểu ngôn ngữ và tổng hợp giọng nói, nó dựa vào một mô hình thống nhất duy nhất được cập nhật liên tục khi người dùng đang nói.
Voice prompt xác định giọng điệu trợ lý, trong khi text prompt xác định tính cách và cách ứng xử. Sự kết hợp này cho phép PersonaPlex duy trì cá tính nhất quán đồng thời phản hồi tức thời và tự nhiên.
Kiến trúc PersonaPlex | Nguồn: NVIDIA PersonaPlex
PersonaPlex được đánh giá bằng FullDuplexBench và một bộ kiểm thử dịch vụ khách hàng mở rộng gọi là ServiceDuplexBench.
Nó vượt trội hơn các hệ thống mã nguồn mở và thương mại khác về động lực hội thoại, phản hồi độ trễ thấp, xử lý ngắt lời và bám sát nhiệm vụ trong cả bối cảnh trợ lý lẫn chăm sóc khách hàng.
Động lực hội thoại (Cao hơn là tốt hơn) | Nguồn: NVIDIA PersonaPlex
Trong video demo bên dưới, bạn có thể thấy rõ người dùng trò chuyện trôi chảy với mô hình, đùa vui và đối đáp theo thời gian thực.