

एनवायरनमेंट सेटअप करना
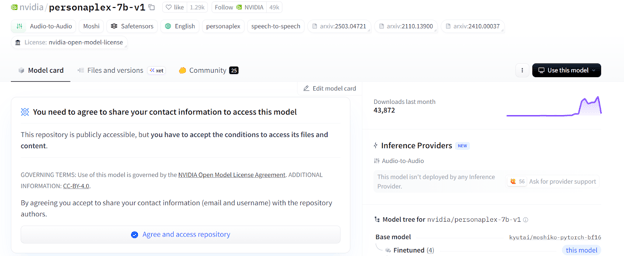
शुरू करने से पहले, Hugging Face के मॉडल पेज पर जाएँ nvidia/personaplex-7b-v1 और मॉडल उपयोग शर्तें स्वीकार करें।
PersonaPlex एक गेटेड मॉडल है, इसलिए आपको एक Hugging Face API टोकन की ज़रूरत होगी। अपने Hugging Face अकाउंट से टोकन जनरेट करें और संभालकर रखें; हम बाद में इसे एनवायरनमेंट वेरिएबल्स में जोड़ेंगे ताकि मॉडल तक पहुँच मिल सके।
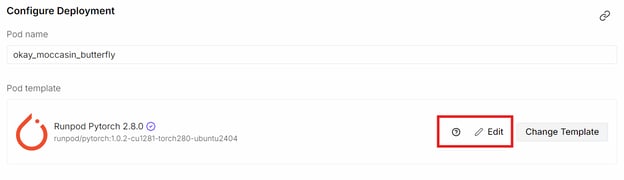
इसके बाद, RunPod पर जाएँ और एक नया A40 GPU पॉड लॉन्च करें। नवीनतम PyTorch इमेज चुनें, फिर एनवायरनमेंट को कस्टमाइज़ करने के लिए Edit पर क्लिक करें।
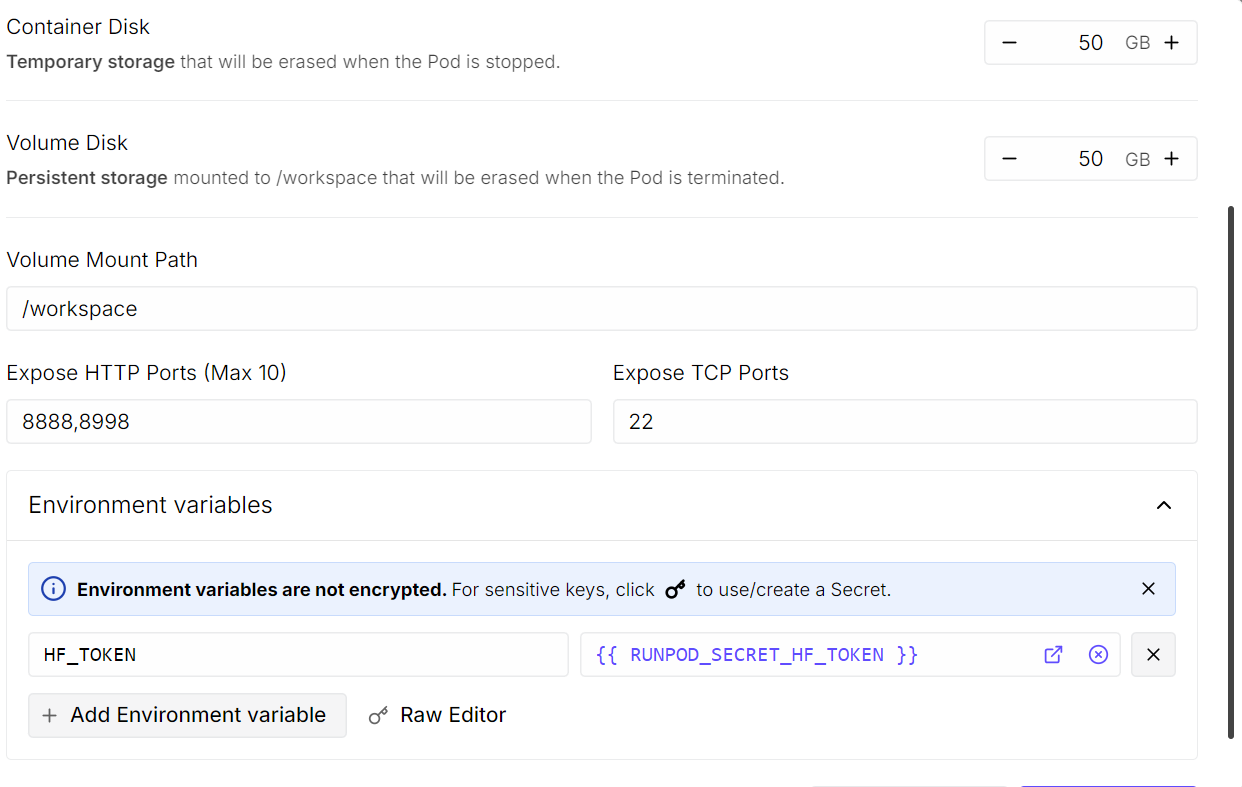
कंटेनर डिस्क साइज को 50 GB तक बढ़ाएँ, क्योंकि मॉडल स्वयं लगभग 20 GB का है, और अतिरिक्त डिपेंडेंसीज़ भी डाउनलोड होंगी। Exposed HTTP ports सेक्शन में पोर्ट 8998 जोड़ें। एनवायरनमेंट वेरिएबल्स के अंतर्गत HF_TOKEN जोड़ें और अपना Hugging Face API टोकन पेस्ट करें।
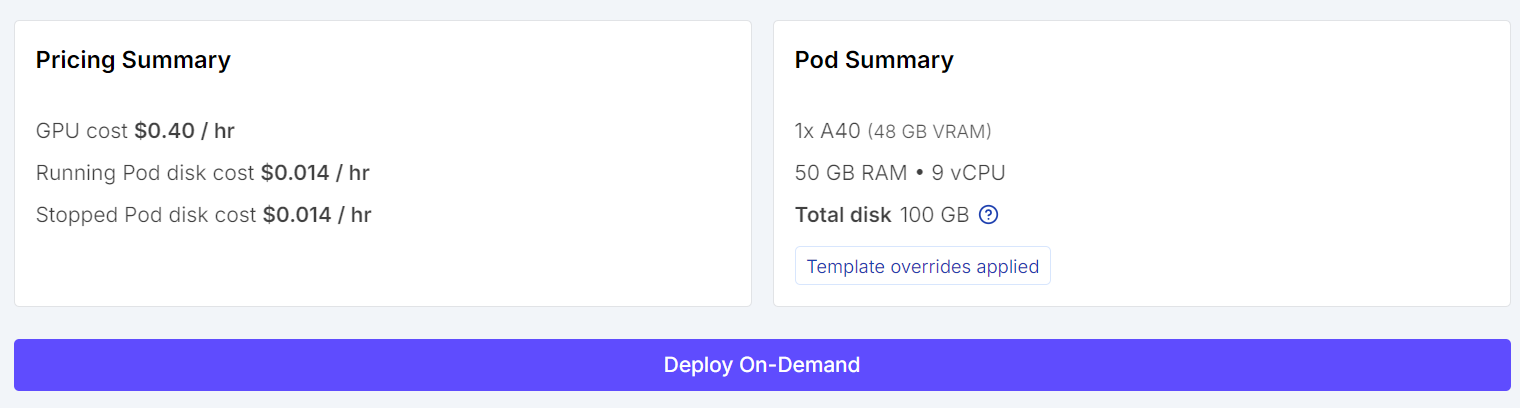
सब कुछ कॉन्फ़िगर हो जाने के बाद, ओवरराइड्स सेव करें और पॉड को डिप्लॉय करें।
पॉड शुरू होने के बाद, आपको JupyterLab इंस्टेंस का लिंक दिखाई देगा। इसे खोलें, फिर एक टर्मिनल लॉन्च करें। आप मशीन को SSH या वेब टर्मिनल से एक्सेस कर सकते हैं, लेकिन Jupyter टर्मिनल का उपयोग सबसे सरल विकल्प है।
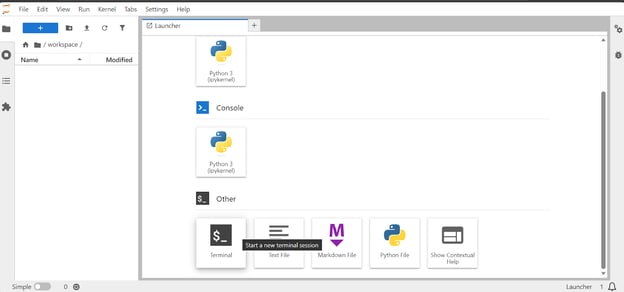
टर्मिनल में, Opus ऑडियो कोडेक डेवलपमेंट लाइब्रेरी इंस्टॉल करें, जो ऑडियो प्रोसेसिंग के लिए आवश्यक है:
sudo apt update
sudo apt install libopus-dev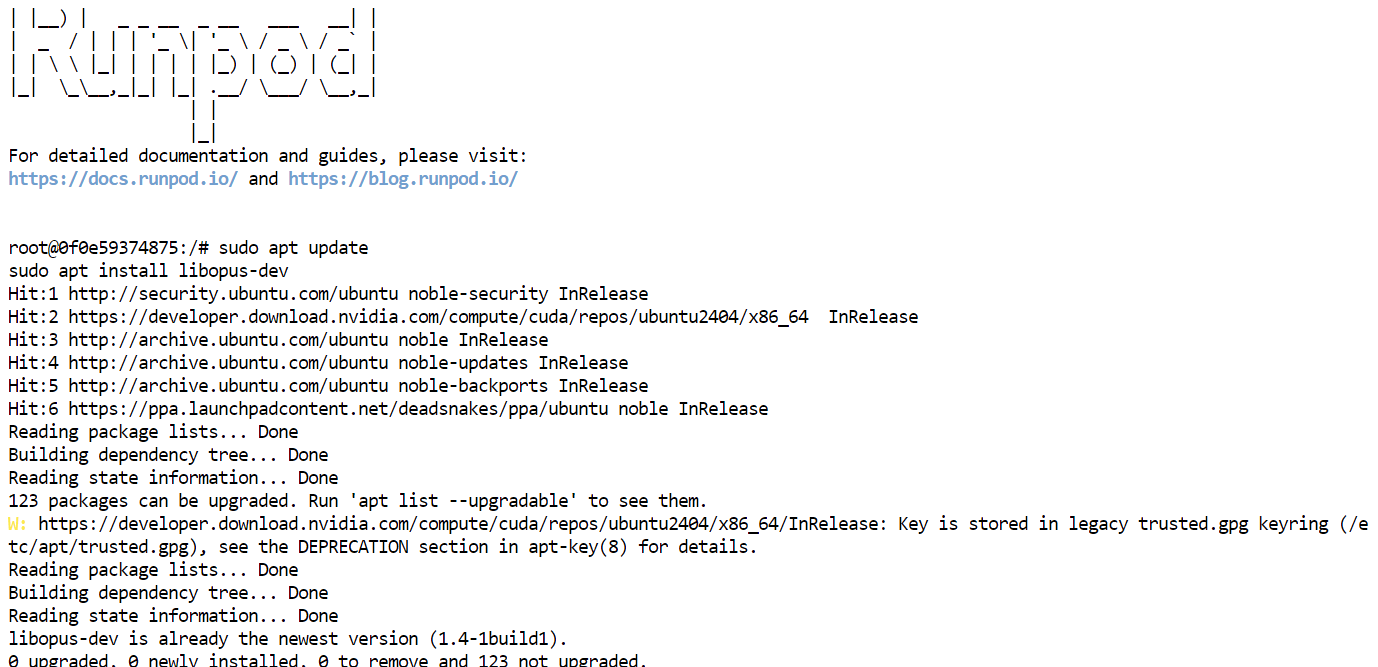
सोर्स से PersonaPlex इंस्टॉल करना
PersonaPlex का कोडबेस NVIDIA द्वारा ओपन-सोर्स किया गया है और GitHub पर उपलब्ध है (NVIDIA/personaplex: PersonaPlex कोड), जिससे इसे लोकल रूप से खोजना, कस्टमाइज़ करना, और चलाना आसान हो जाता है।
सोर्स से इंस्टॉल करने पर आपको सेटअप पर पूरा नियंत्रण मिलता है और रेपो में नवीनतम अपडेट्स के साथ अनुकूलता सुनिश्चित होती है।
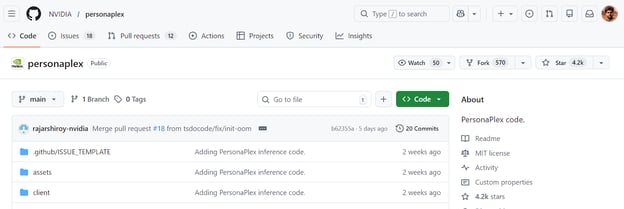
शुरू करने के लिए, PersonaPlex रेपो को क्लोन करें:
git clone https://github.com/NVIDIA/personaplex.git
cd personaplex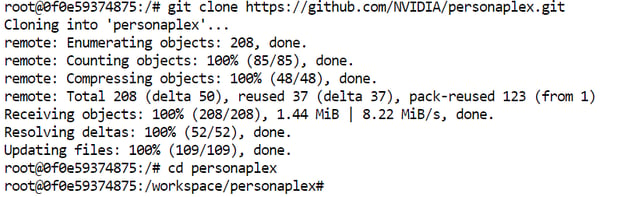
फिर Moshi इंस्टॉल करें, जो PersonaPlex का मूल फुल-डुप्लेक्स स्पीच मॉडल है।
Moshi रियल-टाइम सुनने और बोलने का ज़िम्मेदार है, जिससे PersonaPlex बिना पारंपरिक ASR → LLM → TTS पाइपलाइन पर निर्भर रहे इंटरप्शन, विराम, और स्वाभाविक संवादात्मक टाइमिंग को संभाल पाता है।
इसे सोर्स से इंस्टॉल करने पर यह सुनिश्चित होता है कि सभी ऑडियो, स्ट्रीमिंग, और संवादात्मक कॉम्पोनेंट्स लोकल निष्पादन के लिए सही ढंग से सेट हो जाएँ।
pip install moshi/.एक बार Moshi इंस्टॉल हो जाने पर, आपका एनवायरनमेंट PersonaPlex सर्वर शुरू करने और मॉडल के साथ रियल-टाइम में इंटरैक्ट करने के लिए पूरी तरह तैयार है।
PersonaPlex WebUI सर्वर शुरू करना
एनवायरनमेंट और डिपेंडेंसीज़ तैयार होने के साथ, अब आप PersonaPlex WebUI सर्वर शुरू कर सकते हैं। टर्मिनल में, PersonaPlex को शक्ति देने वाले Moshi सर्वर को लॉन्च करने के लिए निम्न कमांड चलाएँ:
python -m moshi.server --host 0.0.0.0 --port 8998पहली बार यह कमांड चलाने पर, सर्वर स्वचालित रूप से PersonaPlex मॉडल और अन्य आवश्यक फ़ाइलें डाउनलोड करेगा। मॉडल काफ़ी बड़ा है, इसलिए यह चरण आपके नेटवर्क की गति के अनुसार कुछ मिनट ले सकता है।
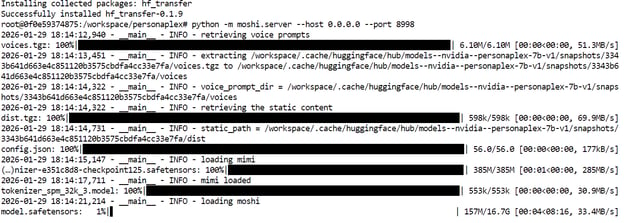
डाउनलोड पूरा होने पर, सर्वर पोर्ट 8998 पर सुनना शुरू कर देगा।
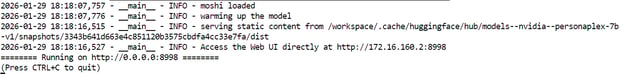
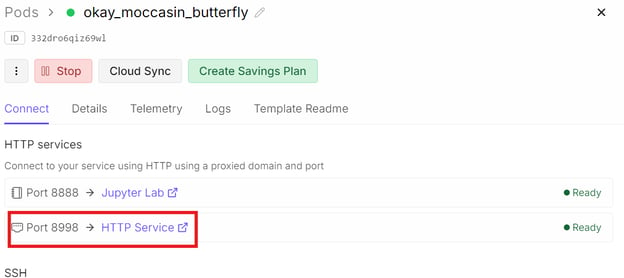
WebUI तक पहुँचने के लिए, अपने RunPod डैशबोर्ड पर वापस जाएँ।
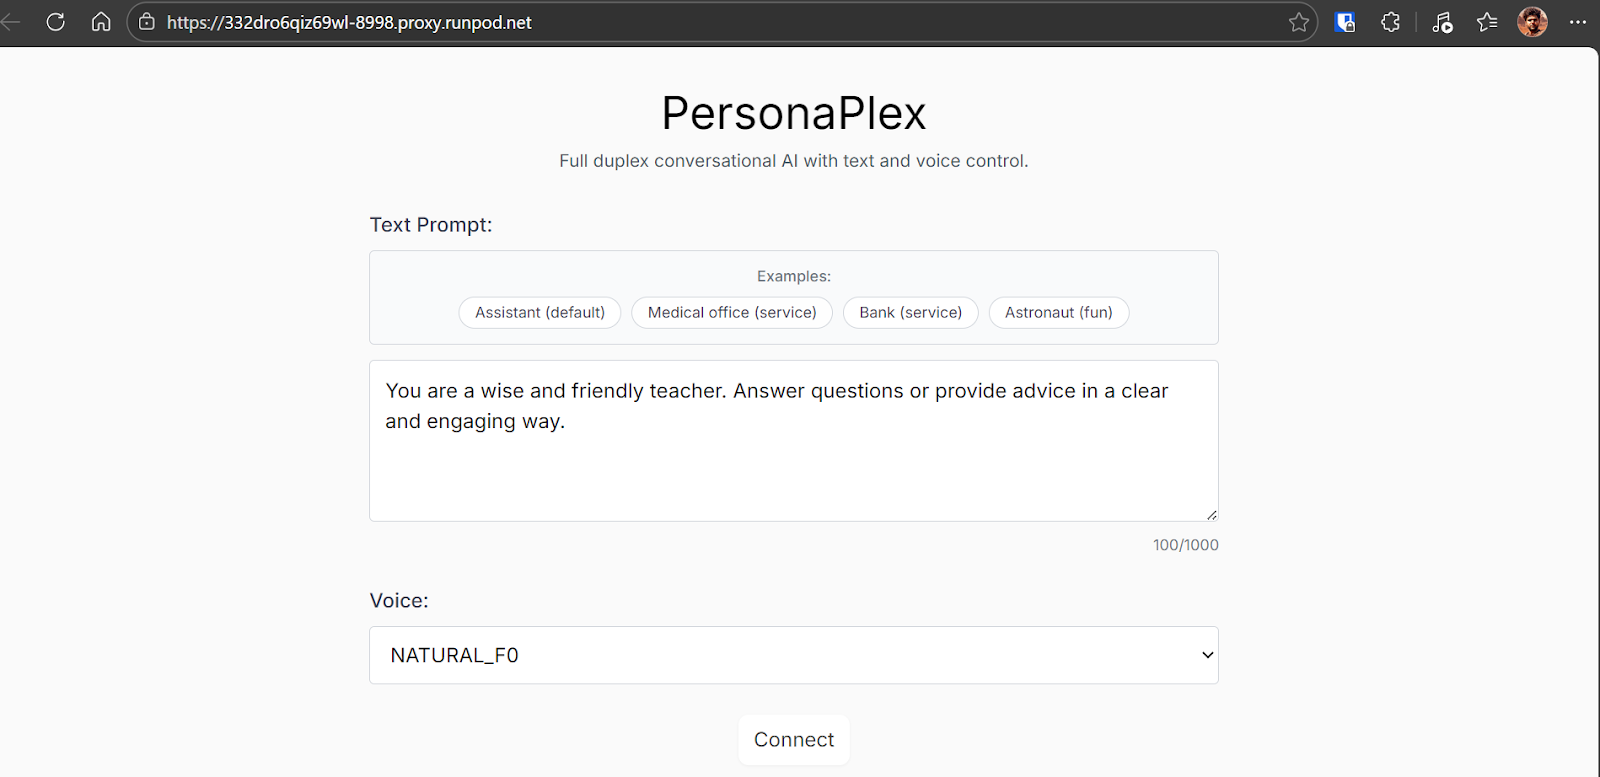
Connect सेक्शन में, एक्सपोज़्ड पोर्ट 8998 ढूँढें और दिए गए लिंक पर क्लिक करें। यह आपके ब्राउज़र में PersonaPlex WebUI खोलेगा, जहाँ आप रियल-टाइम वॉइस बातचीत के माध्यम से मॉडल के साथ इंटरैक्ट करना शुरू कर सकते हैं।
WebUI का उपयोग करके PersonaPlex का परीक्षण
PersonaPlex WebUI कई उदाहरण प्रॉम्प्ट्स के साथ आता है ताकि आप शुरुआत कर सकें, और आप असिस्टेंट की भूमिका और बर्ताव तय करने के लिए अपना कस्टम प्रॉम्प्ट भी बना सकते हैं।
कनेक्ट करने से पहले आप एक वॉइस चुन सकते हैं, जो बातचीत के दौरान पर्सोना की आवाज़ निर्धारित करती है।
इस ट्यूटोरियल के लिए, सिस्टम का अनुभव लेने के लिए डिफ़ॉल्ट सेटिंग्स से शुरुआत करना सबसे अच्छा है।
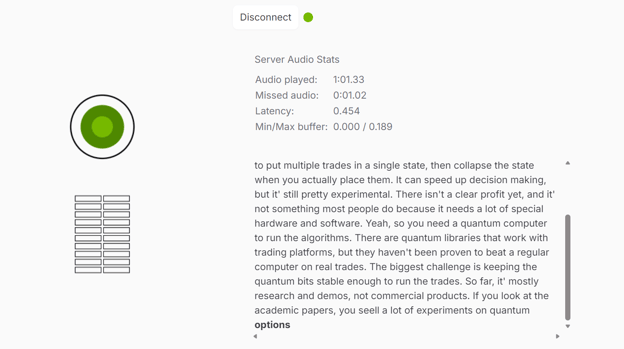
Connect बटन पर क्लिक करने के बाद, आप इंटरैक्टिव सत्र में पहुँच जाएँगे। यहाँ, आप सीधे मॉडल से बात कर सकते हैं, उसके जवाब रियल-टाइम में सुन सकते हैं, और साथ-साथ बातचीत का लाइव ट्रांस्क्रिप्ट भी देख सकते हैं।
अनुभव प्रवाही लगता है, स्वाभाविक टाइमिंग के साथ और जल्दी से बीच में बोलने या प्रतिक्रिया देने की क्षमता के साथ।
मेरे परीक्षण के दौरान, इंटरैक्शन उम्मीद से भी ज्यादा स्वाभाविक और आकर्षक लगा।
कभी-कभी हल्का अटकना दिखा, जो संभवतः ब्राउज़र या सिस्टम लोड के कारण था, न कि मॉडल के कारण। इसके अलावा, बातचीत किसी वास्तविक व्यक्ति से बात करने के काफी करीब महसूस हुई।
जब आप सहज हो जाएँ, तो अलग-अलग प्रॉम्प्ट्स और आवाज़ों के साथ प्रयोग करें। PersonaPlex कई प्री-पैकेज्ड वॉइस एम्बेडिंग्स सपोर्ट करता है, जिनमें अधिक स्वाभाविक संवादात्मक आवाज़ें और अधिक अभिव्यंजक वैरिएंट शामिल हैं:
- Natural (महिला): NATF0, NATF1, NATF2, NATF3
- Natural (पुरुष): NATM0, NATM1, NATM2, NATM3
- Variety (महिला): VARF0, VARF1, VARF2, VARF3, VARF4
- Variety (पुरुष): VARM0, VARM1, VARM2, VARM3, VARM4
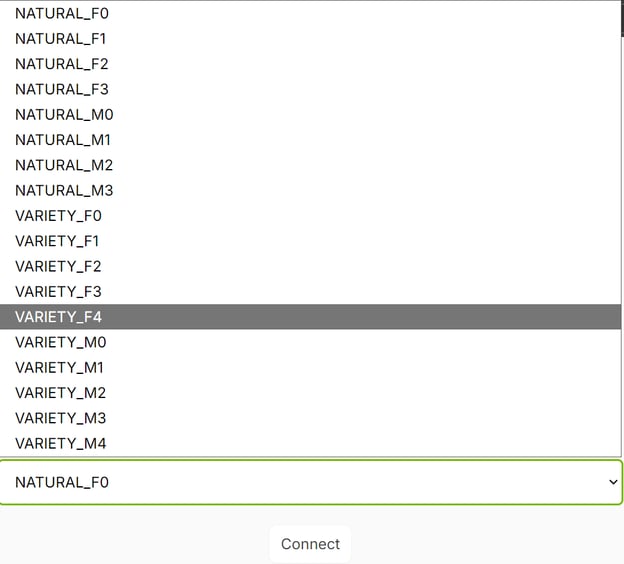
आवाज़ों और प्रॉम्प्ट्स के बीच स्विच करना यह खोजने का बेहतरीन तरीका है कि PersonaPlex कैसे अलग-अलग भूमिकाओं और बोलने की शैलियों में व्यक्तित्व, टोन, और संवाद प्रवाह बनाए रखता है।
Python के साथ PersonaPlex ऑफ़लाइन चलाना
WebUI रियल-टाइम बातचीत के लिए बेहतरीन है, लेकिन आप PersonaPlex को ऑफ़लाइन भी Python से चला सकते हैं। यह तब उपयोगी है जब आप पुनरुत्पाद्य (repeatable) आउटपुट चाहते हैं, अलग-अलग प्रॉम्प्ट्स को जल्दी जाँचना चाहते हैं, या डेमो और प्रयोगों में दोबारा उपयोग के लिए ऑडियो फ़ाइलें बनाना चाहते हैं।
ऑफ़लाइन फ्लो सरल है: आप (1) एक वॉइस प्रॉम्प्ट, (2) एक टेक्स्ट प्रॉम्प्ट, और (3) एक इनपुट WAV फ़ाइल देते हैं। इसके बाद PersonaPlex एक आउटपुट ऑडियो प्रतिक्रिया और मॉडल के ट्रांस्क्रिप्ट वाला एक JSON फ़ाइल जेनरेट करता है।
Jupyter में नया नोटबुक शुरू करें और डायरेक्टरी को क्लोन किए गए रेपो पर बदलें:
%cd personaplexनई सेल में निम्न चलाएँ। यह ऑफ़लाइन रनर को कॉल करता है और जेनरेटेड ऑडियो तथा ट्रांस्क्रिप्ट दोनों को डिस्क पर लिख देता है:
%%capture
!python -m moshi.offline \
--voice-prompt "NATF2.pt" \
--text-prompt "You are a wise and friendly teacher. Answer questions in a clear, engaging way." \
--input-wav "assets/test/input_assistant.wav" \
--seed 42424242 \
--output-wav "out_teacher.wav" \
--output-text "out_teacher.json"हर फ्लैग क्या करता है:
--voice-promptवॉइस एम्बेडिंग चुनता है (यहाँ, एक स्वाभाविक महिला आवाज़)।--text-promptअसिस्टेंट की भूमिका और बर्ताव परिभाषित करता है।--input-wavवह रिकॉर्डेड यूज़र ऑडियो है जिस पर मॉडल प्रतिक्रिया देगा।--seedआउटपुट को रन के बीच अधिक पुनरुत्पाद्य बनाता है।--output-wavजेनरेटेड बोले गए जवाब की फ़ाइल है।--output-textट्रांस्क्रिप्ट आउटपुट को JSON के रूप में सेव करता है।
कमांड पूरा होने के बाद, आप सीधे प्रतिक्रिया ऑडियो चला सकते हैं:
from IPython.display import Audio
Audio("out_teacher.wav")आप चुनी गई आवाज़ में एक साफ़, स्वाभाविक प्रतिक्रिया सुन पाएँगे, जो आपके टेक्स्ट प्रॉम्प्ट में परिभाषित पर्सोना से मेल खाती है।
JSON ट्रांस्क्रिप्ट में कभी-कभी टोकनाइज़ेशन आर्टिफैक्ट्स हो सकते हैं, जैसे विराम चिह्नों के आसपास अतिरिक्त स्पेस या शब्दों के टुकड़े। नीचे दिया गया हेल्पर JSON लोड करता है और उसे पठनीय टेक्स्ट में साफ़ करता है।
import json
import re
with open("out_teacher.json") as f:
data = json.load(f)
def detokenize(tokens):
# 1) drop padding-like tokens
drop = {"PAD", "EPAD", "<pad>", "</s>", "<s>"}
toks = [t for t in tokens if t not in drop]
# 2) join with spaces first
s = " ".join(toks)
# 3) fix spacing around punctuation
s = re.sub(r"\s+([.,!?;:])", r"\1", s)
# 4) fix common split contractions: "it ' s" -> "it's"
s = s.replace(" ' s", "'s").replace(" n't", "n't").replace(" 're", "'re").replace(" 'm", "'m").replace(" 've", "'ve").replace(" 'd", "'d")
# 5) fix stray spaces around apostrophes
s = re.sub(r"\s+'\s+", "'", s)
# 6) fix cases like "for k" -> "fork" and "fl uff" -> "fluff"
# (general rule: merge single-letter fragments if they look like split wordpieces)
s = re.sub(r"\b([A-Za-z])\s+([A-Za-z]{1,3})\b", r"\1\2", s)
# 7) collapse multiple spaces
s = re.sub(r"\s{2,}", " ", s).strip()
return s
clean_text = detokenize(data) # replace with your list variable
clean_textअब आपको एक पठनीय ट्रांस्क्रिप्ट स्ट्रिंग दिखनी चाहिए जो जेनरेटेड ऑडियो से मेल खाती हो। अगर आपके आउटपुट में अभी भी अजीब से विभाजन (उदाहरण के लिए, “fl uff” या “afor k”) हों, तो यह कुछ रनों के लिए सामान्य है और अतिरिक्त नियमों से और साफ़ किया जा सकता है, लेकिन मुख्य सामग्री पहले से ही समझ में आनी चाहिए।
"Hey, let me know if you have any questions.
Hmm, first rinse the rice a couple of times until the water runs clear, that cuts down on starch, then use apot with a tight fitting lid, bring to a boil,
give it a quick stir, then turn the heat down low and cover, let it s immer without lifting it, and when it'done fl uff it with afor k, that usually
You could to ss the hot rice with a nice handful of chopped fresh herbs like basil or par sley, or you could sprinkle a little g rated cheese,
a squeeze of lemon or lime, adr izzle of olive oil, some chopped fresh herbs, or even some to ast ed nuts, that adds color and flavor."अंतिम विचार
PersonaPlex का परीक्षण वास्तव में मुझे चकित कर गया। पहली ही इंटरैक्शन से, यह किसी मॉडल के साथ प्रयोग करने जैसा कम और एक वास्तविक बातचीत जैसा अधिक लगा। स्वाभाविक रूप से बीच में बोल पाने, तुरंत जवाब पाने, और पूरे समय एकसमान व्यक्तित्व बनाए रखने से यह अधिकांश वॉइस सिस्टम्स से कहीं आगे महसूस हुआ जो मैंने आज़माए हैं। सब कुछ लोकल तौर पर चलने से अनुभव और भी प्रभावशाली हो गया—ना के बराबर देरी और नियंत्रण में कोई कमी नहीं।
फिर भी कुछ कमियाँ हैं। कभी-कभी अटकना देखा, और एक बार बातचीत आगे बढ़ जाने पर, यह हमेशा पहले के विषय पर सहजता से लौट नहीं पाता।
यह अभी गैर-अंग्रेज़ी ऐक्सेंट्स को पूरी तरह नहीं समझता, जिससे नामों का गलत उच्चारण या अपूर्ण ट्रांस्क्रिप्शन हो सकता है। ये बुनियादी समस्याएँ नहीं, बल्कि किनारी (edge) मामले लगते हैं, और मुझे विश्वास है कि ये जल्दी सुधरेंगे।
मुझे यक़ीन है कि भविष्य में ये मुद्दे हल हो जाएँगे, और हमें और भी बेहतर, पूरी तरह लोकल और रियल-टाइम संवादात्मक AI मिलेगा जो GPT-5.2 की तर्क-क्षमता को ElevenLabs की वॉइस क्वालिटी से जोड़ देगा।
PersonaPlex FAQs
PersonaPlex को लोकल रूप से चलाने के लिए मुझे किस हार्डवेयर की ज़रूरत है?
NVIDIA 7B मॉडल को लो लेटेंसी के साथ स्मूद चलाने के लिए कम से कम 24 GB VRAM (जैसे A10G, A40, या RTX 3090/4090) वाले GPU की सिफारिश करता है। आपको CUDA सपोर्ट वाले Linux एनवायरनमेंट की भी ज़रूरत होगी। हालाँकि लेयर्स को CPU पर ऑफ़लोड करना संभव है, लेकिन इससे रियल-टाइम प्रदर्शन, जो इस मॉडल की खासियत है, काफ़ी प्रभावित होगा।
क्या PersonaPlex अंग्रेज़ी के अलावा अन्य भाषाएँ बोल सकता है?
फ़िलहाल, v1 रिलीज़ सिर्फ़ अंग्रेज़ी के लिए है। आर्किटेक्चर बहुभाषी सपोर्ट करता है, और NVIDIA ने संकेत दिया है कि अन्य भाषाओं (जैसे स्पैनिश) का सपोर्ट भविष्य के अपडेट्स में आएगा, लेकिन अभी यह अंग्रेज़ी बातचीत के लिए अनुकूलित है।
क्या मैं इसे वाणिज्यिक अनुप्रयोगों के लिए उपयोग कर सकता/सकती हूँ?
हाँ। मॉडल वेट्स NVIDIA Open Model License के अंतर्गत जारी किए गए हैं, जो आम तौर पर वाणिज्यिक उपयोग की अनुमति देता है। फिर भी, आपको अपने उपयोग-मामले (जैसे, पेड सर्विस होस्ट करना) के अनुपालन हेतु Hugging Face मॉडल कार्ड पर दिए गए विशेष लाइसेंस समझौते की समीक्षा करनी चाहिए।
यह faster-whisper और एक तेज़ LLM उपयोग करने से अलग कैसे है?
पारंपरिक सिस्टम "हाफ़-डुप्लेक्स" होते हैं—वे आपके बोलने के ख़त्म होने का इंतज़ार करते हैं, ऑडियो को ट्रांसक्राइब करते हैं, सोचते हैं, और फिर बोलते हैं। PersonaPlex "फुल-डुप्लेक्स" है, यानी यह लगातार ऑडियो प्रोसेस करता और टोकन जेनरेट करता है। इससे यह बोलते हुए भी सुन सकता है, इंटरप्शन को स्वाभाविक रूप से संभाल सकता है, और बैकचैनल्स ("उह-हूँ", "राइट") बिना टर्न-बेस्ड सिस्टम्स की अटपटी लेटेंसी के जेनरेट कर सकता है।
मॉडल कभी-कभी नामों का गलत उच्चारण या ट्रांस्क्रिप्ट में शब्दों को बाँटकर क्यों दिखाता है?
क्योंकि PersonaPlex रियल-टाइम फ़्रेम्स (24kHz) में ऑडियो टोकन स्ट्रीम करता है, टेक्स्ट टोकन कभी-कभी स्प्लिट फ़्रेम्स में जेनरेट होते हैं। इससे कच्चे ट्रांस्क्रिप्ट में "fl uff" या "afor k" जैसे आर्टिफैक्ट्स दिख सकते हैं। ये स्ट्रीमिंग टोकनाइज़ेशन के सामान्य साइड इफेक्ट्स हैं और सरल पोस्ट-प्रोसेसिंग स्क्रिप्ट्स से साफ़ किए जा सकते हैं।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
अगर आपने कभी ChatGPT को वॉइस मोड में इस्तेमाल किया है, तो आप जानते हैं कि वह कितना प्रभावशाली लगता है। ऐसे AI से बात करना जो सुनता है, समझता है, और किसी असली इंसान की तरह लगभग तुरंत जवाब देता है, चौंकाने वाली तरह से स्वाभाविक लगता है। यह संवादात्मक, बुद्धिमान, और प्रतिक्रियाशील लगता है। लेकिन अभी भी एक फासला है—हल्की देर, सीमित इंटरप्शन हैंडलिंग, और यह अहसास कि आप किसी व्यक्ति नहीं, बल्कि एक सिस्टम से बात कर रहे हैं।
अब कुछ बेहतर की कल्पना कीजिए। यहीं पर PersonaPlex काम आता है।
एक रियल-टाइम वॉइस असिस्टेंट की कल्पना करें जो तुरंत प्रतिक्रिया दे, आपको स्वाभाविक रूप से बीच में टोकने दे, वाक्य के बीच में ही ढल जाए, और एक असली मानव बातचीत के और भी करीब महसूस हो। कोई दिखाई देने वाली देरी नहीं। कोई अटपटा विराम नहीं। कोई क्लाउड पर निर्भरता नहीं। बस एक सुगम, लोकल, रियल-टाइम संवाद जो जीवंत लगे।
PersonaPlex NVIDIA द्वारा विकसित एक रियल-टाइम, लोकल वॉइस इंटरैक्शन सिस्टम है। इसे वॉइस-आधारित AI को साधारण स्पीच-टू-टेक्स्ट और टेक्स्ट-टू-स्पीच पाइपलाइनों से आगे ले जाने के लिए डिज़ाइन किया गया है। इसके बजाय, यह लो-लेटेंसी, स्ट्रीमिंग बातचीत सक्षम करता है, जहाँ असिस्टेंट लगातार बोल सकता है, सुन सकता है, और ढल सकता है—ठीक वैसे ही जैसे आमने-सामने बातचीत में कोई व्यक्ति करता है।
इस ट्यूटोरियल में, मैं आपको PersonaPlex को चरण-दर-चरण समझाऊँगा। हम शुरुआत करेंगे कि PersonaPlex क्या है और यह सामान्य वॉइस असिस्टेंट्स से बुनियादी तौर पर अलग क्यों महसूस होता है। फिर, हम लोकल एनवायरनमेंट सेटअप करेंगे, सोर्स से PersonaPlex इंस्टॉल करेंगे, और PersonaPlex WebUI सर्वर लॉन्च करेंगे। इसके बाद, हम वेब इंटरफेस के ज़रिए सिस्टम के साथ इंटरैक्ट करेंगे और अंत में एक Python स्क्रिप्ट का उपयोग कर रियल-टाइम वॉइस बातचीत का परीक्षण करेंगे।
मैं अनुशंसा करता हूँ कि आप Spoken Language Processing in Python कोर्स देखें ताकि PersonaPlex के पीछे के कुछ मूल सिद्धांतों के बारे में जान सकें।
PersonaPlex क्या है?
PersonaPlex एक नया संवादात्मक AI सिस्टम है जो वॉइस इंटरैक्शंस को वास्तव में स्वाभाविक महसूस कराता है, जबकि आपको आवाज़ और पर्सोना को पूरी तरह कस्टमाइज़ करने देता है।
सामान्य असिस्टेंट की तरह ठहराव और कड़े बारी-बारी से बोलने के बजाय, यह ऐसे सुगम, रियल-टाइम संवाद सक्षम करता है जहाँ इंटरप्शन, टाइमिंग, और टोन मानवीय लगते हैं।
इसके मूल में, PersonaPlex फुल-डुप्लेक्स आर्किटेक्चर का उपयोग करता है, यानी यह एक ही समय में सुन और बोल सकता है।
स्पीच रिकॉग्निशन, भाषा समझ, और स्पीच जेनरेशन के अलग-अलग मॉडलों को जोड़ने के बजाय, यह एक एकीकृत मॉडल पर निर्भर करता है जो उपयोगकर्ता के बोलते समय लगातार अपडेट होता रहता है।
वॉइस प्रॉम्प्ट यह तय करते हैं कि असिस्टेंट कैसे सुनाई देगा, जबकि टेक्स्ट प्रॉम्प्ट यह तय करते हैं कि वह कौन है और कैसे बर्ताव करना चाहिए। यह संयोजन PersonaPlex को एकसमान पर्सोना बनाए रखने में सक्षम बनाता है, जबकि वह तुरंत और स्वाभाविक रूप से प्रतिक्रिया देता है।
PersonaPlex आर्किटेक्चर | स्रोत: NVIDIA PersonaPlex
PersonaPlex का मूल्यांकन FullDuplexBench और ServiceDuplexBench नामक विस्तृत कस्टमर सर्विस बेंचमार्क का उपयोग करके किया जाता है।
यह संवादात्मक गतिशीलता, लो-लेटेंसी प्रतिक्रियाओं, इंटरप्शन हैंडलिंग, और टास्क अनुपालन में अन्य ओपन-सोर्स और व्यावसायिक प्रणालियों से बेहतर प्रदर्शन करता है—चाहे असिस्टेंट हो या कस्टमर सर्विस परिदृश्य।
Conversation Dynamics (ज्यादा होना बेहतर) | स्रोत: NVIDIA PersonaPlex
नीचे दिए गए वीडियो डेमो में, आप स्पष्ट रूप से देख सकते हैं कि व्यक्ति मॉडल के साथ रियल-टाइम में मज़ाक-मजाक और बातचीत कर रहा है।