

环境准备
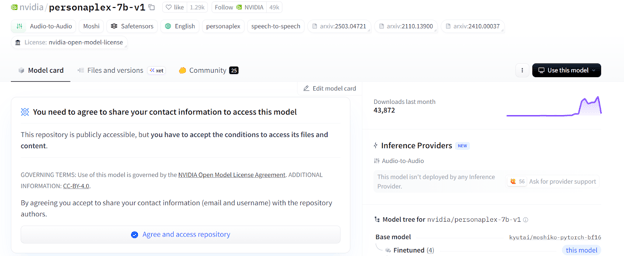
开始之前,请访问 Hugging Face 模型页面 nvidia/personaplex-7b-v1 并接受模型使用条款。
PersonaPlex 是门控模型,您需要一个 Hugging Face API 令牌。请在 Hugging Face 账户中生成令牌并保留,稍后我们会将其添加到环境变量以允许访问模型。
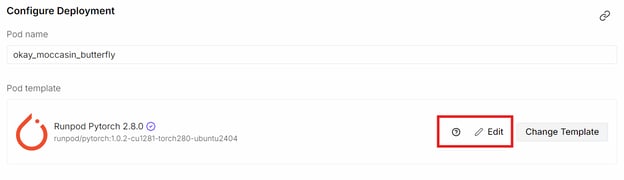
接着前往 RunPod 并启动一个新的 A40 GPU pod。选择最新的 PyTorch 镜像,然后点击 Edit 进行环境自定义。
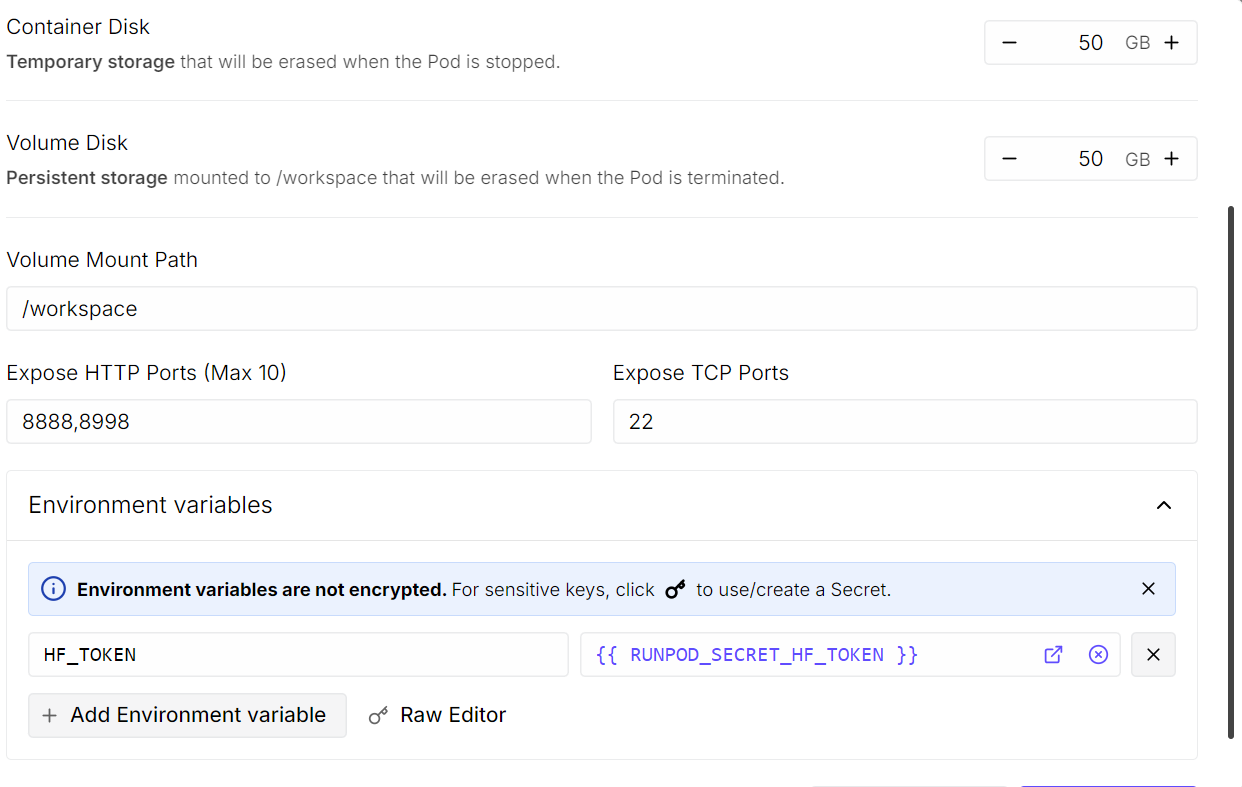
将容器磁盘大小增加到 50 GB,因为模型本身约 20 GB,且还需要下载额外依赖。在 Exposed HTTP ports 一栏添加 端口 8998。在环境变量中添加 HF_TOKEN,并粘贴您的 Hugging Face API 令牌。
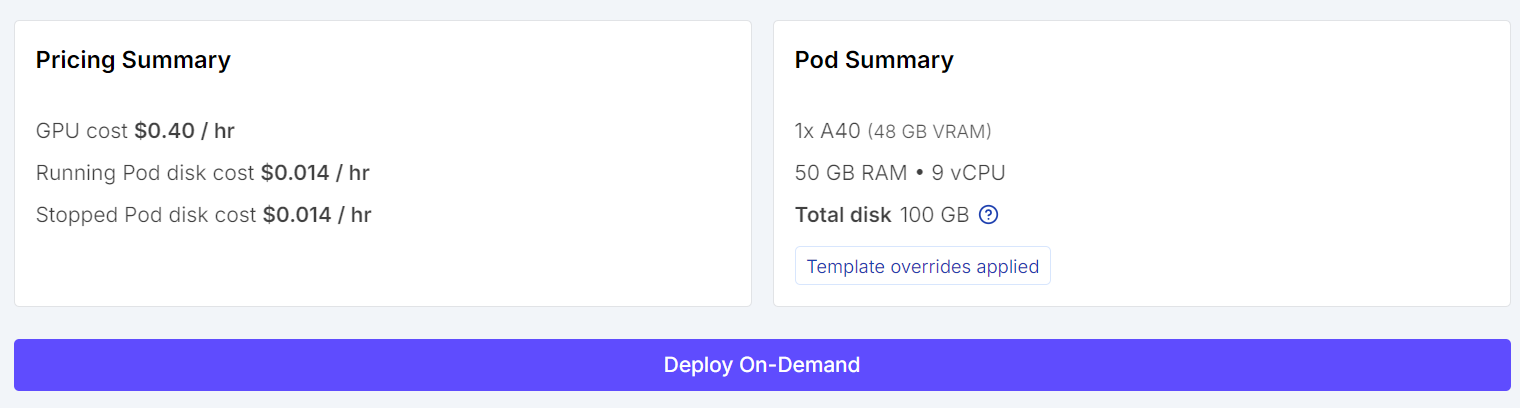
配置完成后,保存覆盖项并部署 pod。
pod 启动后,您会看到 JupyterLab 实例的链接。打开它,然后启动一个终端。您可以通过 SSH 或网页终端访问这台机器,但使用 Jupyter 的终端最为简单。
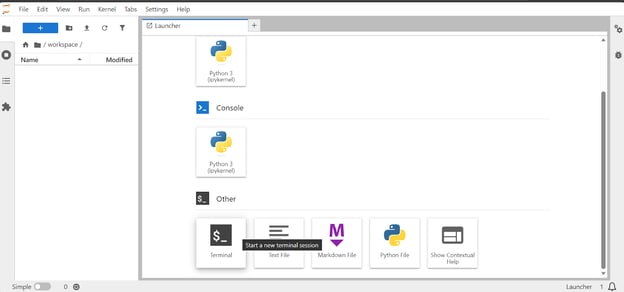
在终端中安装 Opus 音频编解码器的开发库,它是音频处理所必需的:
sudo apt update
sudo apt install libopus-dev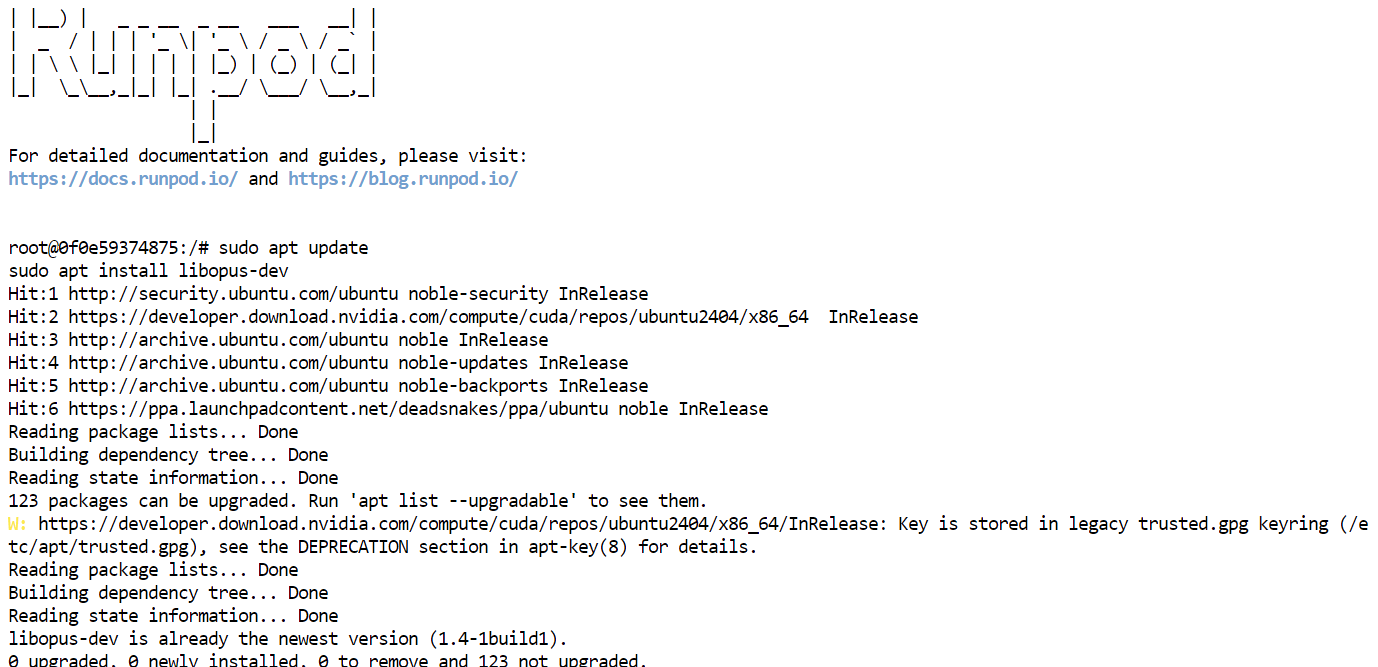
从源码安装 PersonaPlex
PersonaPlex 代码库由 NVIDIA 开源并托管在 GitHub(NVIDIA/personaplex: PersonaPlex code),便于本地探索、定制与运行。
从源码安装可让您完全掌控安装过程,并确保与仓库中的最新更新兼容。
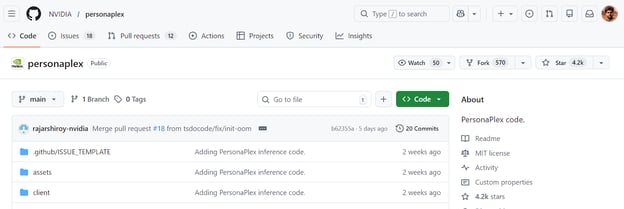
首先克隆 PersonaPlex 仓库:
git clone https://github.com/NVIDIA/personaplex.git
cd personaplex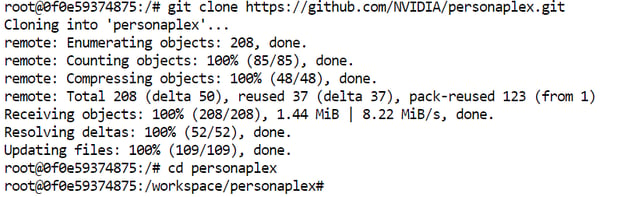
然后安装 PersonaPlex 构建所依赖的核心全双工语音模型 Moshi。
Moshi 负责实时的“听”和“说”,使 PersonaPlex 无需依赖传统的 ASR → LLM → TTS 流水线,即可处理打断、停顿与自然的对话时序。
从源码安装可确保本地执行所需的音频、流式与对话组件正确配置。
pip install moshi/.安装 Moshi 完成后,您的环境就已准备好启动 PersonaPlex 服务器,并与模型进行实时交互。
启动 PersonaPlex WebUI 服务器
环境与依赖就绪后,您就可以启动 PersonaPlex 的 WebUI 服务器了。在终端运行以下命令,启动为 PersonaPlex 提供支持的 Moshi 服务器:
python -m moshi.server --host 0.0.0.0 --port 8998首次运行该命令时,服务器会自动下载 PersonaPlex 模型及其他必要文件。由于模型体积较大,此步骤可能需要几分钟,具体取决于您的网络速度。
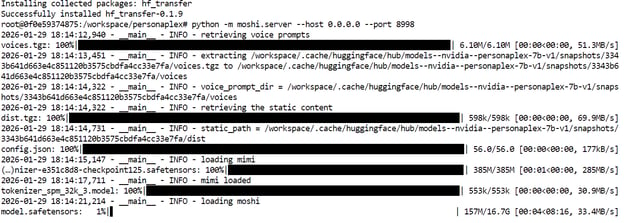
下载完成后,服务器将开始监听 8998 端口。
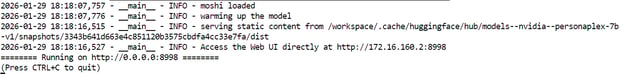
要访问 WebUI,请返回 RunPod 控制台。
在 Connect 区域找到暴露的 8998 端口并点击提供的链接。这将会在浏览器中打开 PersonaPlex 的 WebUI,您可以在其中开始进行实时语音对话。
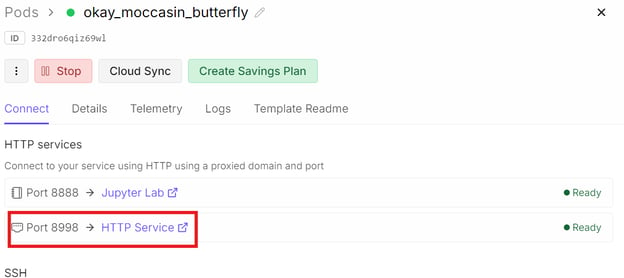
通过 WebUI 测试 PersonaPlex
PersonaPlex 的 WebUI 自带多个示例提示词,便于您快速上手,您也可以创建自定义提示词来定义助手的角色与行为。
您可以在连接前选择声音,决定对话中 persona 的音色。
对于本教程,建议先使用默认设置,感受系统的基本体验。
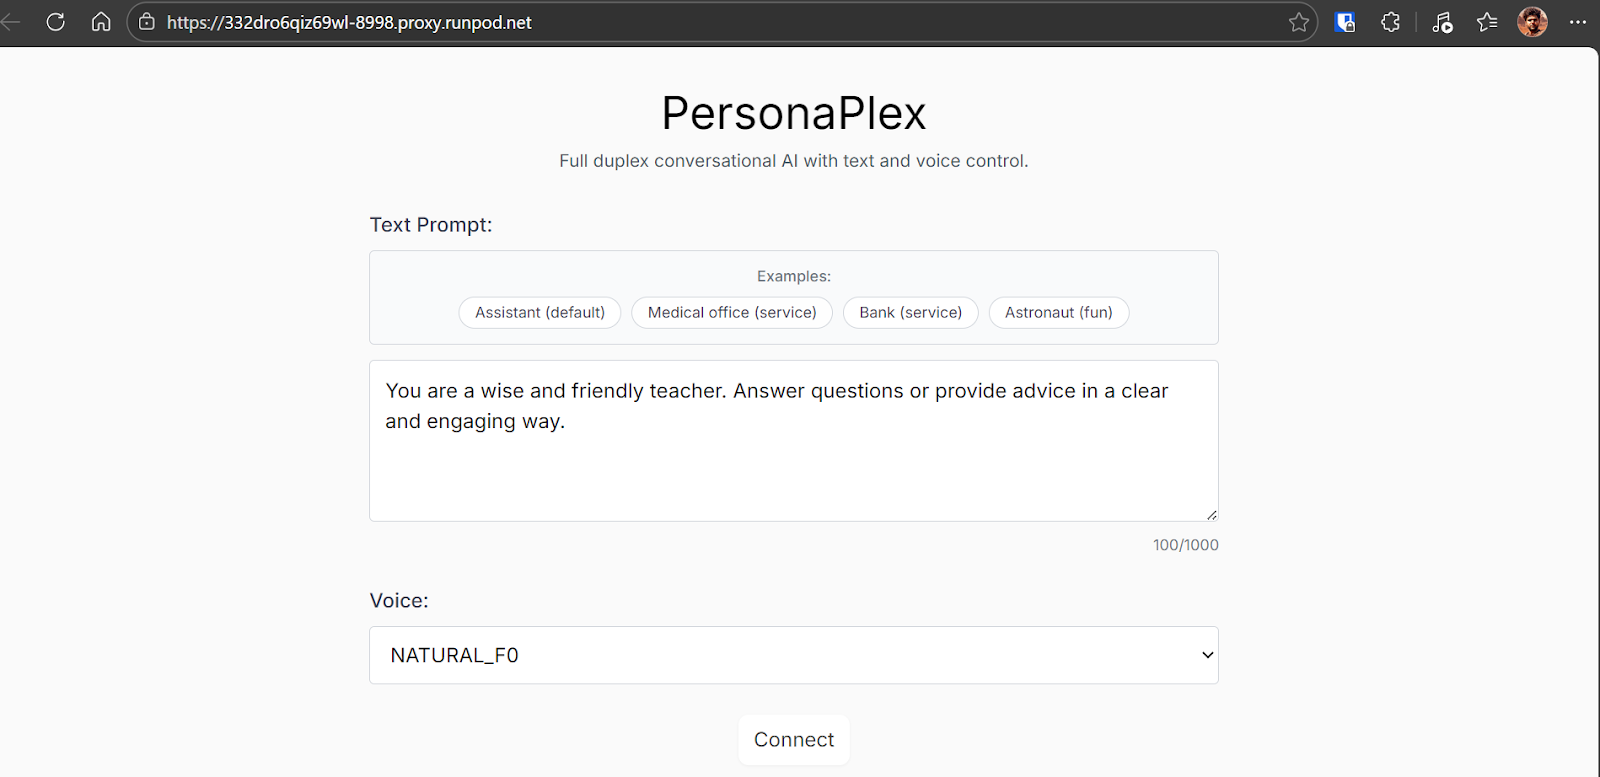
点击 Connect 按钮后,您将进入交互会话。在这里,您可以直接对模型说话,实时听到它的回应,并看到同时生成的对话文字记录。
整体体验流畅,节奏自然,并支持快速打断与响应。
在我的测试中,交互感受出乎意料地自然且引人入胜。
我注意到偶尔会有卡顿,这更可能是浏览器或系统负载所致,而非模型本身。除此之外,对话体验已非常接近与真人交谈。
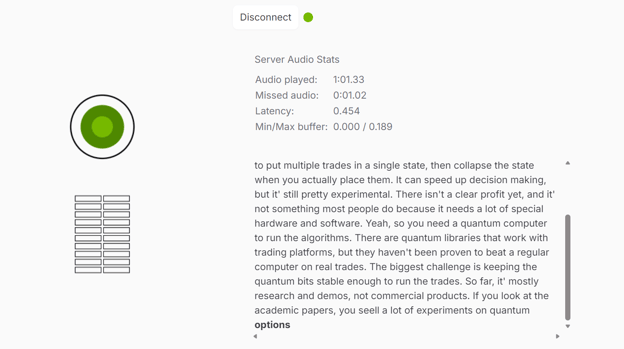
熟悉之后,尝试不同的提示词与声音。PersonaPlex 支持多种预置的语音嵌入,包括更自然的会话音色和更具表现力的变体:
- 自然(女声):NATF0、NATF1、NATF2、NATF3
- 自然(男声):NATM0、NATM1、NATM2、NATM3
- 多样(女声):VARF0、VARF1、VARF2、VARF3、VARF4
- 多样(男声):VARM0、VARM1、VARM2、VARM3、VARM4
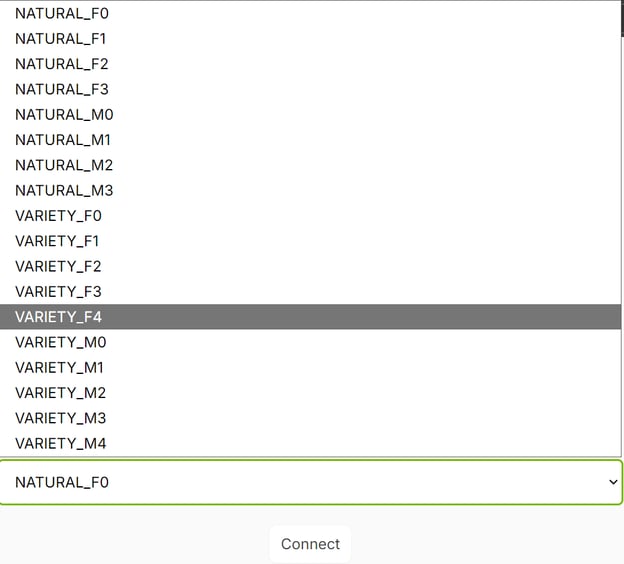
在不同声音与提示词之间切换,是探索 PersonaPlex 如何在不同角色与说话风格下保持人格、语气和对话流畅性的好方式。
使用 Python 离线运行 PersonaPlex
WebUI 非常适合实时对话,但您也可以在 Python 中离线运行 PersonaPlex。当您需要可重复的输出、想快速测试不同提示词,或想生成可在演示与实验中复用的音频文件时,这非常有用。
离线路径很简单:提供(1)语音提示,(2)文本提示,以及(3)一个输入 WAV 文件。PersonaPlex 随后会生成一个输出音频响应和一个包含模型转录的 JSON 文件。
在 Jupyter 中新建一个笔记本,并切换到已克隆的仓库目录:
%cd personaplex在新单元格中运行以下命令。它会调用离线运行器,并将生成的音频与转录写入磁盘:
%%capture
!python -m moshi.offline \
--voice-prompt "NATF2.pt" \
--text-prompt "You are a wise and friendly teacher. Answer questions in a clear, engaging way." \
--input-wav "assets/test/input_assistant.wav" \
--seed 42424242 \
--output-wav "out_teacher.wav" \
--output-text "out_teacher.json"各参数说明:
--voice-prompt选择语音嵌入(此处为自然女声)。--text-prompt定义助手的角色与行为。--input-wav为模型将要回应的用户录音。--seed使多次运行间的输出更可复现。--output-wav生成的口语化响应。--output-text将转录结果保存为 JSON。
命令完成后,您可以直接播放响应音频:
from IPython.display import Audio
Audio("out_teacher.wav")您应能听到清晰、自然的语音,且与文本提示中设定的人格相匹配。
JSON 转录有时会包含分词伪影,例如标点前后多余空格或被拆分的词片。下面的辅助函数会加载 JSON 并清理为可读文本。
import json
import re
with open("out_teacher.json") as f:
data = json.load(f)
def detokenize(tokens):
# 1) drop padding-like tokens
drop = {"PAD", "EPAD", "<pad>", "</s>", "<s>"}
toks = [t for t in tokens if t not in drop]
# 2) join with spaces first
s = " ".join(toks)
# 3) fix spacing around punctuation
s = re.sub(r"\s+([.,!?;:])", r"\1", s)
# 4) fix common split contractions: "it ' s" -> "it's"
s = s.replace(" ' s", "'s").replace(" n't", "n't").replace(" 're", "'re").replace(" 'm", "'m").replace(" 've", "'ve").replace(" 'd", "'d")
# 5) fix stray spaces around apostrophes
s = re.sub(r"\s+'\s+", "'", s)
# 6) fix cases like "for k" -> "fork" and "fl uff" -> "fluff"
# (general rule: merge single-letter fragments if they look like split wordpieces)
s = re.sub(r"\b([A-Za-z])\s+([A-Za-z]{1,3})\b", r"\1\2", s)
# 7) collapse multiple spaces
s = re.sub(r"\s{2,}", " ", s).strip()
return s
clean_text = detokenize(data) # replace with your list variable
clean_text现在您应能看到与生成音频相匹配的可读转录字符串。如果输出仍包含奇怪的拆分(例如“fl uff”或“afor k”),对于某些运行来说这是正常现象,可用额外规则进一步清理,但主要内容应该已能理解。
"Hey, let me know if you have any questions.
Hmm, first rinse the rice a couple of times until the water runs clear, that cuts down on starch, then use apot with a tight fitting lid, bring to a boil,
give it a quick stir, then turn the heat down low and cover, let it s immer without lifting it, and when it'done fl uff it with afor k, that usually
You could to ss the hot rice with a nice handful of chopped fresh herbs like basil or par sley, or you could sprinkle a little g rated cheese,
a squeeze of lemon or lime, adr izzle of olive oil, some chopped fresh herbs, or even some to ast ed nuts, that adds color and flavor."结语
测试 PersonaPlex 的过程着实让我惊喜。从第一次交互开始,它更像是一场真实的对话,而不是在试验一个模型。能够自然打断、即时响应,并在整个过程保持一致的人格,让它远超我体验过的大多数语音系统。本地运行的一切更是加分,没有明显延迟,也不会失去控制感。
当然也有不足。我注意到偶尔的卡顿,一旦话题推进,回到更早的话题时,它并不总能顺畅衔接。
它目前对非英语口音的理解也不够完善,可能会导致名字发音不准或转录不够理想。这些更像是边缘情况,而非根本性问题,我相信会很快得到改进。
我相信这些问题未来都会被解决,我们将迎来更优秀、完全本地、真正实时的对话式 AI,将 GPT-5.2 的推理能力与 ElevenLabs 的音色品质融为一体。
PersonaPlex 常见问答
在本地运行 PersonaPlex 需要什么硬件?
NVIDIA 建议使用至少24 GB 显存(如 A10G、A40 或 RTX 3090/4090)的 GPU,以低延迟顺畅运行 7B 模型。您还需要支持 CUDA 的 Linux 环境。虽然可以将部分层卸载到 CPU,但这会显著削弱该模型以实时性能见长的优势。
PersonaPlex 能说英语以外的语言吗?
目前 v1 版本仅支持英语。其架构支持多语言,NVIDIA 已表示未来更新的路线图中将加入其他语言(如西班牙语),但目前优化重点仍是英语对话。
我可以将其用于商业应用吗?
可以。模型权重采用NVIDIA 开放模型许可发布,一般允许商业使用。但请务必查看 Hugging Face 模型卡上的具体许可协议,确保您的使用场景(例如提供付费服务)符合其条款。
它与 faster-whisper 加快速 LLM 的组合有何不同?
传统系统是“半双工”——它们会等您说完、转写音频、思考,然后再发声。PersonaPlex 是“全双工”,意味着它会持续处理音频并生成 token。这使其能在说话的同时倾听,自然地处理打断,并生成诸如“嗯哼”“对”的反馈,而不再像回合制系统那样存在尴尬的延迟。
为什么模型有时会把名字念错,或在转录中把单词拆开?
由于 PersonaPlex 以实时帧(24kHz)流式输出音频 token,文本 token 有时会跨帧生成。这会在原始转录中产生诸如“fl uff”或“afor k”之类的伪影。这是流式分词的常见副作用,可通过简单的后处理脚本清理。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
如果您用过带语音模式的 ChatGPT,您已经知道它有多惊艳。与一个能听、能懂、还能几乎像真人一样回应的 AI 交流,会让人感到意外的自然。它像是在对话,聪明而迅速。但仍存在差距:细小的延迟、有限的打断处理,以及那种“您在和系统而不是人说话”的感觉。
现在想象一下更进一步的体验。这正是 PersonaPlex 登场的地方。
想象一个实时语音助手,能瞬时响应、允许您自然打断、在一句话中途自适应,并且更接近真实的人类对话。几乎无感延迟、没有尴尬的停顿、无需依赖云端。只是顺畅、本地、实时的对话,像是有生命的交流。
PersonaPlex 是 NVIDIA 开发的本地实时语音交互系统。它旨在将语音类 AI 推进到超越简单的语音转文本与文本转语音的流水线。相反,它实现了低延迟的流式对话,助手可以持续说、持续听、持续适应,就像面对面交流中的真人那样。
在本教程中,我将一步步带您了解 PersonaPlex。我们将先理解 PersonaPlex 是什么,以及为何它与典型的语音助手有本质区别。随后,我们会搭建本地环境、从源码安装 PersonaPlex,并启动 PersonaPlex 的 WebUI 服务器。之后,我们将通过网页界面与系统交互,最后用一个 Python 脚本测试实时语音对话。
我建议您查看 Spoken Language Processing in Python 课程,了解 PersonaPlex 背后的一些基础知识。
什么是 PersonaPlex?
PersonaPlex 是一个全新的对话式 AI 系统,让语音交互真正自然,同时仍然允许您完全自定义声音与人格(persona)。
它不再像传统助手那样充满停顿和僵硬的轮流发言,而是实现了流畅、实时的对话,让打断、时机与语调都更贴近人类。
其核心是全双工架构,意味着它可以同时倾听与发声。
它并非将语音识别、语言理解与语音生成等独立模型串联起来,而是依赖单一的统一模型,能在用户说话的同时持续更新。
语音提示用于定义助手的声音,而文本提示定义它是谁、应如何行为。二者结合,使 PersonaPlex 在保持一致人格的同时,做到即时而自然的响应。
PersonaPlex 架构 | 来源:NVIDIA PersonaPlex
PersonaPlex 使用 FullDuplexBench 和扩展的客户服务基准 ServiceDuplexBench 进行评估。
在对话动态、低延迟响应、打断处理与任务遵循等方面,它在助手与客服两类场景中均优于其他开源与商业系统。
对话动态(数值越高越好)| 来源:NVIDIA PersonaPlex
在下方的视频演示中,您可以清楚地看到人与模型之间进行流畅的实时交流,甚至能实时插科打诨、开玩笑。