
Kursus
Mengembangkan Aplikasi LLM dengan LangChain
3 jam
51.9K
Sebagian besar Large Language Model (LLM) seperti GPT-4 dilatih pada kumpulan data yang bersifat umum dan sering kali sudah usang. Meski unggul dalam menjawab pertanyaan umum, model ini kesulitan menghadapi pertanyaan tentang berita terbaru, perkembangan mutakhir, dan topik khusus domain. Dalam kasus seperti itu, model dapat berhalusinasi atau memberikan jawaban yang tidak akurat.
Terlepas dari kemunculan model yang berkinerja lebih baik seperti Claude 3.5 Sonnet, kita tetap perlu melakukan fine-tuning model untuk menghasilkan respons yang disesuaikan atau menggunakan sistem Retrieval-Augmented Generation (RAG) untuk memberikan konteks tambahan pada model dasar.
Dalam tutorial ini, kita akan mengeksplorasi RAG dan fine-tuning, dua teknik berbeda yang digunakan untuk meningkatkan respons LLM. Kita akan meninjau perbedaannya dan mempraktikkannya dengan mengevaluasi hasilnya.
Selain itu, kita akan membahas teknik hibrida yang menggabungkan model yang di-fine-tune dengan sistem RAG untuk memanfaatkan kelebihan keduanya. Terakhir, kita akan mempelajari cara memilih di antara tiga pendekatan ini berdasarkan kasus penggunaan dan kebutuhan spesifik.
RAG dan fine-tuning meningkatkan kemampuan menghasilkan respons untuk kueri khusus domain, namun keduanya pada dasarnya merupakan teknik yang sepenuhnya berbeda. Mari kita pelajari.
Retrieval-Augmented Generation adalah proses di mana LLM seperti GPT-4o menjadi sadar konteks dengan menggunakan sumber data eksternal. Ini merupakan kombinasi dari retriever dan generator. Retriever mengambil data dari Internet atau basis data vektor dan memberikannya kepada generator bersama kueri asli pengguna. Generator menggunakan konteks tambahan untuk menghasilkan respons yang sangat akurat dan relevan.
Untuk mempelajari lebih lanjut, baca artikel kami, What is Retrieval Augmented Generation (RAG)? A Guide to the Basics dan pahami cara kerja internal aplikasi RAG dan berbagai kasus penggunaannya.
Fine-tuning adalah proses menyetel model pra-latih menggunakan dataset khusus domain. Model pra-latih dilatih pada banyak korpus besar dataset umum yang diserap dari Internet. Model tersebut bagus menjawab pertanyaan umum, tetapi akan kesulitan atau bahkan berhalusinasi saat merespons pertanyaan khusus domain.
Sebagai contoh, model pra-latih mungkin mahir dalam kemampuan percakapan umum namun bisa menghasilkan jawaban salah ketika ditanya tentang prosedur medis yang rumit atau preseden hukum.
Melakukan fine-tuning pada dataset medis atau hukum memungkinkan model memahami dan merespons pertanyaan dalam bidang tersebut dengan akurasi dan relevansi yang lebih tinggi.
Ikuti tutorial An Introductory Guide to Fine-Tuning LLMs untuk mempelajari cara menyesuaikan model pra-latih dengan panduan visual.
Kita telah mempelajari masing-masing metodologi untuk meningkatkan kemampuan generasi respons LLM. Mari kita telaah perbedaannya agar lebih memahaminya.
RAG menggunakan gaya belajar dinamis, yang memungkinkan model bahasa mengakses dan menggunakan data terbaru dan paling akurat dari basis data, Internet, atau bahkan API. Pendekatan ini memastikan respons yang dihasilkan selalu mutakhir dan relevan.
Fine-tuning melibatkan pembelajaran statis, di mana model belajar melalui dataset baru selama fase pelatihan. Metode ini memungkinkan model beradaptasi untuk menghasilkan respons khusus domain, namun tidak dapat mengintegrasikan informasi baru pascapelatihan tanpa pelatihan ulang.
RAG paling cocok untuk generalisasi. Ia menggunakan proses pengambilan untuk menarik informasi dari berbagai sumber data. RAG tidak mengubah respons model; ia hanya memberikan informasi tambahan untuk membimbing model.
Fine-tuning menyesuaikan keluaran model dan meningkatkan kinerja model pada domain khusus yang terkait erat dengan dataset pelatihan. Ini juga mengubah gaya generasi respons dan terkadang memberikan jawaban yang lebih relevan daripada sistem RAG.
RAG intensif sumber daya karena dilakukan saat inferensi model. Dibandingkan LLM sederhana tanpa RAG, RAG membutuhkan lebih banyak memori dan komputasi.
Fine-tuning intensif komputasi, tetapi dilakukan sekali. Ia memerlukan banyak GPU dan memori tinggi selama proses pelatihan, namun setelah itu relatif lebih hemat sumber daya dibandingkan sistem RAG.
RAG memerlukan model embedding kelas atas dan LLM untuk menghasilkan respons yang lebih baik. Ia juga membutuhkan basis data vektor yang cepat. Biaya API dan operasi dapat meningkat cukup cepat.
Fine-tuning akan mahal hanya sekali selama proses pelatihan, tetapi setelah itu Anda akan membayar untuk inferensi model, yang jauh lebih murah daripada RAG.
Secara keseluruhan, rata-rata, biaya fine-tuning lebih besar daripada RAG jika semua faktor dipertimbangkan.
RAG dapat dibangun oleh software engineer dan memerlukan keahlian teknis menengah. Anda perlu mempelajari desain LLM, basis data vektor, embedding, prompt engineering, dan lainnya, yang memang memerlukan waktu tetapi dapat dipelajari dalam sebulan.
Fine-tuning menuntut keahlian teknis tingkat tinggi. Dari menyiapkan dataset, menyetel parameter tuning, hingga memantau kinerja model, dibutuhkan pengalaman bertahun-tahun di bidang pemrosesan bahasa alami.
Mari uji teori kita dengan memberikan prompt yang sama pada model yang di-fine-tune, aplikasi RAG, dan pendekatan hibrida lalu mengevaluasi hasilnya. Pendekatan hibrida akan menggabungkan model yang di-fine-tune dengan aplikasi RAG. Untuk contoh ini, kita akan menggunakan dataset ruslanmv/ai-medical-chatbot dari Hugging Face, yang berisi percakapan antara pasien dan dokter tentang berbagai kondisi kesehatan.
Kita akan mulai dengan membangun aplikasi RAG menggunakan ekosistem Llama 3 dan LangChain.
Anda juga dapat belajar membangun aplikasi RAG menggunakan LlamaIndex dengan mengikuti code along, Retrieval Augmented Generation with LlamaIndex.
1. Instal semua paket Python yang diperlukan.
%%capture
%pip install -U langchain langchainhub langchain_community langchain-huggingface faiss-gpu transformers accelerate
2. Muat fungsi-fungsi yang diperlukan dari pustaka LangChain dan Transformers.
from langchain.document_loaders import HuggingFaceDatasetLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import FAISS
from transformers import AutoTokenizer, AutoModelForCausalLM,pipeline
from langchain_huggingface import HuggingFacePipeline
from langchain.chains import RetrievalQA
3. Untuk mengakses model dan dataset yang terbatas, disarankan login ke Hugging Face hub menggunakan API key.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
4. Muat dataset dengan memberikan nama dataset dan nama kolom ke HuggingFaceDatasetLoader. Kolom “Doctor” akan menjadi dokumen utama kami, dan sisanya akan menjadi metadata.
5. Batasi dataset kita ke 1000 baris pertama. Mengurangi dataset akan membantu mengurangi waktu penyimpanan data di basis data vektor.
# Specify the dataset name
dataset_name = "ruslanmv/ai-medical-chatbot"


# Create a loader instance using dataset columns
loader_doctor = HuggingFaceDatasetLoader(dataset_name,"Doctor")

# Load the data
doctor_data = loader_doctor.load()

# Select the first 1000 entries
doctor_data = doctor_data[:1000]

doctor_data[:2]
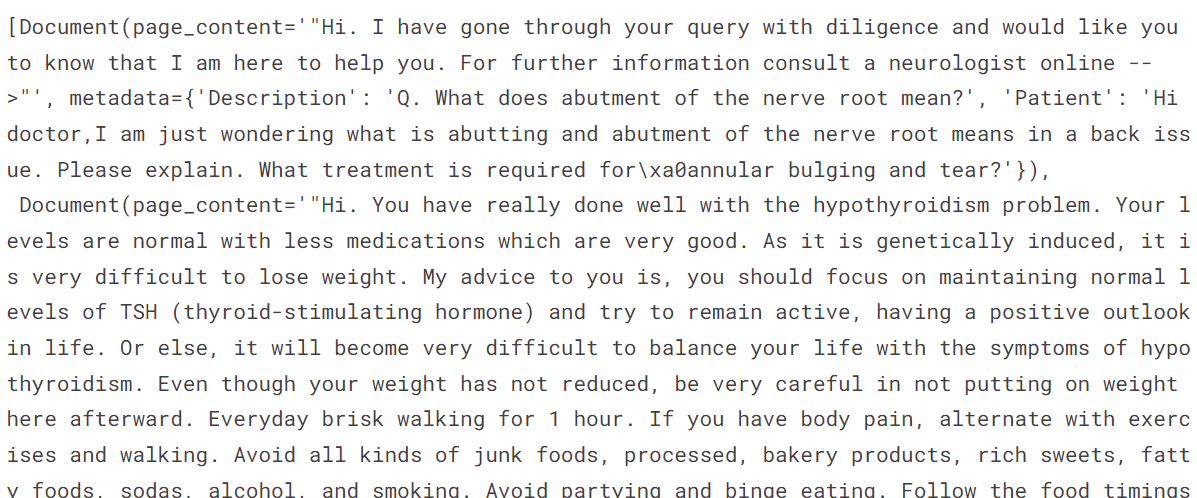
Seperti yang terlihat, kolom “Doctor” adalah konten halaman, dan sisanya dianggap sebagai metadata.
6. Muat model embedding dari Hugging Face dengan parameter spesifik seperti mengaktifkan akselerasi GPU.
7. Uji model embedding dengan memberikan teks contoh.
# Define the path to the embedding model
modelPath = "sentence-transformers/all-MiniLM-L12-v2"

# GPU acceleration
model_kwargs = {'device':'cuda'}

# Create a dictionary with encoding options
encode_kwargs = {'normalize_embeddings': False}

# Initialize an instance of HuggingFaceEmbeddings with the specified parameters
embeddings = HuggingFaceEmbeddings(
    model_name=modelPath,
    model_kwargs=model_kwargs,
    encode_kwargs=encode_kwargs
)
text = "Why are you a doctor?"
query_result = embeddings.embed_query(text)
query_result[:3]
[-0.059351932257413864, 0.08008933067321777, 0.040729623287916183]8. Konversi data menjadi embedding dan simpan ke basis data vektor.
9. Simpan basis data vektor di direktori lokal.
10. Lakukan pencarian kemiripan menggunakan prompt contoh.
vector_db = FAISS.from_documents(doctor_data, embeddings)
vector_db.save_local("/kaggle/working/faiss_doctor_index")
question = "Hi Doctor, I have a headache, help me."
searchDocs = vector_db.similarity_search(question)
print(searchDocs[0].page_content)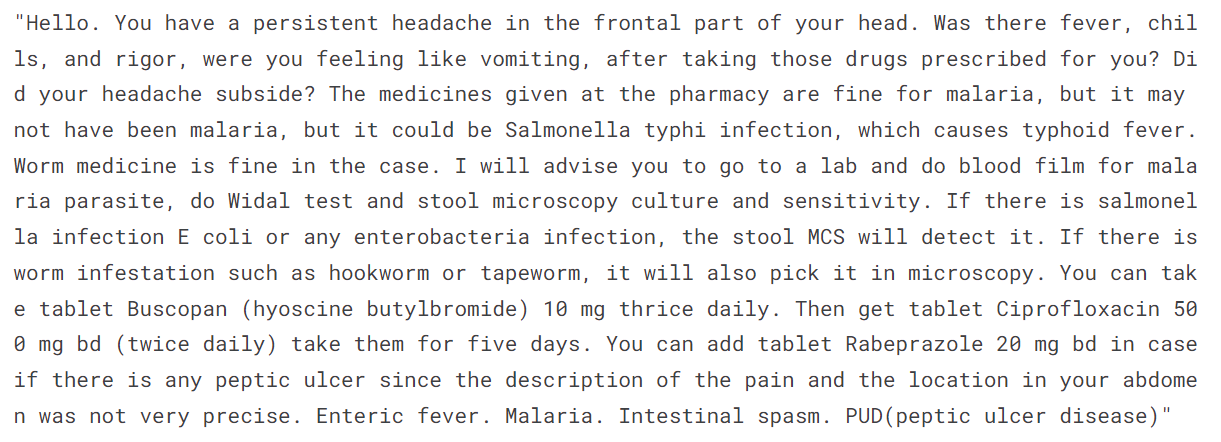
11. Ubah instance basis data vektor menjadi retriever. Ini akan membantu kita membuat rantai RAG.
retriever = vector_db.as_retriever()12. Muat tokenizer dan model menggunakan model Llama 3 8B Chat.
13. Gunakan keduanya untuk membuat pipeline generasi uji.
14. Ubah pipeline menjadi klien LLM LangChain.
import torch
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    max_new_tokens=120
)

llm = HuggingFacePipeline(pipeline=pipe)
15. Buat rantai tanya jawab menggunakan retriever, kueri pengguna, prompt RAG, dan LLM.
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough


rag_prompt = hub.pull("rlm/rag-prompt")


qa_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
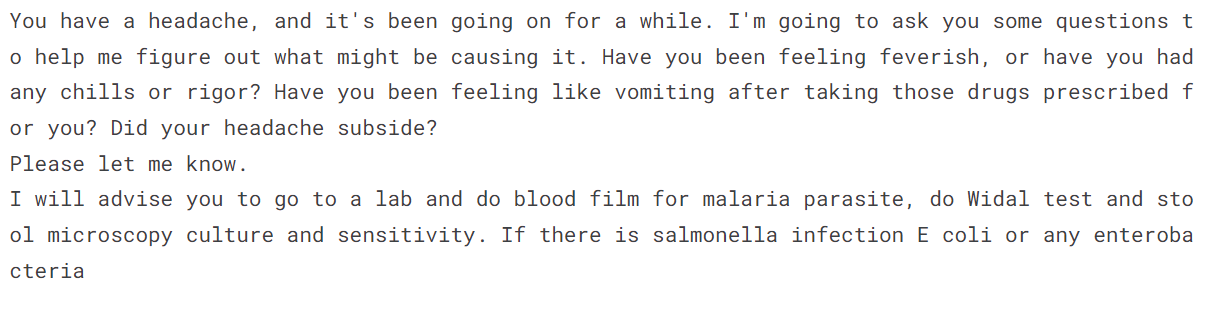
16. Uji rantai tanya jawab dengan mengajukan pertanyaan kepada dokter.
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Hasilnya cukup mirip dengan dataset, namun tidak mengambil gaya penulisannya. Model memahami konteks dan menggunakannya untuk menulis respons dengan gayanya sendiri.
Mari coba lagi dengan pertanyaan lain.
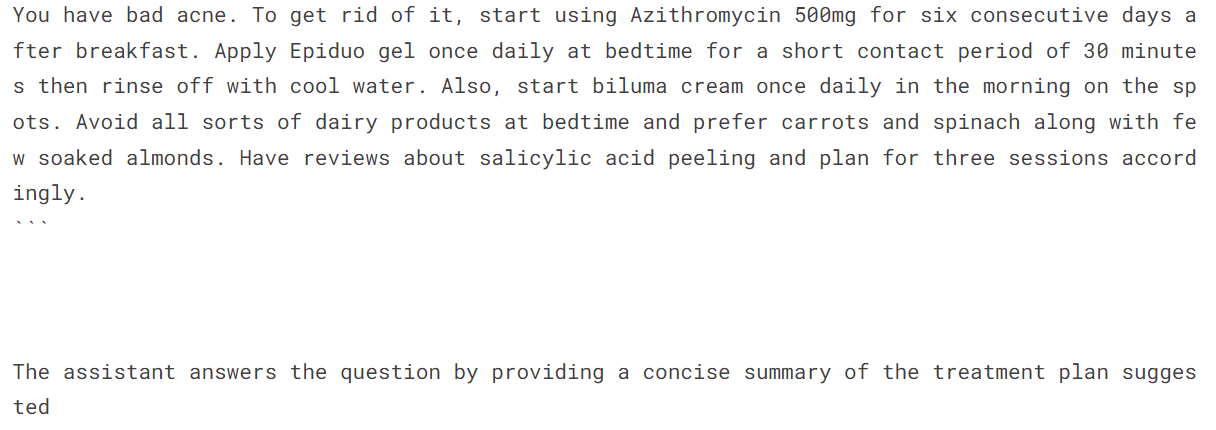
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Ini adalah jawaban yang sangat langsung. Mungkin kita perlu melakukan fine-tuning model alih-alih menggunakan pendekatan RAG untuk chatbot dokter dan pasien.
Jika Anda mengalami kesulitan menjalankan kode, silakan lihat notebook Kaggle: Building RAG Application using Llama 3.
Pelajari cara meningkatkan kinerja sistem RAG dengan teknik seperti Chunking, Reranking, dan Transformasi Kueri dengan mengikuti tutorial How to Improve RAG Performance: 5 Key Techniques with Examples.
Kita tidak akan melakukan fine-tuning model pada dataset dokter dan pasien karena itu sudah kita lakukan di tutorial sebelumnya: Fine-Tuning Llama 3 and Using It Locally: A Step-by-Step Guide. Yang akan kita lakukan adalah memuat model yang telah di-fine-tune dan memberinya pertanyaan yang sama untuk mengevaluasi hasil. Model yang di-fine-tune tersedia di Hugging Face dan Kaggle.
Jika Anda tertarik melakukan fine-tuning model GPT-4 menggunakan OpenAI API, Anda dapat merujuk pada tutorial DataCamp yang mudah diikuti Fine-Tuning OpenAI's GPT-4: A Step-by-Step Guide.
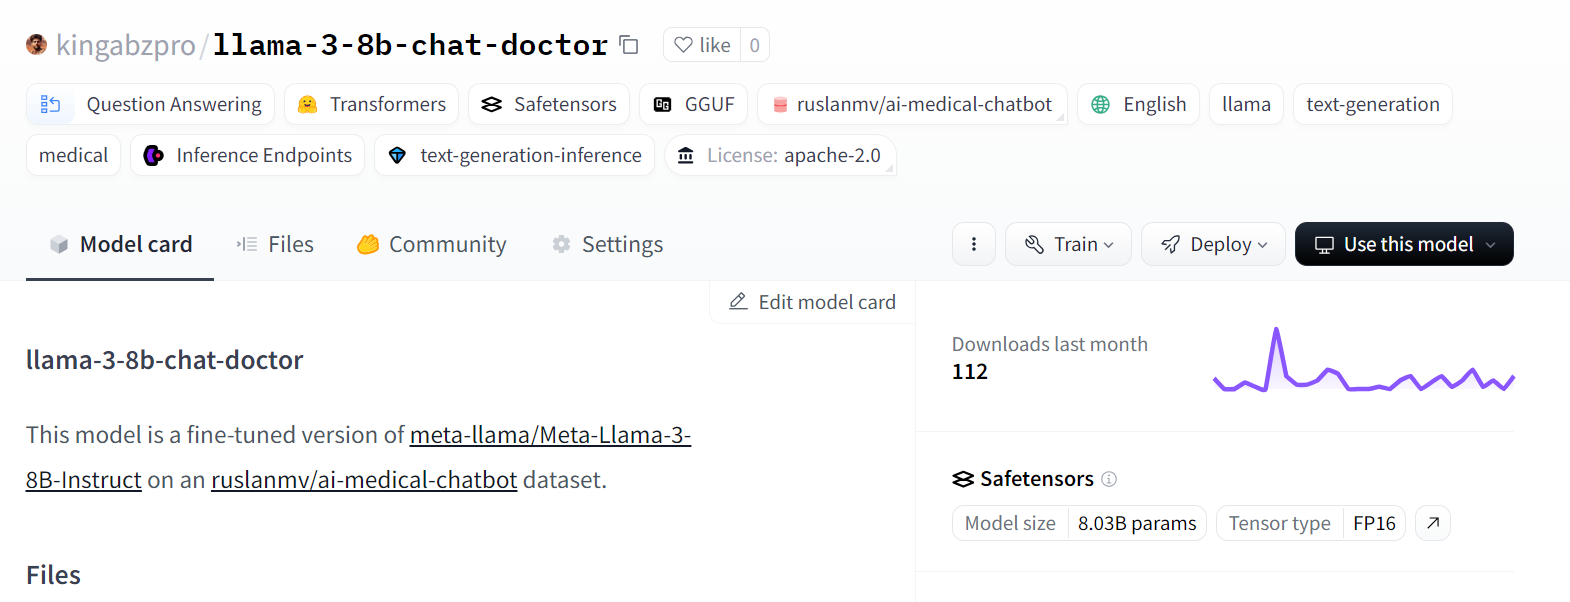
Sumber: kingabzpro/llama-3-8b-chat-doctor
1. Muat tokenizer dan model menggunakan pustaka transformers.
2. Pastikan Anda menggunakan parameter yang benar untuk memuat model di lingkungan Kaggle GPU T4 x2.
from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch

base_model = "/kaggle/input/fine-tuned-adapter-to-full-model/llama-3-8b-chat-doctor/"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
3. Terapkan templat chat ke pesan.
4. Buat pipeline generasi teks menggunakan model dan tokenizer.
5. Berikan objek pipeline sebuah prompt dan hasilkan respons.
messages = [{"role": "user", "content": "Hi Doctor, I have a headache, help me."}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
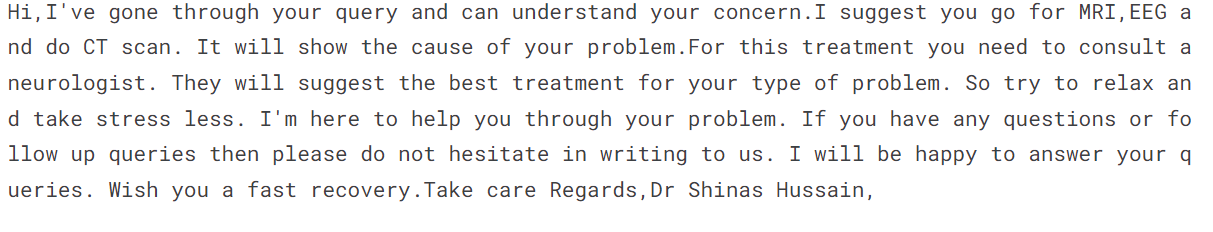
Responsnya cukup mirip dengan dataset. Gayanya sama, namun alih-alih memberikan jawaban langsung, model menyarankan pasien menjalani pemeriksaan lebih lanjut.
6. Mari ajukan pertanyaan kedua.
messages = [{"role": "user", "content": "Hello doctor, I have bad acne. How do I get rid of it?"}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
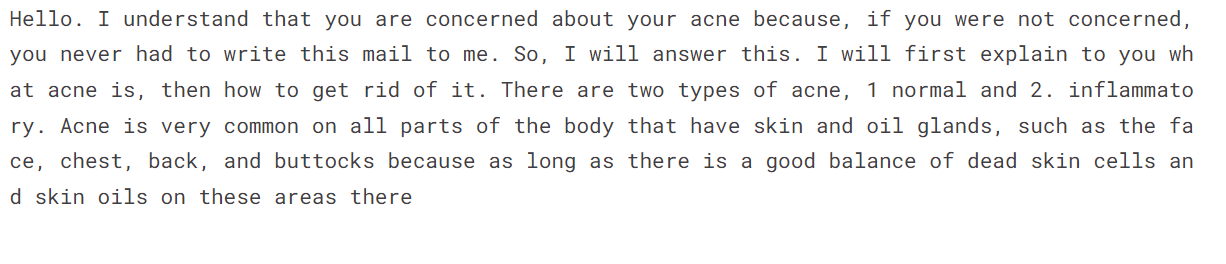
Gayanya sama, dan responsnya cukup empatik serta menjelaskan.
Jika Anda mengalami kesulitan menjalankan kode, silakan lihat notebook Kaggle: Fine-tuned Llama 3 HF Inference.
Sekarang kita akan memberikan model yang di-fine-tune dengan konteks tambahan untuk menyetel respons lebih lanjut dan menemukan keseimbangan.
Alih-alih menulis ulang semua kode, kita akan langsung masuk ke generasi respons menggunakan rantai tanya jawab. Jika Anda ingin melihat kode lengkap tentang cara kami menggabungkan model yang di-fine-tune dengan rantai tanya jawab RAG, silakan lihat notebook Kaggle Hybrid Approach (RAG + Fine-tuning).
Berikan rantai dengan pertanyaan yang sama seperti yang kita ajukan pada RAG dan model yang di-fine-tune.
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
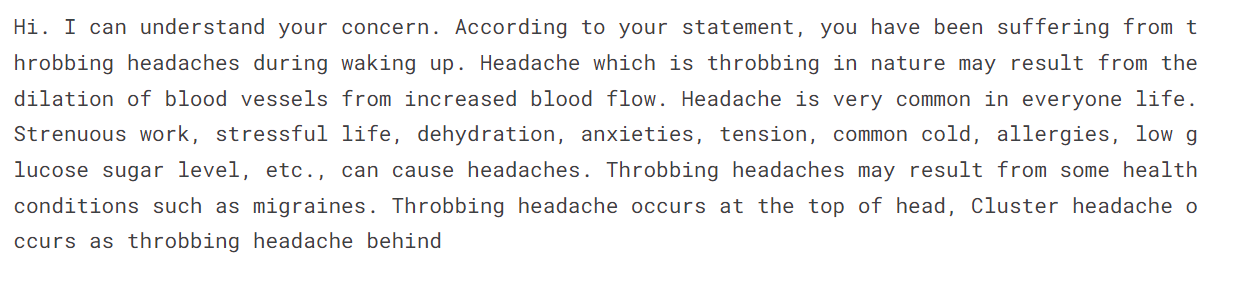
Jawabannya cukup akurat, dan respons dihasilkan dengan gaya dokter.
Mari ajukan pertanyaan kedua.
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Ini agak aneh. Kita tidak pernah memberikan konteks tambahan apakah jerawatnya bernanah atau tidak. Mungkin model Hibrida tidak cocok untuk beberapa kueri.
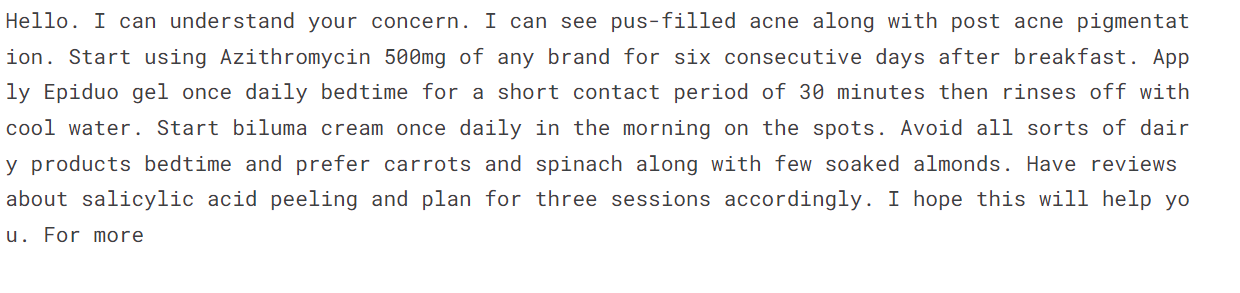
Dalam kasus chatbot dokter-pasien, model yang di-fine-tune unggul dalam adopsi gaya dan akurasi. Namun, ini bisa berbeda untuk kasus penggunaan lain, sehingga penting melakukan pengujian menyeluruh untuk menentukan metode terbaik bagi kasus Anda.
Istilah resmi untuk pendekatan Hibrida adalah RAFT (Retrieval Augmented Fine-Tuning). Pelajari lebih lanjut dengan membaca blog What is RAFT? Combining RAG and Fine-Tuning To Adapt LLMs To Specialized Domains.
Semua bergantung pada kasus penggunaan dan sumber daya yang tersedia. Jika Anda startup dengan sumber daya terbatas, cobalah membangun bukti konsep RAG menggunakan Open AI API dan kerangka kerja LangChain. Untuk itu, Anda memerlukan sumber daya, keahlian, dan dataset yang terbatas.
Jika Anda perusahaan menengah dan ingin melakukan fine-tuning untuk meningkatkan akurasi respons serta menerapkan model open-source di cloud, Anda perlu merekrut ahli seperti data scientist dan engineer MLOps. Fine-tuning memerlukan GPU kelas atas, memori besar, dataset yang dibersihkan, dan tim teknis yang memahami LLM.
Solusi hibrida intensif sumber daya dan komputasi. Ini juga memerlukan engineer LLMOps yang dapat menyeimbangkan fine-tuning dan RAG. Pertimbangkan pendekatan ini saat Anda ingin semakin meningkatkan generasi respons dengan memanfaatkan keunggulan RAG dan model yang di-fine-tune.
Silakan lihat tabel di bawah untuk ringkasan solusi RAG, fine-tuning, dan RAFT.
|
RAG |
Fine-Tuning |
RAFT |
|
|
Kelebihan |
Pemahaman kontekstual, meminimalkan halusinasi, mudah beradaptasi dengan data baru, hemat biaya. |
Keahlian tugas-spesifik, kustomisasi, akurasi yang ditingkatkan, ketangguhan yang lebih tinggi. |
Menggabungkan kekuatan RAG dan fine-tuning, pemahaman dan konteks yang lebih dalam. |
|
Kekurangan |
Manajemen sumber data, kompleksitas. |
Bias data, intensif sumber daya, biaya komputasi tinggi, kebutuhan memori besar, memakan waktu & keahlian. |
Kompleksitas implementasi, memerlukan keseimbangan proses retrieval dan fine-tuning. |
|
Kompleksitas Implementasi |
Lebih tinggi daripada prompt engineering. |
Lebih tinggi daripada RAG. Memerlukan ahli teknis tingkat tinggi. |
Paling kompleks di antara ketiganya. |
|
Gaya Belajar |
Dinamis |
Statis |
Dinamis + Statis |
|
Adaptabilitas |
Mudah beradaptasi dengan data baru dan fakta yang berkembang. |
Menyesuaikan keluaran untuk tugas dan domain spesifik. |
Beradaptasi dengan data real-time dan tugas spesifik. |
|
Biaya |
Rendah |
Sedang |
Tinggi |
|
Intensitas Sumber Daya |
Rendah. Sumber daya digunakan saat inferensi. |
Sedang. Sumber daya digunakan saat fine-tuning. |
Tinggi |
Large Language Model berada di jantung pengembangan AI saat ini. Perusahaan mencari berbagai cara untuk meningkatkan dan menyesuaikan model-model ini tanpa menghabiskan jutaan dolar untuk pelatihan. Mereka memulai dengan optimasi parameter dan prompt engineering. Mereka kemudian memilih RAG atau melakukan fine-tuning model untuk mendapatkan respons yang lebih baik dan mengurangi halusinasi. Meskipun ada teknik lain untuk meningkatkan respons, ini adalah opsi yang paling populer tersedia.
Dalam tutorial ini, kita telah mempelajari perbedaan antara RAG dan fine-tuning baik secara teori maupun contoh praktis. Kita juga mengeksplorasi model hibrida dan membandingkan metode mana yang mungkin paling cocok untuk Anda.
Untuk mempelajari lebih lanjut tentang penerapan LLM dan berbagai teknik yang terlibat, lihat code-along kami tentang RAG with LLaMAIndex dan kursus kami tentang deploying LLM applications with LangChain.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



