Last chance! 50% off DataCamp Premium
Sale ends in
Seiring pemrosesan bahasa alami (NLP) terus berkembang pesat, model bahasa besar (LLM) menjadi alat yang sangat kuat, mampu menangani semakin banyak tugas. Namun, satu tantangan yang berkelanjutan adalah menyesuaikan model umum ini ke area yang sangat khusus, seperti literatur medis atau dokumentasi perangkat lunak.
Di sinilah Retrieval-Augmented Fine-Tuning (RAFT) hadir, sebuah teknik baru yang dapat mentransformasi NLP khusus domain. RAFT menggabungkan keunggulan Retrieval-Augmented Generation (RAG), metode yang memadukan LLM dengan sumber data eksternal, dan fine-tuning, sehingga model tidak hanya mempelajari pengetahuan khusus domain tetapi juga belajar cara mengambil dan memahami konteks eksternal secara akurat untuk menjalankan tugas.
Dalam artikel ini, kita akan menelusuri cara kerja RAFT, melihat keunggulannya, dan bagaimana teknik mutakhir ini dapat merevolusi pendekatan kita terhadap tugas NLP khusus domain. Untuk memulai, lihat beberapa sumber tentang RAG, seperti pengantar RAG kami dan penerapan praktis RAG.
Retrieval Augmented Fine-Tuning (RAFT) adalah pendekatan terobosan untuk model bahasa yang menggabungkan manfaat RAG dan fine-tuning. Teknik ini menyesuaikan model bahasa untuk domain tertentu dengan meningkatkan kemampuan model dalam memahami dan memanfaatkan pengetahuan khusus domain sekaligus memastikan ketangguhan terhadap pengambilan informasi yang tidak akurat.
RAFT dirancang khusus untuk mengatasi tantangan dalam menyesuaikan LLM ke domain spesialis. Dalam konteks ini, penalaran berbasis pengetahuan umum menjadi kurang krusial, dan fokus utama bergeser pada memaksimalkan akurasi terhadap kumpulan dokumen khusus domain yang telah ditentukan.
Retrieval-Augmented Generation (RAG) adalah teknik yang meningkatkan model bahasa dengan mengintegrasikan modul pengambilan yang mengambil informasi relevan dari basis pengetahuan eksternal.
Modul pengambilan ini mengambil dokumen yang relevan berdasarkan kueri masukan. Model bahasa kemudian menggunakan konteks tambahan ini untuk menghasilkan keluaran akhir.
Beroperasi dalam paradigma 'ambil-dan-baca', RAG terbukti sangat efektif pada berbagai tugas NLP, termasuk pemodelan bahasa dan tanya jawab domain terbuka.
Namun, model bahasa ini belum dilatih untuk mengambil dokumen khusus domain secara akurat dan hanya memiliki pengetahuan domain umum dari pra-pelatihan.
Seperti dicatat dalam makalah aslinya, metode pengambilan in-context yang ada setara dengan mengikuti ujian buku terbuka tanpa mengetahui dokumen mana yang paling relevan untuk menjawab pertanyaan.
Untuk mempelajari lebih lanjut tentang RAG, lihat bagaimana RAG dapat digunakan dengan GPT dan Milvus untuk melakukan Question Answering.
Fine-tuning adalah pendekatan yang banyak digunakan untuk menyesuaikan LLM pra-latih ke tugas hilir. Proses ini melibatkan pelatihan lanjutan pada data spesifik tugas, sehingga model mampu mempelajari pola dan selaras dengan format keluaran yang diinginkan.
Fine-tuning terbukti berhasil dalam berbagai aplikasi NLP, seperti peringkasan, tanya jawab, dan generasi dialog. Namun, metode fine-tuning tradisional mungkin kesulitan memanfaatkan pengetahuan eksternal khusus domain atau menangani pengambilan yang tidak sempurna saat inferensi.
Dengan analogi serupa seperti sebelumnya, fine-tuning ibarat menghafal dokumen dan menjawab pertanyaan tanpa merujuknya saat ujian. Masalah dari pendekatan ini adalah fine-tuning bisa mahal, dan pengetahuan yang di-fine-tune dapat menjadi usang. Selain itu, metode fine-tuning ini tidak serespnsif metode berbasis RAG.
Untuk mempelajari lebih lanjut tentang fine-tuning, berikut panduan pengantar fine-tuning LLM.
RAFT menyadari keterbatasan pendekatan yang ada dan bertujuan menggabungkan kekuatan RAG dan fine-tuning. Dengan memasukkan dokumen khusus domain selama proses fine-tuning, RAFT memungkinkan model mempelajari pola yang spesifik untuk domain target sekaligus meningkatkan kemampuannya memahami dan memanfaatkan konteks eksternal secara efektif.
Secara garis besar, dalam RAFT, data pelatihan terdiri dari pertanyaan, dokumen (baik yang relevan maupun tidak relevan), dan jawaban gaya chain-of-thought yang dihasilkan dari dokumen relevan. Model dilatih untuk menjawab pertanyaan berdasarkan dokumen yang diberikan, termasuk dokumen pengalih yang tidak memuat informasi relevan. Pendekatan ini mengajarkan model untuk mengidentifikasi dan memprioritaskan informasi relevan sambil mengabaikan konten yang tidak relevan.
Mari selami lebih dalam mekanisme cara kerja Retrieval-Augmented Fine-Tuning. RAFT mengusulkan metode baru untuk menyiapkan data fine-tuning guna melatih model penjawab RAG dalam-domain. Dalam RAFT, setiap data poin dalam dataset pelatihan terdiri dari:
Dalam dataset pelatihan fine-tuning RAFT, setiap pertanyaan dipasangkan dengan serangkaian dokumen — sebagian memuat jawaban dan sebagian tidak — beserta jawaban bergaya chain-of-thought. Struktur ini sangat berguna untuk melatih model membedakan antara informasi yang bermanfaat dan yang tidak relevan saat menyusun jawaban.
Untuk semakin meningkatkan pembelajaran model, dataset pelatihan RAFT mencakup campuran jenis pertanyaan:
Terakhir, jawaban bergaya chain-of-thought memasukkan segmen dari dokumen oracle dan proses penalaran terperinci. Pendekatan ini meningkatkan akurasi model dalam menjawab pertanyaan dengan mengajarkannya membentuk rantai penalaran menggunakan segmen relevan dari konteks asli.
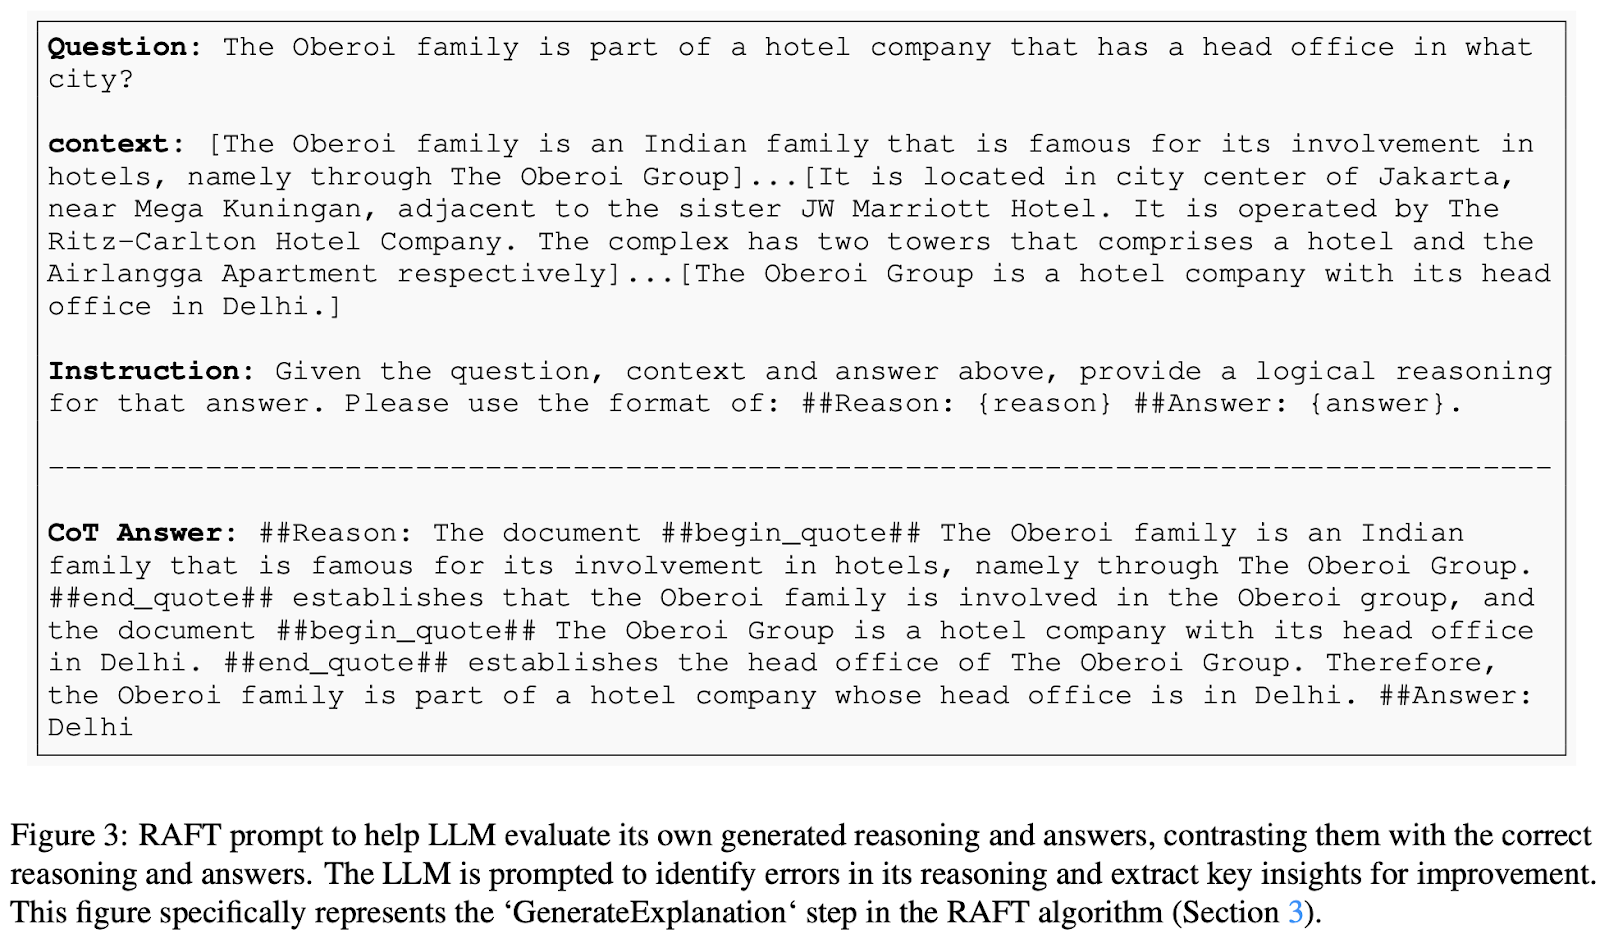
Sumber gambar: RAFT: Adapting Language Model to Domain Specific RAG
Setelah data pelatihan disiapkan, proses fine-tuning meliputi:
Selama tahap inferensi, model yang telah di-fine-tune akan disajikan sebuah pertanyaan dan top-K dokumen yang diambil oleh pipeline RAG. Perhatikan bahwa modul retriever beroperasi secara independen dari RAFT.
Untuk menunjukkan bahwa RAFT unggul dalam mengekstraksi informasi relevan dari dokumen dalam-domain dan menjawab pertanyaan, makalah asli membandingkan pendekatan RAFT dengan model tujuan umum dengan RAG dan dengan model yang di-fine-tune khusus domain. Secara khusus, mereka melakukan fine-tuning Llama-2 menggunakan metode RAFT untuk membuat model RAFT 7B, dan membandingkannya dengan berikut ini:
Model-model ini dievaluasi pada tiga jenis dataset untuk menilai kinerja RAFT di berbagai domain:
Secara keseluruhan, hasil menunjukkan bahwa RAFT secara konsisten mengungguli metode fine-tuning terawasi, baik dengan maupun tanpa RAG, di PubMed, HotpotQA, dan dataset API lainnya.
Dibandingkan dengan fine-tuning khusus domain (DSF), RAFT secara signifikan mengungguli DSF. Menariknya, DSF dengan RAG tidak menghasilkan kinerja yang lebih baik dan bahkan lebih buruk.
Ini menunjukkan bahwa DSF kekurangan kemampuan untuk mengekstraksi informasi relevan dari dokumen yang disediakan secara efektif. Dengan menggunakan RAFT, kita melatih model untuk memproses dokumen secara akurat dan memberikan gaya jawaban yang tepat.
Pendekatan RAFT bahkan mengungguli GPT-3.5 dengan RAG, yang merupakan model bahasa jauh lebih besar, menunjukkan efektivitas RAFT.
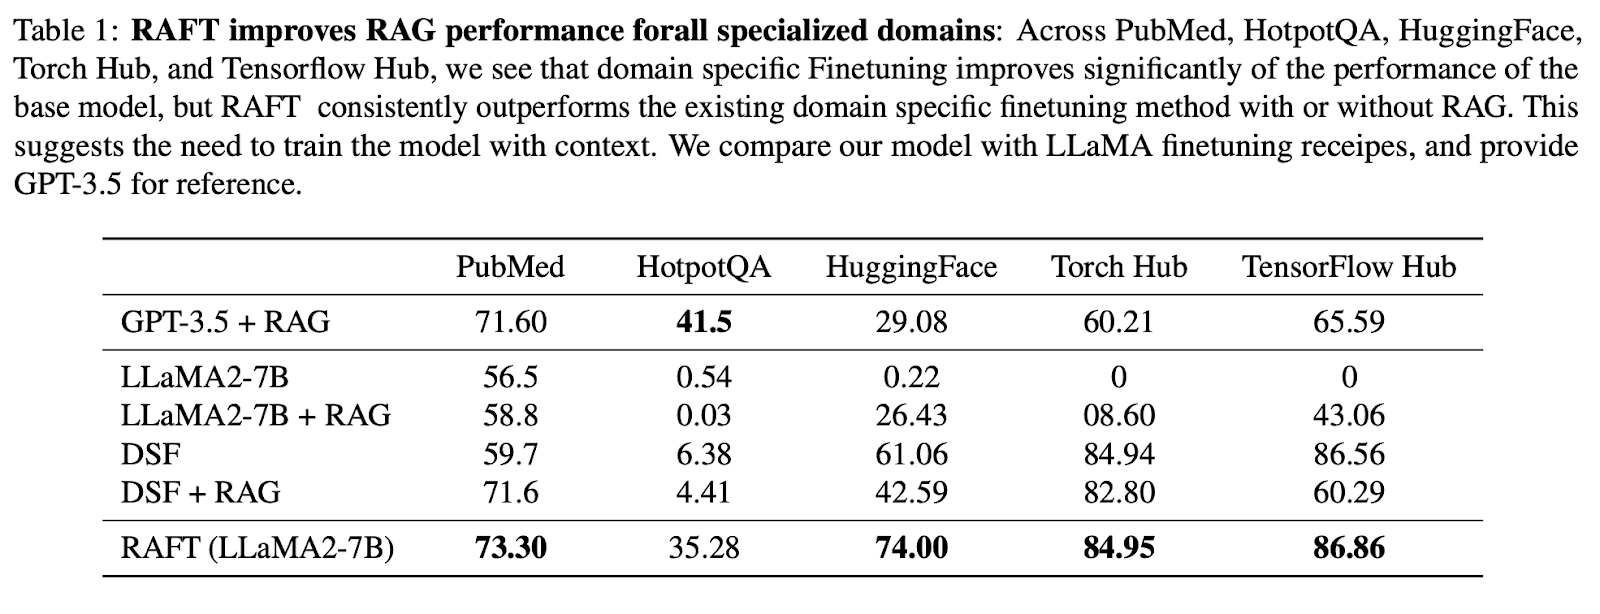
Sumber gambar: RAFT: Adapting Language Model to Domain Specific RAG
Studi ablasi
Selain eksperimen utama, makalah asli juga melakukan beberapa studi ablasi untuk memahami dampak berbagai komponen terhadap kinerja RAFT:
Untuk mengimplementasikan RAFT, peneliti dan praktisi dapat mengikuti langkah-langkah yang diuraikan dalam makalah. Ini mencakup menghasilkan jawaban bergaya chain-of-thought dari dokumen relevan, memasukkan dokumen distractor selama pelatihan, dan melakukan fine-tuning model menggunakan teknik pembelajaran terawasi. Para penulis juga membuka kode secara open-source dan menyediakan demo untuk memudahkan eksperimen lanjutan dan adopsi RAFT.
RAFT mewakili kemajuan signifikan dalam pemodelan bahasa khusus domain, menawarkan solusi kuat untuk menyesuaikan LLM pada domain spesialis. Dengan menggabungkan kekuatan RAG dan fine-tuning, RAFT membekali model bahasa dengan kemampuan untuk secara efektif memanfaatkan pengetahuan khusus domain sambil tetap tangguh terhadap ketidakakuratan pengambilan.
Bagi Anda yang ingin mendalami dunia RAG dan fine-tuning, kami merekomendasikan menelusuri sumber berikut:
Seiring meningkatnya permintaan untuk model bahasa khusus domain, teknik seperti RAFT akan memainkan peran krusial dalam memungkinkan aplikasi NLP yang lebih akurat dan andal di berbagai industri dan domain.
Lanjutkan Perjalanan Belajar AI Anda Hari Ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt