
{count, plural, one {Cursus} other {Cursussen}}
LLM-toepassingen ontwikkelen met LangChain
{hours} uur
51.5K
De meeste Large Language Models (LLM’s), zoals GPT-4, zijn getraind op algemene, vaak verouderde datasets. Ze zijn sterk in het beantwoorden van algemene vragen, maar hebben moeite met recente nieuwsfeiten, laatste ontwikkelingen en domeinspecifieke onderwerpen. In zulke gevallen kunnen ze hallucineren of onnauwkeurige antwoorden geven.
Ondanks de opkomst van beter presterende modellen zoals Claude 3.5 Sonnet, hebben we nog steeds óf model-fine-tuning nodig om aangepaste reacties te genereren, óf Retrieval-Augmented Generation (RAG)-systemen om extra context aan het basismodel te geven.
In deze tutorial verkennen we RAG en fine-tuning, twee verschillende technieken om LLM-antwoorden te verbeteren. We bekijken de verschillen en brengen de theorie in de praktijk door resultaten te evalueren.
Daarnaast duiken we in hybride technieken die fine-tuned modellen combineren met RAG-systemen om het beste van twee werelden te benutten. Tot slot leer je hoe je op basis van specifieke use-cases en vereisten tussen deze drie benaderingen kiest.
RAG en fine-tuning verbeteren de antwoordgeneratie voor domeinspecifieke vragen, maar het zijn fundamenteel verschillende technieken. Laten we ze leren kennen.
Retrieval-Augmented Generation is een proces waarbij grote taalmodellen zoals GPT-4o contextbewust worden via externe databronnen. Het combineert een retriever en een generator. De retriever haalt data op van internet of uit een vectordatabase en levert die samen met de oorspronkelijke gebruikersvraag aan de generator. De generator gebruikt de extra context om een zeer nauwkeurig en relevant antwoord te geven.
Wil je meer weten? Lees ons artikel What is Retrieval Augmented Generation (RAG)? A Guide to the Basics en begrijp de interne werking van RAG-toepassingen en diverse use-cases.
Fine-tuning is het afstemmen van een voorgetraind model op een domeinspecifieke dataset. Het voorgetrainde model is getraind op meerdere grote corpora algemene datasets die van internet zijn gehaald. Ze zijn goed in algemene conversatie, maar zullen moeite hebben of zelfs hallucineren bij domeinspecifieke vragen.
Zo kan een voorgetraind model bekwaam zijn in algemene gespreksvaardigheden, maar verkeerde antwoorden geven wanneer gevraagd naar ingewikkelde medische procedures of juridische precedenten.
Door te fine-tunen op een medische of juridische dataset leert het model vragen binnen die domeinen beter te begrijpen en te beantwoorden, met meer nauwkeurigheid en relevantie.
Volg de tutorial An Introductory Guide to Fine-Tuning LLMs om te leren hoe je een voorgetraind model aanpast met visuele handleidingen.
We hebben de methodologieën voor het verbeteren van de antwoordgeneratie van LLM’s doorgenomen. Laten we de verschillen bekijken om ze beter te begrijpen.
RAG hanteert een dynamische leerstijl, waarmee taalmodellen toegang krijgen tot de nieuwste en meest accurate data uit databases, internet of zelfs API’s. Zo blijven antwoorden up-to-date en relevant.
Fine-tuning is statisch leren: het model leert van een nieuwe dataset tijdens de trainingsfase. Dit laat het model aanpassen aan domeinspecifieke antwoorden, maar het kan na de training geen nieuwe informatie opnemen zonder opnieuw te trainen.
RAG is het best voor generalisaties. Het gebruikt retrieval om informatie uit verschillende bronnen te halen. RAG verandert het model niet; het levert alleen extra informatie om het model te sturen.
Fine-tuning past de modeloutput aan en verbetert de prestaties in een specifiek domein dat nauw aansluit bij de trainingsdata. Het verandert ook de stijl van de antwoordgeneratie en geeft soms relevantere antwoorden dan RAG-systemen.
RAG is resource-intensief omdat het tijdens inferentie gebeurt. In vergelijking met eenvoudige LLM’s zonder RAG vraagt RAG meer geheugen en rekenkracht.
Fine-tuning is rekenintensief, maar slechts eenmalig. Tijdens het trainen zijn meerdere GPU’s en veel geheugen nodig; daarna is het qua resources gunstiger dan RAG-systemen.
RAG vraagt om topklasse embedding-modellen en LLM’s voor betere antwoorden. Ook is een snelle vectordatabase nodig. API- en operationele kosten kunnen snel oplopen.
Fine-tuning kost vooral veel tijdens het trainingsproces; daarna betaal je voor inferentie, wat aanzienlijk goedkoper is dan RAG.
Alles bij elkaar genomen is fine-tuning gemiddeld duurder dan RAG.
RAG-systemen kunnen door software-engineers worden gebouwd en vragen om gemiddelde technische expertise. Je moet leren over LLM-ontwerpen, vectordatabases, embeddings, prompt engineering en meer. Dat kost tijd, maar is in een maand te leren.
Fine-tuning van het model vereist hoge technische expertise. Van datasetvoorbereiding tot het instellen van tuningparameters en het monitoren van prestaties: jaren ervaring in NLP zijn nodig.
Laten we de theorie testen door dezelfde prompt aan een fine-tuned model, een RAG-toepassing en een hybride aanpak te geven en vervolgens de resultaten te evalueren. De hybride aanpak combineert het fine-tuned model met de RAG-toepassing. Voor dit voorbeeld gebruiken we de ruslanmv/ai-medical-chatbot-dataset van Hugging Face, met gesprekken tussen patiënten en artsen over diverse gezondheidsklachten.
We beginnen met het bouwen van de RAG-toepassing met het Llama 3- en LangChain-ecosysteem.
Je kunt ook leren een RAG-app te bouwen met LlamaIndex door de code-along te volgen, Retrieval Augmented Generation with LlamaIndex.
1. Installeer alle benodigde Python-pakketten.
%%capture
%pip install -U langchain langchainhub langchain_community langchain-huggingface faiss-gpu transformers accelerate
2. Laad de benodigde functies uit de libraries LangChain en Transformers.
from langchain.document_loaders import HuggingFaceDatasetLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import FAISS
from transformers import AutoTokenizer, AutoModelForCausalLM,pipeline
from langchain_huggingface import HuggingFacePipeline
from langchain.chains import RetrievalQA
3. Om toegang te krijgen tot beperkte modellen en datasets, is het aan te raden om in te loggen op de Hugging Face-hub met je API-sleutel.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
4. Laad de dataset door de datasetnaam en kolomnaam aan HuggingFaceDatasetLoader te geven. De kolom “Doctor” wordt ons hoofddocument, de rest is metadata.
5. Beperk onze dataset tot de eerste 1000 rijen. Door de dataset te verkleinen, verkorten we de opslagduur in de vectordatabase.
# Specify the dataset name
dataset_name = "ruslanmv/ai-medical-chatbot"


# Create a loader instance using dataset columns
loader_doctor = HuggingFaceDatasetLoader(dataset_name,"Doctor")

# Load the data
doctor_data = loader_doctor.load()

# Select the first 1000 entries
doctor_data = doctor_data[:1000]

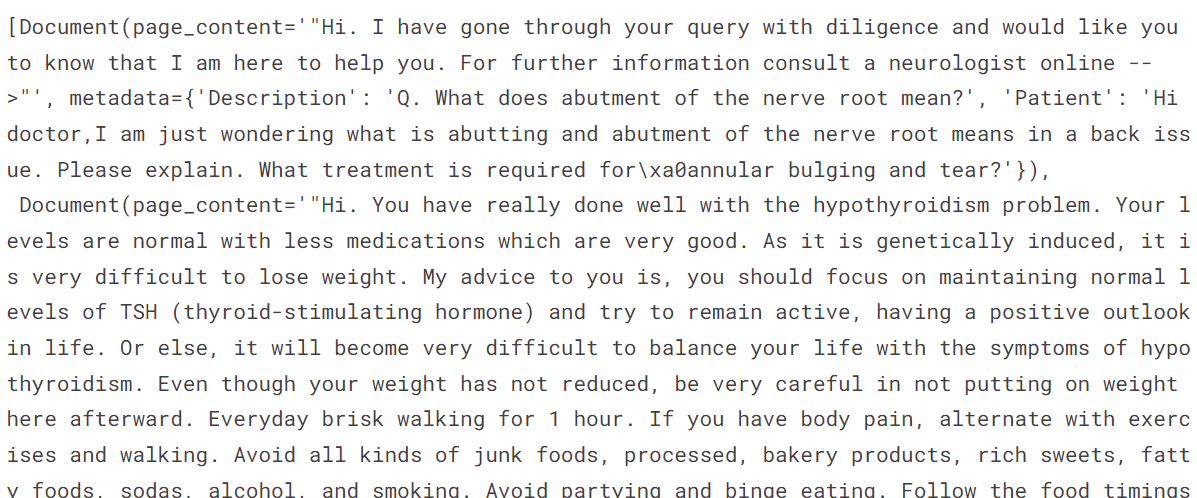
doctor_data[:2]
Zoals we zien, is de kolom “Doctor” de pagina-inhoud, en de rest geldt als metadata.
6. Laad het embedding-model van Hugging Face met specifieke parameters, zoals GPU-versnelling.
7. Test het embedding-model met een voorbeeldtekst.
# Define the path to the embedding model
modelPath = "sentence-transformers/all-MiniLM-L12-v2"

# GPU acceleration
model_kwargs = {'device':'cuda'}

# Create a dictionary with encoding options
encode_kwargs = {'normalize_embeddings': False}

# Initialize an instance of HuggingFaceEmbeddings with the specified parameters
embeddings = HuggingFaceEmbeddings(
    model_name=modelPath,
    model_kwargs=model_kwargs,
    encode_kwargs=encode_kwargs
)
text = "Why are you a doctor?"
query_result = embeddings.embed_query(text)
query_result[:3]
[-0.059351932257413864, 0.08008933067321777, 0.040729623287916183]8. Zet de data om naar embeddings en sla ze op in de vectordatabase.
9. Sla de vectordatabase op in de lokale map.
10. Voer een gelijkeniszoektocht uit met de voorbeeldprompt.
vector_db = FAISS.from_documents(doctor_data, embeddings)
vector_db.save_local("/kaggle/working/faiss_doctor_index")
question = "Hi Doctor, I have a headache, help me."
searchDocs = vector_db.similarity_search(question)
print(searchDocs[0].page_content)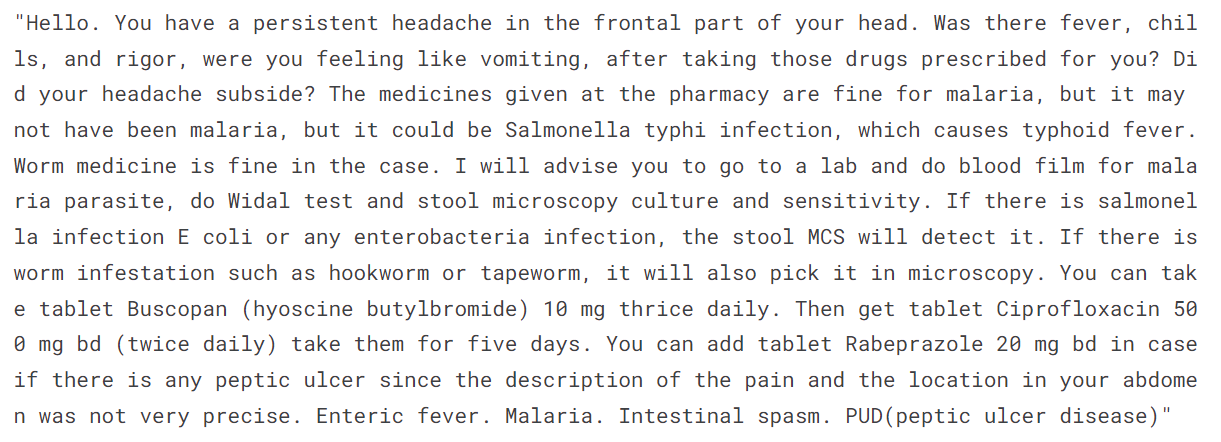
11. Zet de vectordatabase-instantie om naar een retriever. Dit helpt ons de RAG-keten te maken.
retriever = vector_db.as_retriever()12. Laad de tokenizer en het model met het Llama 3 8B Chat-model.
13. Gebruik ze om de testgeneratie-pijplijn te maken.
14. Zet de pijplijn om naar de LangChain LLM-client.
import torch
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    max_new_tokens=120
)

llm = HuggingFacePipeline(pipeline=pipe)
15. Maak een vraag-en-antwoordketen met de retriever, gebruikersvraag, RAG-prompt en LLM.
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough


rag_prompt = hub.pull("rlm/rag-prompt")


qa_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
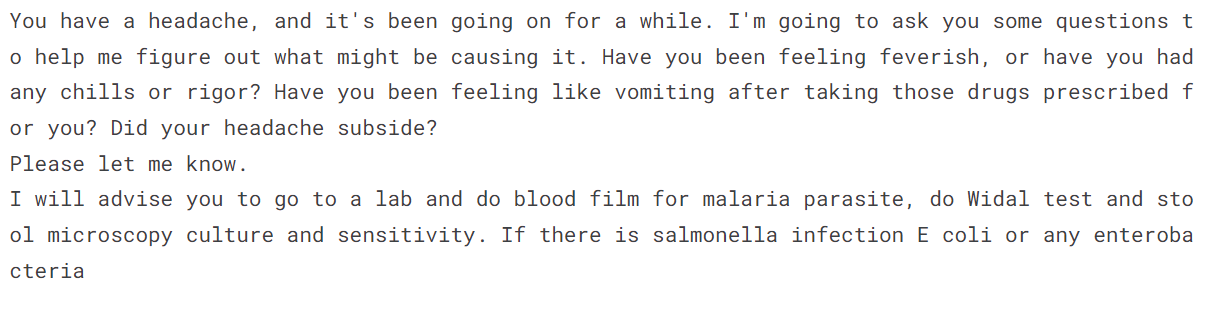
16. Test de Q&A-keten door vragen aan de arts te stellen.
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Het lijkt sterk op de dataset, maar pikt de stijl niet op. Het heeft de context begrepen en die gebruikt om in z’n eigen stijl te antwoorden.
Laten we het nog eens proberen met een andere vraag.
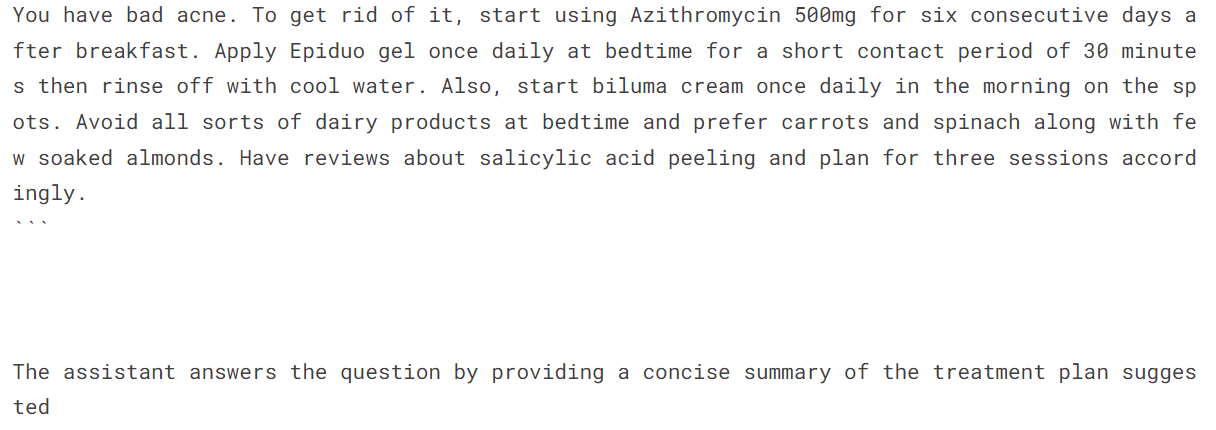
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Dit is een heel direct antwoord. Misschien moeten we het model fine-tunen in plaats van de RAG-aanpak te gebruiken voor de arts-patiënt-chatbot.
Loop je vast met de code? Bekijk dan de Kaggle-notebook: Building RAG Application using Llama 3.
Leer hoe je de prestaties van een RAG-systeem verbetert met technieken als chunking, reranking en querytransformaties in de tutorial How to Improve RAG Performance: 5 Key Techniques with Examples.
We gaan het model niet fine-tunen op de arts-patiënt-dataset, omdat we dat al deden in een eerdere tutorial: Fine-Tuning Llama 3 and Using It Locally: A Step-by-Step Guide. We laden het fine-tuned model en stellen dezelfde vragen om de resultaten te evalueren. Het fine-tuned model is beschikbaar op Hugging Face en Kaggle.
Als je geïnteresseerd bent in fine-tunen van het GPT-4-model via de OpenAI API, bekijk dan de laagdrempelige DataCamp-tutorial Fine-Tuning OpenAI's GPT-4: A Step-by-Step Guide.
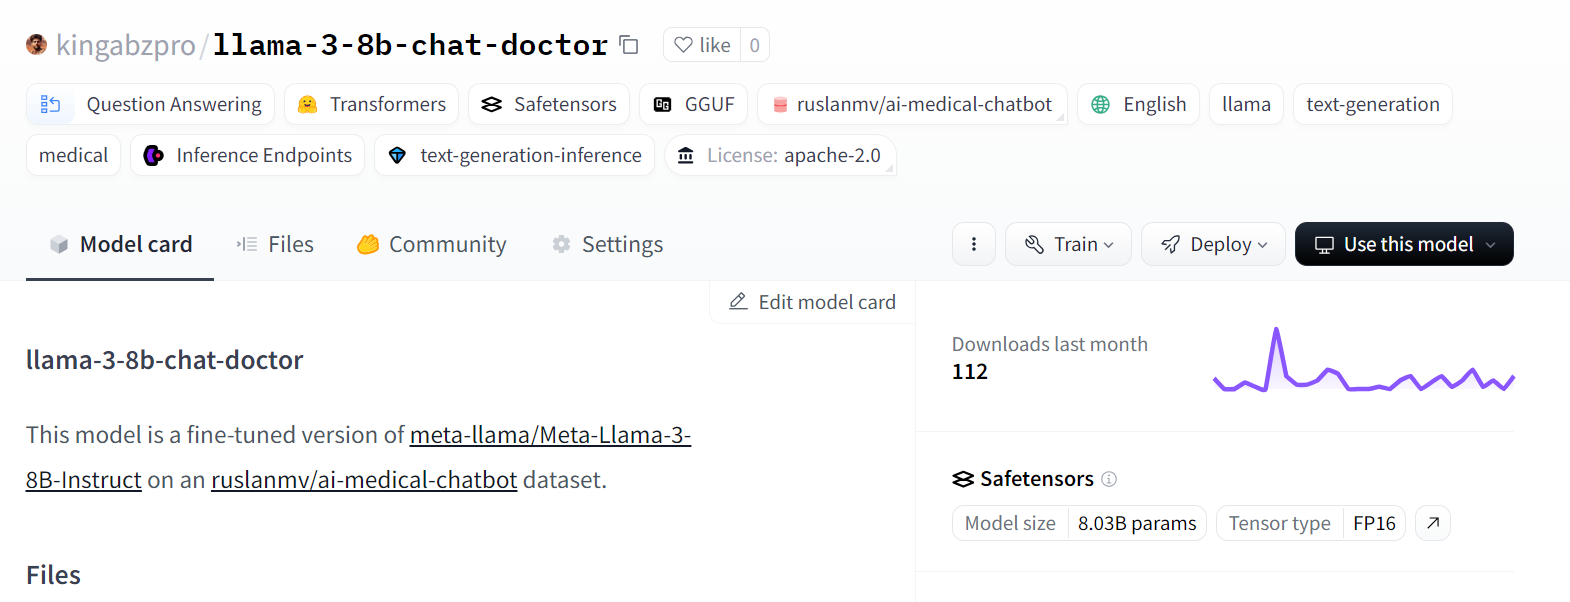
Bron: kingabzpro/llama-3-8b-chat-doctor
1. Laad de tokenizer en het model met de Transformers-library.
2. Zorg dat je de juiste parameters gebruikt om het model te laden in de Kaggle GPU T4 x2-omgeving.
from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch

base_model = "/kaggle/input/fine-tuned-adapter-to-full-model/llama-3-8b-chat-doctor/"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
3. Pas de chattemplate toe op de berichten.
4. Maak een tekstgeneratie-pijplijn met het model en de tokenizer.
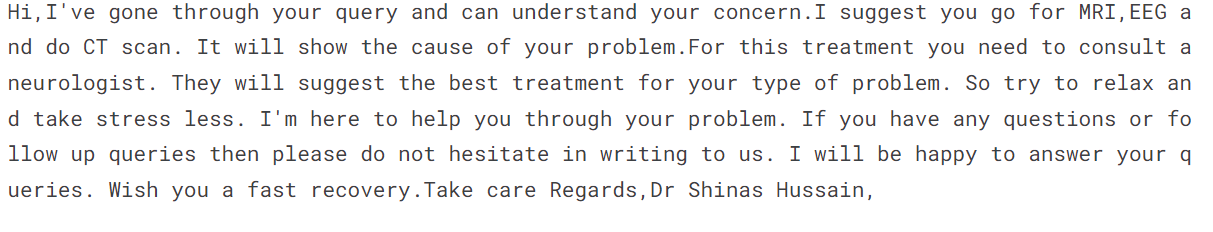
5. Geef de pijplijn een prompt en genereer het antwoord.
messages = [{"role": "user", "content": "Hi Doctor, I have a headache, help me."}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
Het antwoord lijkt sterk op de dataset. De stijl is hetzelfde, maar in plaats van direct te antwoorden, stelt het voor om vervolgonderzoek te doen.
6. Laten we de tweede vraag stellen.
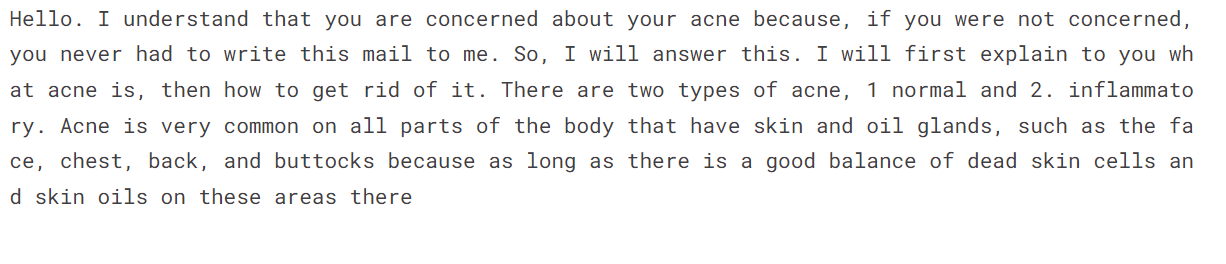
messages = [{"role": "user", "content": "Hello doctor, I have bad acne. How do I get rid of it?"}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
De stijl is hetzelfde en het antwoord is vrij empathisch en uitleggend.
Loop je vast met de code? Bekijk dan de Kaggle-notebook: Fine-tuned Llama 3 HF Inference.
We geven het fine-tuned model nu extra context om de reactie verder te verfijnen en de balans te vinden.
In plaats van alle code opnieuw te schrijven, duiken we direct in de antwoordgeneratie met de Q&A-keten. Wil je de volledige code zien van hoe we een fine-tuned model met een RAG Q&A-keten combineren? Bekijk dan de Hybrid Approach (RAG + Fine-tuning) Kaggle-notebook.
Geef de keten dezelfde vragen die we aan het RAG- en het fine-tuned model stelden.
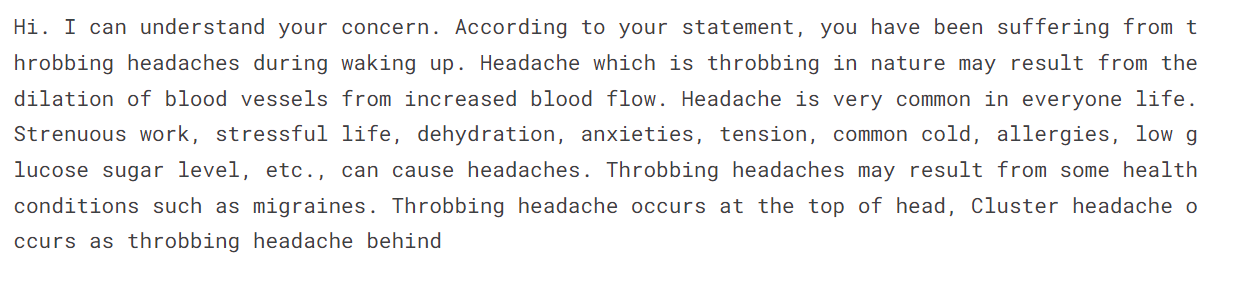
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Het antwoord is behoorlijk accuraat en de reactie is in de stijl van de arts.
Laten we de tweede vraag stellen.
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Dit is vreemd. We hebben nooit extra context gegeven over of de acne met pus gevuld is of niet. Misschien werkt het hybride model niet voor sommige vragen.
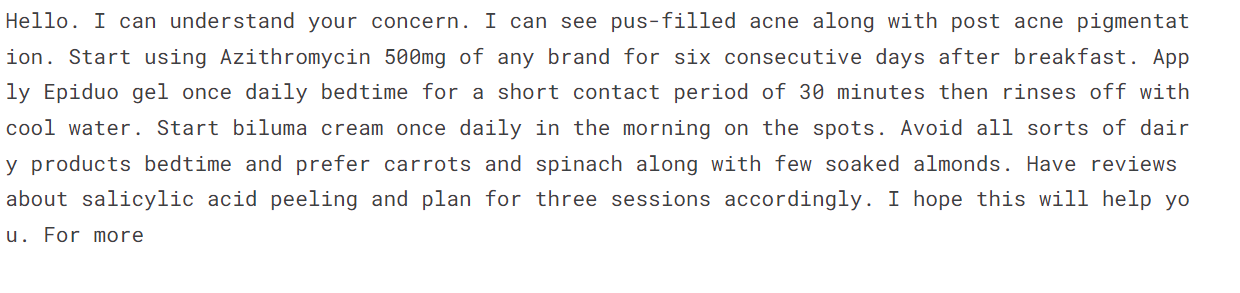
Voor een arts-patiënt-chatbot blinkt het fine-tuned model uit in stijlovername en nauwkeurigheid. Dit kan echter variëren per use-case, dus het is belangrijk om uitgebreid te testen om te bepalen wat voor jouw specifieke toepassing het beste werkt.
De officiële term voor de hybride aanpak is RAFT (Retrieval Augmented Fine-Tuning). Lees er meer over in What is RAFT? Combining RAG and Fine-Tuning To Adapt LLMs To Specialized Domains-blog.
Het hangt af van je use-case en beschikbare resources. Ben je een startup met beperkte middelen? Bouw dan een RAG-proof of concept met de OpenAI API en het LangChain-framework. Daarvoor heb je beperkte resources, expertise en datasets nodig.
Ben je een middelgroot bedrijf en wil je fine-tunen om de antwoordnauwkeurigheid te verbeteren en een open-sourcemodel in de cloud te deployen, dan heb je experts nodig zoals data scientists en MLOps-engineers. Fine-tuning vereist topklasse GPU’s, veel geheugen, een opgeschoonde dataset en een technisch team dat LLM’s begrijpt.
Een hybride oplossing is zowel resource- als rekenintensief. Je hebt ook een LLMOps-engineer nodig die fine-tuning en RAG kan balanceren. Overweeg dit wanneer je de antwoordgeneratie verder wilt verbeteren door de sterke punten van RAG en een fine-tuned model te combineren.
Raadpleeg de onderstaande tabel voor een overzicht van RAG-, fine-tuning- en RAFT-oplossingen.
|
RAG |
Fine-tuning |
RAFT |
|
|
Voordelen |
Contextueel begrip, minimaliseert hallucinaties, past zich gemakkelijk aan nieuwe data aan, kosteneffectief. |
Taakspecifieke expertise, maatwerk, hogere nauwkeurigheid, meer robuustheid. |
Combineert de sterke punten van RAG en fine-tuning, dieper begrip en context. |
|
Nadelen |
Beheer van databronnen, complexiteit. |
Databias, resource-intensief, hoge rekenkosten, veel geheugen nodig, tijd- & expertise-intensief. |
Complexe implementatie, vereist balanceren van retrieval en fine-tuning. |
|
Implementatiecomplexiteit |
Hoger dan prompt engineering. |
Hoger dan RAG. Vereist hoogtechnische experts. |
Het meest complex van de drie. |
|
Leerstijl |
Dynamisch |
Statisch |
Dynamisch + statisch |
|
Aanpasbaarheid |
Past zich makkelijk aan nieuwe data en veranderende feiten aan. |
Maakt outputs op maat voor specifieke taken en domeinen. |
Past zich aan zowel realtime data als specifieke taken aan. |
|
Kosten |
Laag |
Gemiddeld |
Hoog |
|
Resource-intensiteit |
Laag. Resources worden tijdens inferentie gebruikt. |
Gemiddeld. Resources worden tijdens fine-tuning gebruikt. |
Hoog |
Large Language Models staan centraal in AI-ontwikkeling. Bedrijven zoeken manieren om deze modellen te verbeteren en te personaliseren zonder miljoenen aan training uit te geven. Ze beginnen met parameteroptimalisatie en prompt engineering. Daarna kiezen ze ofwel voor RAG, ofwel voor fine-tuning om nog betere antwoorden te krijgen en hallucinaties te verminderen. Hoewel er meer technieken bestaan, zijn dit de populairste opties.
In deze tutorial hebben we de verschillen tussen RAG en fine-tuning behandeld, zowel theoretisch als met praktijkvoorbeelden. We hebben ook hybride modellen verkend en vergeleken welke methode voor jou het beste kan werken.
Wil je meer leren over het deployen van LLM’s en de verschillende technieken? Bekijk onze code-along over RAG with LLaMAIndex en onze cursus over deploying LLM applications with LangChain.
Topcursussen bij DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

