

Bagaimana Cara Kerja Retrieval Augmented Generation (RAG)?
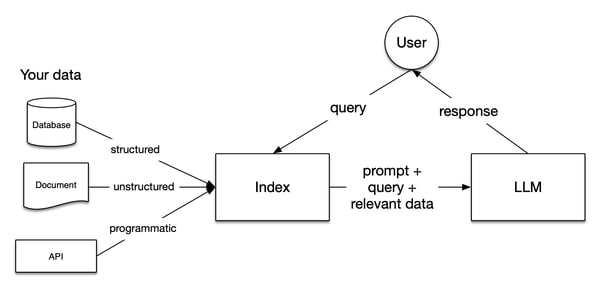
Gambar dari Dokumentasi LlamaIndex
Retrieval Augmented Generation (RAG) terdiri dari tiga langkah: Pengindeksan, Pengambilan, dan Generasi.
Pengindeksan
Pengindeksan adalah dasar untuk mendapatkan jawaban yang akurat dan peka konteks dengan LLM. Pertama, proses dimulai dengan mengekstraksi dan membersihkan data dari berbagai format file, seperti Dokumen Word, file PDF, atau file HTML. Setelah data dibersihkan, data diubah menjadi teks polos standar. Untuk menghindari keterbatasan konteks dalam LLM, teks dipecah menjadi potongan-potongan kecil. Proses ini disebut Chunking. Setelah itu, setiap potongan diubah menjadi vektor numerik atau embedding menggunakan model embedding. Terakhir, sebuah indeks dibangun untuk menyimpan potongan dan embedding terkaitnya sebagai pasangan kunci-nilai.
Pengambilan
Selama tahap pengambilan, kueri pengguna juga diubah menjadi representasi vektor menggunakan model embedding yang sama. Lalu, skor kemiripan antara vektor kueri dan potongan yang telah diberi vektor dihitung. Sistem mengambil K potongan teratas dengan kemiripan terbesar terhadap kueri pengguna.
Generasi
Kueri pengguna dan potongan yang diambil dimasukkan ke dalam templat prompt. Prompt yang telah diperkaya dari langkah sebelumnya kemudian diberikan sebagai input ke LLM.
Keterbatasan RAG
Saat membangun sistem RAG, ada tantangan signifikan yang mungkin Anda temui pada ketiga langkah di atas, seperti berikut:
- Pengindeksan: Efektivitas RAG sangat dipengaruhi oleh kualitas data. Jika sumber data eksternal lebih berisik daripada informatif, respons yang dihasilkan LLM tidak akan berguna.
- Pengambilan: Tergantung pada jenis file Anda dan bagaimana Anda menyiapkan sistem RAG, sistem tidak selalu mengambil potongan yang membantu menjawab kueri pengguna.
- Generasi: Meski sistem RAG disiapkan secara efektif, LLM masih dapat menghasilkan jawaban yang salah berdasarkan fakta yang dibayangkan.
Di bawah ini, kami akan mengeksplorasi strategi untuk mengatasi keterbatasan ini. Kami akan membahas tiga strategi utama: Chunking, Re-Ranking, dan Transformasi Kueri. Selain itu, kami akan menunjukkan bagaimana strategi-strategi ini dapat membantu meningkatkan performa RAG dengan membangun sistem RAG yang menjawab pertanyaan tentang entri Wikipedia menggunakan Llamaindex dan OpenAI API. Mari kita mulai!
Menyiapkan Sistem RAG Garis Dasar
Sebelum mengeksplorasi trik untuk meningkatkan performa sistem RAG, kita perlu menetapkan performa dasar dengan membangun pipeline RAG sederhana. Mari mulai dengan memasang paket llama-index dan openai.
!pip install llama-index
!pip install openaiLlamaindex adalah kerangka kerja data untuk aplikasi berbasis Large Language Model (LLM). Ini memungkinkan Anda untuk menyerap berbagai jenis sumber data eksternal, membangun sistem Retrieval Augmentation Generation (RAG), dan mengabstraksi integrasi dengan LLM lain hanya dalam beberapa baris kode. Selain itu, Llamaindex menyediakan berbagai teknik untuk menghasilkan keluaran LLM yang lebih akurat.
Secara default, Llamaindex menggunakan model OpenAI gpt-3.5-turbo untuk generasi teks dan model text-embedding-ada-002 untuk pengambilan dan embedding. Untuk menggunakan model-model ini, Anda perlu membuat akun gratis di platform OpenAI dan mendapatkan kunci OpenAI API. Untuk mendapatkan kuncinya, silakan kunjungi dokumentasi OpenAI API.
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"Sekarang paket telah terpasang, kita akan membangun sistem RAG yang menjawab pertanyaan berdasarkan halaman Wikipedia tentang Emma Stone, Ryan Gosling, dan La La Land. Pertama, kita perlu memasang pustaka wikipedia untuk mengekstrak halaman Wikipedia:
!pip install wikipediaLalu, kita dapat dengan mudah mengunduh data dari Wikipedia:
# Import packages
from llama_index.core import (VectorStoreIndex,ServiceContext, download_loader)
# Download the documents from Wikipedia and load them
WikipediaReader = download_loader("WikipediaReader")
loader = WikipediaReader()
pages = ['Emma_Stone', 'La_La_Land', 'Ryan_Gosling']
documents = loader.load_data(pages=pages, auto_suggest=False, redirect = False)Setelah data diekstrak, kita dapat membagi dokumen menjadi potongan berukuran 256 karakter tanpa overlap. Selanjutnya, potongan-potongan ini diubah menjadi vektor numerik menggunakan model embedding dan diindeks dalam Vector Store.
# Initialize the gpt3.5 model
gpt3 = OpenAI(temperature=0, model="gpt-3.5-turbo-instruct", api_key=OPENAI_API_KEY)
# Initialize the embedding model
embed_model = OpenAIEmbedding(model= OpenAIEmbeddingModelType.TEXT_EMBED_ADA_002, api_key=OPENAI_API_KEY)
# Transform chunks into numerical vectors using the embedding model
service_context_gpt3 = ServiceContext.from_defaults(llm=gpt3, chunk_size = 256, chunk_overlap=0, embed_model=embed_model)
index = VectorStoreIndex.from_documents(documents, service_context=service_context_gpt3)
retriever = index.as_retriever(similarity_top_k=3)Untuk mengurangi risiko halusinasi, kami menggunakan modul PromptTemplate untuk memastikan jawaban LLM hanya didasarkan pada konteks yang disediakan.
from llama_index.core.prompts import PromptTemplate
# Build a prompt template to only provide answers based on the loaded documents
template = (
"We have provided context information below. \n"
"---------------------\n"
"{context_str}"
"\n---------------------\n"
"Given this information, please answer the question: {query_str}\n"
"Don't give an answer unless it is supported by the context above.\n"
)
qa_template = PromptTemplate(template)Sekarang sistem RAG telah disiapkan, kita bisa mengujinya dengan pertanyaan berdasarkan dokumen yang diambil. Mari kita coba!
Kueri 1: “Apa alur film yang membuat Emma Stone memenangkan Academy Award pertamanya?”
Kueri pertama ini menantang karena mengharuskan model melihat beberapa potongan informasi:
- Nama film yang membuat Emma Stone memenangkan Academy Award pertamanya (dalam hal ini, La La Land)
- Alur film tersebut.
# Create a prompt for the model
question = "What is the plot of the film that led Emma Stone to win her first Academy Award?"
# Retrieve the context from the model
contexts = retriever.retrieve(question)
context_list = [n.get_content() for n in contexts]
prompt = qa_template.format(context_str="\n\n".join(context_list), query_str=question)
# Generate the response
response = gpt3.complete(prompt)
print(str(response))Keluaran:
The plot of the film that made Emma Stone win her first Academy Award is not explicitly mentioned in the provided context.Kueri 2: "Bandingkan keluarga Emma Stone dan Ryan Gosling”
Kueri kedua ini bahkan lebih menantang daripada pertanyaan sebelumnya karena meminta memilih potongan relevan terkait keluarga kedua aktor.
# Create a prompt for the model
question = "Compare the families of Emma Stone and Ryan Gosling"
# Retrieve the context from the model
contexts = retriever.retrieve(question)
context_list = [n.get_content() for n in contexts]
prompt = qa_template.format(context_str="\n\n".join(context_list), query_str=question)
# Generate the response
response = gpt3.complete(prompt)
print(str(response))Kita menerima keluaran berikut:
Based on the context provided, it is not possible to compare the families of Emma Stone and Ryan Gosling as the information focuses on their professional collaboration and experiences while working on the film "La La Land." There is no mention of their personal family backgrounds or relationships in the context provided.Seperti yang Anda lihat, kita menerima jawaban yang kurang memuaskan pada kedua kasus. Pada bagian berikutnya, mari kita jelajahi cara meningkatkan performa sistem RAG ini!
Meningkatkan Performa RAG dengan Memperbarui Ukuran Chunk
Kita dapat mulai dengan menyesuaikan ukuran chunk dan overlap-nya. Seperti disebutkan di atas, dokumen dipecah menjadi potongan dengan overlap tertentu. Secara default, LlamaIndex menggunakan 1024 sebagai ukuran chunk dan 20 sebagai overlap chunk. Selain dua hiperparameter ini, sistem secara default mengambil 2 potongan teratas.
Sebagai contoh, kita dapat menetapkan ukuran chunk ke 512, overlap ke 50, dan menambah jumlah potongan teratas yang diambil:
# modify default values of chunk size and chunk overlap
service_context_gpt3 = ServiceContext.from_defaults(llm=gpt3, chunk_size = 512, chunk_overlap=50, embed_model=embed_model)
# build index
index = VectorStoreIndex.from_documents(
documents, service_context=service_context_gpt3
)
# returns the engine for the index
query_engine = index.as_query_engine(similarity_top_k=4)Kueri 1: “Apa alur film yang membuat Emma Stone memenangkan Academy Award pertamanya?”
# generate the response
response = query_engine.query("What is the plot of the film that led Emma Stone to win her first Academy Award?")
print(response)Keluaran:
The film that made Emma Stone win her first Academy Award is a romantic musical called La La Land.Dibanding jawaban sebelumnya, ini sedikit lebih baik. Model berhasil mengenali La La Land sebagai film yang membuat Emma Stone memenangkan Academy Award pertamanya, tetapi belum mampu menjelaskan alur filmnya.
Kueri 2: "Bandingkan keluarga Emma Stone dan Ryan Gosling”
# generate the response
response = query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
print(response)Keluaran:
Emma Stone has expressed her close relationship with her family and mentioned being blessed with great family and people around her. She has also shared about her mother's battle with breast cancer and their celebration by getting matching tattoos. On the other hand, there is no specific information provided about Ryan Gosling's family or his personal relationships in the context.Sekali lagi, keluaran pipeline RAG membaik, tetapi masih belum menangkap informasi tentang keluarga Ryan Gosling.
Meningkatkan Performa RAG dengan Re-Ranking
Seiring bertambahnya ukuran dan kompleksitas dataset, memilih informasi relevan untuk mengembalikan jawaban yang sesuai terhadap kueri kompleks menjadi sangat penting. Untuk tujuan ini, keluarga teknik yang disebut Re-Ranking memungkinkan Anda memahami potongan mana yang penting dalam teks. Teknik ini menyusun ulang dan memfilter dokumen, dengan memeringkat yang paling relevan terlebih dahulu.
Ada dua pendekatan utama untuk Re-Ranking:
- Menggunakan model Re-Ranking sebagai teknik alternatif untuk model embedding. Model ini menerima kueri dan konteks sebagai input dan mengembalikan skor kemiripan alih-alih embedding
- Menggunakan LLM untuk menangkap informasi semantik dalam dokumen secara lebih efisien.
Sebelum menerapkan pendekatan Re-Ranking ini, mari kita evaluasi apa yang dikembalikan sistem RAG dasar sebagai tiga potongan teratas untuk kueri kedua:
# Retrieve the top three chunks for the second query
retriever = index.as_retriever(similarity_top_k=3)
query = "Compare the families of Emma Stone and Ryan Gosling"
nodes = retriever.retrieve(query)
# Print the chunks
for node in nodes:
print('----------------------------------------------------')
display_source_node(node, source_length = 500)Ini adalah keluaran sebelum Re-Ranking; setiap potongan memiliki Node ID dengan skor kemiripan.
Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 0.8415899563985404
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------
Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 0.831147173341674
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles. Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...
----------------------------------------------------
Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 0.8289486590392277
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...Re-Ranking dengan FlagEmbeddingReranker
Untuk mengambil potongan relevan, kita dapat menggunakan model Re-Ranking open-source dari Hugging Face, bernama model bge-ranker-base.
Sama seperti OpenAI API, menggunakan Hugging Face mengharuskan Anda mendapatkan token akses pengguna. Anda dapat membuat token akses pengguna dari Hugging Face dengan mengikuti dokumentasi ini.
HF_TOKEN = userdata.get('HF_TOKEN')
os.environ['HF_TOKEN'] = HF_TOKENSebelum melangkah lebih jauh, kita juga perlu memasang pustaka yang diperlukan untuk menggunakan model Re-Ranking:
%pip install llama-index-postprocessor-flag-embedding-reranker
!pip install git+https://github.com/FlagOpen/FlagEmbedding.gitTerakhir, kita gunakan model bge-ranker-base untuk mengembalikan potongan paling relevan.
# Import packages
from llama_index.postprocessor.flag_embedding_reranker import FlagEmbeddingReranker
from llama_index.core.schema import QueryBundle
# Re-Rank chunks based on the bge-reranker-base-model
reranker = FlagEmbeddingReranker(
top_n = 3,
model = "BAAI/bge-reranker-base",
)
# Return the updated chunks
query_bundle = QueryBundle(query_str=query)
ranked_nodes = reranker._postprocess_nodes(nodes, query_bundle = query_bundle)
for ranked_node in ranked_nodes:
print('----------------------------------------------------')
display_source_node(ranked_node, source_length = 500)Ini adalah hasil setelah Re-Ranking:
Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 3.0143558979034424
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------
Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 2.2117154598236084
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...
----------------------------------------------------
Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 1.6185210943222046
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles.Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...Dari keluaran tersebut, jelas bahwa node dengan ID 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f berpindah dari posisi kedua ke ketiga. Selain itu, terlihat adanya variabilitas yang lebih besar dalam skor kemiripan.
Sekarang setelah kita menggunakan Re-Ranking, mari evaluasi seperti apa respons RAG terhadap kueri asli:
# Initialize the query engine with Re-Ranking
query_engine = index.as_query_engine(
similarity_top_k = 3,
node_postprocessors=[reranker]
)
# Print the response from the model
response = query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
print(response)Ini adalah respons setelah menerapkan model Re-Ranking:
Both Emma Stone and Ryan Gosling have close relationships with their families. Stone has expressed her gratitude for having a great family and people around her who keep her grounded. Gosling, on the other hand, has drawn from his own experiences as an aspiring artist, indicating a connection to his personal background.Ada peningkatan signifikan dibandingkan respons sebelumnya, tetapi masih belum lengkap. Mari kita evaluasi bagaimana pendekatan Re-Ranking berbasis LLM dapat membantu meningkatkan performa RAG.
Re-Ranking dengan RankGPTRerank
Kali ini, kita dapat mengandalkan LLM sebagai Re-Ranker. Di sini, kita menggunakan modul RankGPT, yang memanfaatkan kemampuan model GPT untuk memeringkat dokumen dalam sistem RAG. Untuk memulai, kita pasang paket yang diperlukan:
%pip install llama-index-postprocessor-rankgpt-rerankKita menggunakan fungsi RankGPTRerank untuk melakukan Re-Ranking pada potongan dengan model gpt-3.5-turbo-0125.
# Import packages
from llama_index.postprocessor.rankgpt_rerank import RankGPTRerank
# Re-Rank the top 3 chunks based on the gpt-3.5-turbo-0125 model
reranker = RankGPTRerank(
top_n = 3,
llm = OpenAI(model="gpt-3.5-turbo-0125"),
)
# Display the top 3 chunks based on RankGPT
query_bundle = QueryBundle(query_str=query)
ranked_nodes = reranker._postprocess_nodes(nodes, query_bundle = query_bundle)
for ranked_node in ranked_nodes:
print('----------------------------------------------------')
display_source_node(ranked_node, source_length = 500)Dengan menggunakan RankGPT, kita mendapatkan potongan berikut:
----------------------------------------------------
Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 1.6185210943222046
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles.Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...
----------------------------------------------------
Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 3.0143558979034424
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------
Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 2.2117154598236084
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...Karena RankGPT tidak mengurutkan potongan berdasarkan skor kemiripan, skor yang disajikan dalam keluaran tidak diperbarui. Dari keluaran, kita dapat melihat bahwa node pertama yang dianggap paling relevan menyebutkan Emma Stone dan Ryan Gosling, sementara node lainnya berisi lebih banyak detail tentang kehidupan Emma Stone.
Sekarang, jika kita mencetak respons model dengan Metodologi Re-Ranking ini, kita mendapatkan keluaran berikut:
Both Emma Stone and Ryan Gosling have close relationships with their families. Stone has expressed gratitude for having a great family and supportive people around her, while Gosling has drawn from his own experiences as an aspiring artist, indicating a connection to his family as well. Stone's family has played a significant role in her life, supporting her career pursuits and celebrating important milestones with her. Similarly, Gosling's experiences as an actor have likely been influenced by his family dynamics and relationships.Jawabannya lebih panjang dan berisi lebih banyak detail daripada teknik Re-Ranking sebelumnya.
Meningkatkan Performa RAG dengan Transformasi Kueri
Transformasi kueri, juga disebut penulisan ulang kueri, adalah pendekatan yang mengubah sebuah kueri menjadi kueri lain alih-alih menggunakan kueri mentah untuk mengambil k potongan teratas. Kita akan mengeksplorasi teknik berikut:
- HyDE: Kita mengubah kueri pengguna dan jawaban hipotetisnya menjadi embedding untuk mengambil dokumen yang paling cocok di ruang vektor.
- Transformasi Kueri Multi-Langkah: Kita membagi kueri pengguna yang kompleks menjadi subpertanyaan berurutan untuk pemrosesan yang efektif.
Meningkatkan Performa RAG dengan HyDE
HyDE adalah singkatan dari Hypothetical Document Embeddings. Terdiri dari dua langkah. Pertama, membuat jawaban hipotetis untuk kueri pengguna. Setelah jawaban/dokumen hipotetis ditentukan, jawaban dan kueri diubah menjadi embedding. Lalu, sistem mengambil dokumen yang paling dekat dengan embedding di ruang vektor. Mari kita lihat praktiknya!
# Import packages
from llama_index.core.indices.query.query_transform import HyDEQueryTransform
from llama_index.core.query_engine.transform_query_engine import (
TransformQueryEngine,
)
# build index and query engine for the index
index = VectorStoreIndex.from_documents(documents, service_context=service_context_gpt3)
query_engine = index.as_query_engine(similarity_top_k=4)
# HyDE setup
hyde = HyDEQueryTransform(include_original=True)
# Transform the query engine using HyDE
hyde_query_engine = TransformQueryEngine(query_engine, hyde)
# Print the response from the model
response = hyde_query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
print(response)Ini adalah keluarannya:
Both Emma Stone and Ryan Gosling come from diverse family backgrounds. Ryan Gosling's parents were of part French Canadian descent, along with some German, English, Scottish, and Irish. He grew up in a family that practiced the Church of Jesus Christ of Latter-day Saints. On the other hand, Emma Stone was born and raised in Scottsdale, Arizona, without specific details provided about her family's ethnic background or religious affiliation.Dibanding metode Re-Ranking, kita melihat peningkatan parsial. Sebelumnya, keluaran lebih terkait dengan hubungan para aktor dengan keluarga mereka. Kini, fokusnya lebih pada asal-usul.
Meningkatkan Performa RAG dengan Transformasi Kueri Multi-Langkah
Pendekatan transformasi kueri multi-langkah membagi kueri pengguna menjadi subpertanyaan berurutan. Metode ini berguna saat bekerja dengan pertanyaan kompleks.
Seperti yang kita perhatikan, LLM cenderung kesulitan saat membandingkan dua fakta, meskipun dapat menjawab dengan benar ketika pertanyaannya hanya mengenai topik spesifik. Di sini, kita dapat melihat transformasi kueri multi-langkah dalam praktik.
# Multi-step query setup
step_decompose_transform_gpt3 = StepDecomposeQueryTransform(gpt3, verbose=True)
index_summary = "Breaks down the initial query"
# Return query engine for the index
multi_step_query_engine = MultiStepQueryEngine(
query_engine=query_engine,
query_transform=step_decompose_transform_gpt3,
index_summary=index_summary
)
# print the response from the model
response = multi_step_query_engine.query("Compare the families of Emma Stone and Ryan Gosling")Kita dapat melihat pertanyaan perantara yang memungkinkan kita mencapai keluaran akhir:
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is the family background of Emma Stone and Ryan Gosling?
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is the specific family background of Emma Stone?
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is Emma Stone's relationship with her family like?Berikut respons untuk kueri pengguna:
Both Ryan Gosling and Emma Stone have strong family connections, with Emma Stone emphasizing the importance of her family in keeping her grounded. Ryan Gosling's family background includes a mix of French Canadian, German, English, Scottish, and Irish heritage.Dalam kasus ini, menggunakan transformasi kueri multi-langkah untuk membandingkan keluarga Emma Stone dan Ryan Gosling terbukti membantu.
Kesimpulan
Dalam artikel ini, Anda telah mempelajari berbagai teknik untuk Meningkatkan Performa RAG. Baik itu Chunking, Re-Ranking, maupun Transformasi Kueri, pendekatan terbaik sering kali bergantung pada kasus penggunaan dan keluaran yang Anda inginkan untuk suatu kueri.
Jika Anda ingin mendalami RAG, kami merekomendasikan menonton code-along kami tentang Retrieval Augmented Generation dengan LlamaIndex dan Retrieval Augmented Generation dengan GPT dan Milvus. Video-video ini menunjukkan cara menggabungkan LLM dengan basis data vektor menggunakan retrieval augmented generation pada berbagai kasus penggunaan.

Data Scientist - CRIF





Retrieval Augmented Generation (RAG) adalah salah satu teknik paling populer untuk meningkatkan akurasi dan keandalan Large Language Model (LLM). Hal ini dimungkinkan dengan menyediakan informasi tambahan dari sumber data eksternal. Dengan cara ini, jawaban dapat disesuaikan dengan konteks spesifik dan diperbarui tanpa fine-tuning dan pelatihan ulang.
Terlepas dari popularitas RAG, teknik ini tidak selalu bekerja dengan baik di semua konteks. Dalam artikel ini, kami akan menjelaskan langkah demi langkah cara membangun pipeline RAG secara efektif, mengeksplorasi keterbatasan RAG, dan cara mengatasinya. Mari mulai!