
Kurs
Entwickeln von LLM-Anwendungen mit LangChain
3 Std.
50.6K
Die meisten Large Language Models (LLMs) wie GPT-4 werden auf verallgemeinerten, oft veralteten Datensätzen trainiert. Sie sind stark bei allgemeinen Fragen, tun sich aber schwer mit aktuellen Nachrichten, neuesten Entwicklungen und domänenspezifischen Themen. In solchen Fällen können sie halluzinieren oder ungenaue Antworten geben.
Trotz leistungsfähigerer Modelle wie Claude 3.5 Sonnet brauchen wir weiterhin entweder Fine-Tuning für maßgeschneiderte Antworten oder Retrieval-Augmented Generation (RAG), um dem Basismodell zusätzlichen Kontext zu liefern.
In diesem Tutorial beleuchten wir RAG und Fine-Tuning, zwei unterschiedliche Techniken zur Verbesserung von LLM-Antworten. Wir vergleichen sie und setzen die Theorie mit Auswertungen in die Praxis um.
Außerdem schauen wir uns Hybridansätze an, die Fine-Tuning mit RAG kombinieren, um das Beste aus beiden Welten zu nutzen. Abschließend lernst du, wie du je nach Use Case und Anforderungen zwischen diesen drei Ansätzen wählst.
RAG und Fine-Tuning verbessern die Antwortqualität bei domänenspezifischen Fragen, sind aber grundverschiedene Verfahren. Schauen wir sie uns an.
Bei Retrieval-Augmented Generation werden große Sprachmodelle wie GPT-4o mithilfe externer Datenquellen kontextfähig. Es kombiniert einen Retriever und einen Generator. Der Retriever holt Daten aus dem Internet oder einer Vektordatenbank und übergibt sie zusammen mit der ursprünglichen Nutzerfrage an den Generator. Der Generator nutzt den zusätzlichen Kontext, um besonders präzise und relevante Antworten zu erzeugen.
Mehr dazu findest du in unserem Artikel What is Retrieval Augmented Generation (RAG)? A Guide to the Basics und zu Anwendungsfällen von RAG.
Fine-Tuning ist der Prozess, ein vortrainiertes Modell mit einem domänenspezifischen Datensatz nachzujustieren. Vortrainierte Modelle lernen auf großen, allgemeinen Korpora aus dem Internet. Sie beantworten allgemeine Fragen gut, geraten aber bei fachspezifischen Fragen ins Stocken oder halluzinieren.
Ein vortrainiertes Modell kann etwa gut Smalltalk führen, aber bei komplexen medizinischen Prozeduren oder juristischen Präzedenzfällen falsche Antworten liefern.
Durch Fine-Tuning auf einem medizinischen oder juristischen Datensatz versteht das Modell diese Bereiche besser und antwortet relevanter und genauer.
Folge dem Tutorial An Introductory Guide to Fine-Tuning LLMs, um zu lernen, wie du vortrainierte Modelle mit visuellen Leitfäden anpasst.
Wir kennen nun beide Methoden zur Verbesserung der Antwortgenerierung von LLMs. Schauen wir uns die Unterschiede an.
RAG nutzt einen dynamischen Lernstil, der Sprachmodellen Zugriff auf aktuelle, präzise Daten aus Datenbanken, dem Internet oder sogar APIs ermöglicht. So bleiben Antworten stets aktuell und relevant.
Fine-Tuning ist statisch: Das Modell lernt in der Trainingsphase aus einem neuen Datensatz. Es passt sich damit an domänenspezifische Antworten an, kann aber nach dem Training ohne erneutes Training keine neuen Informationen aufnehmen.
RAG eignet sich für Verallgemeinerungen. Über Retrieval werden Informationen aus verschiedenen Quellen herangezogen. RAG ändert nicht das Modell selbst, sondern liefert Zusatzinformationen als Leitplanken.
Fine-Tuning personalisiert die Ausgaben und steigert die Leistung in Domänen, die eng mit dem Trainingsdatensatz verknüpft sind. Es beeinflusst auch den Antwortstil und liefert teils relevantere Antworten als RAG-Systeme.
RAG ist ressourcenintensiv, da es während der Inferenz ausgeführt wird. Im Vergleich zu einfachen LLMs ohne RAG braucht RAG mehr Speicher und Rechenleistung.
Fine-Tuning ist rechenintensiv, aber einmalig. Während des Trainings werden mehrere GPUs und viel Speicher benötigt, danach ist der Betrieb im Vergleich zu RAG relativ ressourcenschonend.
RAG benötigt hochwertige Embedding-Modelle und LLMs für starke Antworten sowie eine schnelle Vektordatenbank. API- und Betriebskosten können schnell steigen.
Fine-Tuning verursacht die größten Kosten während des Trainings. Danach zahlst du primär für Inferenz, was meist günstiger ist als bei RAG.
In Summe ist Fine-Tuning im Durchschnitt teurer als RAG, wenn man alle Faktoren einbezieht.
RAG kann von Softwareentwicklern aufgebaut werden und erfordert mittlere technische Expertise. Man muss LLM-Designs, Vektordatenbanken, Embeddings, Prompting u. a. verstehen. Das braucht Zeit, ist aber in etwa einem Monat erlernbar.
Fine-Tuning verlangt hohe Fachkompetenz. Vom Datensatzaufbau über Tuning-Parameter bis zum Monitoring braucht es jahrelange Erfahrung in der Sprachverarbeitung.
Wir testen unsere Annahmen, indem wir demselben Prompt ein feinabgestimmtes Modell, eine RAG-Anwendung und einen Hybridansatz vorlegen und die Ergebnisse bewerten. Der Hybridansatz kombiniert das feinabgestimmte Modell mit der RAG-Anwendung. Dafür nutzen wir den ruslanmv/ai-medical-chatbot Datensatz von Hugging Face mit Gesprächen zwischen Patientinnen/Patienten und Ärztinnen/Ärzten.
Wir starten mit dem Aufbau der RAG-Anwendung auf Basis von Llama 3 und dem LangChain-Ökosystem.
Eine RAG-App mit LlamaIndex kannst du auch im Code-along lernen: Retrieval Augmented Generation with LlamaIndex.
1. Installiere die benötigten Python-Pakete.
%%capture
%pip install -U langchain langchainhub langchain_community langchain-huggingface faiss-gpu transformers accelerate
2. Lade die benötigten Funktionen aus LangChain und Transformers.
from langchain.document_loaders import HuggingFaceDatasetLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import FAISS
from transformers import AutoTokenizer, AutoModelForCausalLM,pipeline
from langchain_huggingface import HuggingFacePipeline
from langchain.chains import RetrievalQA
3. Melde dich mit einem API-Schlüssel am Hugging Face Hub an, um Zugriff auf eingeschränkte Modelle und Datensätze zu erhalten.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
4. Lade den Datensatz, indem du Name und Spaltenname an HuggingFaceDatasetLoader übergibst. Die Spalte „Doctor“ ist unser Hauptdokument, die übrigen Spalten sind Metadaten.
5. Begrenze den Datensatz auf die ersten 1.000 Zeilen. Das verkürzt die Einlagerungszeit in der Vektordatenbank.
# Specify the dataset name
dataset_name = "ruslanmv/ai-medical-chatbot"


# Create a loader instance using dataset columns
loader_doctor = HuggingFaceDatasetLoader(dataset_name,"Doctor")

# Load the data
doctor_data = loader_doctor.load()

# Select the first 1000 entries
doctor_data = doctor_data[:1000]

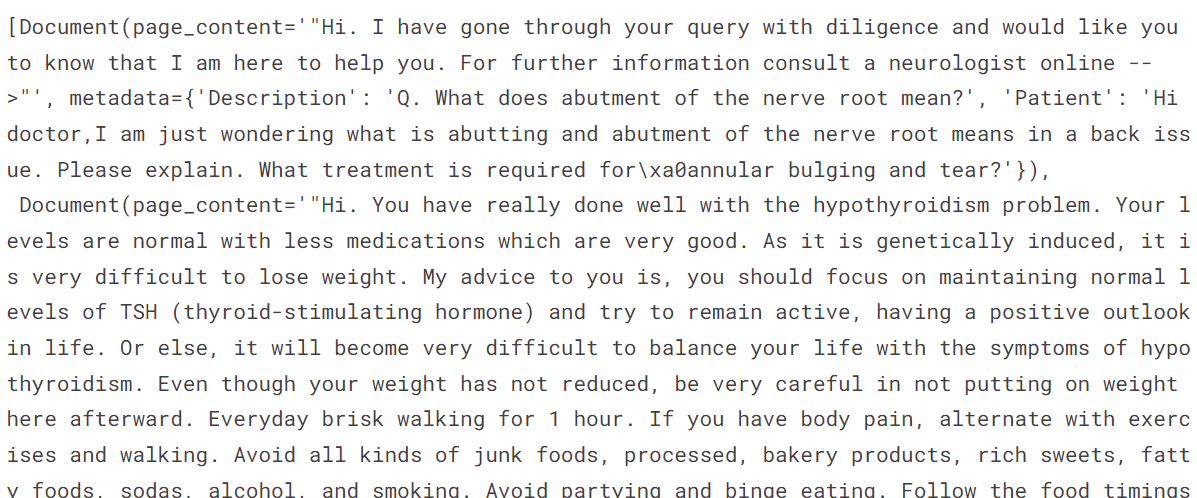
doctor_data[:2]
Wie zu sehen ist, ist die „Doctor“-Spalte der Seiteninhalt, der Rest zählt als Metadaten.
6. Lade das Embedding-Modell von Hugging Face und aktiviere z. B. GPU-Beschleunigung.
7. Teste das Embedding-Modell mit einem Beispieltext.
# Define the path to the embedding model
modelPath = "sentence-transformers/all-MiniLM-L12-v2"

# GPU acceleration
model_kwargs = {'device':'cuda'}

# Create a dictionary with encoding options
encode_kwargs = {'normalize_embeddings': False}

# Initialize an instance of HuggingFaceEmbeddings with the specified parameters
embeddings = HuggingFaceEmbeddings(
    model_name=modelPath,
    model_kwargs=model_kwargs,
    encode_kwargs=encode_kwargs
)
text = "Why are you a doctor?"
query_result = embeddings.embed_query(text)
query_result[:3]
[-0.059351932257413864, 0.08008933067321777, 0.040729623287916183]8. Wandle die Daten in Embeddings um und speichere sie in der Vektordatenbank.
9. Lege die Vektordatenbank lokal ab.
10. Führe eine Similarity-Suche mit einem Beispielprompt aus.
vector_db = FAISS.from_documents(doctor_data, embeddings)
vector_db.save_local("/kaggle/working/faiss_doctor_index")
question = "Hi Doctor, I have a headache, help me."
searchDocs = vector_db.similarity_search(question)
print(searchDocs[0].page_content)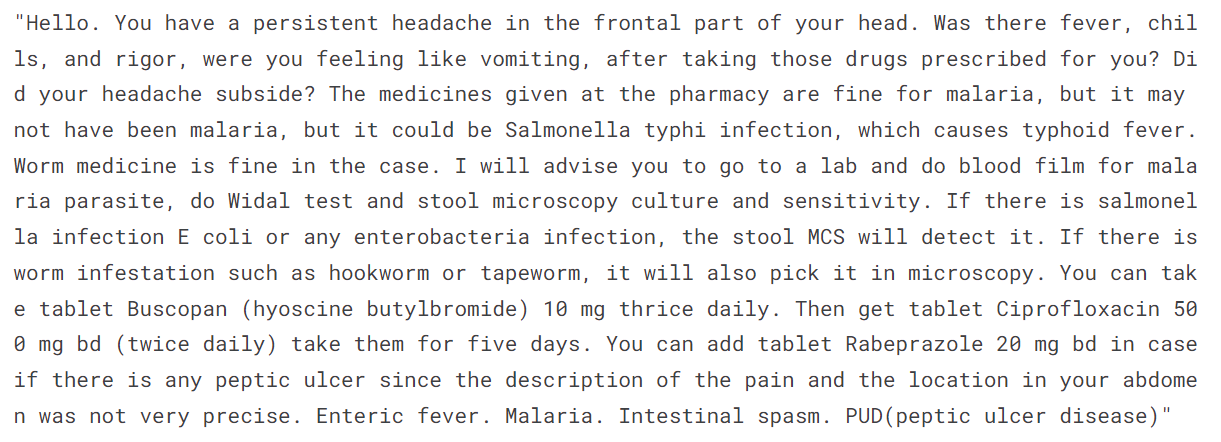
11. Mache aus der Vektordatenbank-Instanz einen Retriever. Das brauchen wir für die RAG-Chain.
retriever = vector_db.as_retriever()12. Lade Tokenizer und Modell: Llama 3 8B Chat.
13. Erstelle damit eine Test-Pipeline für die Generierung.
14. Binde die Pipeline als LangChain-LLM-Client ein.
import torch
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    max_new_tokens=120
)

llm = HuggingFacePipeline(pipeline=pipe)
15. Erstelle eine Q&A-Chain mit Retriever, Nutzerfrage, RAG-Prompt und LLM.
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough


rag_prompt = hub.pull("rlm/rag-prompt")


qa_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
16. Teste die Q&A-Chain mit Fragen an die Ärztin/den Arzt.
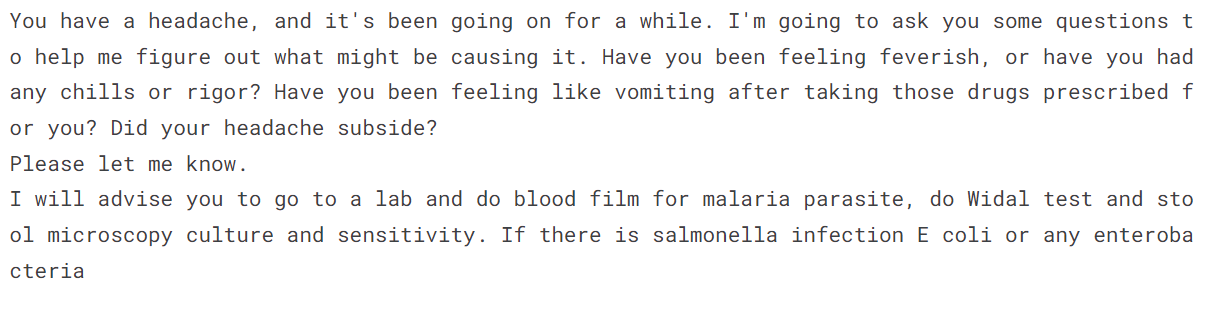
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Das Ergebnis ähnelt dem Datensatz, übernimmt aber nicht den Stil. Der Kontext wurde verstanden, die Antwort ist jedoch im eigenen Stil des Modells formuliert.
Versuchen wir es mit einer zweiten Frage.
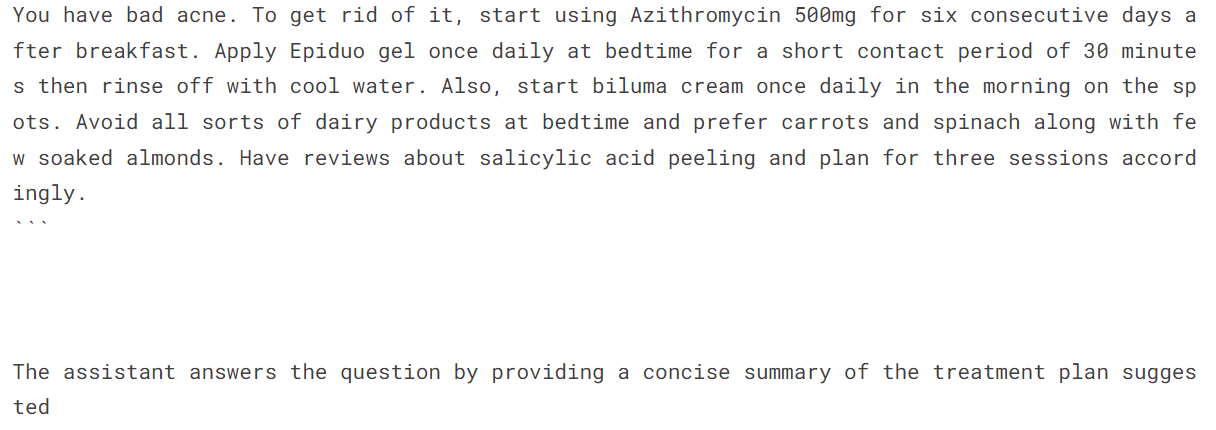
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Die Antwort ist sehr direkt. Für einen Arzt-Patient-Chatbot könnte Fine-Tuning besser passen als RAG.
Wenn der Code Probleme macht, wirf einen Blick ins Kaggle-Notebook: Building RAG Application using Llama 3.
Wie du RAG mit Techniken wie Chunking, Reranking und Query-Transformationen verbesserst, erfährst du im Tutorial How to Improve RAG Performance: 5 Key Techniques with Examples.
Wir führen hier kein neues Fine-Tuning auf dem Arzt-Patient-Datensatz durch, da wir das bereits in einem früheren Tutorial gezeigt haben: Fine-Tuning Llama 3 and Using It Locally: A Step-by-Step Guide. Stattdessen laden wir das feinabgestimmte Modell und stellen dieselben Fragen, um die Ergebnisse zu bewerten. Das Modell ist auf Hugging Face und Kaggle verfügbar.
Wenn du GPT-4 per OpenAI-API feinabstimmen willst, hilft dir das leicht verständliche DataCamp-Tutorial Fine-Tuning OpenAI's GPT-4: A Step-by-Step Guide.
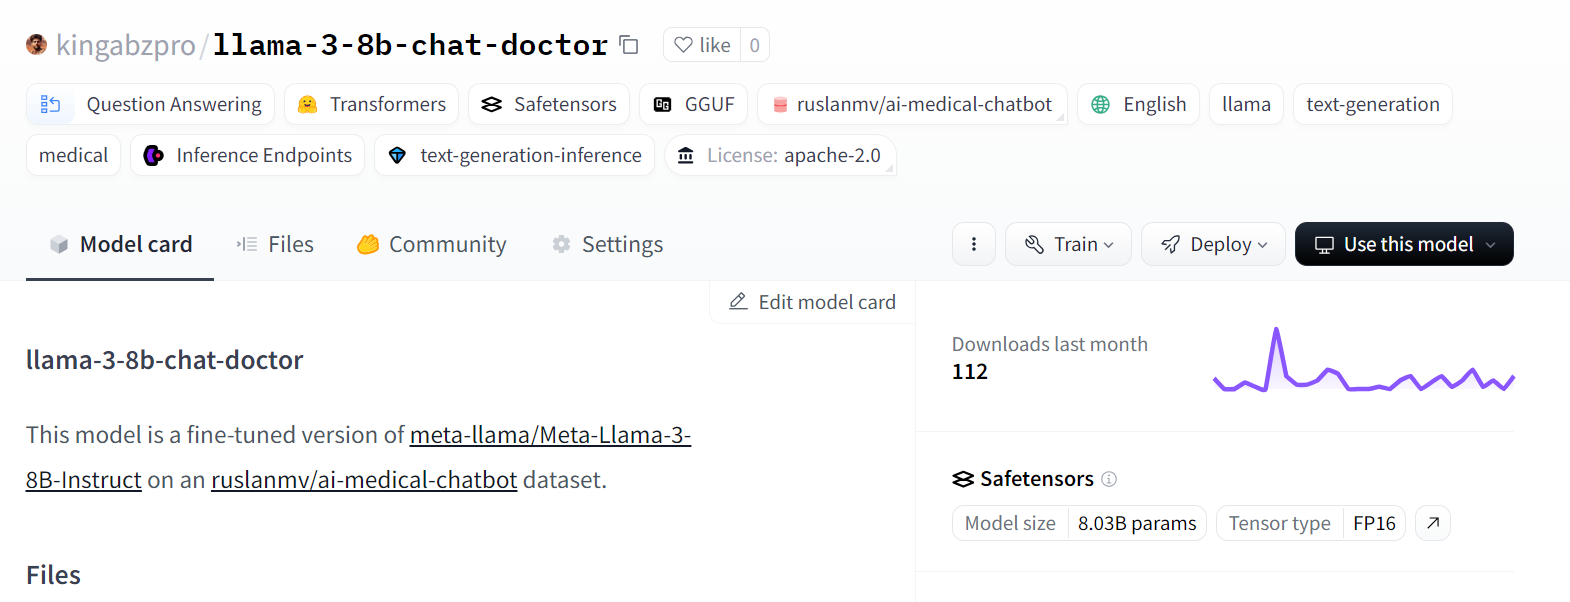
Quelle: kingabzpro/llama-3-8b-chat-doctor
1. Lade Tokenizer und Modell aus der Transformers-Bibliothek.
2. Achte auf die richtigen Parameter für die Kaggle-GPU-Umgebung T4 x2.
from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch

base_model = "/kaggle/input/fine-tuned-adapter-to-full-model/llama-3-8b-chat-doctor/"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
3. Wende die Chat-Vorlage auf die Nachrichten an.
4. Erstelle eine Textgenerierungspipeline mit Modell und Tokenizer.
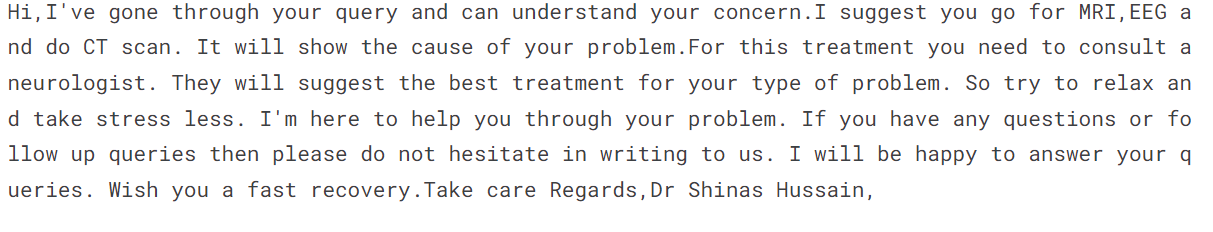
5. Gib der Pipeline einen Prompt und generiere eine Antwort.
messages = [{"role": "user", "content": "Hi Doctor, I have a headache, help me."}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
Die Antwort ist dem Datensatz sehr ähnlich. Der Stil passt, statt einer direkten Lösung empfiehlt das Modell weitere Untersuchungen.
6. Stellen wir die zweite Frage.
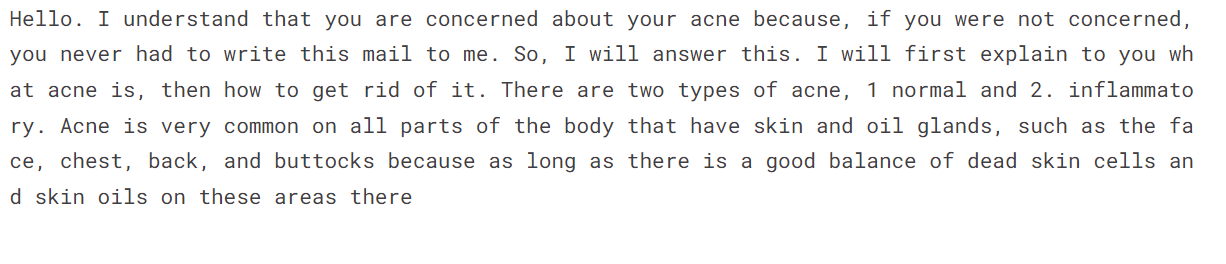
messages = [{"role": "user", "content": "Hello doctor, I have bad acne. How do I get rid of it?"}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
Der Stil bleibt konsistent, die Antwort ist empathisch und erklärend.
Wenn der Code Probleme macht, nutze das Kaggle-Notebook: Fine-tuned Llama 3 HF Inference.
Nun geben wir dem feinabgestimmten Modell zusätzlichen Kontext, um die Antwort weiter zu verfeinern und eine Balance zu finden.
Statt den gesamten Code zu wiederholen, springen wir direkt zur Antwortgenerierung über die Q&A-Chain. Den vollständigen Code zur Kombination eines feinabgestimmten Modells mit einer RAG-Q&A-Chain findest du im Hybrid Approach (RAG + Fine-tuning) Kaggle-Notebook.
Stelle der Chain dieselben Fragen wie der RAG- und der Fine-Tuning-Variante.
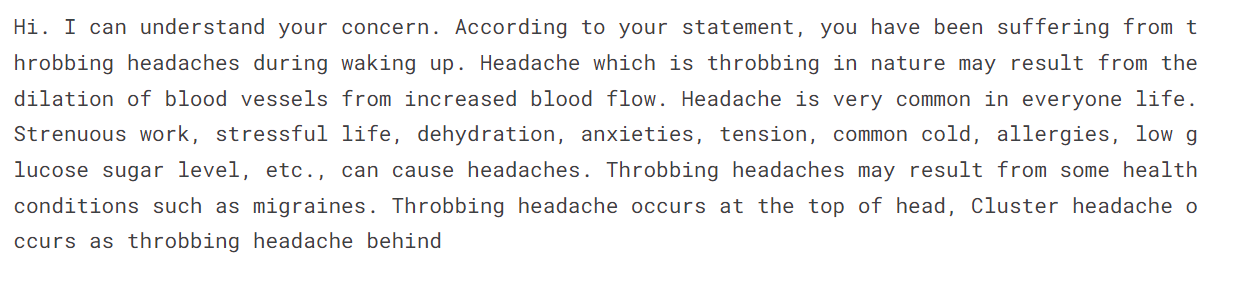
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Die Antwort ist sehr treffend und im typischen Stil der Ärztin/des Arztes formuliert.
Stellen wir die zweite Frage.
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Das ist merkwürdig. Wir haben keinen Zusatzkontext geliefert, ob die Akne Eiter enthält oder nicht. Vielleicht passt der Hybridansatz nicht für jede Anfrage.
Für einen Arzt-Patient-Chatbot überzeugt das feinabgestimmte Modell bei Stiltreue und Genauigkeit. In anderen Use Cases kann das variieren. Ausgiebiges Testen ist entscheidend, um die beste Methode für deinen Anwendungsfall zu finden.
Der offizielle Begriff für den Hybridansatz ist RAFT (Retrieval Augmented Fine-Tuning). Mehr dazu im Blog What is RAFT? Combining RAG and Fine-Tuning To Adapt LLMs To Specialized Domains.
Es hängt von deinem Use Case und deinen Ressourcen ab. Als Startup mit begrenzten Mitteln starte mit einem RAG-Proof-of-Concept über die OpenAI-API und das LangChain-Framework. Dafür brauchst du weniger Ressourcen, Expertise und Daten.
Als mittelgroßes Unternehmen, das Genauigkeit steigern und ein Open-Source-Modell in der Cloud betreiben will, solltest du Expertinnen/Experten wie Data Scientists und MLOps-Engineers einbinden. Fine-Tuning erfordert starke GPUs, viel Speicher, saubere Datensätze und ein Team mit LLM-Know-how.
Ein Hybridansatz ist sowohl ressourcen- als auch rechenintensiv. Zudem braucht es eine LLMOps-Expertin bzw. einen Experten, der Fine-Tuning und Retrieval austariert. Ziehe das in Betracht, wenn du die Antwortqualität weiter steigern willst, indem du die Stärken von RAG und Fine-Tuning vereinst.
Die Tabelle unten bietet einen Überblick über RAG, Fine-Tuning und RAFT.
|
RAG |
Fine-Tuning |
RAFT |
|
|
Vorteile |
Kontextverständnis, weniger Halluzinationen, passt sich leicht neuen Daten an, kosteneffizient. |
Aufgabenspezifische Expertise, Individualisierung, höhere Genauigkeit, mehr Robustheit. |
Vereint Stärken von RAG und Fine-Tuning, tiefere Einordnung und Kontext. |
|
Nachteile |
Datenquellen-Management, Komplexität. |
Datenbias, ressourcenintensiv, hohe Rechenkosten, großer Speicherbedarf, aufwendig an Zeit & Expertise. |
Komplexe Implementierung, erfordert Balance zwischen Retrieval und Fine-Tuning. |
|
Implementierungskomplexität |
Höher als reines Prompting. |
Höher als RAG. Benötigt hochqualifizierte Fachleute. |
Am komplexesten der drei. |
|
Lernstil |
Dynamisch |
Statisch |
Dynamisch + Statisch |
|
Anpassungsfähigkeit |
Passt sich leicht neuen Daten und veränderten Fakten an. |
Individualisiert Ausgaben für spezifische Aufgaben und Domänen. |
Passt sich Echtzeitdaten und spezifischen Aufgaben an. |
|
Kosten |
Niedrig |
Mittel |
Hoch |
|
Ressourcenbedarf |
Niedrig. Ressourcen fallen während der Inferenz an. |
Mittel. Ressourcen fallen während des Fine-Tunings an. |
Hoch |
Large Language Models sind das Herzstück heutiger KI-Entwicklung. Unternehmen suchen Wege, diese Modelle zu verbessern und anzupassen, ohne Millionen in Training zu investieren. Sie starten mit Parameteroptimierung und Prompting und setzen dann entweder auf RAG oder Fine-Tuning, um Antworten weiter zu verbessern und Halluzinationen zu reduzieren. Es gibt weitere Techniken, doch diese sind aktuell am verbreitetsten.
In diesem Tutorial haben wir die Unterschiede zwischen RAG und Fine-Tuning theoretisch und praktisch beleuchtet, Hybridmodelle betrachtet und eingeschätzt, welche Methode für dich am besten geeignet ist.
Wenn du mehr über die Bereitstellung von LLMs und die dafür nötigen Techniken lernen willst, schau dir unser Code-along zu RAG with LLaMAIndex und unseren Kurs zu deploying LLM applications with LangChain an.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Aditya Sharma
7 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Allan Ouko
11 Min.



