
Cours
Développement d'applications LLM avec LangChain
3 h
50.6K
La plupart des grands modèles de langage (LLM) comme GPT-4 sont entraînés sur des jeux de données généraux, souvent obsolètes. S'ils excellent pour répondre à des questions courantes, ils peinent avec les requêtes sur l’actualité, les dernières avancées ou des sujets très spécialisés. Dans ces cas, ils peuvent halluciner ou fournir des réponses inexactes.
Même avec l’émergence de modèles plus performants comme Claude 3.5 Sonnet, il reste nécessaire soit d’affiner un modèle (fine-tuning) pour générer des réponses adaptées, soit d’utiliser des systèmes de Retrieval-Augmented Generation (RAG) pour apporter un contexte supplémentaire au modèle de base.
Dans ce tutoriel, nous allons explorer le RAG et le fine-tuning, deux approches distinctes pour améliorer les réponses des LLM. Nous verrons leurs différences et passerons de la théorie à la pratique en évaluant les résultats.
Nous aborderons également des techniques hybrides combinant modèles affinés et systèmes RAG pour tirer parti du meilleur des deux mondes. Enfin, nous apprendrons à choisir entre ces trois approches selon les cas d’usage et les exigences.
RAG et le fine-tuning améliorent la génération de réponses pour des requêtes de domaine, mais ce sont intrinsèquement des techniques très différentes. Voyons-les de plus près.
La Retrieval-Augmented Generation est un processus par lequel des LLM comme GPT-4o deviennent « sensibles au contexte » grâce à des sources de données externes. Il s’agit d’une combinaison d’un récupérateur (retriever) et d’un générateur. Le récupérateur extrait des informations depuis Internet ou une base vectorielle et les transmet au générateur avec la requête initiale de l’utilisateur. Le générateur s’appuie sur ce contexte supplémentaire pour produire une réponse très précise et pertinente.
Pour en savoir plus, lisez notre article What is Retrieval Augmented Generation (RAG)? A Guide to the Basics pour comprendre le fonctionnement d’une application RAG et ses principaux cas d’usage.
Le fine-tuning consiste à réentraîner un modèle pré-entraîné sur un jeu de données spécifique à un domaine. Le modèle pré-entraîné a été formé sur de vastes corpus généraux récupérés sur Internet. Il répond bien aux questions générales, mais aura des difficultés, voire des hallucinations, face à des questions spécialisées.
Par exemple, un modèle pré-entraîné peut bien converser, mais produire des réponses erronées s’il est interrogé sur des actes médicaux complexes ou des jurisprudences.
L’affiner sur un jeu de données médical ou juridique permet au modèle de comprendre et de répondre dans ces domaines avec plus de précision et de pertinence.
Suivez le tutoriel An Introductory Guide to Fine-Tuning LLMs pour apprendre à personnaliser un modèle pré-entraîné avec des guides visuels.
Nous avons vu chaque méthode pour améliorer la génération de réponses des LLM. Examinons maintenant leurs différences pour mieux les comprendre.
RAG s’appuie sur un apprentissage dynamique, qui permet aux modèles d’accéder aux données les plus récentes et fiables depuis des bases, Internet ou des API. Cette approche garantit des réponses toujours à jour et pertinentes.
Le fine-tuning relève d’un apprentissage statique : le modèle apprend à partir d’un nouveau jeu de données pendant l’entraînement. Il s’adapte ainsi à un domaine, mais ne peut intégrer de nouvelles informations après coup sans réentraînement.
RAG convient mieux aux généralisations. Il récupère des informations depuis plusieurs sources de données. RAG ne modifie pas le modèle lui-même ; il lui fournit simplement un contexte supplémentaire pour guider la réponse.
Le fine-tuning personnalise la sortie et améliore les performances du modèle sur un domaine proche du jeu d’entraînement. Il influence aussi le style de réponse et fournit parfois des réponses plus pertinentes que des systèmes RAG.
RAG consomme des ressources pendant l’inférence. Par rapport à un LLM « simple », il demande plus de mémoire et de calcul.
Le fine-tuning est coûteux en calcul, mais effectué une seule fois. Il nécessite plusieurs GPU et beaucoup de mémoire pendant l’entraînement ; ensuite, il est plutôt économe en ressources comparé aux systèmes RAG.
RAG requiert des modèles d’embedding et des LLM de tout premier plan pour de meilleures réponses, ainsi qu’une base vectorielle rapide. Les coûts d’API et d’exploitation peuvent grimper vite.
Le fine-tuning vous coûtera cher essentiellement pendant l’entraînement ; ensuite, l’inférence du modèle revient nettement moins cher qu’un RAG.
Globalement, en moyenne, le fine-tuning revient plus cher que RAG si l’on considère l’ensemble des facteurs.
Les systèmes RAG peuvent être conçus par des ingénieurs logiciels et exigent un niveau d’expertise technique intermédiaire. Il faut comprendre la conception des LLM, les bases vectorielles, les embeddings, l’ingénierie de prompts, etc. C’est formateur et accessible en quelques semaines.
Le fine-tuning d’un modèle exige une forte expertise. De la préparation des données au réglage des hyperparamètres en passant par le suivi des performances, des années d’expérience en traitement du langage naturel sont un atout.
Testons notre hypothèse en soumettant le même prompt à un modèle affiné, à une application RAG et à une approche hybride, puis en évaluant les résultats. L’approche hybride combinera le modèle affiné avec l’application RAG. Pour l’exemple, nous utiliserons le jeu de données ruslanmv/ai-medical-chatbot de Hugging Face, qui contient des conversations entre patients et médecins sur diverses pathologies.
Nous allons commencer par construire l’application RAG en utilisant Llama 3 et l’écosystème LangChain.
Vous pouvez aussi apprendre à créer une application RAG avec LlamaIndex en suivant le code-along Retrieval Augmented Generation with LlamaIndex.
1. Installez tous les packages Python nécessaires.
%%capture
%pip install -U langchain langchainhub langchain_community langchain-huggingface faiss-gpu transformers accelerate
2. Chargez les fonctions nécessaires depuis les bibliothèques LangChain et Transformers.
from langchain.document_loaders import HuggingFaceDatasetLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import FAISS
from transformers import AutoTokenizer, AutoModelForCausalLM,pipeline
from langchain_huggingface import HuggingFacePipeline
from langchain.chains import RetrievalQA
3. Pour accéder aux modèles et jeux de données restreints, nous vous recommandons de vous connecter au hub Hugging Face avec votre clé d’API.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
4. Chargez le jeu de données en fournissant son nom et le nom de la colonne à HuggingFaceDatasetLoader. La colonne « Doctor » sera notre document principal, le reste constituera les métadonnées.
5. Limitons le jeu de données aux 1 000 premières lignes pour accélérer l’indexation dans la base vectorielle.
# Specify the dataset name
dataset_name = "ruslanmv/ai-medical-chatbot"


# Create a loader instance using dataset columns
loader_doctor = HuggingFaceDatasetLoader(dataset_name,"Doctor")

# Load the data
doctor_data = loader_doctor.load()

# Select the first 1000 entries
doctor_data = doctor_data[:1000]

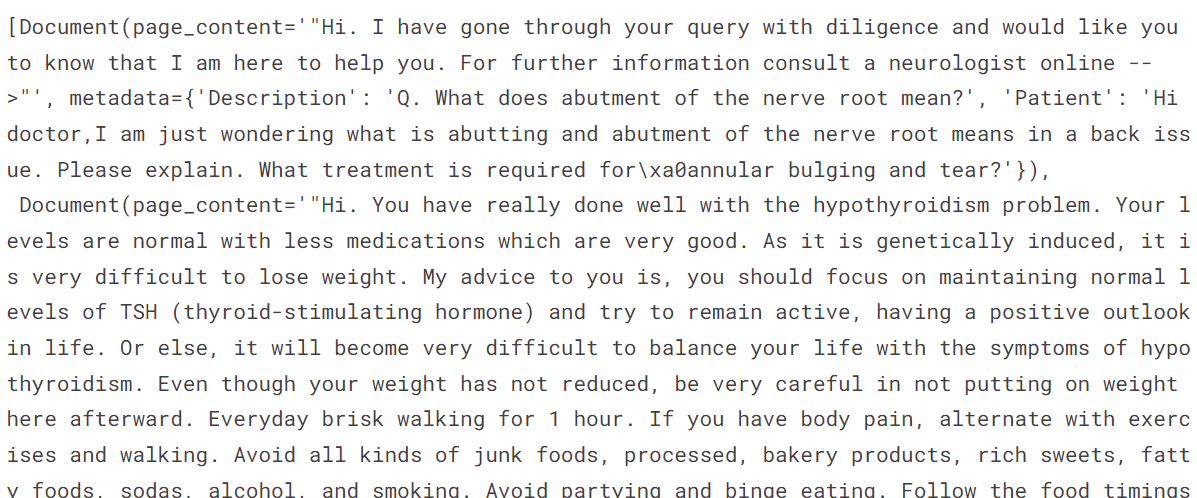
doctor_data[:2]
Comme vous pouvez le voir, la colonne « Doctor » contient le texte de la page et le reste forme les métadonnées.
6. Chargez le modèle d’embedding depuis Hugging Face avec des paramètres dédiés (accélération GPU, etc.).
7. Testez le modèle d’embedding avec un texte d’exemple.
# Define the path to the embedding model
modelPath = "sentence-transformers/all-MiniLM-L12-v2"

# GPU acceleration
model_kwargs = {'device':'cuda'}

# Create a dictionary with encoding options
encode_kwargs = {'normalize_embeddings': False}

# Initialize an instance of HuggingFaceEmbeddings with the specified parameters
embeddings = HuggingFaceEmbeddings(
    model_name=modelPath,
    model_kwargs=model_kwargs,
    encode_kwargs=encode_kwargs
)
text = "Why are you a doctor?"
query_result = embeddings.embed_query(text)
query_result[:3]
[-0.059351932257413864, 0.08008933067321777, 0.040729623287916183]8. Convertissez les données en embeddings et enregistrez-les dans la base vectorielle.
9. Sauvegardez la base vectorielle en local.
10. Effectuez une recherche de similarité avec un prompt d’exemple.
vector_db = FAISS.from_documents(doctor_data, embeddings)
vector_db.save_local("/kaggle/working/faiss_doctor_index")
question = "Hi Doctor, I have a headache, help me."
searchDocs = vector_db.similarity_search(question)
print(searchDocs[0].page_content)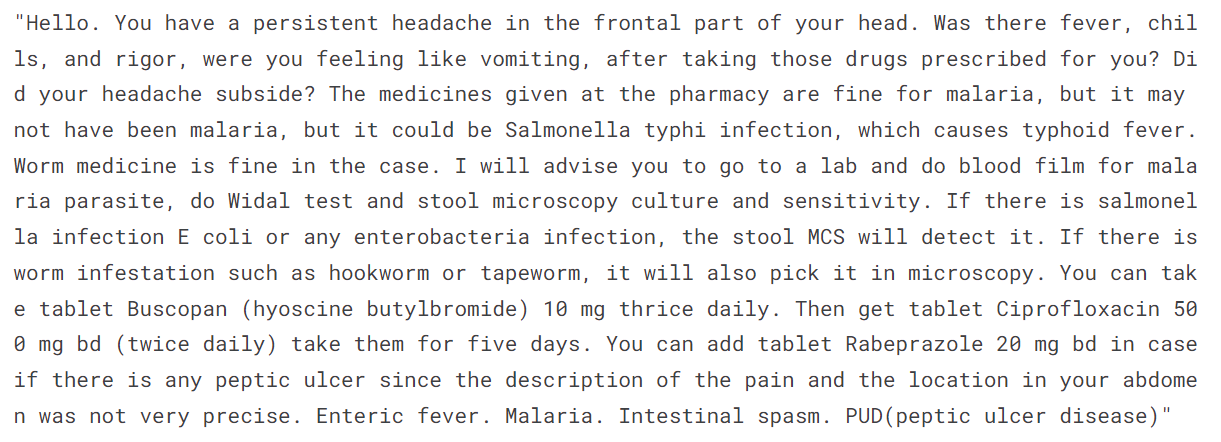
11. Convertissez l’instance de base vectorielle en retriever pour créer la chaîne RAG.
retriever = vector_db.as_retriever()12. Chargez le tokenizer et le modèle Llama 3 8B Chat.
13. Utilisez-les pour créer un pipeline de génération de test.
14. Convertissez le pipeline en client LLM LangChain.
import torch
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    max_new_tokens=120
)

llm = HuggingFacePipeline(pipeline=pipe)
15. Créez une chaîne questions-réponses en combinant le retriever, la requête, le prompt RAG et le LLM.
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough


rag_prompt = hub.pull("rlm/rag-prompt")


qa_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
16. Testez la chaîne Q&R en posant des questions au médecin.
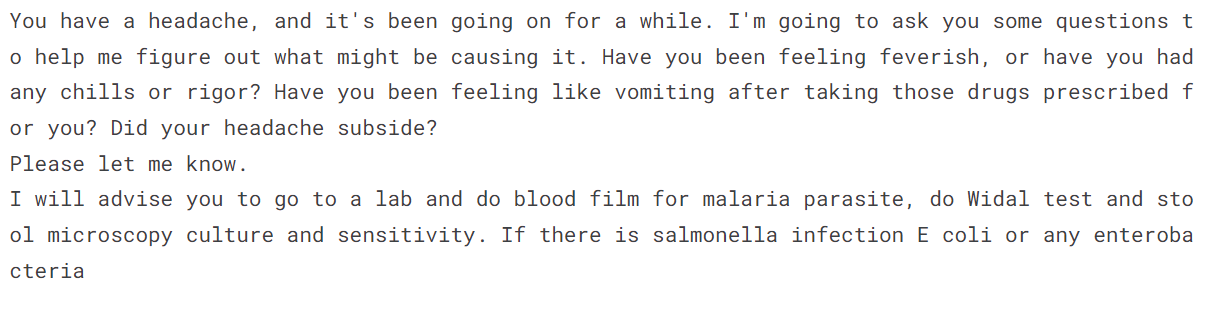
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
La réponse est proche du jeu de données, mais le modèle n’en reprend pas le style. Il comprend le contexte et rédige dans son propre ton.
Essayons avec une autre question.
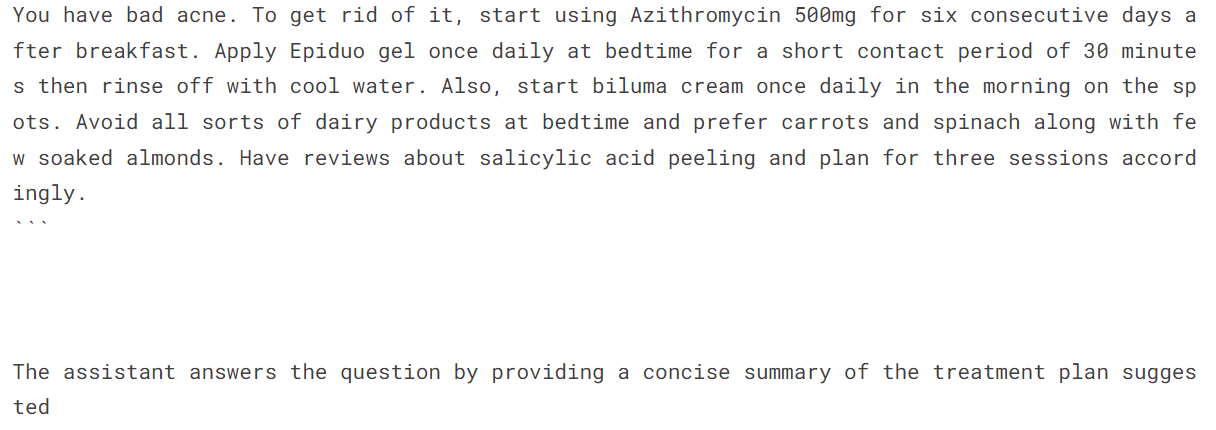
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
La réponse est très directe. Peut-être qu’un fine-tuning serait plus adapté qu’une approche RAG pour un chatbot médecin-patient.
Si vous avez des difficultés à exécuter le code, consultez le notebook Kaggle : Building RAG Application using Llama 3.
Apprenez à améliorer les performances d’un système RAG avec des techniques comme le découpage (chunking), le reranking et les transformations de requêtes en suivant le tutoriel How to Improve RAG Performance: 5 Key Techniques with Examples.
Nous n’allons pas réentraîner le modèle sur le jeu médecin-patient, car cela a déjà été fait dans un tutoriel précédent : Fine-Tuning Llama 3 and Using It Locally: A Step-by-Step Guide. Nous allons charger le modèle affiné et lui poser les mêmes questions pour comparer les résultats. Le modèle affiné est disponible sur Hugging Face et Kaggle.
Si vous souhaitez affiner GPT-4 avec l’API OpenAI, consultez le tutoriel DataCamp pas à pas Fine-Tuning OpenAI's GPT-4: A Step-by-Step Guide.
Source : kingabzpro/llama-3-8b-chat-doctor
1. Chargez le tokenizer et le modèle via la bibliothèque Transformers.
2. Assurez-vous d’utiliser les bons paramètres dans l’environnement Kaggle GPU T4 x2.
from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch

base_model = "/kaggle/input/fine-tuned-adapter-to-full-model/llama-3-8b-chat-doctor/"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
3. Appliquez le modèle de chat (chat template) aux messages.
4. Créez un pipeline de génération de texte avec le modèle et le tokenizer.
5. Fournissez un prompt au pipeline et générez la réponse.
messages = [{"role": "user", "content": "Hi Doctor, I have a headache, help me."}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
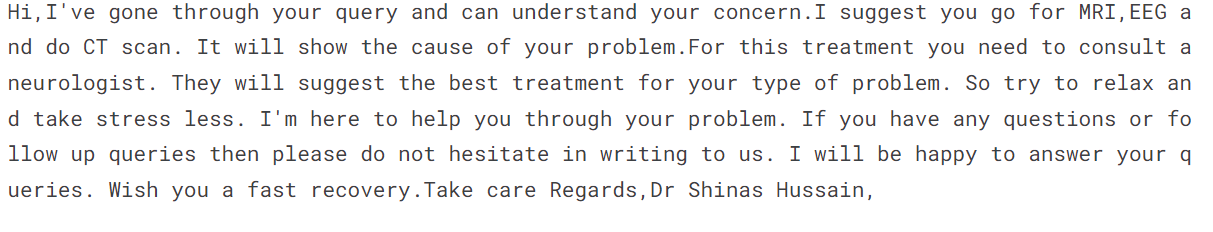
La réponse est très proche du jeu de données. Le style est similaire, mais au lieu d’une réponse tranchée, le modèle suggère des examens complémentaires.
6. Posons la seconde question.
messages = [{"role": "user", "content": "Hello doctor, I have bad acne. How do I get rid of it?"}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
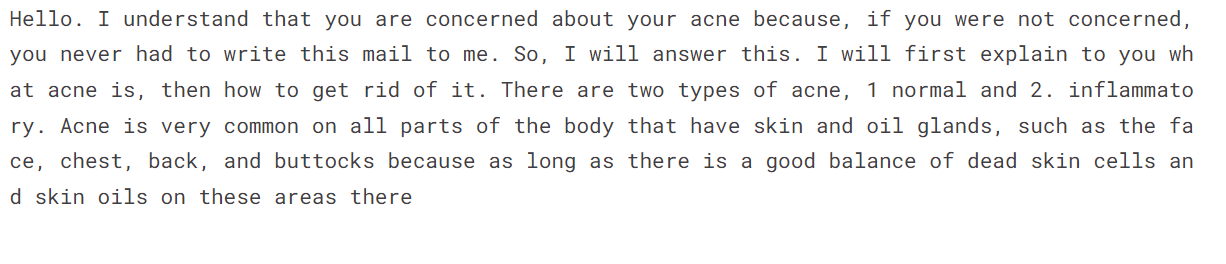
Le style est cohérent, la réponse fait preuve d’empathie et d’explications.
Si vous avez des difficultés à exécuter le code, consultez le notebook Kaggle : Fine-tuned Llama 3 HF Inference.
Nous allons maintenant fournir au modèle affiné un contexte supplémentaire pour ajuster encore la réponse et trouver le bon équilibre.
Au lieu de réécrire tout le code, passons directement à la génération de réponses avec la chaîne Q&R. Pour voir l’intégralité du code combinant un modèle affiné et une chaîne Q&R RAG, consultez le notebook Kaggle Hybrid Approach (RAG + Fine-tuning).
Soumettez à la chaîne les mêmes questions qu’au RAG et au modèle affiné.
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
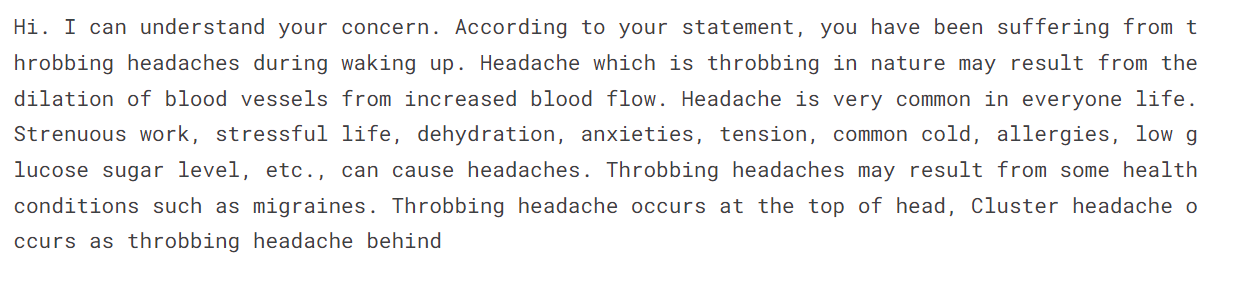
La réponse est très précise et le ton correspond à celui d’un médecin.
Passons à la seconde question.
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Étrange. Nous n’avons jamais fourni de contexte supplémentaire indiquant si l’acné est purulente ou non. Peut-être que le modèle hybride n’est pas optimal pour certaines requêtes.
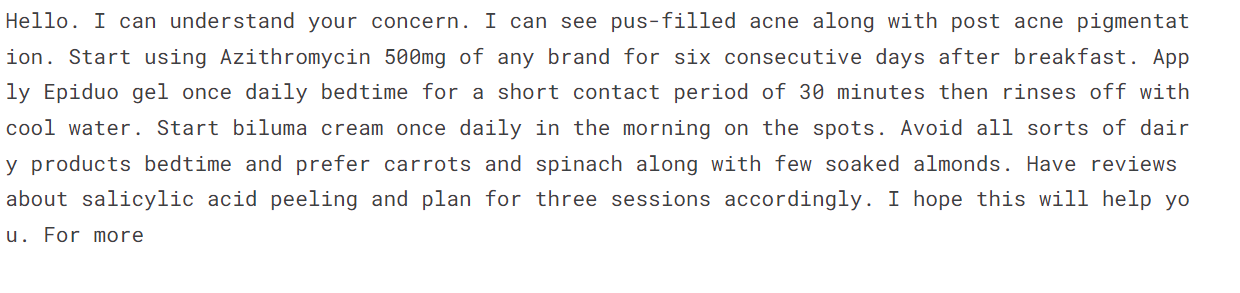
Pour un chatbot médecin-patient, le modèle affiné brille par l’adoption du style et la justesse. Cela peut toutefois varier selon les cas d’usage, d’où l’importance de tests approfondis pour identifier la meilleure approche pour votre besoin.
Le terme officiel pour l’approche hybride est RAFT (Retrieval Augmented Fine-Tuning). Pour en savoir plus, lisez le billet What is RAFT? Combining RAG and Fine-Tuning To Adapt LLMs To Specialized Domains.
Tout dépend de votre cas d’usage et de vos moyens. Si vous êtes une startup avec des ressources limitées, créez un POC RAG avec l’API OpenAI et le framework LangChain. Les besoins en ressources, expertise et données restent modestes.
Si vous êtes une entreprise de taille intermédiaire et souhaitez affiner un modèle open source pour gagner en précision et le déployer dans le cloud, recrutez des experts (data scientists, ingénieurs MLOps). Le fine-tuning requiert des GPU haut de gamme, beaucoup de mémoire, un jeu de données propre et une équipe maîtrisant les LLM.
Une solution hybride est gourmande en ressources et en calcul. Elle suppose aussi un profil LLMOps capable d’orchestrer l’équilibre entre fine-tuning et RAG. Envisagez-la si vous souhaitez aller encore plus loin en combinant les atouts de RAG et d’un modèle affiné.
Reportez-vous au tableau ci-dessous pour une vue d’ensemble des solutions RAG, fine-tuning et RAFT.
|
RAG |
Fine-tuning |
RAFT |
|
|
Avantages |
Compréhension contextuelle, moins d’hallucinations, adaptation facile aux nouvelles données, économique. |
Expertise par tâche, personnalisation, précision accrue, robustesse renforcée. |
Allie les forces de RAG et du fine-tuning, compréhension et contexte plus profonds. |
|
Inconvénients |
Gestion des sources de données, complexité. |
Biais de données, intensif en ressources, coûts de calcul élevés, besoins mémoire importants, demande du temps & de l’expertise. |
Complexité de mise en œuvre, nécessite d’équilibrer récupération et fine-tuning. |
|
Complexité de mise en œuvre |
Plus élevée que l’ingénierie de prompts. |
Plus élevée que RAG. Nécessite des experts très techniques. |
La plus élevée des trois. |
|
Style d’apprentissage |
Dynamique |
Statique |
Dynamique + statique |
|
Adaptabilité |
S’adapte facilement aux nouvelles données et faits évolutifs. |
Personnalise les sorties pour des tâches et domaines précis. |
S’adapte aux données en temps réel et aux tâches spécifiques. |
|
Coût |
Faible |
Modéré |
Élevé |
|
Intensité en ressources |
Faible. Ressources utilisées à l’inférence. |
Modérée. Ressources utilisées pendant le fine-tuning. |
Élevée |
Les grands modèles de langage sont au cœur du développement de l’IA aujourd’hui. Les entreprises cherchent à les améliorer et à les personnaliser sans dépenser des millions en entraînement. Elles commencent par l’optimisation des paramètres et l’ingénierie de prompts, puis choisissent RAG ou le fine-tuning pour obtenir de meilleures réponses et réduire les hallucinations. D’autres techniques existent, mais ce sont les options les plus répandues.
Dans ce tutoriel, nous avons vu les différences entre RAG et le fine-tuning, en théorie comme en pratique. Nous avons aussi étudié les modèles hybrides et comparé les approches pour vous aider à choisir la plus adaptée.
Pour aller plus loin sur le déploiement des LLM et les techniques associées, découvrez notre code-along sur RAG with LLaMAIndex et notre cours sur deploying LLM applications with LangChain.
Les meilleurs cours DataCamp
Cours
Cours
Cours