
Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
52K
Hầu hết các Mô hình Ngôn ngữ Lớn (LLM) như GPT-4 được huấn luyện trên các bộ dữ liệu tổng quát và thường đã lỗi thời. Dù rất giỏi trả lời các câu hỏi chung, chúng gặp khó khăn với tin tức mới, diễn biến gần đây và các chủ đề chuyên ngành. Trong những trường hợp này, mô hình có thể bịa đặt (hallucinate) hoặc đưa ra câu trả lời không chính xác.
Dù đã xuất hiện các mô hình hiệu quả hơn như Claude 3.5 Sonnet, chúng ta vẫn cần hoặc tinh chỉnh (fine-tune) mô hình để tạo phản hồi tùy biến, hoặc dùng hệ thống Retrieval-Augmented Generation (RAG) để cung cấp bối cảnh bổ sung cho mô hình gốc.
Trong hướng dẫn này, chúng ta sẽ khám phá RAG và fine-tuning, hai kỹ thuật khác nhau nhằm cải thiện phản hồi của LLM. Ta sẽ xem xét sự khác biệt và đưa lý thuyết vào thực hành bằng cách đánh giá kết quả.
Ngoài ra, chúng ta sẽ tìm hiểu các kỹ thuật lai kết hợp mô hình đã fine-tune với hệ thống RAG để tận dụng ưu điểm của cả hai. Cuối cùng, chúng ta sẽ học cách lựa chọn giữa ba cách tiếp cận này dựa trên từng bài toán và yêu cầu cụ thể.
RAG và fine-tuning giúp cải thiện việc tạo phản hồi cho các truy vấn chuyên ngành, nhưng về bản chất là hai kỹ thuật hoàn toàn khác nhau. Hãy cùng tìm hiểu.
Retrieval-Augmented Generation là quy trình giúp các mô hình ngôn ngữ lớn như GPT-4o trở nên nhận biết ngữ cảnh nhờ dữ liệu bên ngoài. Đây là sự kết hợp giữa bộ truy xuất (retriever) và bộ sinh (generator). Bộ truy xuất lấy dữ liệu từ Internet hoặc cơ sở dữ liệu vector và cung cấp cho bộ sinh kèm theo truy vấn gốc của người dùng. Bộ sinh sử dụng bối cảnh bổ sung để tạo ra phản hồi có độ chính xác và mức liên quan cao.
Để tìm hiểu thêm, hãy đọc bài viết Retrieval Augmented Generation (RAG) là gì? Hướng dẫn cơ bản và hiểu cơ chế hoạt động bên trong của ứng dụng RAG cùng các trường hợp sử dụng khác nhau.
Fine-tuning là quá trình điều chỉnh mô hình đã tiền huấn luyện bằng bộ dữ liệu chuyên ngành. Mô hình tiền huấn luyện được học trên nhiều tập dữ liệu tổng quát lớn thu thập từ Internet. Chúng phản hồi tốt với câu hỏi chung, nhưng sẽ gặp khó hoặc thậm chí bịa đặt khi trả lời câu hỏi chuyên ngành.
Ví dụ, một mô hình tiền huấn luyện có thể giỏi trò chuyện chung nhưng có thể đưa ra câu trả lời sai khi được hỏi về các thủ thuật y khoa phức tạp hoặc án lệ pháp lý.
Tinh chỉnh trên bộ dữ liệu y khoa hoặc pháp lý giúp mô hình hiểu và trả lời câu hỏi trong các lĩnh vực đó chính xác, phù hợp hơn.
Hãy theo dõi hướng dẫn Hướng dẫn nhập môn Fine-Tuning LLMs để học cách tùy chỉnh mô hình tiền huấn luyện với minh họa trực quan.
Chúng ta đã tìm hiểu từng phương pháp để cải thiện khả năng tạo phản hồi của LLM. Hãy xem xét các khác biệt để hiểu rõ hơn.
RAG sử dụng phong cách học động, cho phép mô hình truy cập và dùng dữ liệu mới nhất, chính xác nhất từ cơ sở dữ liệu, Internet hoặc thậm chí API. Cách tiếp cận này đảm bảo phản hồi luôn cập nhật và phù hợp.
Fine-tuning mang tính học tĩnh, nơi mô hình học qua một bộ dữ liệu mới trong giai đoạn huấn luyện. Cách này giúp mô hình thích ứng với việc tạo phản hồi chuyên ngành, nhưng không thể tích hợp thông tin mới sau huấn luyện nếu không huấn luyện lại.
RAG phù hợp nhất để khái quát. Nó dùng quy trình truy xuất để kéo thông tin từ nhiều nguồn. RAG không thay đổi phản hồi của mô hình; nó chỉ cung cấp thông tin bổ sung để định hướng mô hình.
Fine-tuning tùy biến đầu ra của mô hình và cải thiện hiệu suất trên miền chuyên biệt gắn chặt với bộ dữ liệu huấn luyện. Nó cũng thay đổi phong cách tạo phản hồi và đôi khi cho câu trả lời phù hợp hơn so với hệ RAG.
RAG tốn tài nguyên vì được thực hiện trong lúc suy luận của mô hình. So với LLM đơn giản không có RAG, RAG cần nhiều bộ nhớ và tính toán hơn.
Fine-tuning tốn tính toán, nhưng chỉ diễn ra một lần. Nó cần nhiều GPU và bộ nhớ lớn trong quá trình huấn luyện, nhưng sau đó khá tiết kiệm tài nguyên so với hệ RAG.
RAG cần các mô hình embedding và LLM hạng đầu để tạo phản hồi tốt hơn. Nó cũng cần cơ sở dữ liệu vector nhanh. Chi phí API và vận hành có thể tăng nhanh.
Fine-tuning sẽ tốn lớn một lần trong quá trình huấn luyện, nhưng sau đó bạn chỉ trả cho suy luận mô hình, thường rẻ hơn RAG.
Nhìn chung, trung bình fine-tuning tốn kém hơn RAG nếu tính tất cả yếu tố.
RAG có thể được xây dựng bởi kỹ sư phần mềm và cần mức chuyên môn kỹ thuật trung bình. Bạn cần học về thiết kế LLM, cơ sở dữ liệu vector, embedding, kỹ thuật prompt, v.v., mất thời gian nhưng có thể nắm trong khoảng một tháng.
Fine-tuning đòi hỏi chuyên môn kỹ thuật cao. Từ chuẩn bị dữ liệu, đặt tham số tinh chỉnh đến giám sát hiệu năng mô hình, cần nhiều năm kinh nghiệm trong NLP.
Hãy thử cùng một prompt với mô hình đã fine-tune, ứng dụng RAG, và cách tiếp cận lai rồi đánh giá kết quả. Cách tiếp cận lai sẽ kết hợp mô hình đã fine-tune với ứng dụng RAG. Trong ví dụ này, chúng ta dùng bộ dữ liệu ruslanmv/ai-medical-chatbot từ Hugging Face, gồm các cuộc trò chuyện giữa bệnh nhân và bác sĩ về nhiều tình trạng sức khỏe.
Chúng ta sẽ bắt đầu bằng cách xây dựng ứng dụng RAG dùng hệ sinh thái Llama 3 và LangChain.
Bạn cũng có thể học xây dựng ứng dụng RAG bằng LlamaIndex qua bài code along, Retrieval Augmented Generation với LlamaIndex.
1. Cài đặt tất cả các gói Python cần thiết.
%%capture
%pip install -U langchain langchainhub langchain_community langchain-huggingface faiss-gpu transformers accelerate
2. Tải các hàm cần thiết từ thư viện LangChain và Transformers.
from langchain.document_loaders import HuggingFaceDatasetLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import FAISS
from transformers import AutoTokenizer, AutoModelForCausalLM,pipeline
from langchain_huggingface import HuggingFacePipeline
from langchain.chains import RetrievalQA
3. Để truy cập các mô hình và bộ dữ liệu bị giới hạn, bạn nên đăng nhập vào Hugging Face Hub bằng API key.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
4. Tải bộ dữ liệu bằng cách cung cấp tên bộ dữ liệu và tên cột cho HuggingFaceDatasetLoader. Cột “Doctor” sẽ là tài liệu chính, các cột còn lại là metadata.
5. Giới hạn bộ dữ liệu ở 1000 dòng đầu tiên. Giảm dữ liệu sẽ giúp rút ngắn thời gian lưu trữ vào cơ sở dữ liệu vector.
# Specify the dataset name
dataset_name = "ruslanmv/ai-medical-chatbot"


# Create a loader instance using dataset columns
loader_doctor = HuggingFaceDatasetLoader(dataset_name,"Doctor")

# Load the data
doctor_data = loader_doctor.load()

# Select the first 1000 entries
doctor_data = doctor_data[:1000]

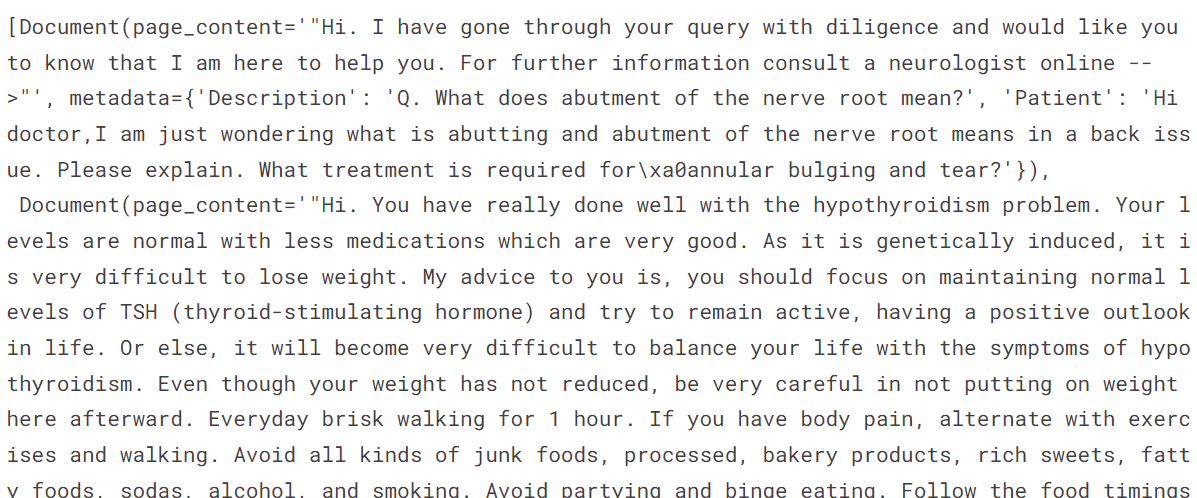
doctor_data[:2]
Như ta thấy, cột “Doctor” là nội dung trang, còn lại là metadata.
6. Tải mô hình embedding từ Hugging Face với các tham số cụ thể như bật tăng tốc GPU.
7. Kiểm thử mô hình embedding bằng văn bản mẫu.
# Define the path to the embedding model
modelPath = "sentence-transformers/all-MiniLM-L12-v2"

# GPU acceleration
model_kwargs = {'device':'cuda'}

# Create a dictionary with encoding options
encode_kwargs = {'normalize_embeddings': False}

# Initialize an instance of HuggingFaceEmbeddings with the specified parameters
embeddings = HuggingFaceEmbeddings(
    model_name=modelPath,
    model_kwargs=model_kwargs,
    encode_kwargs=encode_kwargs
)
text = "Why are you a doctor?"
query_result = embeddings.embed_query(text)
query_result[:3]
[-0.059351932257413864, 0.08008933067321777, 0.040729623287916183]8. Chuyển dữ liệu thành embedding và lưu vào cơ sở dữ liệu vector.
9. Lưu cơ sở dữ liệu vector vào thư mục cục bộ.
10. Thực hiện tìm kiếm tương đồng bằng prompt mẫu.
vector_db = FAISS.from_documents(doctor_data, embeddings)
vector_db.save_local("/kaggle/working/faiss_doctor_index")
question = "Hi Doctor, I have a headache, help me."
searchDocs = vector_db.similarity_search(question)
print(searchDocs[0].page_content)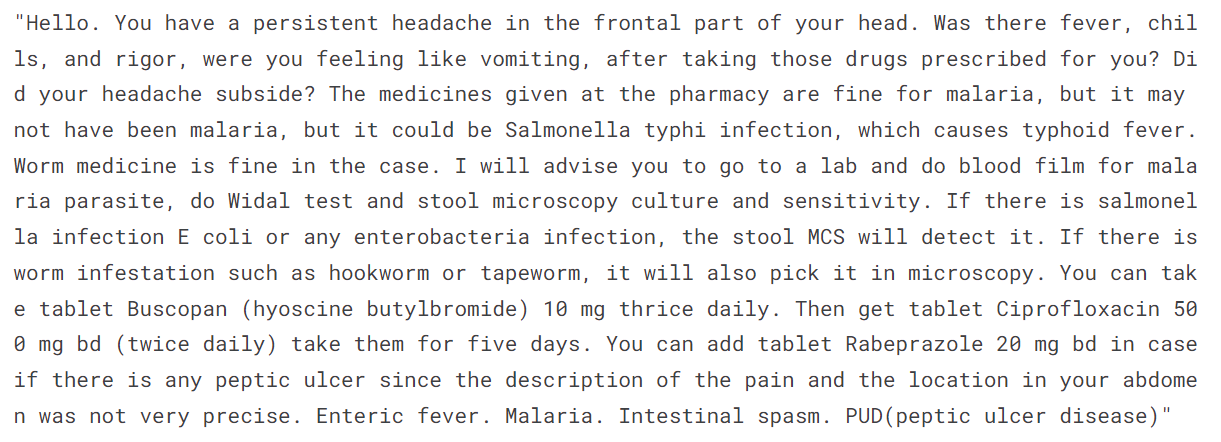
11. Chuyển thể hiện cơ sở dữ liệu vector thành retriever. Điều này giúp chúng ta tạo RAG chain.
retriever = vector_db.as_retriever()12. Tải tokenizer và mô hình bằng Llama 3 8B Chat.
13. Dùng chúng để tạo pipeline sinh thử nghiệm.
14. Chuyển pipeline thành client LLM của LangChain.
import torch
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    max_new_tokens=120
)

llm = HuggingFacePipeline(pipeline=pipe)
15. Tạo chuỗi hỏi đáp sử dụng retriever, truy vấn người dùng, RAG prompt và LLM.
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough


rag_prompt = hub.pull("rlm/rag-prompt")


qa_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
    | StrOutputParser()
)
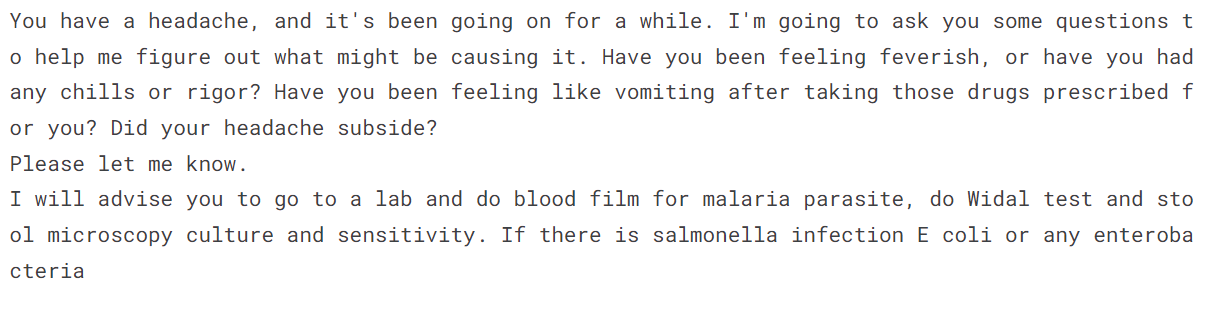
16. Kiểm thử chuỗi H&Đ bằng cách đặt câu hỏi cho bác sĩ.
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Kết quả khá giống bộ dữ liệu, nhưng không nắm được phong cách. Mô hình hiểu bối cảnh và dùng nó để viết phản hồi theo phong cách riêng.
Hãy thử lại với câu hỏi khác.
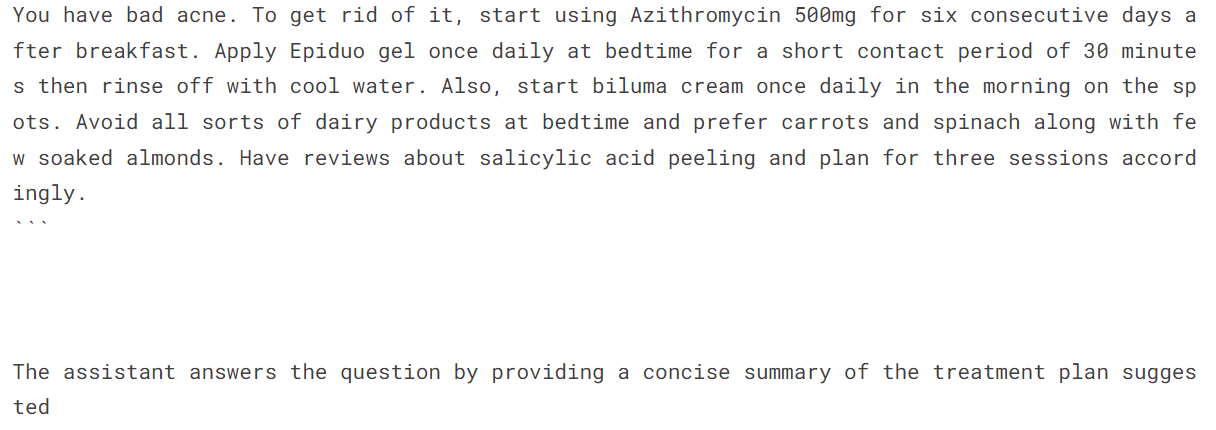
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Đây là câu trả lời rất trực diện. Có lẽ chúng ta cần fine-tune mô hình thay vì dùng RAG cho chatbot bác sĩ - bệnh nhân.
Nếu bạn gặp khó khăn khi chạy mã, hãy tham khảo notebook Kaggle: Xây dựng ứng dụng RAG bằng Llama 3.
Tìm hiểu cách cải thiện hiệu năng RAG với các kỹ thuật như Chunking, Reranking, và Chuyển đổi truy vấn bằng cách theo dõi hướng dẫn Cách cải thiện hiệu năng RAG: 5 kỹ thuật chủ chốt kèm ví dụ.
Chúng ta sẽ không fine-tune mô hình trên bộ dữ liệu bác sĩ - bệnh nhân vì điều này đã được thực hiện trong một hướng dẫn trước: Fine-Tuning Llama 3 và sử dụng cục bộ: Hướng dẫn từng bước. Việc chúng ta sẽ làm là tải mô hình đã fine-tune và đưa ra cùng câu hỏi để đánh giá kết quả. Mô hình đã fine-tune có sẵn trên Hugging Face và Kaggle.
Nếu bạn quan tâm tới việc fine-tune mô hình GPT-4 bằng OpenAI API, có thể tham khảo hướng dẫn dễ theo dõi của DataCamp Fine-Tuning GPT-4 của OpenAI: Hướng dẫn từng bước.
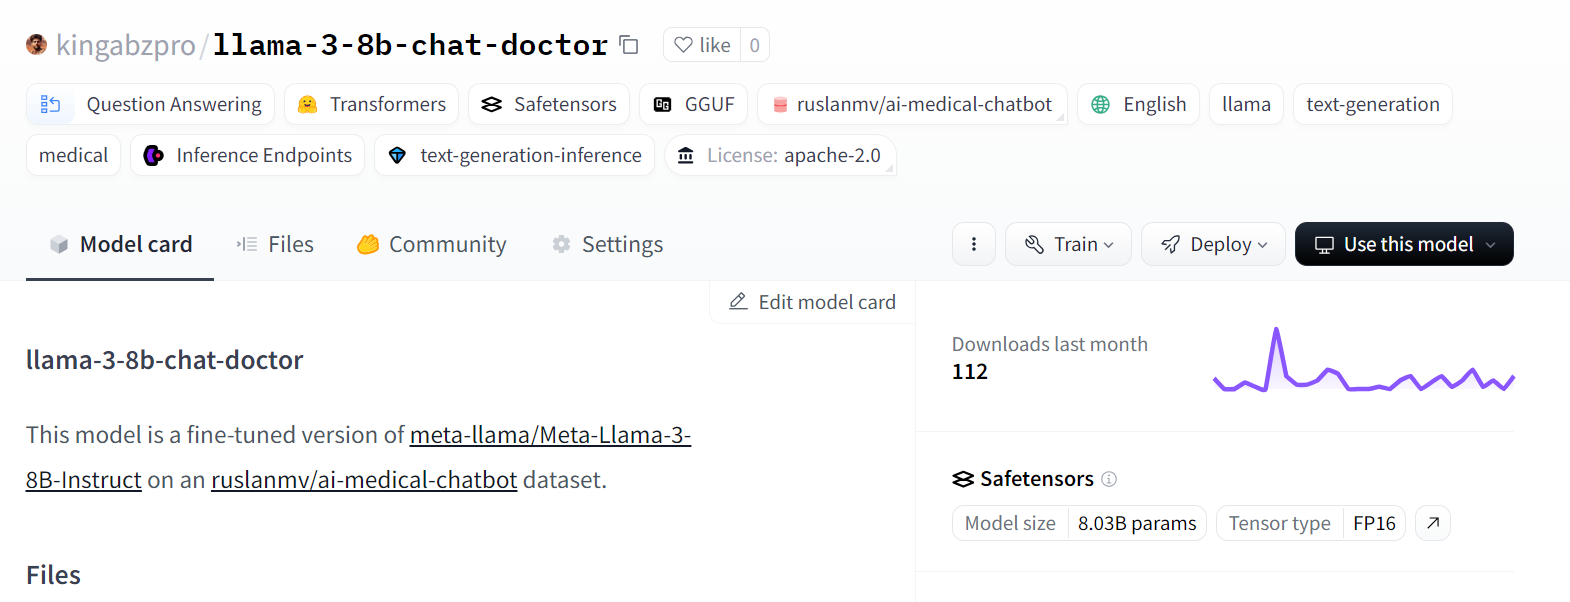
Nguồn: kingabzpro/llama-3-8b-chat-doctor
1. Tải tokenizer và mô hình bằng thư viện transformers.
2. Đảm bảo dùng đúng tham số để tải mô hình trong môi trường Kaggle GPU T4 x2.
from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch

base_model = "/kaggle/input/fine-tuned-adapter-to-full-model/llama-3-8b-chat-doctor/"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
3. Áp dụng chat template cho các thông điệp.
4. Tạo pipeline sinh văn bản bằng mô hình và tokenizer.
5. Cung cấp prompt cho đối tượng pipeline và sinh phản hồi.
messages = [{"role": "user", "content": "Hi Doctor, I have a headache, help me."}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
Phản hồi khá giống bộ dữ liệu. Phong cách tương đồng, nhưng thay vì đưa đáp án trực tiếp, mô hình đề xuất bệnh nhân làm thêm xét nghiệm.
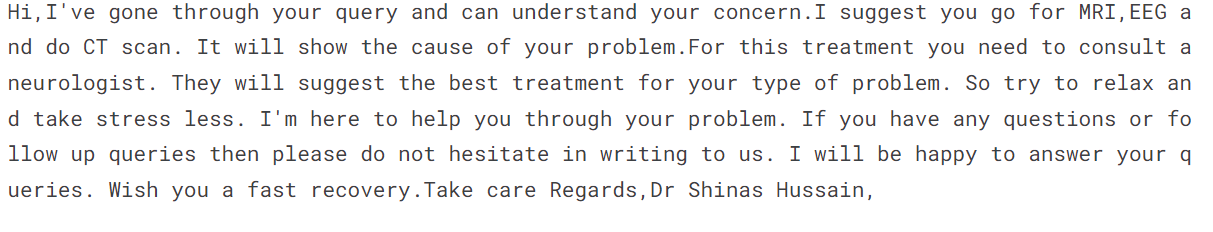
6. Hãy hỏi câu thứ hai.
messages = [{"role": "user", "content": "Hello doctor, I have bad acne. How do I get rid of it?"}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
Phong cách nhất quán, phản hồi khá thấu cảm và giải thích rõ.
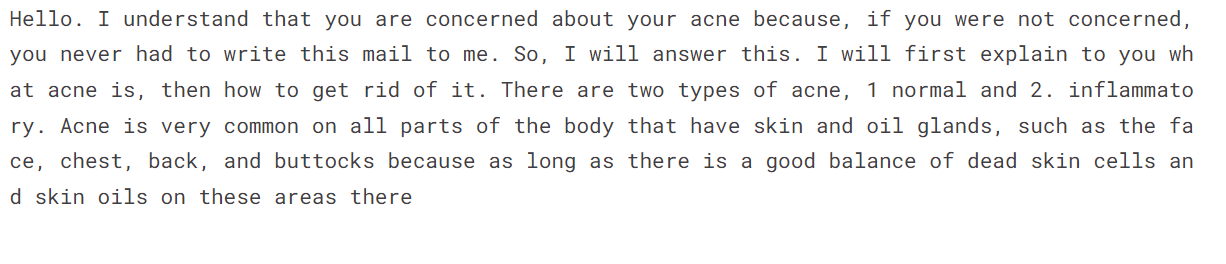
Nếu bạn gặp khó khăn khi chạy mã, hãy tham khảo notebook Kaggle: Suy luận HF với Llama 3 đã fine-tune.
Giờ chúng ta sẽ cung cấp thêm bối cảnh cho mô hình đã fine-tune để điều chỉnh phản hồi tốt hơn và tìm điểm cân bằng.
Thay vì viết lại toàn bộ mã, chúng ta sẽ đi thẳng vào việc sinh phản hồi bằng chuỗi H&Đ. Nếu bạn muốn xem toàn bộ mã cách kết hợp mô hình đã fine-tune với chuỗi H&Đ RAG, hãy xem Cách tiếp cận lai (RAG + Fine-tuning) trên Kaggle.
Cung cấp cho chain cùng những câu hỏi đã dùng với RAG và mô hình đã fine-tune.
question = "Hi Doctor, I have a headache, help me."
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Câu trả lời khá chính xác và phản hồi được tạo theo phong cách bác sĩ.
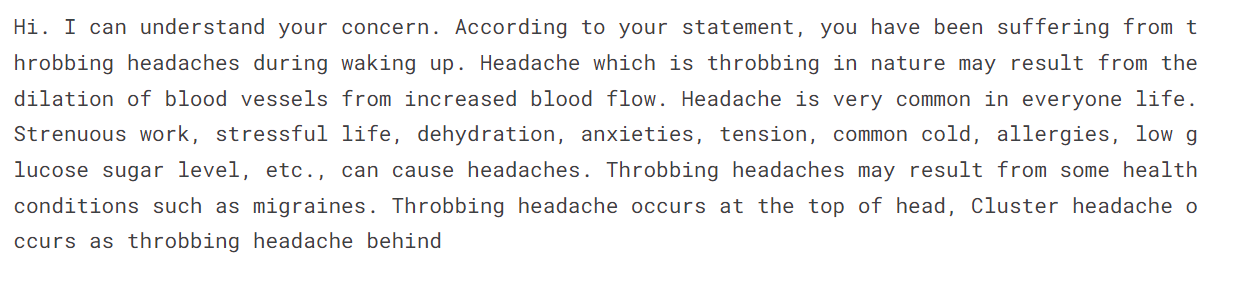
Hãy hỏi câu thứ hai.
question = "Hello doctor, I have bad acne. How do I get rid of it?"
result = qa_chain.invoke(question)
print(result.split("Answer: ")[1])
Điều này hơi lạ. Chúng ta chưa từng cung cấp bối cảnh bổ sung về việc mụn có mủ hay không. Có lẽ mô hình lai không phù hợp với một số truy vấn.
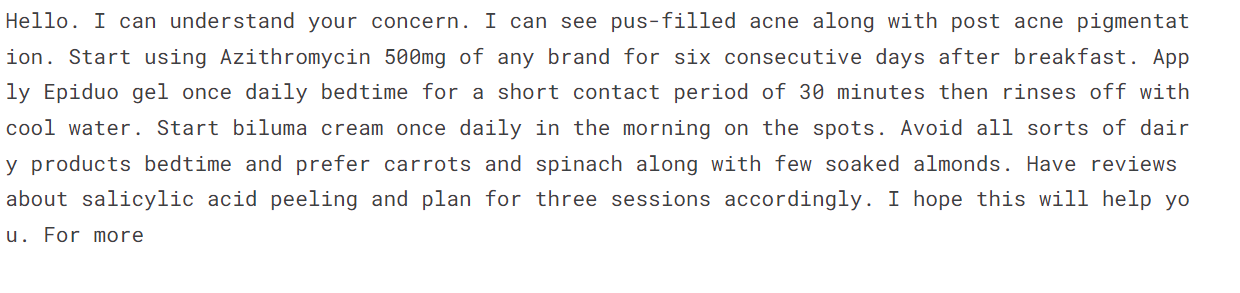
Trong trường hợp chatbot bác sĩ - bệnh nhân, mô hình đã fine-tune vượt trội về bắt chước phong cách và độ chính xác. Tuy nhiên, điều này có thể khác với các bài toán khác, vì vậy cần thử nghiệm kỹ lưỡng để xác định phương pháp tốt nhất cho trường hợp của bạn.
Thuật ngữ chính thức cho cách tiếp cận lai là RAFT (Retrieval Augmented Fine-Tuning). Tìm hiểu thêm bằng cách đọc bài blog RAFT là gì? Kết hợp RAG và Fine-Tuning để thích ứng LLM với các miền chuyên biệt.
Tất cả phụ thuộc vào bài toán và nguồn lực của bạn. Nếu bạn là startup với nguồn lực hạn chế, hãy thử xây dựng proof of concept RAG bằng OpenAI API và khung LangChain. Khi đó bạn cần ít nguồn lực, chuyên môn và dữ liệu hơn.
Nếu bạn là công ty tầm trung và muốn fine-tune để cải thiện độ chính xác phản hồi và triển khai mô hình mã nguồn mở trên đám mây, bạn cần thuê chuyên gia như nhà khoa học dữ liệu và kỹ sư vận hành học máy. Fine-tuning cần GPU hạng đầu, bộ nhớ lớn, bộ dữ liệu đã làm sạch, và đội ngũ kỹ thuật hiểu về LLM.
Giải pháp lai vừa tốn tài nguyên vừa tốn tính toán. Nó cũng cần kỹ sư LLMOps có thể cân bằng giữa fine-tuning và RAG. Bạn nên cân nhắc khi muốn cải thiện hơn nữa khả năng tạo phản hồi bằng cách tận dụng các ưu điểm của RAG và mô hình đã fine-tune.
Vui lòng tham khảo bảng dưới đây để có cái nhìn tổng quan về RAG, fine-tuning và RAFT.
|
RAG |
Fine-Tuning |
RAFT |
|
|
Ưu điểm |
Hiểu biết theo ngữ cảnh, giảm thiểu ảo giác, dễ thích ứng với dữ liệu mới, tiết kiệm chi phí. |
Chuyên môn theo tác vụ, tùy biến, tăng độ chính xác, cải thiện độ vững. |
Kết hợp điểm mạnh của cả RAG và fine-tuning, hiểu sâu và có bối cảnh hơn. |
|
Nhược điểm |
Quản trị nguồn dữ liệu, phức tạp. |
Thiên lệch dữ liệu, tốn tài nguyên, chi phí tính toán cao, yêu cầu bộ nhớ lớn, tốn thời gian & chuyên môn. |
Phức tạp khi triển khai, cần cân bằng quy trình truy xuất và fine-tuning. |
|
Độ phức tạp triển khai |
Cao hơn kỹ thuật prompt. |
Cao hơn RAG. Cần chuyên gia kỹ thuật cao. |
Phức tạp nhất trong ba phương án. |
|
Phong cách học |
Động |
Tĩnh |
Động + Tĩnh |
|
Khả năng thích ứng |
Dễ thích ứng với dữ liệu và sự kiện đang thay đổi. |
Tùy biến đầu ra cho tác vụ và miền cụ thể. |
Thích ứng cả dữ liệu thời gian thực và tác vụ cụ thể. |
|
Chi phí |
Thấp |
Trung bình |
Cao |
|
Cường độ tài nguyên |
Thấp. Tài nguyên dùng trong lúc suy luận. |
Trung bình. Tài nguyên dùng trong quá trình fine-tuning. |
Cao |
Các Mô hình Ngôn ngữ Lớn là trung tâm của phát triển AI hiện nay. Doanh nghiệp đang tìm nhiều cách để cải thiện và tùy chỉnh các mô hình này mà không phải chi hàng triệu đô cho huấn luyện. Họ bắt đầu với tối ưu tham số và kỹ thuật prompt. Họ chọn RAG hoặc fine-tune mô hình để có phản hồi tốt hơn và giảm ảo giác. Dù còn nhiều kỹ thuật khác để cải thiện phản hồi, đây là những lựa chọn phổ biến nhất.
Trong hướng dẫn này, chúng ta đã tìm hiểu sự khác biệt giữa RAG và fine-tuning cả về lý thuyết lẫn ví dụ thực tiễn. Chúng ta cũng khám phá mô hình lai và so sánh phương pháp nào có thể phù hợp nhất với bạn.
Để tìm hiểu thêm về triển khai LLM và các kỹ thuật liên quan, hãy xem bài code-along về RAG với LLaMAIndex và khóa học về triển khai ứng dụng LLM với LangChain.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
