Kursus
Konsep Large Language Models (LLM)
2 jam
112K
Catatan: Bonsai 2 27B kini tersedia, berbasis Qwen3.8 27B
Menjalankan model bahasa secara lokal kini semakin mudah, bahkan di perangkat keras lama. Bonsai adalah model 1-bit yang dirancang agar kecil, cepat, dan efisien, menjadikannya opsi yang baik untuk penggunaan lokal di laptop Windows.
Dalam tutorial ini, saya akan menunjukkan apa itu Bonsai dan bagaimana model 1-bit bekerja dengan cara yang sederhana. Saya akan memandu Anda melalui proses setup lengkap langkah demi langkah.
Ini mencakup mengunduh model Bonsai 8B GGUF, menyiapkan fork PrismML dari llama.cpp, menguji model di command line, menjalankannya sebagai server lokal, dan memastikan semuanya berfungsi dengan curl maupun WebUI bawaan.
Saya juga merekomendasikan panduan kami untuk menjalankan GLM-5.1 dan Qwen3.5-27B secara lokal.
Bonsai adalah keluarga model bahasa 1-bit ringkas dari PrismML yang mencakup varian 1,7B, 4B, dan 8B, memberi pengguna beberapa pilihan ukuran sesuai perangkat dan kebutuhan kinerja.
Lini Bonsai dirancang untuk inferensi lokal yang efisien, dengan dukungan di llama.cpp dan runtime terkait, dan model andalan Bonsai 8B GGUF dikemukakan jauh lebih kecil daripada model 8B FP16 tipikal namun tetap kompetitif dalam kemampuan.
Model 1-bit bekerja dengan menyimpan setiap bobot sebagai satu bit alih-alih menggunakan nilai presisi penuh standar. Dalam format Q1_0 milik Bonsai, nilai 0 dipetakan ke skala negatif dan nilai 1 ke skala positif, dengan satu skala FP16 yang dibagi untuk setiap 128 bobot.
Pendekatan ini sangat mengurangi penggunaan memori sambil tetap menjaga model fungsional dan efisien untuk inferensi. Bonsai menerapkan desain 1-bit ini pada embeddings, proyeksi attention, proyeksi MLP, dan LM head, menjadikannya model 1-bit end-to-end.
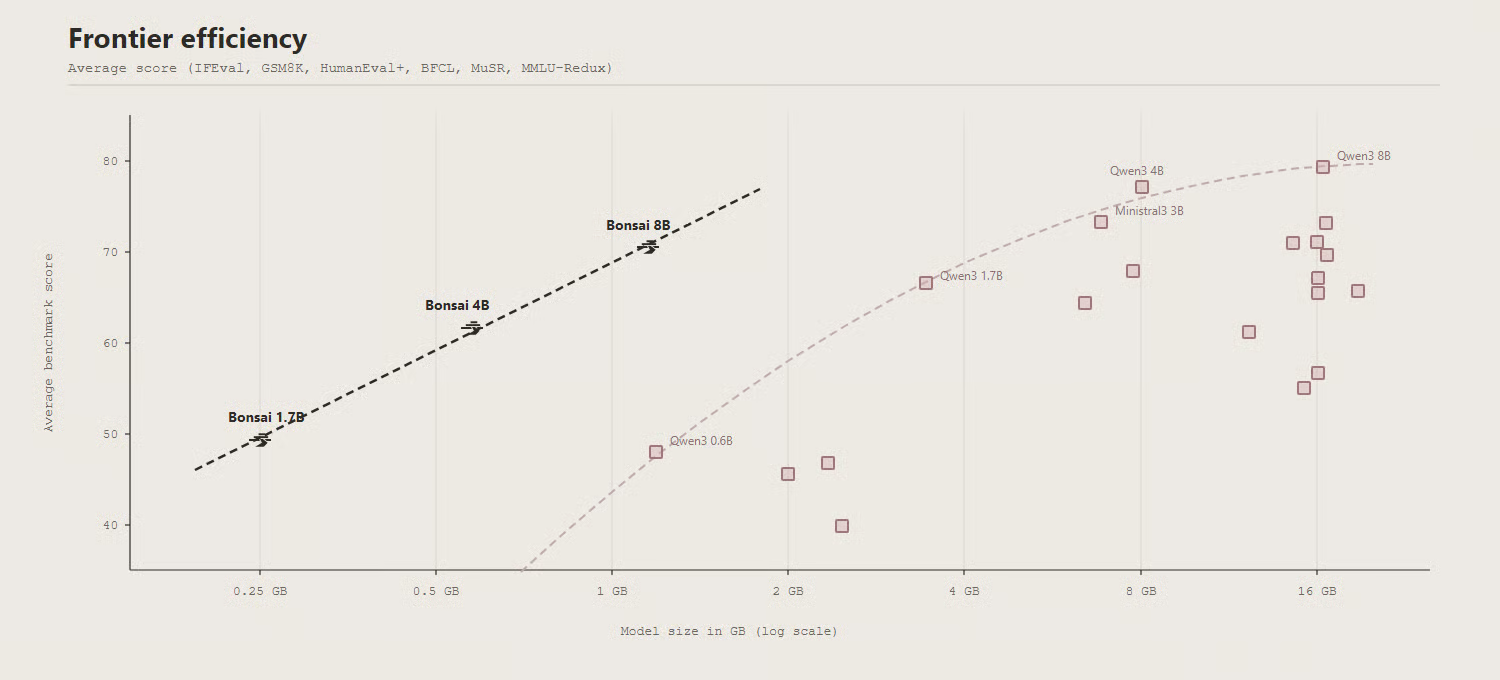
Sumber: prism-ml/Bonsai-8B-gguf · Hugging Face
Dalam pengujian benchmark, Bonsai 8B menunjukkan bahwa model 1-bit yang jauh lebih kecil masih dapat tetap kompetitif dengan model presisi penuh di kisaran 6B hingga 9B. Kartu model melaporkan skor rata-rata 70,5 di enam kategori evaluasi, menempatkannya dekat dengan beberapa model 8B standar. Ini membuat Bonsai menonjol bukan hanya karena ukuran dan kecepatannya, tetapi juga karena menjaga performa yang solid.
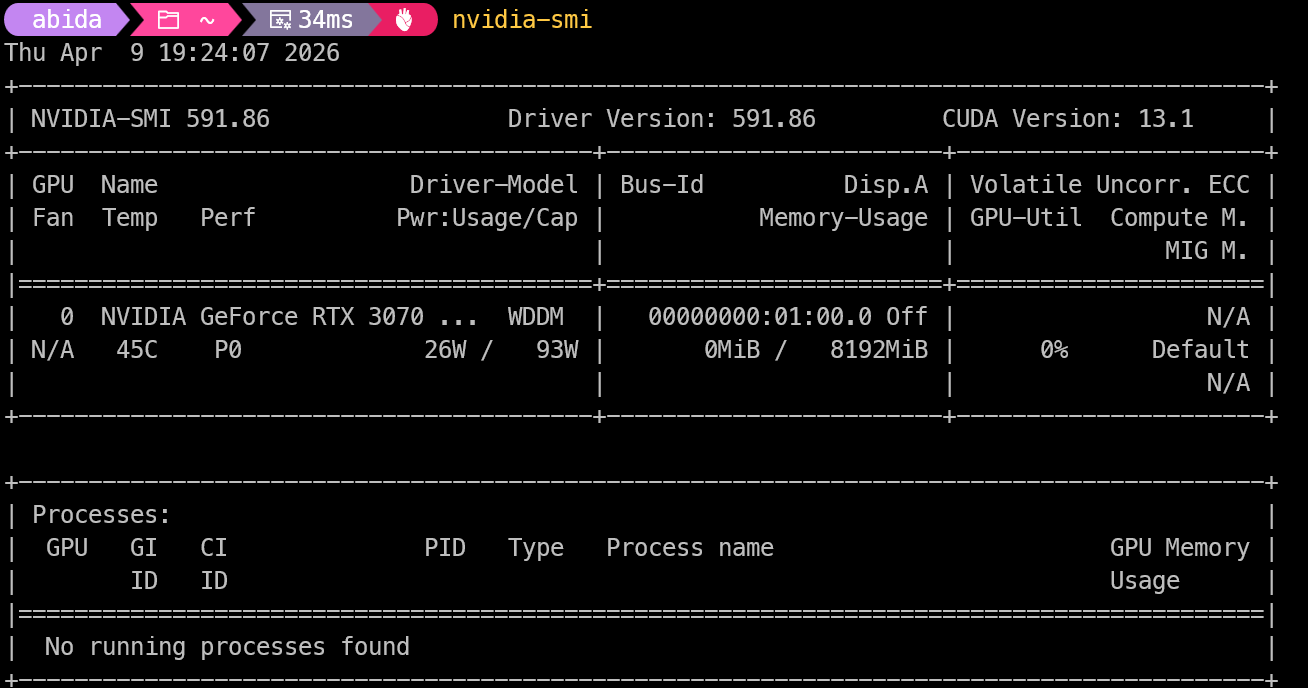
Untuk tutorial ini, saya menjalankan Bonsai di laptop Windows lama dengan prosesor Intel Gen ke-12 dan GPU NVIDIA RTX 3070. Salah satu keunggulan terbesar Bonsai 8B adalah dapat berjalan dengan sekitar 2 GB VRAM atau RAM sistem, sehingga menjadi opsi praktis untuk laptop lama dan sistem dengan memori lebih rendah.
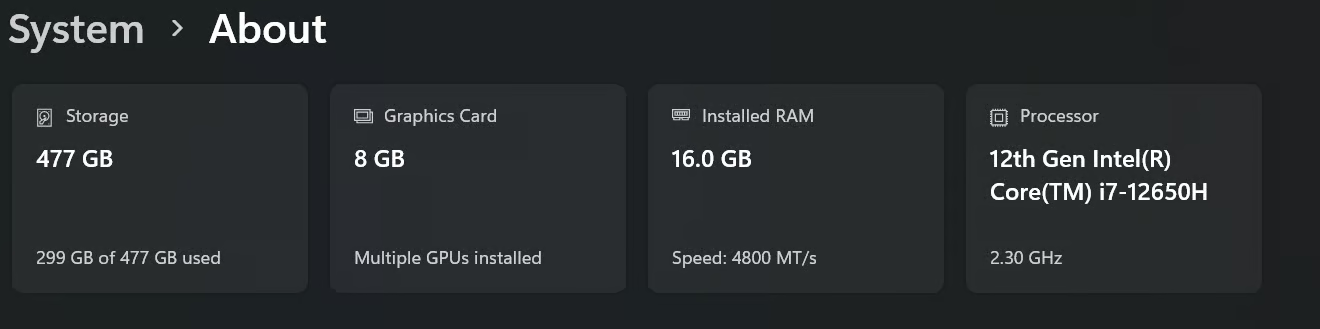
Untuk kecepatan yang lebih baik, saya menyarankan menginstal driver GPU NVIDIA terbaru dan CUDA Toolkit dari halaman unduhan resmi NVIDIA. CUDA Toolkit adalah lingkungan pengembangan resmi NVIDIA untuk aplikasi yang dipercepat GPU.
Setelah semuanya terpasang, buka Command Prompt atau Terminal dan jalankan:
nvidia-smiPerintah ini menampilkan GPU NVIDIA Anda, versi driver, dan dukungan CUDA. Jika GPU Anda terdeteksi dengan benar, sistem siap menggunakan akselerasi GPU untuk menjalankan Bonsai secara lokal.
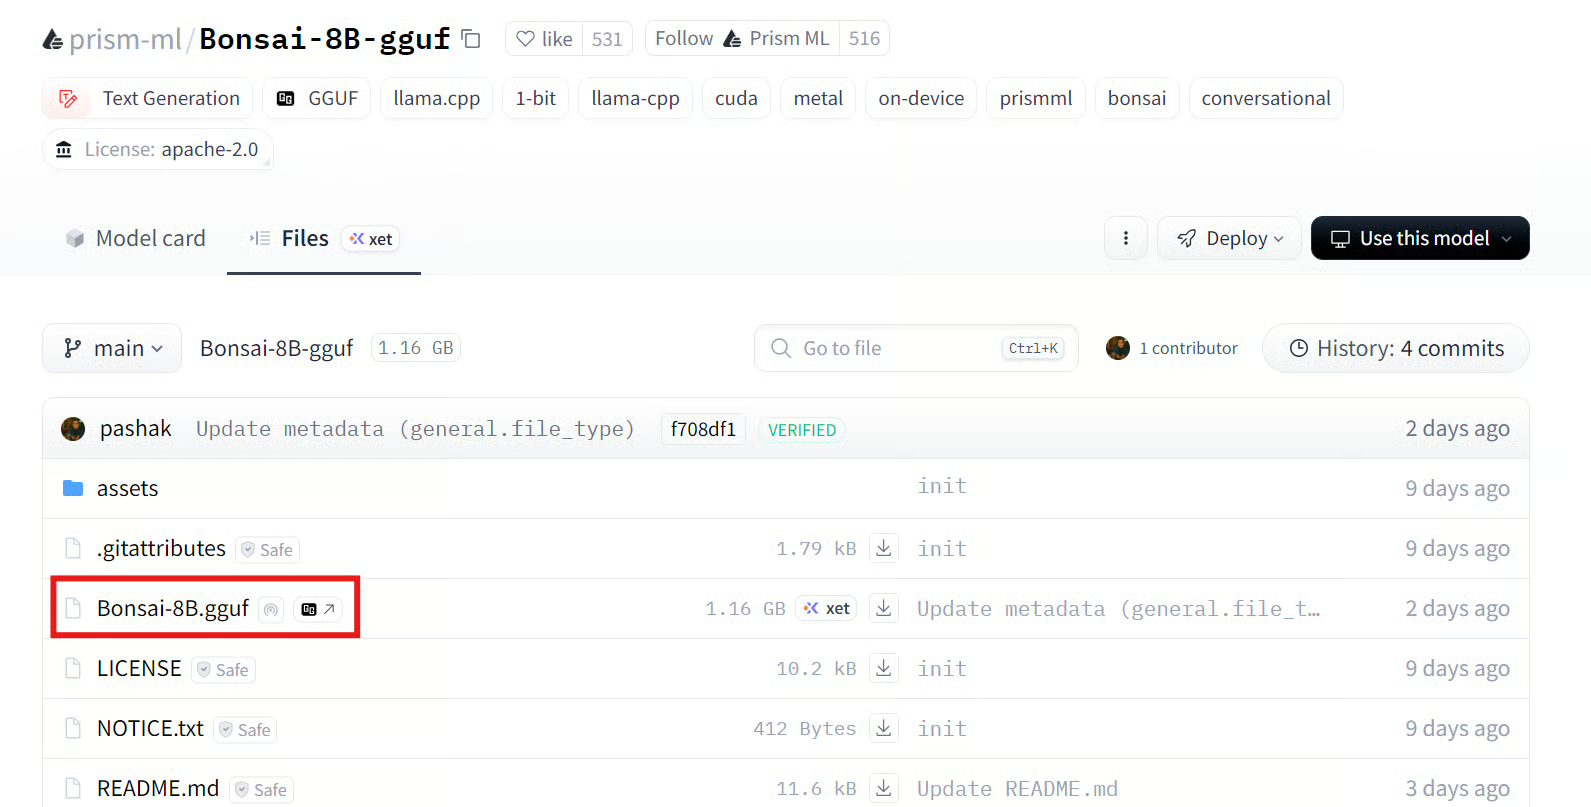
Pertama, buka repository Bonsai 8B GGUF di Hugging Face dan unduh berkas model GGUF langsung menggunakan tombol unduh.
Setelah itu, buat folder bernama “Bonsai” di sistem Anda. Di dalamnya, buat folder lain bernama “model”, lalu letakkan berkas GGUF yang diunduh ke dalam folder tersebut.
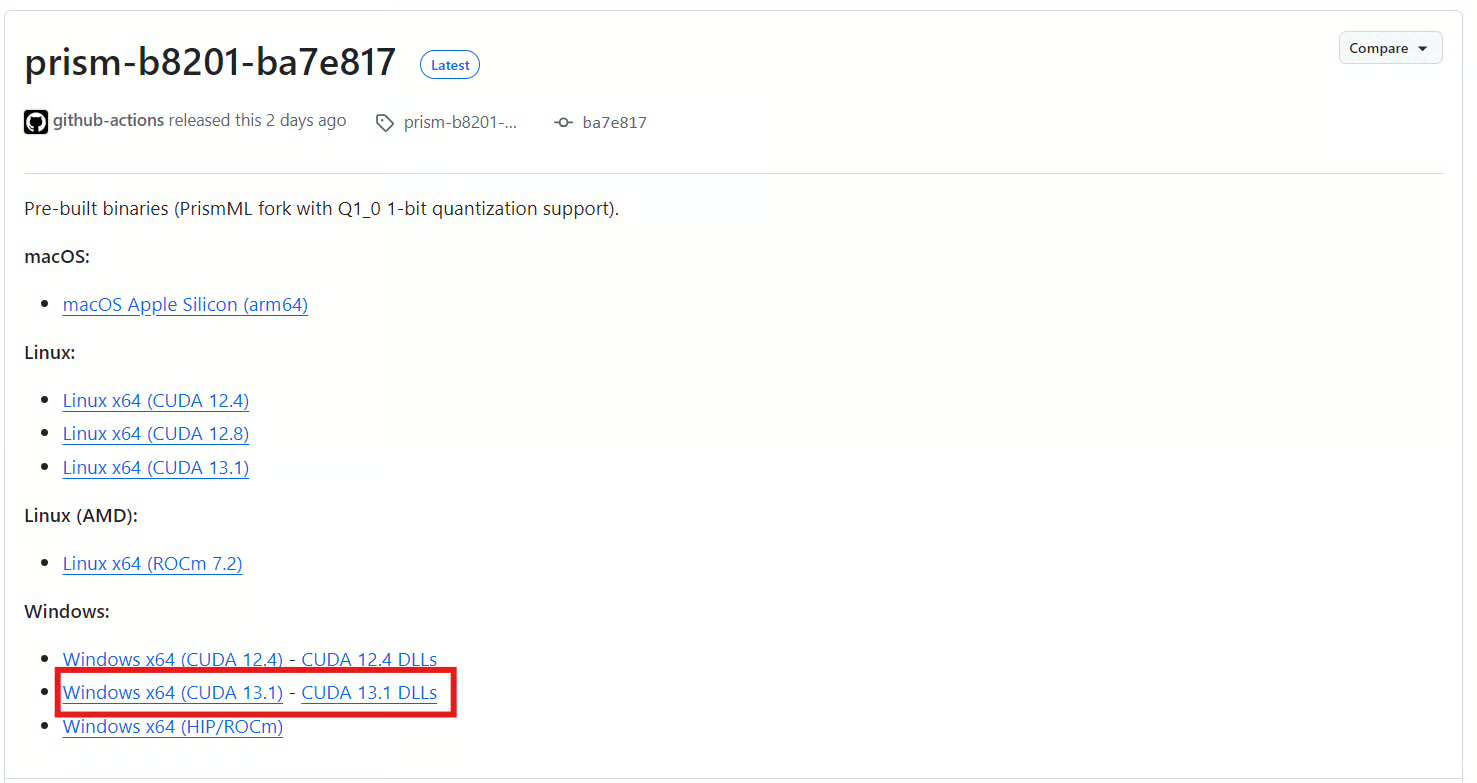
Selanjutnya, buka halaman rilis PrismML llama.cpp dan unduh build Windows x64 siap pakai yang sesuai dengan versi CUDA Anda. Untuk tutorial ini, Anda perlu mengunduh berkas Windows x64 (CUDA 13.1) dan DLL CUDA 13.1 dari halaman rilis yang sama.
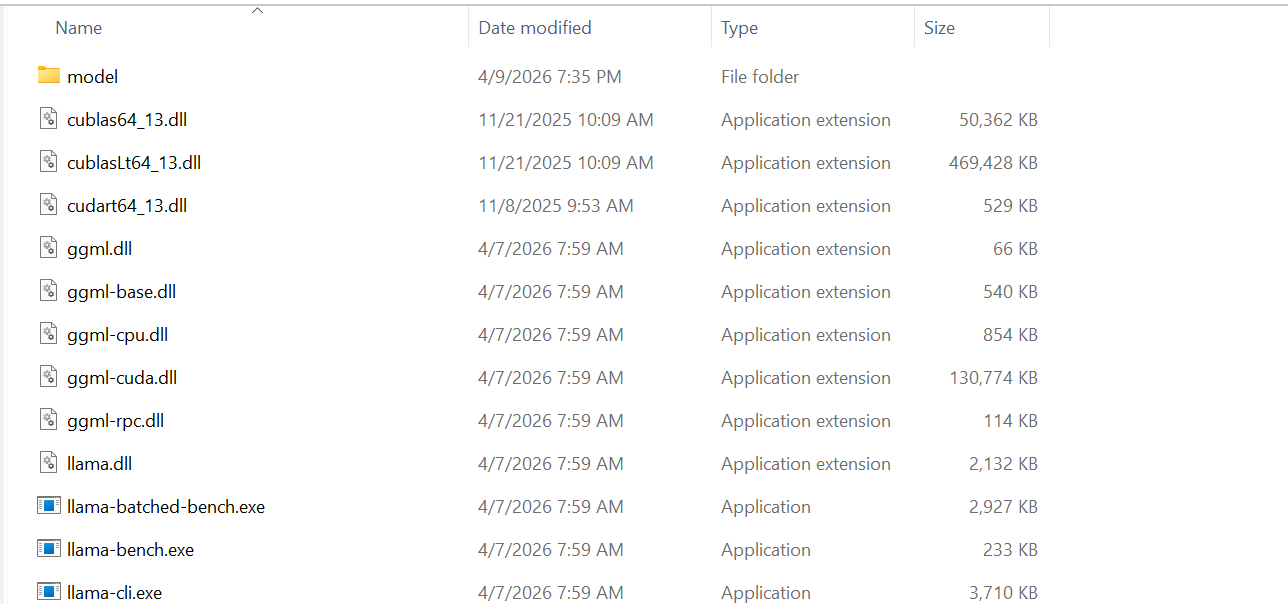
Setelah mengunduh kedua berkas ZIP, ekstrak ke dalam folder “Bonsai” yang Anda buat sebelumnya.
Setelah selesai, folder tersebut harus mencakup direktori model dengan berkas Bonsai GGUF, serta berkas llama.cpp yang diperlukan untuk menjalankan model di command line dan sebagai server lokal.
Sekarang buka folder “Bonsai”, klik kanan di area kosong, lalu pilih Open in Terminal. Ini memungkinkan Anda menjalankan model langsung dari folder yang berisi berkas llama.cpp dan direktori “model”.
Kemudian jalankan perintah berikut untuk menguji Bonsai dengan llama-cli:
.\llama-cli -m model/Bonsai-8B.gguf -p "Explain quantum computing in simple terms." -n 256 --temp 0.5 --top-p 0.85 --top-k 20 -ngl 99Perintah ini mengikuti prompt dan pengaturan generasi yang direkomendasikan pada quickstart resmi Bonsai, termasuk temperature 0.5, top-p 0.85, top-k 20, dan -ngl 99 untuk meng-offload layer ke GPU.
Dalam pengujian saya, model dimuat ke memori GPU dalam waktu kurang dari satu detik, dan responsnya cepat serta akurat.
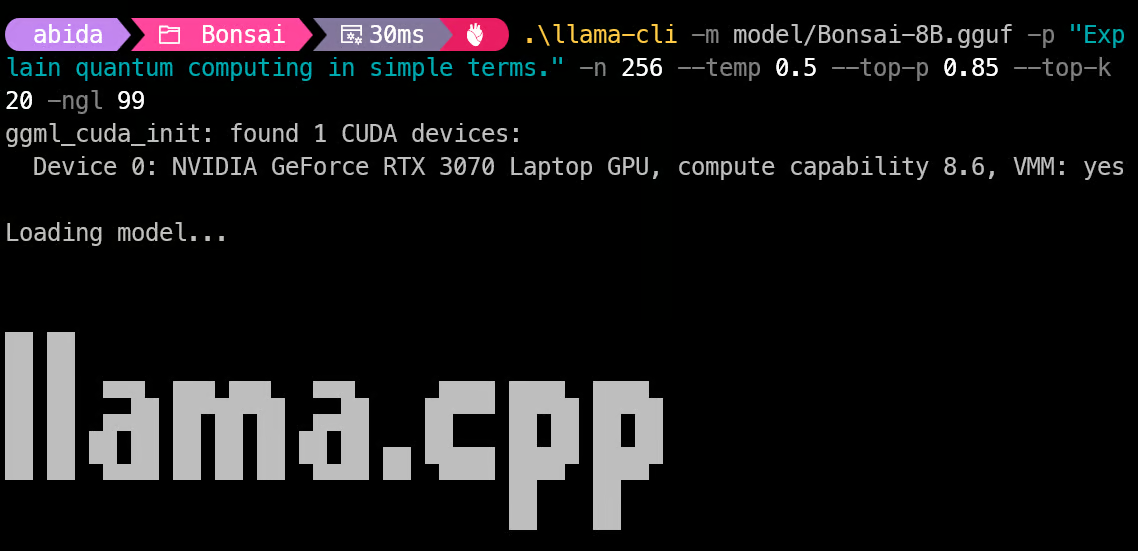
Saya juga mendapatkan sekitar 88,6 token per detik, yang sangat impresif untuk menjalankan model lokal di laptop lama.
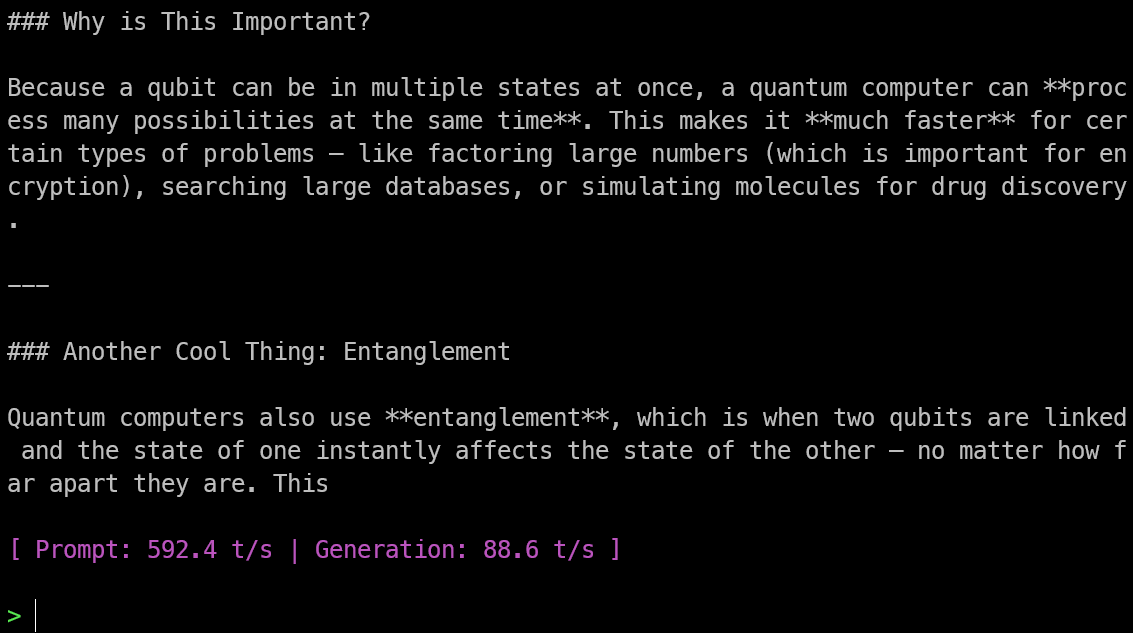
Setelah menguji model di CLI, Anda dapat menjalankannya sebagai server inferensi lokal dengan llama-server:
.\llama-server -m model/Bonsai-8B.gguf -ngl 99 --host 127.0.0.1 --port 8033Ini mengikuti setup server lokal yang sama seperti pada halaman model resmi Bonsai, di mana PrismML menggunakan llama-server untuk menyajikan model melalui endpoint HTTP lokal.
Dalam pengujian saya, model dimuat ke memori dalam waktu kurang dari 5 detik.
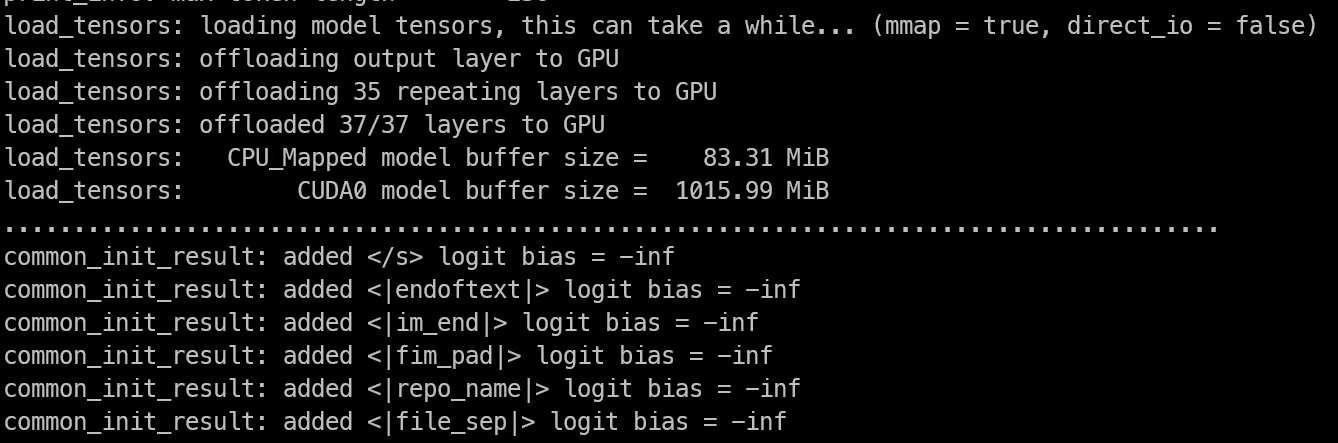
Setelah selesai memuat, terminal menampilkan bahwa server berjalan di 127.0.0.1:8033, yang berarti Bonsai kini tersedia melalui endpoint API lokal di mesin Anda.
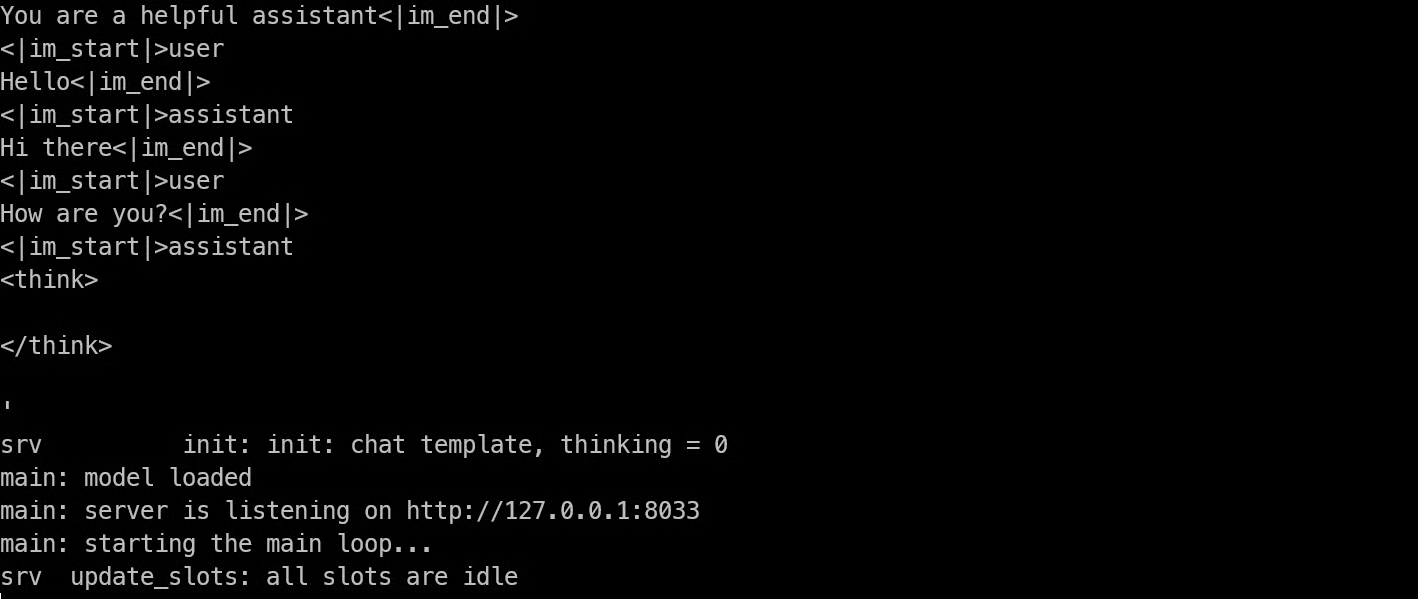
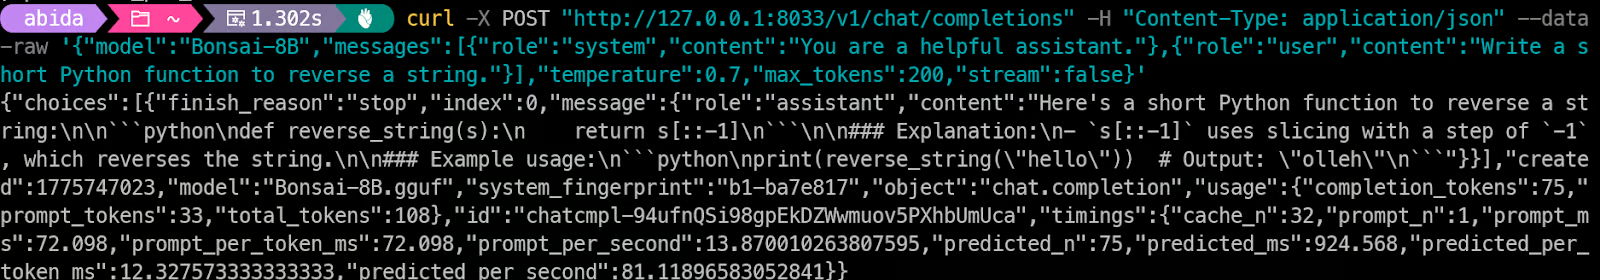
Sekarang server Bonsai sudah berjalan, langkah berikutnya adalah menguji API lokal dengan curl. Endpoint llama-server kompatibel dengan OpenAI, jadi Anda bisa mengirim permintaan ke /v1/chat/completions dan menerima respons chat completion seperti biasa.
Jalankan perintah berikut di terminal Anda:
curl -X POST "http://127.0.0.1:8033/v1/chat/completions" -H "Content-Type: application/json" --data-raw '{"model":"Bonsai-8B","messages":[{"role":"system","content":"You are a helpful assistant."},{"role":"user","content":"Write a short Python function to reverse a string."}],"temperature":0.7,"max_tokens":200,"stream":false}'Jika semuanya berfungsi dengan benar, server akan mengembalikan respons JSON dengan output yang dihasilkan.
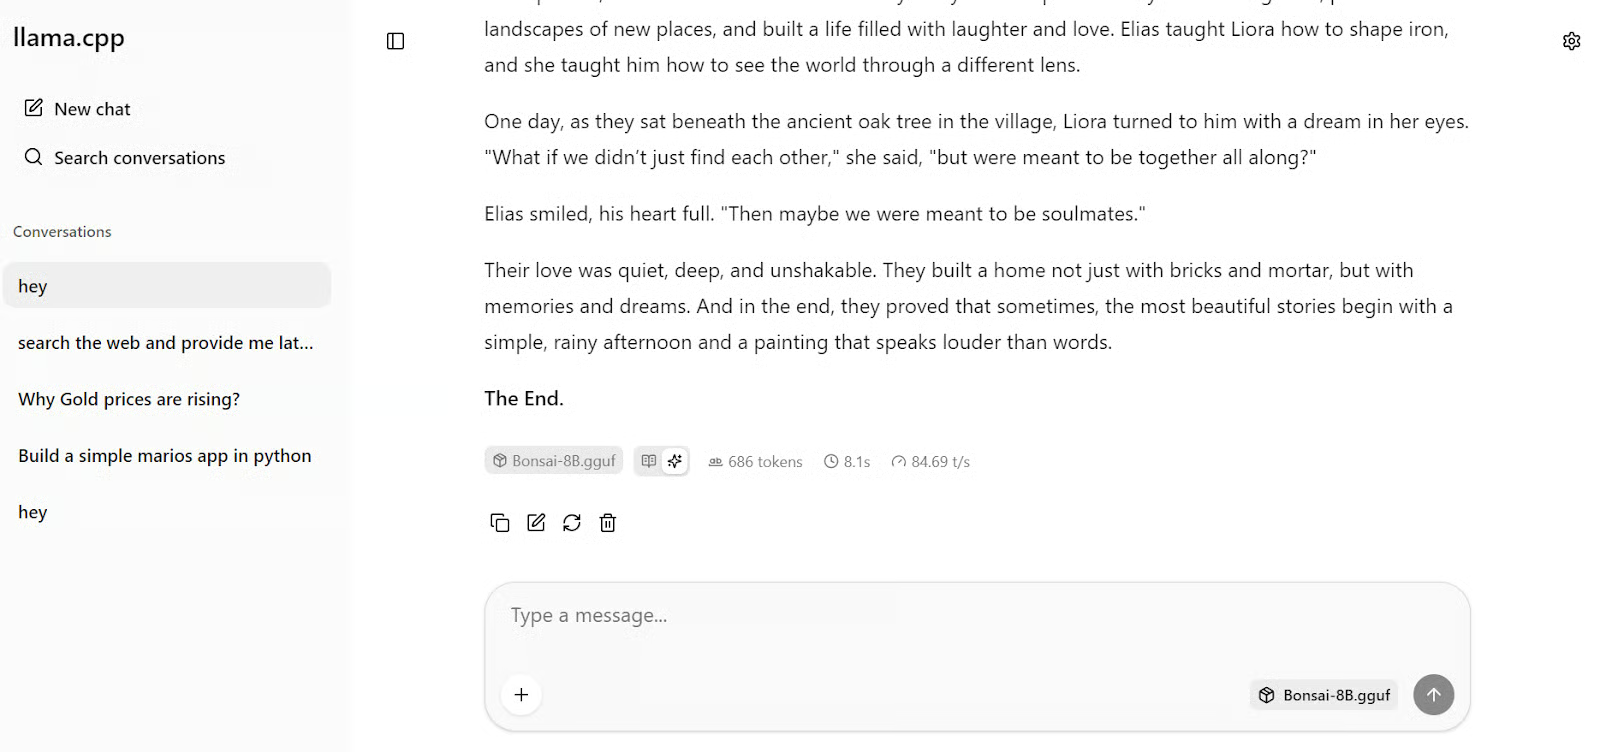
Setelah server berjalan, buka http://127.0.0.1:8033/ di browser Anda. Server llama.cpp menyertakan antarmuka web bawaan.
Ini memberi Anda antarmuka mirip ChatGPT yang sederhana untuk menguji model yang berjalan secara lokal. Dalam kasus saya, UI langsung terbuka, dan saya bisa mulai mengobrol dengan Bonsai langsung dari browser.
Pertama saya memintanya menulis cerita, dan dalam beberapa detik, ia mengembalikan respons dengan kecepatan sekitar 85 token per detik.
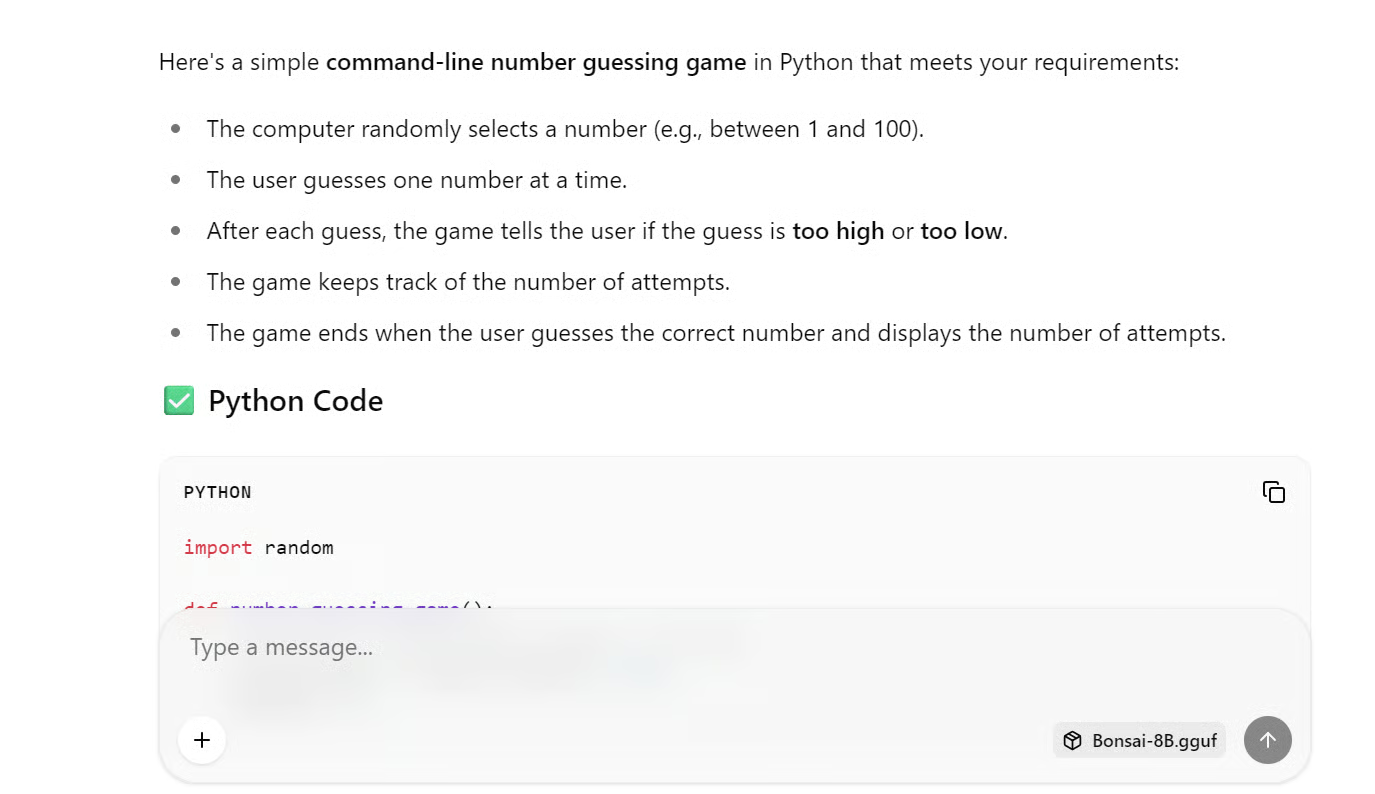
Untuk melihat seberapa baik ia menangani tugas pemrograman nyata, saya memberinya prompt ini:
Write Python code to build a command-line number guessing game where the user guesses a randomly selected number, receives "too high" or "too low" hints after each guess, and sees the total number of attempts once they guess correctly.Lagi-lagi, responsnya cepat. Model menghasilkan kode beserta instruksi sederhana tentang cara menyimpan berkas dan menjalankannya dengan Python.
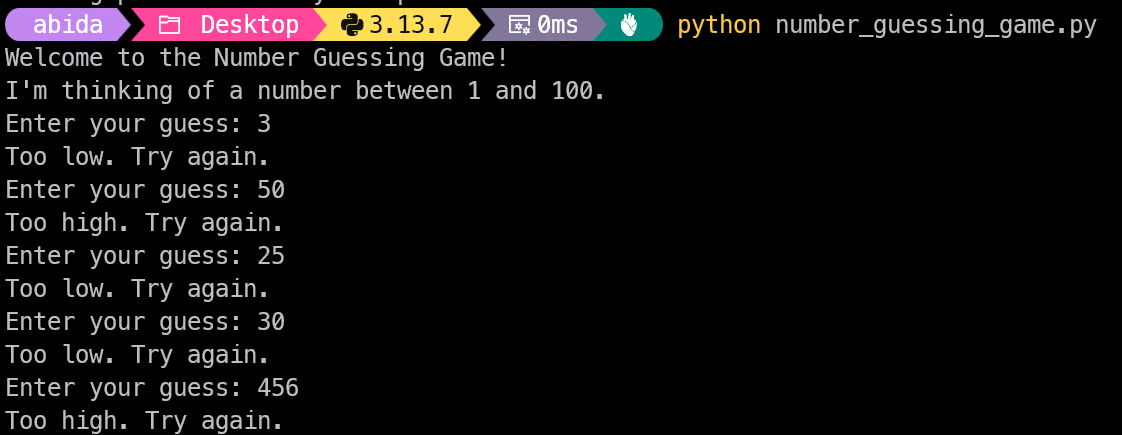
Saya menyalin kodenya ke dalam berkas Python, menjalankannya di terminal, dan langsung berfungsi tanpa masalah.
Saya juga menguji prompt kedua untuk melihat bagaimana ia menangani pembuatan front-end:
Create a simple, clean HTML personal profile website for Abid Ali Awan, a Data Scientist, with sections for a hero intro, about, skills, projects, and contact, using modern styling and placeholder content that can be customized later.Responsnya kembali cepat. Saya menyalin kode yang dihasilkan ke berkas HTML dan membukanya di browser, dan halamannya dirender dengan benar.
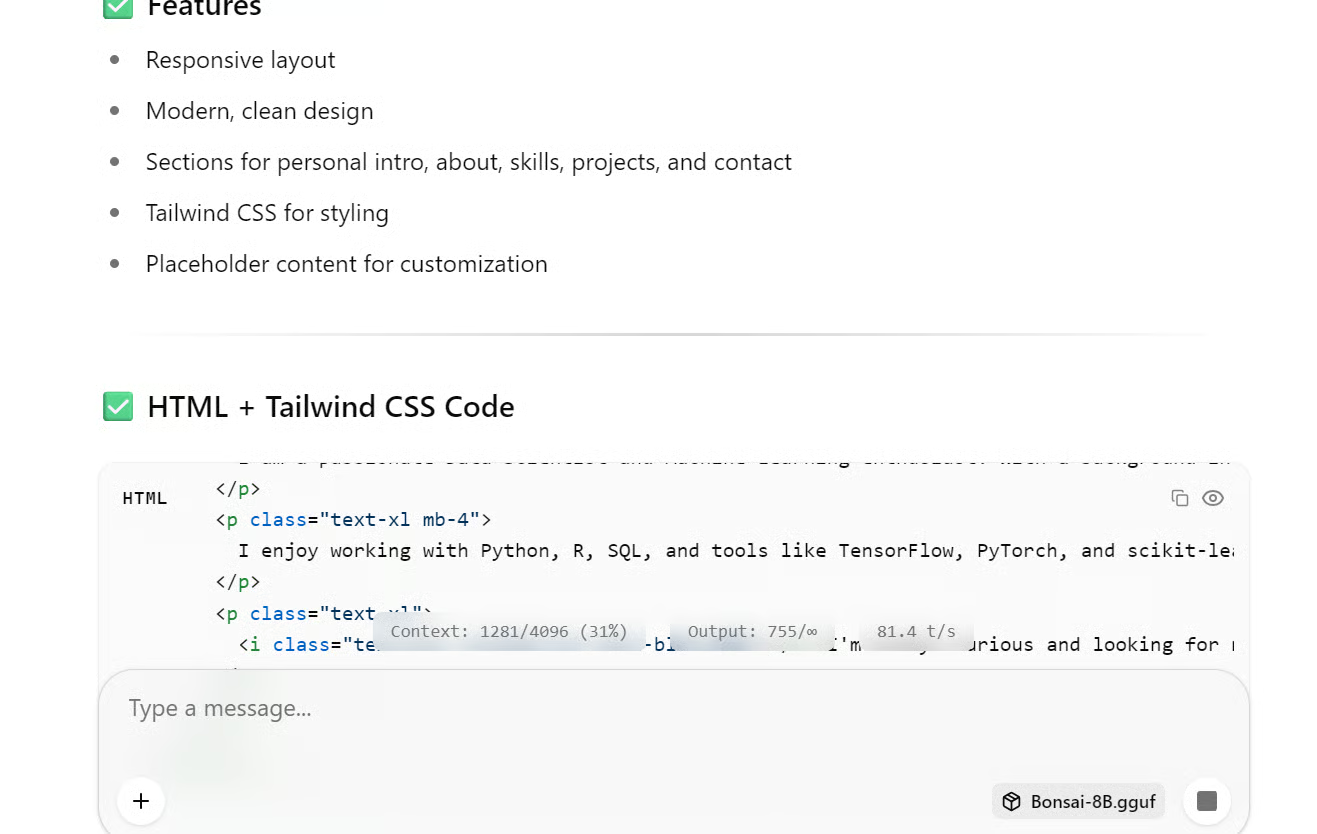
Untuk model sekecil ini, hasilnya benar-benar impresif.
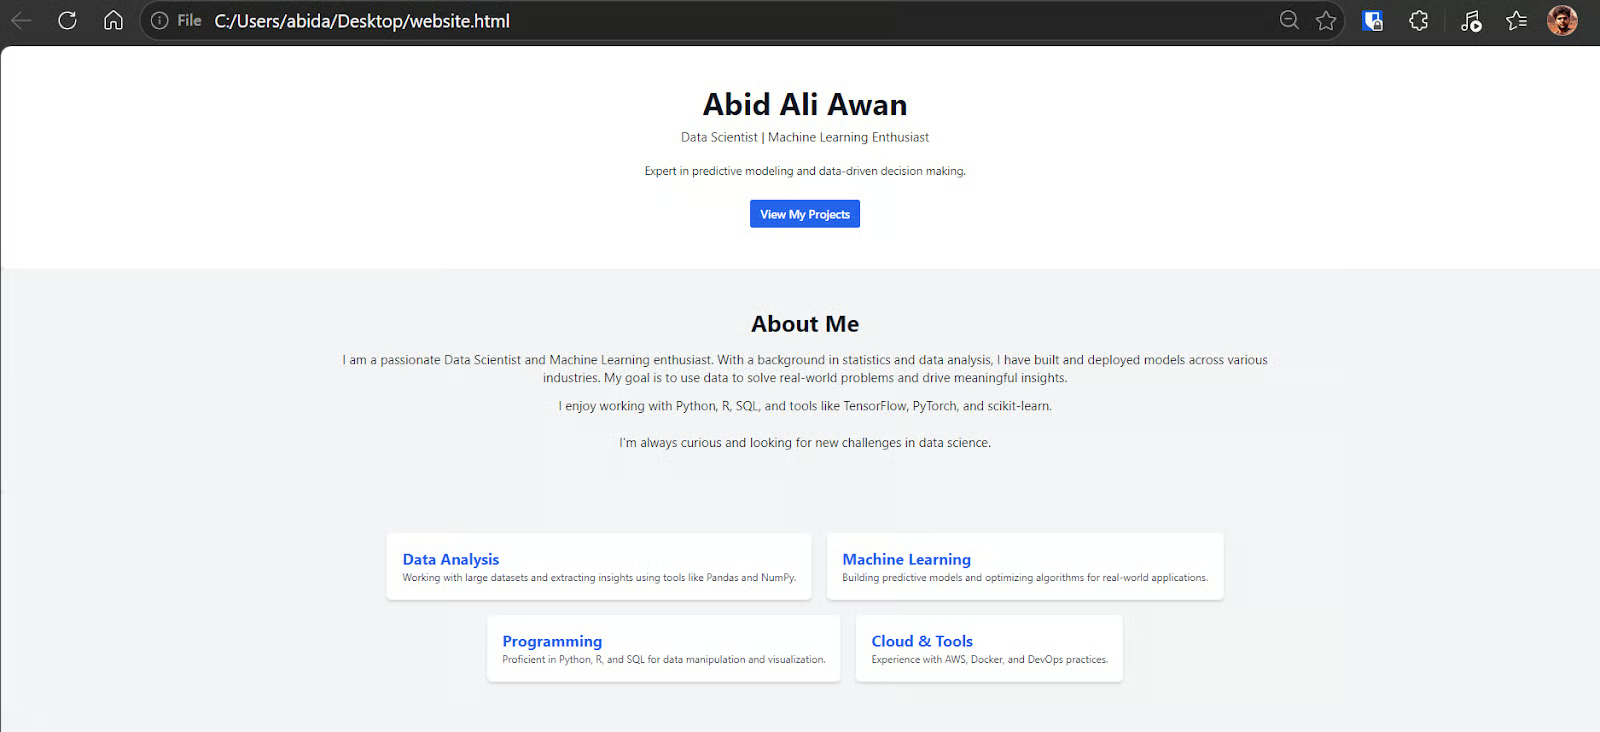
Yang paling mengejutkan saya dari Bonsai adalah gabungan kecepatan, ukuran, dan kecerdasannya. Saya tidak menyangka model sekecil ini terasa begitu cepat dan dapat digunakan di laptop Windows lama.
Proses setup lengkapnya juga jauh lebih mudah dari yang saya duga. Saya hanya perlu mengunduh berkas GGUF dari Hugging Face dan berkas build llama.cpp dari PrismML, menempatkan semuanya ke dalam satu folder, lalu menjalankan perintah di terminal untuk menguji dan menyajikan model secara lokal. Dari awal hingga selesai, saya butuh kurang dari dua menit untuk beralih dari tanpa setup menjadi benar-benar menggunakan model.
WebUI llama.cpp membuat keseluruhan pengalaman semakin mudah diakses, terutama bagi seseorang dengan pengetahuan terbatas tentang setup AI lokal atau komputasi. Setelah server berjalan, saya bisa menguji prompt, menghasilkan kode, dan mencoba tugas menulis kreatif melalui antarmuka browser sederhana tanpa alat tambahan.
Saya juga menyukai kualitas outputnya. Untuk model berukuran ini, Bonsai menangani pemrograman dan penulisan kreatif dengan sangat baik. Ia cepat di CLI, cepat melalui server lokal, dan cepat di WebUI. Meski begitu, saya tidak berpikir model sekecil ini adalah pilihan tepat untuk coding agentik atau tugas yang lebih kompleks yang memerlukan penalaran lebih dalam dan penanganan konteks lebih panjang.
Namun, jika Anda ingin menjalankan model secara lokal, menurut saya model 1-bit adalah arah yang sangat menjanjikan. Model ini menawarkan keseimbangan kuat antara efisiensi dan kecerdasan, dan membuat AI lokal jauh lebih praktis di perangkat keras sehari-hari. Saya akan sangat tertarik mencoba model 1-bit yang lebih besar berikutnya, sesuatu yang mendekati ke rentang Qwen3.5-27B, karena itu bisa menawarkan keseimbangan yang lebih baik lagi antara kecepatan, penggunaan memori, dan kapabilitas.
Kursus LLM
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt