
Kursus
Pengantar Analisis Teks di R
4 jam
27.3K
Topic modeling adalah pendekatan yang sering digunakan untuk menemukan pola semantik tersembunyi yang ditampilkan oleh sebuah korpus teks dan secara otomatis mengidentifikasi topik yang ada di dalamnya.
Ini adalah jenis pemodelan statistik yang memanfaatkan pembelajaran mesin tanpa pengawasan untuk menganalisis dan mengidentifikasi klaster atau kelompok kata serupa dalam sebuah kumpulan teks.
Sebagai contoh, algoritma topic modeling dapat digunakan untuk menentukan apakah isi sebuah dokumen menyiratkan bahwa itu adalah faktur, keluhan, atau kontrak.
Menurut beberapa sumber, rata-rata orang menghasilkan lebih dari 1,7MB data digital per detik. Angka ini berjumlah lebih dari 2,5 kuintiliun byte data per hari, di mana 80-90% bersifat tidak terstruktur.
Bayangkan skenario di mana sebuah bisnis mempekerjakan satu orang untuk meninjau setiap potongan data tidak terstruktur dan mengelompokkannya berdasarkan topik yang mendasarinya. Itu akan menjadi tugas yang mustahil.
Penyelesaiannya akan memakan waktu sangat lama dan sangat membosankan, serta berisiko lebih tinggi karena manusia secara alami memiliki bias dan lebih rentan terhadap kesalahan dibanding mesin.
Solusinya adalah topic modeling.
Dengan topic modeling, wawasan dari data dapat diperoleh lebih cepat dan mungkin lebih baik. Teknik ini menggabungkan topik-topik ke dalam struktur yang mudah dipahami, memungkinkan bisnis dengan cepat memahami apa yang terjadi.
Misalnya, bisnis yang ingin memahami tantangan terbesar pelanggan dapat memanfaatkan topic modeling untuk mempelajari informasi ini melalui data tidak terstruktur.
Singkatnya, topic modeling membantu bisnis untuk:
Kita telah menetapkan bahwa topic modeling memungkinkan profesional data menganalisis dan mengidentifikasi klaster atau kelompok kata serupa dalam teks secara cepat dan dalam skala besar.
Namun, apa itu topik, dan bagaimana topic modeling bekerja?
Topik adalah deskripsi laten dari sebuah korpus (sekumpulan besar) teks. Secara intuitif, dokumen mengenai topik tertentu lebih mungkin menghasilkan kata-kata tertentu lebih sering.
Sebagai contoh, kata "dog" dan "bone" lebih mungkin muncul dalam dokumen tentang anjing, sedangkan "cat" dan "meow" lebih mungkin ditemukan dalam dokumen tentang kucing. Konsekuensinya, model topik akan memindai dokumen dan menghasilkan klaster kata-kata serupa.
Pada dasarnya, model topik bekerja dengan menyimpulkan kata-kata dan mengelompokkan yang serupa ke dalam topik untuk membuat klaster topik.
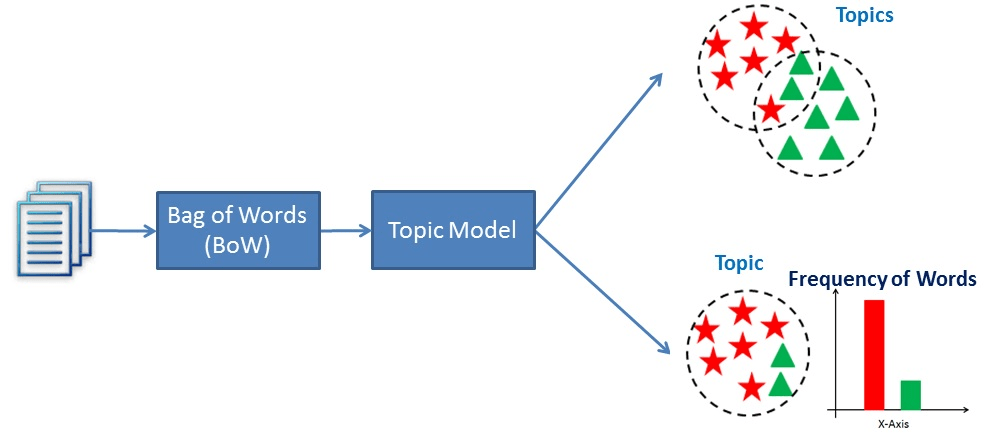
Visualisasi cara kerja topic modeling
Dua teknik topic modeling yang populer adalah Latent Semantic Analysis (LSA) dan Latent Dirichlet Allocation (LDA). Tujuan keduanya sama, yaitu menemukan pola semantik tersembunyi yang ditampilkan oleh data teks, tetapi cara mencapainya berbeda.
Latent Semantic Analysis (LSA) adalah teknik pemrosesan bahasa alami yang digunakan untuk menganalisis hubungan antara dokumen dan istilah yang dikandungnya. Metode ini pertama kali diperkenalkan dalam makalah tahun 1988 berjudul “Using Latent Semantic Analysis to Improve Access to Textual Information” dan masih digunakan hingga kini untuk membuat data terstruktur dari kumpulan teks tidak terstruktur.
Secara khusus, LSA mengasumsikan kata-kata dengan makna serupa akan muncul dalam dokumen yang serupa. Caranya dengan membangun matriks yang berisi jumlah kemunculan kata per dokumen, di mana setiap baris mewakili kata unik, dan kolom mewakili setiap dokumen, kemudian menggunakan Singular Value Decomposition (SVD) untuk mengurangi jumlah baris sambil mempertahankan struktur kemiripan antar kolom. SVD adalah metode matematis yang menyederhanakan data sekaligus menjaga fitur pentingnya. Di sini, SVD digunakan untuk mempertahankan hubungan antara kata dan dokumen.
Untuk menentukan kemiripan antar dokumen, digunakan cosine similarity. Ini adalah ukuran yang menghitung kosinus sudut antara dua vektor, dalam hal ini mewakili dokumen. Nilai yang mendekati 1 berarti dokumen sangat mirip berdasarkan kata-katanya, sedangkan nilai yang mendekati 0 berarti cukup berbeda.
Latent Dirichlet Allocation (LDA) awalnya diusulkan pada tahun 2000 dalam makalah berjudul “Inference of population structure using multilocus genotype data.” Makalah tersebut terutama berfokus pada genetika populasi, subbidang genetika yang menelaah perbedaan genetik di dalam dan antar populasi. Tiga tahun kemudian, Latent Dirichlet Allocation diterapkan dalam pembelajaran mesin.
Para penulis makalah menggambarkan teknik ini sebagai “model generatif untuk teks dan koleksi data diskret lainnya.” Dengan demikian, LDA dapat dijelaskan sebagai teknik pemrosesan bahasa alami yang digunakan untuk mengidentifikasi topik yang menjadi cakupan sebuah dokumen berdasarkan kata-kata yang dikandungnya.
Lebih khususnya, LDA adalah jaringan Bayesian, artinya ini adalah model statistik generatif yang mengasumsikan dokumen tersusun dari kata-kata yang membantu menentukan topik. Dengan demikian, dokumen dipetakan ke daftar topik dengan menetapkan setiap kata dalam dokumen ke berbagai topik. Model ini mengabaikan urutan kata dalam dokumen dan memperlakukannya sebagai bag of words.
Latent Semantic Analysis (LSA) dan Latent Dirichlet Allocation (LDA) keduanya merupakan teknik pemrosesan bahasa alami yang digunakan untuk membuat data terstruktur dari kumpulan teks tidak terstruktur.
Namun, LSA memanfaatkan Singular Value Decomposition (SVD) untuk mengurangi dimensi matriks istilah-dokumen dan didasarkan pada asumsi bahwa kata-kata dengan makna serupa akan muncul dalam dokumen yang serupa. Dengan membuat representasi teks berdimensi lebih rendah, model dapat menangkap hubungan mendasar antar kata untuk menentukan seberapa mirip dua dokumen.
Sebaliknya, LDA adalah model probabilistik generatif yang memanfaatkan inferensi Bayesian untuk menemukan topik-topik mendasar dalam sebuah korpus teks. Ia mengasumsikan setiap dokumen merupakan kombinasi dari sejumlah kecil topik laten, dan setiap kata dihasilkan oleh topik tertentu.
Pada akhirnya, LSA berupaya menemukan hubungan mendasar antar kata, sedangkan LDA berupaya menemukan topik-topik mendasar dalam sebuah korpus teks. Meski keduanya digunakan untuk membuat representasi vektor dari teks, asumsi yang mendasarinya berbeda.
Mari lihat bagaimana teknik-teknik ini bekerja. Gunakan buku kerja DataLab ini untuk mengikuti kodenya.
Hal pertama yang kita butuhkan adalah data.
Untuk topic modeling, data yang kita gunakan disebut korpus, yaitu sekumpulan teks.
Berikut korpus kecil yang saya buat menggunakan fakta dari internet:
# Creating example documents
doc_1 = "A whopping 96.5 percent of water on Earth is in our oceans, covering 71 percent of the surface of our planet. And at any given time, about 0.001 percent is floating above us in the atmosphere. If all of that water fell as rain at once, the whole planet would get about 1 inch of rain."

doc_2 = "One-third of your life is spent sleeping. Sleeping 7-9 hours each night should help your body heal itself, activate the immune system, and give your heart a break. Beyond that--sleep experts are still trying to learn more about what happens once we fall asleep."

doc_3 = "A newborn baby is 78 percent water. Adults are 55-60 percent water. Water is involved in just about everything our body does."

doc_4 = "While still in high school, a student went 264.4 hours without sleep, for which he won first place in the 10th Annual Great San Diego Science Fair in 1964."

doc_5 = "We experience water in all three states: solid ice, liquid water, and gas water vapor."

# Create corpus
corpus = [doc_1, doc_2, doc_3, doc_4, doc_5]Langkah selanjutnya adalah membersihkan teks:
# Code source: https://www.analyticsvidhya.com/blog/2016/08/beginners-guide-to-topic-modeling-in-python/

import string
import nltk
nltk.download('stopwords')
nltk.download('wordnet')
nltk.download('omw-1.4')
from nltk.corpus import stopwords
from nltk.stem.wordnet import WordNetLemmatizer

# remove stopwords, punctuation, and normalize the corpus
stop = set(stopwords.words('english'))
exclude = set(string.punctuation)
lemma = WordNetLemmatizer()

def clean(doc):
    stop_free = " ".join([i for i in doc.lower().split() if i not in stop])
    punc_free = "".join(ch for ch in stop_free if ch not in exclude)
    normalized = " ".join(lemma.lemmatize(word) for word in punc_free.split())
    return normalized

clean_corpus = [clean(doc).split() for doc in corpus]
Pada kode di atas kita:
Namun ini masih belum berarti kita siap.
Sebelum kita dapat menggunakan data ini sebagai masukan ke model LDA atau LSA, data harus diubah menjadi matriks istilah-dokumen (term-document matrix). Matriks istilah-dokumen hanyalah representasi matematis dari sekumpulan dokumen dan istilah yang dikandungnya.
Matriks ini dibuat dengan menghitung kemunculan setiap istilah di tiap dokumen lalu menormalkan hitungan tersebut untuk membuat matriks nilai yang dapat digunakan untuk analisis.
Untuk melakukan ini di Python, kita akan memanfaatkan pustaka Gensim.
from gensim import corpora

# Creating document-term matrix
dictionary = corpora.Dictionary(clean_corpus)
doc_term_matrix = [dictionary.doc2bow(doc) for doc in clean_corpus]
Sekarang, kita bisa memasangkan model kita.
Model pertama yang akan kita gunakan adalah LSA:
from gensim.models import LsiModel

# LSA model
lsa = LsiModel(doc_term_matrix, num_topics=3, id2word = dictionary)

# LSA model
print(lsa.print_topics(num_topics=3, num_words=3))

"""
[
(0, '0.555*"water" + 0.489*"percent" + 0.239*"planet"'),
(1, '0.361*"sleeping" + 0.215*"hour" + 0.215*"still"'),
(2, '-0.562*"water" + 0.231*"rain" + 0.231*"planet"')
]
"""
Ini menghasilkan keluaran topik (setiap baris) dengan istilah topik individual (terms) dan bobotnya.
Mari coba dengan LDA:
from gensim.models import LdaModel

# LDA model
lda = LdaModel(doc_term_matrix, num_topics=3, id2word = dictionary)

# Results
print(lda.print_topics(num_topics=3, num_words=3))

"""
[
(0, '0.071*"water" + 0.025*"state" + 0.025*"three"'),
(1, '0.030*"still" + 0.028*"hour" + 0.026*"sleeping"'),
(2, '0.073*"percent" + 0.069*"water" + 0.031*"rain"')
]
"""Dengan menghilangkan tugas manual dan berulang, topic modeling dapat dengan mudah dan hemat biaya mempercepat proses secara sederhana. Berikut beberapa contohnya:
Topic modeling dapat digunakan untuk membantu staf layanan pelanggan menganalisis pertanyaan dukungan guna mengidentifikasi masalah utama dan menentukan mana yang berulang. Berdasarkan data tersebut, mereka dapat membuat konten swalayang lebih informatif atau membantu pelanggan secara langsung.
Topic modeling dapat digunakan untuk memberi tag pada percakapan sehingga dapat diarahkan ke tim yang paling sesuai. Misalnya, percakapan yang memuat kata-kata seperti “pricing,” “subscription,” “renewal,” dan sebagainya dapat langsung dikirim ke departemen akuntansi untuk dukungan.
Topic modeling digunakan untuk menemukan topik laten yang ada dalam kumpulan dokumen. Ini melibatkan pengenalan pola pada kata dan frasa yang muncul dalam dokumen serta mengelompokkannya menjadi topik berdasarkan tingkat kemiripannya.
Sebaliknya, clustering adalah teknik untuk mengelompokkan objek serupa berdasarkan ukuran kemiripan. Metode seperti ini digunakan untuk menemukan pola dan struktur dalam data dengan mengelompokkan titik data yang serupa.
Walaupun keduanya dapat mengungkap pola dalam data teks, tujuan keduanya berbeda. Topic modeling berfokus pada identifikasi topik laten dalam kumpulan dokumen, sedangkan clustering berfokus pada pengelompokan titik data yang serupa.
Klasifikasi teks, meskipun merupakan teknik pemrosesan bahasa alami, termasuk dalam kategori pembelajaran terawasi. Artinya, klasifikasi teks digunakan untuk memberi label kategori yang telah ditentukan sebelumnya pada suatu potongan teks. Agar model dapat melakukan hal ini, model harus terlebih dahulu belajar dari himpunan data berlabel sebelum dapat digunakan untuk membuat prediksi pada sampel teks baru yang belum pernah dilihat.
Di sisi lain, topic modeling adalah teknik pembelajaran tanpa pengawasan yang digunakan untuk menemukan topik-topik mendasar dalam kumpulan dokumen teks. Ini berarti tidak perlu belajar dari himpunan data berlabel.
Dengan demikian, perbedaan antara keduanya adalah klasifikasi teks digunakan untuk menetapkan label yang telah ditentukan pada teks, sedangkan topic modeling menemukan topik-topik mendasar dalam kumpulan dokumen.
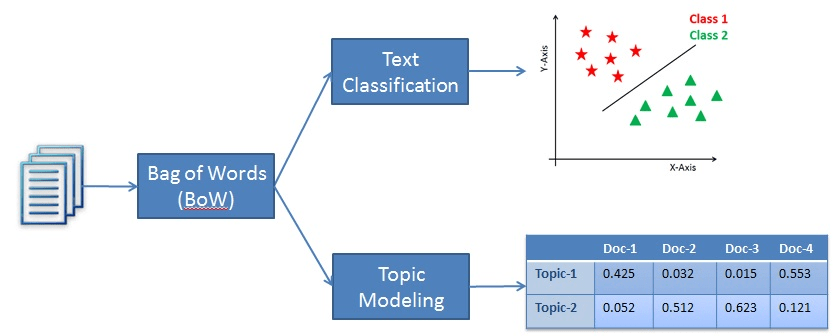
Contoh klasifikasi vs topic modeling
Topic modeling adalah teknik pemrosesan bahasa alami yang populer untuk membuat data terstruktur dari kumpulan data tidak terstruktur. Dengan kata lain, teknik ini memungkinkan bisnis mempelajari pola semantik tersembunyi yang ditampilkan oleh korpus teks dan secara otomatis mengidentifikasi topik yang ada di dalamnya.
Dua pendekatan topic modeling yang populer adalah LSA dan LDA. Keduanya berupaya menemukan pola tersembunyi dalam data teks, tetapi membuat asumsi yang berbeda untuk mencapai tujuannya. LSA mengasumsikan kata-kata dengan makna serupa akan muncul dalam dokumen yang serupa, sedangkan LDA mengasumsikan dokumen tersusun dari kata-kata yang membantu menentukan topik.
Dalam tutorial ini, kami telah membahas konsep inti topic modeling, implementasi praktis, dan bagaimana topic modeling berbeda dari teknik lain seperti klasifikasi teks dan clustering. Untuk melanjutkan pembelajaran Anda, lihat beberapa sumber daya kami lainnya:
Mulai Perjalanan Topic Modeling Anda Hari Ini!
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



