

Konu Modelleme Nedir?
Konu modelleme, bir metin korpusunun sergilediği gizli anlamsal örüntüleri ortaya çıkarmak ve içinde yer alan konuları otomatik olarak belirlemek için sıkça kullanılan bir yaklaşımdır.
Başka bir deyişle, bir metin gövdesindeki benzer kelimelerden oluşan kümeleri veya grupları analiz etmek ve tanımlamak için denetimsiz makine öğreniminden yararlanan bir tür istatistiksel modellemedir.
Örneğin, bir konu modelleme algoritması, bir belgenin içeriğinin bunun bir fatura, şikayet veya sözleşme olup olmadığını ima edip etmediğini belirlemek için devreye alınabilir.
İş dünyasında konu modellemenin rolü
Bazı kaynaklara göre, ortalama bir insan saniyede 1,7 MB'den fazla dijital veri üretiyor. Bu sayı günde 2,5 kentilyon bayttan fazlaya denk geliyor ve bunun %80-90'ı yapılandırılmamış.
Bir işletmenin, her bir yapılandırılmamış veri parçasını gözden geçirip alttaki konuya göre bölümlendirmek için tek bir kişiyi görevlendirdiği bir senaryoyu düşünün. Bu imkansız bir görev olurdu.
Tamamlanması çok uzun sürer ve son derece sıkıcı olurdu; ayrıca insanlar doğası gereği önyargılı ve makinelere göre daha hata yapmaya yatkın olduğundan risk daha yüksektir.
Çözüm konu modellemedir.
Konu modelleme ile verilerden daha hızlı ve muhtemelen daha iyi içgörüler elde edilebilir. Bu teknik, konuları anlaşılır bir yapıda bir araya getirerek işletmelerin olup biteni hızla kavramasını sağlar.
Örneğin, müşterilerin en büyük zorluklarını anlamak isteyen bir işletme, bu bilgiyi yapılandırılmamış veriler üzerinden öğrenmek için konu modellemeden yararlanabilir.
Kısacası, konu modelleme işletmelere şunlarda yardımcı olur:
- Yapılandırılmamış metin verileri üzerinde gerçek zamanlı analiz yapmak
- Yapılandırılmamış verilerden ölçekli olarak öğrenmek
- Biçimi ne olursa olsun veriye ilişkin tutarlı bir anlayış oluşturmak.
Konu Modellemenin Temel Kavramları
Konu modellemenin, veri profesyonellerinin büyük ölçekte bir metin gövdesindeki benzer kelimelerden oluşan kümeleri hızla analiz edip tanımlamasını sağladığını belirledik.
Peki konular nedir ve konu modelleme nasıl çalışır?
Konular nedir ve konu modelleri nasıl çalışır?
Konular, bir metin korpusunun (büyük bir grup) örtük açıklamalarıdır. Sezgisel olarak, belirli bir konuyla ilgili belgelerin belirli kelimeleri daha sık üretmesi daha olasıdır.
Örneğin, “dog” ve “bone” kelimeleri köpeklerle ilgili belgelerde daha olasıyken, “cat” ve “meow” kedilerle ilgili belgelerde daha olasıdır. Sonuç olarak konu modeli belgeleri tarar ve benzer kelimelerden oluşan kümeler üretir.
Özünde, konu modelleri kelimeleri çıkarır ve benzer olanları konular altında gruplayarak konu kümeleri oluşturur.
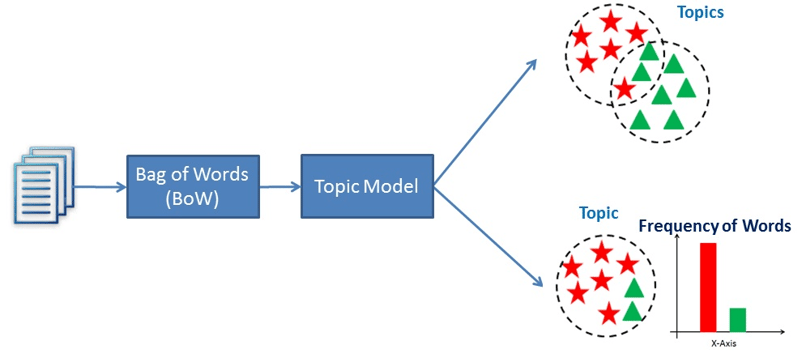
Konu modellemenin nasıl çalıştığını gösteren bir görselleştirme
Konu Modelleme Tekniklerini Keşfetme
İki popüler konu modelleme tekniği Gizli Anlamsal Analiz (LSA) ve Gizli Dirichlet Ayrımı (LDA)'dır. Metin verilerinin sergilediği gizli anlamsal örüntüleri keşfetme hedefleri aynıdır; ancak bunu başarma yolları farklıdır.
Gizli Anlamsal Analiz (LSA)
Gizli Anlamsal Analiz (LSA), belgeler ile içerdiği terimler arasındaki ilişkileri analiz etmek için kullanılan bir doğal dil işleme tekniğidir. Yöntem ilk olarak 1988 tarihli “Using Latent Semantic Analysis to Improve Access to Textual Information” başlıklı bir makalede tanıtıldı ve bugün de yapılandırılmamış metin koleksiyonlarından yapılandırılmış veri oluşturmak için kullanılıyor.
Özellikle, LSA benzer anlamlara sahip kelimelerin benzer belgelerde görüneceği varsayımına dayanır. Bunu, her satırın benzersiz bir kelimeyi, sütunların her bir belgenin kendisini temsil ettiği kelime sayımlarını içeren bir matris oluşturarak ve ardından Tekil Değer Ayrışımı (SVD) kullanarak satır sayısını azaltırken sütunlar arasındaki benzerlik yapısını koruyarak yapar. SVD, verileri önemli özelliklerini koruyarak basitleştiren matematiksel bir yöntemdir. Burada kelimeler ile belgeler arasındaki ilişkileri muhafaza etmek için kullanılır.
Belgeler arasındaki benzerliği belirlemek için kosinüs benzerliği kullanılır. Bu, iki vektör arasındaki açının kosinüsünü hesaplayan bir ölçüdür; burada vektörler belgeleri temsil eder. 1'e yakın bir değer, belgelerin içerdikleri kelimelere göre çok benzer olduğu; 0'a yakın bir değer ise oldukça farklı olduğu anlamına gelir.
Gizli Dirichlet Ayrımı (LDA)
Gizli Dirichlet Ayrımı (LDA) ilk olarak 2000 yılında “Inference of population structure using multilocus genotype data.” başlıklı bir makalede önerildi. Makale ağırlıklı olarak popülasyon genetiğine odaklanıyordu; bu alan, popülasyonlar içindeki ve arasındaki genetik farklılıklarla ilgilenen genetiğin bir alt dalıdır. Üç yıl sonra, Gizli Dirichlet Ayrımı makine öğreniminde uygulandı.
Makalenin yazarları tekniği “metin ve diğer ayrık veri koleksiyonları için üretken bir model” olarak tanımlar. Dolayısıyla LDA, bir belgenin içinde yer alan kelimelere dayanarak o belgenin hangi konulara ait olduğunu belirlemek için kullanılan bir doğal dil tekniği olarak nitelenebilir.
Daha spesifik olarak, LDA bir Bayesçi ağdır; yani, belgelerin konuları belirlemeye yardımcı olan kelimelerden oluştuğunu varsayan üretken bir istatistiksel modeldir. Bu nedenle belgeler, belgedeki her kelimenin farklı konulara atanmasıyla bir konu listesine eşlenir. Bu model, bir belgedeki kelimelerin sırasını yok sayar ve onları bir kelime torbası (bag of words) olarak ele alır.
LSA ve LDA Karşılaştırması
Gizli Anlamsal Analiz (LSA) ve Gizli Dirichlet Ayrımı (LDA), yapılandırılmamış metin koleksiyonlarından yapılandırılmış veri oluşturmak için kullanılan doğal dil işleme teknikleridir.
Ancak LSA, terim-belge matrisinin boyutunu azaltmak için Tekil Değer Ayrışımı'ndan (SVD) yararlanır ve benzer anlamlara sahip kelimelerin benzer belgelerde görüneceği varsayımına dayanır. Metnin daha düşük boyutlu bir temsili oluşturularak model, iki belgenin ne kadar benzer olduğunu belirlemek için kelimeler arasındaki altta yatan ilişkileri yakalayabilir.
Buna karşılık, LDA bir metin korpusundaki altta yatan konuları bulmak için Bayesçi çıkarımdan yararlanan üretken olasılıksal bir modeldir. Her belgenin az sayıda örtük konunun bir birleşimi olduğunu ve her kelimenin belirli bir konu tarafından üretildiğini varsayar.
Özetle, LSA kelimeler arasındaki altta yatan ilişkileri keşfetmeye çalışırken LDA bir metin korpusundaki altta yatan konuları keşfetmeyi amaçlar. Her ikisi de metnin vektör temsillerini oluşturmak için kullanılan teknikler olsa da farklı varsayımlar yaparlar.
Konu Modellemenin Pratik Uygulaması
Bu tekniklerin nasıl çalıştığını görelim. Koda adım adım eşlik etmek için bu DataLab çalışma kitabını kullanın.
Veri hazırlama
İlk ihtiyacımız olan şey veridir.
Konu modelleme için kullandığımız verilere korpus denir; bu, basitçe bir metin koleksiyonudur.
İnternetten derlediğim bazı gerçeklerle oluşturduğum küçük bir korpus şöyle:
# Creating example documents
doc_1 = "A whopping 96.5 percent of water on Earth is in our oceans, covering 71 percent of the surface of our planet. And at any given time, about 0.001 percent is floating above us in the atmosphere. If all of that water fell as rain at once, the whole planet would get about 1 inch of rain."
doc_2 = "One-third of your life is spent sleeping. Sleeping 7-9 hours each night should help your body heal itself, activate the immune system, and give your heart a break. Beyond that--sleep experts are still trying to learn more about what happens once we fall asleep."
doc_3 = "A newborn baby is 78 percent water. Adults are 55-60 percent water. Water is involved in just about everything our body does."
doc_4 = "While still in high school, a student went 264.4 hours without sleep, for which he won first place in the 10th Annual Great San Diego Science Fair in 1964."
doc_5 = "We experience water in all three states: solid ice, liquid water, and gas water vapor."
# Create corpus
corpus = [doc_1, doc_2, doc_3, doc_4, doc_5]Önişleme
Sıradaki adım metni temizlemektir:
# Code source: https://www.analyticsvidhya.com/blog/2016/08/beginners-guide-to-topic-modeling-in-python/
import string
import nltk
nltk.download('stopwords')
nltk.download('wordnet')
nltk.download('omw-1.4')
from nltk.corpus import stopwords
from nltk.stem.wordnet import WordNetLemmatizer
# remove stopwords, punctuation, and normalize the corpus
stop = set(stopwords.words('english'))
exclude = set(string.punctuation)
lemma = WordNetLemmatizer()
def clean(doc):
stop_free = " ".join([i for i in doc.lower().split() if i not in stop])
punc_free = "".join(ch for ch in stop_free if ch not in exclude)
normalized = " ".join(lemma.lemmatize(word) for word in punc_free.split())
return normalized
clean_corpus = [clean(doc).split() for doc in corpus]Yukarıdaki kodda şunları yaptık:
- Gerekli kütüphaneleri içe aktardık ve durdurma kelimeleri (stopwords) ile wordnet'i indirdik
- İngilizce durdurma kelimelerini tanımladık
- Dışlamak istediğimiz noktalama işaretlerinin kümesini oluşturduk
- WordNet kök bulucu (lemmatizer) örneğini oluşturduk
- Durdurma kelimelerini ve noktalama işaretlerini kaldırmak ve belgeleri kök forma indirgemek için bir fonksiyon yazdık.
- Korpusteki her belgeye clean fonksiyonunu uyguladık.
Ancak bu yine de hazır olduğumuz anlamına gelmiyor.
Bu verileri bir LDA veya LSA modeline girdi olarak kullanmadan önce, terim-belge matrisine dönüştürülmesi gerekir. Terim-belge matrisi, bir dizi belge ile bu belgelerde yer alan terimlerin matematiksel bir temsilidir.
Her bir belgedeki her terimin görülme sıklığı sayılarak oluşturulur ve ardından bu sayımlar analiz için kullanılabilecek bir değerler matrisi oluşturmak üzere normalize edilir.
Bunu Python'da yapmak için Gensim kütüphanesinden yararlanacağız.
from gensim import corpora
# Creating document-term matrix
dictionary = corpora.Dictionary(clean_corpus)
doc_term_matrix = [dictionary.doc2bow(doc) for doc in clean_corpus]Artık modellerimizi eğitebiliriz.
Modelleme
Kullanacağımız ilk model LSA olacak:
from gensim.models import LsiModel
# LSA model
lsa = LsiModel(doc_term_matrix, num_topics=3, id2word = dictionary)
# LSA model
print(lsa.print_topics(num_topics=3, num_words=3))
"""
[
(0, '0.555*"water" + 0.489*"percent" + 0.239*"planet"'),
(1, '0.361*"sleeping" + 0.215*"hour" + 0.215*"still"'),
(2, '-0.562*"water" + 0.231*"rain" + 0.231*"planet"')
]
"""Bu çıktı, konuları (her satır) içlerindeki bireysel konu terimleri (terimler) ve ağırlıklarıyla birlikte verir.
Şimdi de LDA ile deneyelim:
from gensim.models import LdaModel
# LDA model
lda = LdaModel(doc_term_matrix, num_topics=3, id2word = dictionary)
# Results
print(lda.print_topics(num_topics=3, num_words=3))
"""
[
(0, '0.071*"water" + 0.025*"state" + 0.025*"three"'),
(1, '0.030*"still" + 0.028*"hour" + 0.026*"sleeping"'),
(2, '0.073*"percent" + 0.069*"water" + 0.031*"rain"')
]
"""Konu Modelleme Ne İçin Kullanılır?
Manuel ve tekrarlayan görevleri ortadan kaldırarak, konu modelleme süreçleri kolayca ve düşük maliyetle hızlandırabilir. İşte birkaç örnek:
Destek taleplerini etiketleme
Konu modelleme, müşteri hizmetleri ekiplerinin destek taleplerini analiz ederek başlıca sorunları belirlemesine ve tekrar edenleri tespit etmesine yardımcı olmak için kullanılabilir. Bu verilere dayanarak daha bilgilendirici self-servis içerikler oluşturabilir veya müşterilere doğrudan yardımcı olabilirler.
Müşteri deneyimini iyileştirme
Konu modelleme, konuşmaları etiketlemek ve en uygun ekibe yönlendirmek için kullanılabilir. Örneğin, “pricing”, “subscription”, “renewal” gibi kelimeler içeren bir konuşma doğrudan destek için muhasebe departmanına gönderilebilir.
Konu Modelleme ve Diğer Teknikler
Konu modelleme ve kümeleme
Konu modelleme, bir belge koleksiyonu içinde var olan örtük konuları keşfetmek için kullanılır. Bu, belgelerde görülen kelime ve ifadelerdeki örüntüleri tanımlamayı ve benzerliklerine göre bunları konular altında gruplamayı içerir.
Buna karşılık, kümeleme benzer nesneleri bir benzerlik ölçütüne göre gruplamak için kullanılan bir tekniktir. Bu yöntemler, benzer veri noktalarını bir araya getirerek verideki örüntüleri ve yapıyı keşfetmek için kullanılır.
Her iki yaklaşım da metin verilerinde örüntüler ortaya çıkarabilse de amaçları farklıdır. Konu modelleme bir belge koleksiyonundaki örtük konuları belirlemeyle ilgilenirken, kümeleme benzer veri noktalarını bir araya getirmekle ilgilenir.
Konu modelleme ve metin sınıflandırma
Metin sınıflandırma bir doğal dil işleme tekniği olmakla birlikte denetimli öğrenme kategorisine girer. Yani metin sınıflandırma, önceden tanımlı kategorileri bir metin parçasına etiketlemek için kullanılır. Modelin bunu başarabilmesi için önce etiketli bir veri setinden öğrenmesi, ardından yeni ve görülmemiş metin örnekleri üzerinde tahminler yapması gerekir.
Öte yandan, konu modelleme bir metin belge koleksiyonundaki altta yatan konuları bulmak için kullanılan denetimsiz bir öğrenme tekniğidir. Bu, etiketli bir veri setinden öğrenmek zorunda olmadığı anlamına gelir.
Dolayısıyla iki yöntem arasındaki fark şudur: Metin sınıflandırma, metne önceden tanımlı etiketler atamak için kullanılırken, konu modelleme bir belge koleksiyonundaki altta yatan konuları keşfeder.
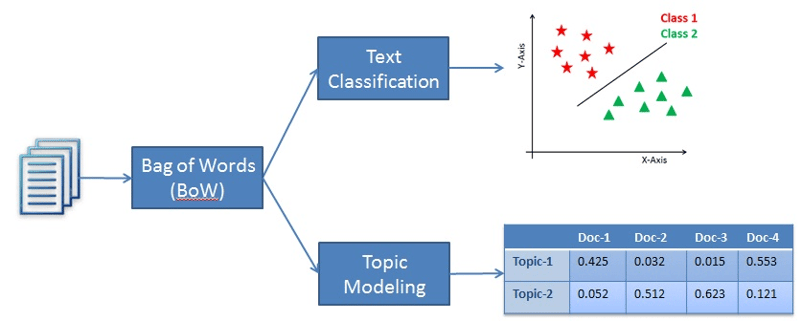
Sınıflandırma ve konu modelleme örneği
Sonuç
Konu modelleme, yapılandırılmamış bir veri koleksiyonundan yapılandırılmış veri oluşturmak için kullanılan popüler bir doğal dil işleme tekniğidir. Başka bir deyişle, bu teknik işletmelerin bir metin korpusunun sergilediği gizli anlamsal örüntüleri öğrenmesini ve içinde yer alan konuları otomatik olarak belirlemesini sağlar.
İki popüler konu modelleme yaklaşımı LSA ve LDA'dır. Her ikisi de metin verilerindeki gizli örüntüleri keşfetmeyi amaçlar; ancak hedeflerine ulaşmak için farklı varsayımlar yaparlar. LSA, benzer anlamlara sahip kelimelerin benzer belgelerde görüneceğini varsayarken; LDA, belgelerin konuları belirlemeye yardımcı olan kelimelerden oluştuğunu varsayar.
Bu eğitimde konu modellemenin temel kavramlarını, pratik bir uygulamasını ve metin sınıflandırma ile kümeleme gibi diğer tekniklerden nasıl ayrıldığını ele aldık. Öğrenmeye devam etmek için şu kaynaklarımıza göz atın:




Analitiğin amacı, verilerden içgörüler çıkarmaktır. Geleneksel olarak bu veriler yapılandırılmıştır; yani verimliliği artırmak için standartlaştırılmış bir biçimdedir. Dünya dijitalleştikçe üretilen verilerin büyük kısmı yapılandırılmamış hale geliyor; yani önceden tanımlı bir veri modeli yok.
Gartner'a göre, yapılandırılmamış veriler tüm yeni kurumsal verilerin %80-90'ını oluşturuyor. Ayrıca yapılandırılmış verilerden üç kat daha hızlı büyüyor. Sonuç olarak, analitik uzmanları veri kümelerinden ilgili bilgileri elde etmek için yeni teknikler kullanmak zorunda.
Bu tekniklerden biri, metin madenciliği alanından konu modellemedir. Bu makalenin devamında şunları ele alacağız: