
Corso
Introduzione all'analisi del testo in R
4 ore
27.3K
Il topic modeling è un approccio spesso utilizzato per scoprire pattern semantici nascosti rappresentati da un corpus di testo e identificare automaticamente i topic al suo interno.
In particolare, è un tipo di modellazione statistica che sfrutta l'apprendimento automatico non supervisionato per analizzare e identificare cluster o gruppi di parole simili all'interno di un testo.
Per esempio, un algoritmo di topic modeling può essere utilizzato per determinare se il contenuto di un documento implica che si tratti di una fattura, un reclamo o un contratto.
Secondo alcune fonti, una persona media genera oltre 1,7 MB di dati digitali al secondo. Questo numero ammonta a più di 2,5 trilioni di byte di dati al giorno, di cui l'80-90% è non strutturato.
Immagina uno scenario in cui un'azienda impiega una sola persona per esaminare ogni pezzo di dato non strutturato e segmentarlo in base al topic sottostante. Sarebbe un compito impossibile.
Richiederebbe moltissimo tempo ed è estremamente noioso; inoltre comporta più rischi, perché gli esseri umani sono naturalmente soggetti a bias e più inclini all'errore rispetto alle macchine.
La soluzione è il topic modeling.
Con il topic modeling, gli insight dai dati possono essere ricavati in modo più rapido e, possibilmente, migliore. Questa tecnica combina i topic in una struttura comprensibile, permettendo alle aziende di capire rapidamente cosa sta succedendo.
Per esempio, un'azienda che vuole capire le sfide principali dei clienti può utilizzare il topic modeling per ricavare queste informazioni dai dati non strutturati.
In breve, il topic modeling aiuta le aziende a:
Abbiamo stabilito che il topic modeling consente ai professionisti dei dati di analizzare rapidamente e identificare su larga scala cluster o gruppi di parole simili all'interno di un testo.
Ma cosa sono i topic e come funziona il topic modeling?
I topic sono descrizioni latenti di un corpus (un grande insieme) di testi. Intuitivamente, i documenti relativi a un topic specifico tenderanno a produrre certe parole con maggiore frequenza.
Per esempio, le parole "dog" e "bone" è più probabile che compaiano in documenti riguardanti i cani, mentre "cat" e "meow" è più probabile compaiano in documenti sui gatti. Di conseguenza, il topic model scandirebbe i documenti e produrrebbe cluster di parole simili.
In sostanza, i topic model deducono le parole e raggruppano quelle simili in topic per creare cluster di topic.
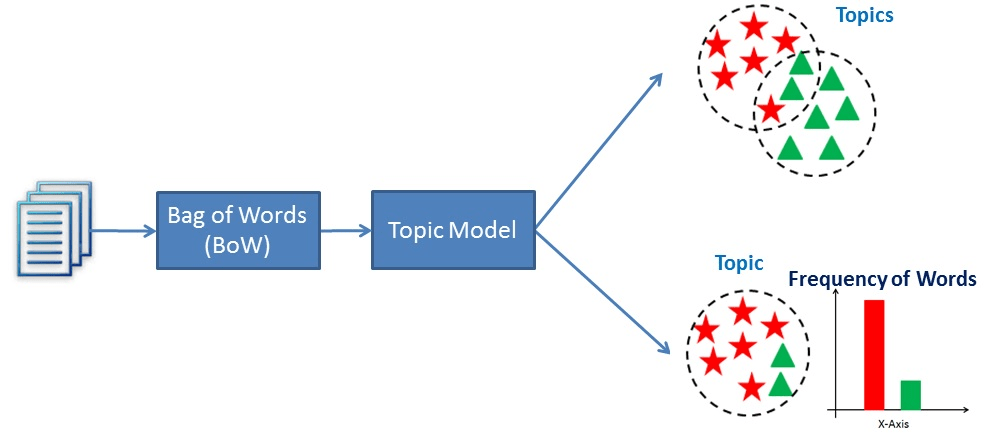
Una visualizzazione di come funziona il topic modeling
Due tecniche popolari di topic modeling sono la Latent Semantic Analysis (LSA) e la Latent Dirichlet Allocation (LDA). Il loro obiettivo di scoprire pattern semantici nascosti rappresentati dai dati testuali è lo stesso, ma il modo in cui lo raggiungono è diverso.
Latent Semantic Analysis (LSA) è una tecnica di elaborazione del linguaggio naturale utilizzata per analizzare le relazioni tra i documenti e i termini che contengono. Il metodo è stato introdotto per la prima volta in un articolo del 1988 intitolato “Using Latent Semantic Analysis to Improve Access to Textual Information” ed è tuttora usato per creare dati strutturati a partire da una raccolta di testi non strutturati.
In particolare, LSA assume che parole con significati simili compaiano in documenti simili. Lo fa costruendo una matrice contenente i conteggi delle parole per documento, in cui ogni riga rappresenta una parola univoca e le colonne rappresentano ciascun documento, per poi utilizzare una Decomposizione ai Valori Singolari (SVD) per ridurre il numero di righe preservando la struttura di similarità tra le colonne. La SVD è un metodo matematico che semplifica i dati mantenendone le caratteristiche importanti. Qui viene usata per mantenere le relazioni tra parole e documenti.
Per determinare la similarità tra documenti, si usa la similarità del coseno. È una misura che calcola il coseno dell'angolo tra due vettori, in questo caso rappresentanti i documenti. Un valore vicino a 1 significa che i documenti sono molto simili in base alle parole che contengono, mentre un valore vicino a 0 significa che sono piuttosto diversi.
La Latent Dirichlet Allocation (LDA) è stata proposta inizialmente nel 2000 in un articolo intitolato “Inference of population structure using multilocus genotype data.” L'articolo si concentrava prevalentemente sulla genetica delle popolazioni, un sottocampo della genetica che studia le differenze genetiche all'interno e tra le popolazioni. Tre anni dopo, la Latent Dirichlet Allocation è stata applicata al machine learning.
Gli autori dell'articolo descrivono la tecnica come “un modello generativo per testi e altre collezioni di dati discreti.” Pertanto, LDA può essere descritta come una tecnica di elaborazione del linguaggio naturale utilizzata per identificare i topic a cui appartiene un documento in base alle parole che contiene.
Più nello specifico, LDA è una rete bayesiana, cioè un modello statistico generativo che assume che i documenti siano composti da parole che aiutano a determinare i topic. Così, i documenti vengono mappati a un elenco di topic assegnando ogni parola del documento a diversi topic. Questo modello ignora l'ordine delle parole in un documento e le tratta come un bag of words.
Latent Semantic Analysis (LSA) e Latent Dirichlet Allocation (LDA) sono entrambe tecniche di elaborazione del linguaggio naturale utilizzate per creare dati strutturati a partire da una raccolta di testi non strutturati.
Tuttavia, LSA sfrutta la Decomposizione ai Valori Singolari (SVD) per ridurre la dimensionalità della matrice termine-documento ed è basata sull'assunzione che parole con significati simili compaiano in documenti simili. Creando una rappresentazione a dimensionalità inferiore del testo, il modello può catturare le relazioni sottostanti tra le parole per determinare quanto due documenti siano simili.
Al contrario, LDA è un modello probabilistico generativo che sfrutta l'inferenza bayesiana per trovare i topic sottostanti in un corpus di testi. Assume che ogni documento sia una combinazione di un piccolo numero di topic latenti e che ogni parola sia generata da un particolare topic.
In definitiva, LSA cerca di scoprire le relazioni sottostanti tra le parole, mentre LDA mira a scoprire i topic sottostanti in un corpus di testi. Sebbene entrambe siano tecniche utilizzate per creare una rappresentazione vettoriale del testo, muovono da assunzioni differenti.
Vediamo come funzionano queste tecniche. Usa questo workbook DataLab per seguire il codice.
La prima cosa di cui abbiamo bisogno sono i dati.
Per il topic modeling, i dati che usiamo si chiamano corpus, cioè una raccolta di testi.
Ecco un piccolo corpus che ho creato usando fatti trovati su internet:
# Creating example documents
doc_1 = "A whopping 96.5 percent of water on Earth is in our oceans, covering 71 percent of the surface of our planet. And at any given time, about 0.001 percent is floating above us in the atmosphere. If all of that water fell as rain at once, the whole planet would get about 1 inch of rain."

doc_2 = "One-third of your life is spent sleeping. Sleeping 7-9 hours each night should help your body heal itself, activate the immune system, and give your heart a break. Beyond that--sleep experts are still trying to learn more about what happens once we fall asleep."

doc_3 = "A newborn baby is 78 percent water. Adults are 55-60 percent water. Water is involved in just about everything our body does."

doc_4 = "While still in high school, a student went 264.4 hours without sleep, for which he won first place in the 10th Annual Great San Diego Science Fair in 1964."

doc_5 = "We experience water in all three states: solid ice, liquid water, and gas water vapor."

# Create corpus
corpus = [doc_1, doc_2, doc_3, doc_4, doc_5]Il passo successivo è pulire il testo:
# Code source: https://www.analyticsvidhya.com/blog/2016/08/beginners-guide-to-topic-modeling-in-python/

import string
import nltk
nltk.download('stopwords')
nltk.download('wordnet')
nltk.download('omw-1.4')
from nltk.corpus import stopwords
from nltk.stem.wordnet import WordNetLemmatizer

# remove stopwords, punctuation, and normalize the corpus
stop = set(stopwords.words('english'))
exclude = set(string.punctuation)
lemma = WordNetLemmatizer()

def clean(doc):
    stop_free = " ".join([i for i in doc.lower().split() if i not in stop])
    punc_free = "".join(ch for ch in stop_free if ch not in exclude)
    normalized = " ".join(lemma.lemmatize(word) for word in punc_free.split())
    return normalized

clean_corpus = [clean(doc).split() for doc in corpus]
Nel codice sopra abbiamo:
Ma questo non significa ancora che siamo pronti.
Prima di poter usare questi dati come input per un modello LDA o LSA, devono essere convertiti in una matrice termine-documento. Una matrice termine-documento è semplicemente una rappresentazione matematica di un insieme di documenti e dei termini in essi contenuti.
Viene creata contando le occorrenze di ogni termine in ciascun documento e poi normalizzando i conteggi per creare una matrice di valori utilizzabile per l'analisi.
Per farlo in Python, useremo la libreria Gensim.
from gensim import corpora

# Creating document-term matrix
dictionary = corpora.Dictionary(clean_corpus)
doc_term_matrix = [dictionary.doc2bow(doc) for doc in clean_corpus]
Ora possiamo adattare i nostri modelli.
Il primo modello che useremo è LSA:
from gensim.models import LsiModel

# LSA model
lsa = LsiModel(doc_term_matrix, num_topics=3, id2word = dictionary)

# LSA model
print(lsa.print_topics(num_topics=3, num_words=3))

"""
[
(0, '0.555*"water" + 0.489*"percent" + 0.239*"planet"'),
(1, '0.361*"sleeping" + 0.215*"hour" + 0.215*"still"'),
(2, '-0.562*"water" + 0.231*"rain" + 0.231*"planet"')
]
"""
Questo stampa i topic (ogni riga) con i singoli termini di ciascun topic e i relativi pesi.
Proviamo con LDA:
from gensim.models import LdaModel

# LDA model
lda = LdaModel(doc_term_matrix, num_topics=3, id2word = dictionary)

# Results
print(lda.print_topics(num_topics=3, num_words=3))

"""
[
(0, '0.071*"water" + 0.025*"state" + 0.025*"three"'),
(1, '0.030*"still" + 0.028*"hour" + 0.026*"sleeping"'),
(2, '0.073*"percent" + 0.069*"water" + 0.031*"rain"')
]
"""Eliminando attività manuali e ripetitive, il topic modeling può accelerare facilmente e a basso costo i processi in modo semplice. Ecco alcuni esempi:
Il topic modeling può aiutare il personale di assistenza clienti ad analizzare le richieste di supporto per identificare i problemi principali e individuare quelli ricorrenti. Sulla base di questi dati, potrebbero creare contenuti self-service più informativi o aiutare direttamente i clienti.
Il topic modeling può essere usato per etichettare le conversazioni in modo che possano essere indirizzate al team più appropriato. Per esempio, una conversazione che include parole come "pricing", "subscription", "renewal", ecc. potrebbe essere inviata direttamente all'ufficio contabilità per il supporto.
Il topic modeling viene utilizzato per scoprire i topic latenti presenti in una raccolta di documenti. Ciò comporta l'identificazione di pattern nelle parole e frasi che compaiono nei documenti e il loro raggruppamento in topic in base alla somiglianza.
Al contrario, il clustering è una tecnica utilizzata per raggruppare oggetti simili sulla base di una misura di somiglianza. Tali metodi vengono impiegati per scoprire pattern e struttura nei dati raggruppando punti dati simili.
Sebbene entrambi gli approcci possano scoprire pattern nei dati testuali, hanno obiettivi diversi. Il topic modeling mira a identificare i topic latenti in una raccolta di documenti, mentre il clustering mira a raggruppare insieme punti dati simili.
La classificazione del testo, pur essendo una tecnica di elaborazione del linguaggio naturale, rientra nella categoria dell'apprendimento supervisionato. In particolare, la classificazione del testo viene impiegata per assegnare categorie predefinite a un dato testo. Affinché il modello riesca in questo compito, deve prima apprendere da un dataset etichettato, per poi poter fare previsioni su nuovi campioni di testo mai visti.
Il topic modeling, invece, è una tecnica di apprendimento non supervisionato utilizzata per trovare i topic sottostanti in una raccolta di documenti testuali. Ciò significa che non deve apprendere da un dataset etichettato.
Dunque, la differenza tra i due metodi è che la classificazione del testo viene usata per assegnare etichette predefinite al testo, mentre il topic modeling scopre i topic sottostanti in una raccolta di documenti.
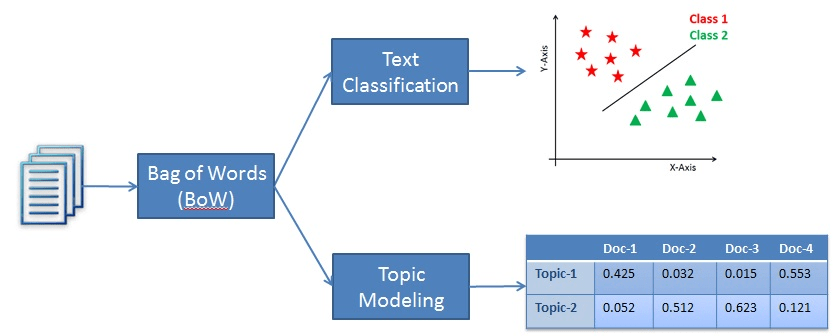
Esempio di classificazione vs topic modeling
Il topic modeling è una popolare tecnica di elaborazione del linguaggio naturale utilizzata per creare dati strutturati a partire da una raccolta di dati non strutturati. In altre parole, la tecnica consente alle aziende di apprendere i pattern semantici nascosti rappresentati da un corpus di testo e di identificare automaticamente i topic presenti al suo interno.
Due approcci popolari al topic modeling sono LSA e LDA. Entrambi cercano di scoprire i pattern nascosti nei dati testuali, ma muovono da assunzioni diverse per raggiungere l'obiettivo. Laddove LSA assume che parole con significati simili compaiano in documenti simili, LDA assume che i documenti siano composti da parole che aiutano a determinare i topic.
In questo tutorial abbiamo trattato i concetti chiave del topic modeling, un'implementazione pratica e in cosa il topic modeling differisce da altre tecniche, come la classificazione del testo e il clustering. Per continuare ad apprendere, dai un'occhiata ad alcune delle nostre altre risorse:
Inizia oggi il tuo percorso nel Topic Modeling!
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



