
Cursus
Introductie tot tekstanalyse in R
4 uur
27.3K
Topic modeling is een veelgebruikte aanpak om verborgen semantische patronen in een tek-corpus te ontdekken en automatisch de onderwerpen te identificeren die erin voorkomen.
Het is namelijk een vorm van statistische modellering die gebruikmaakt van unsupervised machine learning om clusters of groepen van vergelijkbare woorden binnen een tekst te analyseren en te identificeren.
Een topic-modelingalgoritme kan bijvoorbeeld worden ingezet om te bepalen of de inhoud van een document impliceert dat het om een factuur, klacht of contract gaat.
Volgens sommige bronnen genereert een gemiddeld persoon meer dan 1,7 MB aan digitale data per seconde. Dat komt neer op meer dan 2,5 triljard bytes per dag, waarvan 80-90% ongestructureerd is.
Stel dat een bedrijf één persoon inhuurt om elk stuk ongestructureerde data te beoordelen en te segmenteren op basis van het onderliggende onderwerp. Dat is een onmogelijke opgave.
Het zou enorm veel tijd kosten en extreem eentonig zijn. Bovendien is er meer risico, omdat mensen van nature bevooroordeeld zijn en meer fouten maken dan machines.
De oplossing is topic modeling.
Met topic modeling kun je sneller, en mogelijk beter, inzichten uit data halen. Deze techniek bundelt onderwerpen in een begrijpelijke structuur, waardoor bedrijven snel kunnen doorgronden wat er speelt.
Een bedrijf dat de grootste uitdagingen van klanten wil begrijpen, kan bijvoorbeeld topic modeling inzetten om dit uit ongestructureerde data te leren.
Kortom, topic modeling helpt bedrijven bij:
We hebben vastgesteld dat topic modeling data-professionals in staat stelt om op schaal snel clusters of groepen van vergelijkbare woorden binnen een tekst te analyseren en te identificeren.
Maar wat zijn topics precies, en hoe werkt topic modeling?
Topics zijn de latente beschrijvingen van een corpus (grote verzameling) tekst. Intuïtief zullen documenten over een specifiek onderwerp bepaalde woorden vaker laten voorkomen.
Zo zullen de woorden “hond” en “bot” eerder verschijnen in documenten over honden, terwijl “kat” en “miauw” vaker voorkomen in documenten over katten. Het topicmodel scant de documenten en produceert vervolgens clusters van vergelijkbare woorden.
In essentie leiden topicmodellen woorden af en groeperen vergelijkbare woorden tot topics om topicclusters te vormen.
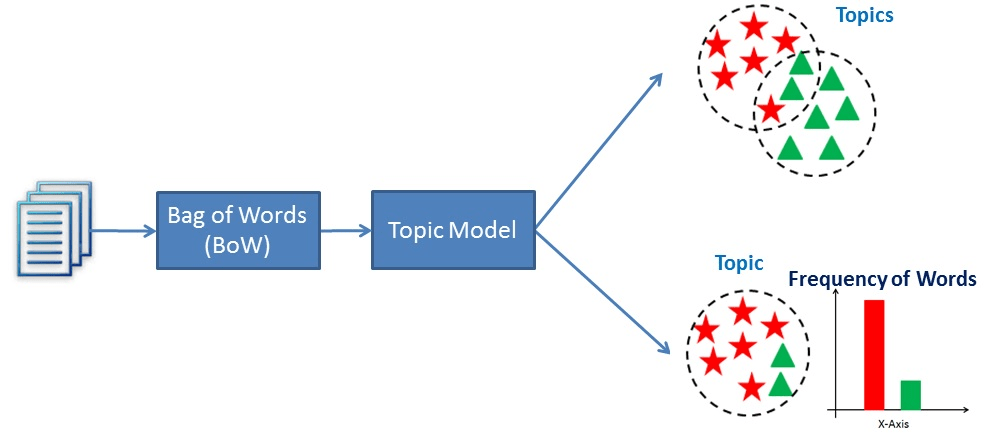
Een visualisatie van hoe topic modeling werkt
Twee populaire topic-modelingtechnieken zijn Latent Semantic Analysis (LSA) en Latent Dirichlet Allocation (LDA). Hun doel, het ontdekken van verborgen semantische patronen in tekstdata, is hetzelfde, maar de manier waarop ze dit bereiken verschilt.
Latent Semantic Analysis (LSA) is een natural language processing-techniek die relaties tussen documenten en de termen daarin analyseert. De methode werd voor het eerst geïntroduceerd in een paper uit 1988, getiteld “Using Latent Semantic Analysis to Improve Access to Textual Information”, en wordt nog steeds gebruikt om gestructureerde data te creëren uit een collectie ongestructureerde tekst.
LSA gaat er namelijk van uit dat woorden met vergelijkbare betekenissen in vergelijkbare documenten zullen voorkomen. Het doet dit door een matrix te construeren met woordtellingen per document, waarbij elke rij een uniek woord voorstelt en kolommen de documenten, en vervolgens een Singular Value Decomposition (SVD) toe te passen om het aantal rijen te verminderen terwijl de gelijkenisstructuur tussen kolommen behouden blijft. SVD is een wiskundige methode die data vereenvoudigt en toch de belangrijkste kenmerken behoudt. Hier wordt het gebruikt om de relaties tussen woorden en documenten te behouden.
Om de gelijkenis tussen documenten te bepalen, wordt cosinusgelijkenis gebruikt. Dit is een maat die de cosinus van de hoek tussen twee vectoren berekent, die hier documenten voorstellen. Een waarde dicht bij 1 betekent dat de documenten erg vergelijkbaar zijn op basis van de woorden erin, terwijl een waarde dicht bij 0 betekent dat ze behoorlijk verschillen.
Latent Dirichlet Allocation (LDA) werd aanvankelijk in 2000 voorgesteld in een paper getiteld “Inference of population structure using multilocus genotype data.” De paper richtte zich voornamelijk op populatiegenetica, een subveld binnen de genetica dat zich bezighoudt met genetische verschillen binnen en tussen populaties. Drie jaar later werd Latent Dirichlet Allocation toegepast in machine learning.
De auteurs beschrijven de techniek als “a generative model for text and other collections of discrete data.” LDA kan dus worden omschreven als een natural-language-techniek die onderwerpen identificeert waar een document toe behoort op basis van de woorden die het bevat.
Concreter is LDA een Bayesiaans netwerk, wat betekent dat het een generatief statistisch model is dat ervan uitgaat dat documenten bestaan uit woorden die helpen bij het bepalen van de topics. Documenten worden dus gekoppeld aan een lijst met topics door elk woord in het document aan verschillende topics toe te wijzen. Dit model negeert de volgorde van woorden in een document en behandelt ze als een bag of words.
Latent Semantic Analysis (LSA) en Latent Dirichlet Allocation (LDA) zijn beide natural-languageprocessingtechnieken die gestructureerde data creëren uit een verzameling ongestructureerde tekst.
LSA gebruikt echter Singular Value Decomposition (SVD) om de dimensionaliteit van de term-documentmatrix te reduceren en is gebaseerd op de aanname dat woorden met vergelijkbare betekenissen in vergelijkbare documenten voorkomen. Door een representatie met lagere dimensionaliteit van de tekst te creëren, kan het model de onderliggende relaties tussen woorden vastleggen om te bepalen hoe vergelijkbaar twee documenten zijn.
Daarentegen is LDA een generatief probabilistisch model dat Bayesiaanse inferentie gebruikt om de onderliggende topics in een corpus van teksten te vinden. Het gaat ervan uit dat elk document een combinatie is van een klein aantal latente topics en dat elk woord door een bepaald topic wordt gegenereerd.
Kort gezegd probeert LSA de onderliggende relaties tussen woorden te ontdekken, terwijl LDA de onderliggende topics in een tekstcorpus wil vinden. Hoewel beide technieken een vectorrepresentatie van tekst creëren, hanteren ze verschillende onderliggende aannames.
Laten we kijken hoe deze technieken werken. Gebruik deze DataLab-werkmap om de code te volgen.
Het eerste wat we nodig hebben, is data.
Voor topic modeling heet de data die we gebruiken een corpus; dat is simpelweg een verzameling tekst.
Hier is een klein corpus dat ik heb gemaakt met feitjes van internet:
# Creating example documents
doc_1 = "A whopping 96.5 percent of water on Earth is in our oceans, covering 71 percent of the surface of our planet. And at any given time, about 0.001 percent is floating above us in the atmosphere. If all of that water fell as rain at once, the whole planet would get about 1 inch of rain."

doc_2 = "One-third of your life is spent sleeping. Sleeping 7-9 hours each night should help your body heal itself, activate the immune system, and give your heart a break. Beyond that--sleep experts are still trying to learn more about what happens once we fall asleep."

doc_3 = "A newborn baby is 78 percent water. Adults are 55-60 percent water. Water is involved in just about everything our body does."

doc_4 = "While still in high school, a student went 264.4 hours without sleep, for which he won first place in the 10th Annual Great San Diego Science Fair in 1964."

doc_5 = "We experience water in all three states: solid ice, liquid water, and gas water vapor."

# Create corpus
corpus = [doc_1, doc_2, doc_3, doc_4, doc_5]De volgende stap is het opschonen van de tekst:
# Code source: https://www.analyticsvidhya.com/blog/2016/08/beginners-guide-to-topic-modeling-in-python/

import string
import nltk
nltk.download('stopwords')
nltk.download('wordnet')
nltk.download('omw-1.4')
from nltk.corpus import stopwords
from nltk.stem.wordnet import WordNetLemmatizer

# remove stopwords, punctuation, and normalize the corpus
stop = set(stopwords.words('english'))
exclude = set(string.punctuation)
lemma = WordNetLemmatizer()

def clean(doc):
    stop_free = " ".join([i for i in doc.lower().split() if i not in stop])
    punc_free = "".join(ch for ch in stop_free if ch not in exclude)
    normalized = " ".join(lemma.lemmatize(word) for word in punc_free.split())
    return normalized

clean_corpus = [clean(doc).split() for doc in corpus]
In de bovenstaande code hebben we:
Maar dat betekent nog niet dat we er klaar voor zijn.
Voordat we deze data als input voor een LDA- of LSA-model kunnen gebruiken, moet ze worden omgezet naar een term-documentmatrix. Een term-documentmatrix is een wiskundige representatie van een set documenten en de termen daarin.
Die wordt gemaakt door het aantal voorkomens van elke term in elk document te tellen en de tellingen vervolgens te normaliseren om een matrix van waarden te creëren die voor analyse kan worden gebruikt.
In Python doen we dit met de Gensim-library.
from gensim import corpora

# Creating document-term matrix
dictionary = corpora.Dictionary(clean_corpus)
doc_term_matrix = [dictionary.doc2bow(doc) for doc in clean_corpus]
Nu kunnen we onze modellen fitten.
Het eerste model dat we gebruiken is LSA:
from gensim.models import LsiModel

# LSA model
lsa = LsiModel(doc_term_matrix, num_topics=3, id2word = dictionary)

# LSA model
print(lsa.print_topics(num_topics=3, num_words=3))

"""
[
(0, '0.555*"water" + 0.489*"percent" + 0.239*"planet"'),
(1, '0.361*"sleeping" + 0.215*"hour" + 0.215*"still"'),
(2, '-0.562*"water" + 0.231*"rain" + 0.231*"planet"')
]
"""
Dit geeft de topics (elke regel) met afzonderlijke termwoorden (termen) en hun gewichten.
Laten we het proberen met LDA:
from gensim.models import LdaModel

# LDA model
lda = LdaModel(doc_term_matrix, num_topics=3, id2word = dictionary)

# Results
print(lda.print_topics(num_topics=3, num_words=3))

"""
[
(0, '0.071*"water" + 0.025*"state" + 0.025*"three"'),
(1, '0.030*"still" + 0.028*"hour" + 0.026*"sleeping"'),
(2, '0.073*"percent" + 0.069*"water" + 0.031*"rain"')
]
"""Door handmatige en repetitieve taken weg te nemen, kan topic modeling processen eenvoudig en goedkoop versnellen. Enkele voorbeelden:
Topic modeling kan klantenservicemedewerkers helpen om supportvragen te analyseren, de belangrijkste issues te identificeren en te bepalen welke herhaaldelijk voorkomen. Op basis daarvan kunnen ze informatievere selfservicecontent maken of klanten direct helpen.
Topic modeling kan worden gebruikt om gesprekken te taggen, zodat ze naar het meest geschikte team kunnen worden gerouteerd. Een gesprek met woorden als “pricing”, “subscription”, “renewal” kan bijvoorbeeld direct naar de financiële administratie worden gestuurd voor ondersteuning.
Topic modeling wordt gebruikt om latente topics te ontdekken die bestaan binnen een collectie documenten. Dit houdt in dat je patronen identificeert in de woorden en zinnen die in documenten voorkomen en ze groepeert in topics op basis van hun overeenkomst.
Clusteren daarentegen is een techniek om vergelijkbare objecten te groeperen op basis van een gelijkenismaat. Zulke methoden worden gebruikt om patronen en structuur in data te ontdekken door vergelijkbare datapunten te bundelen.
Hoewel beide benaderingen patronen in tekstdata kunnen blootleggen, hebben ze verschillende doelen. Topic modeling richt zich op het identificeren van latente topics in een collectie documenten, terwijl clusteren zich richt op het groeperen van vergelijkbare datapunten.
Tekstclassificatie is, hoewel een natural language processing-techniek, een vorm van supervised learning. Tekstclassificatie wordt ingezet om vooraf gedefinieerde categorieën toe te kennen aan een tekstfragment. Om dat te kunnen, moet het model eerst leren van een gelabelde dataset voordat het voorspellingen kan doen op nieuwe, ongeziene tekstvoorbeelden.
Topic modeling daarentegen is een unsupervised learning-techniek die wordt gebruikt om de onderliggende topics in een collectie tekstdocumenten te vinden. Het hoeft dus niet te leren van een gelabelde dataset.
Het verschil tussen beide methoden is dus dat tekstclassificatie wordt gebruikt om vooraf gedefinieerde labels aan tekst toe te kennen, terwijl topic modeling de onderliggende topics in een collectie documenten ontdekt.
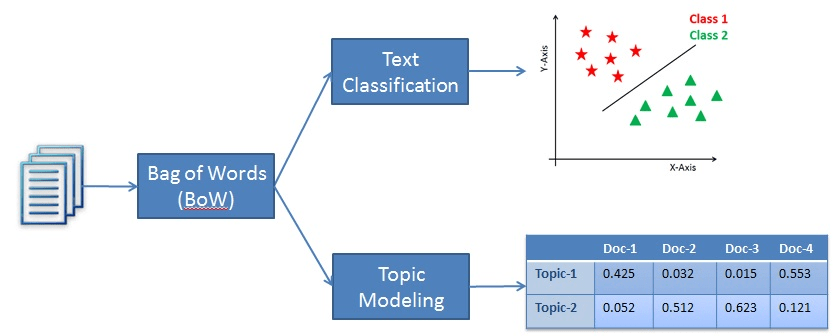
Een voorbeeld van classificatie vs topic modeling
Topic modeling is een populaire natural-languageprocessingtechniek die gestructureerde data creëert uit een verzameling ongestructureerde data. Met andere woorden: de techniek stelt bedrijven in staat om de verborgen semantische patronen in een tek-corpus te leren kennen en automatisch de topics te identificeren die erin voorkomen.
Twee populaire benaderingen voor topic modeling zijn LSA en LDA. Beide willen de verborgen patronen in tekstdata ontdekken, maar hanteren verschillende aannames om dat doel te bereiken. Waar LSA aanneemt dat woorden met vergelijkbare betekenissen in vergelijkbare documenten voorkomen, gaat LDA ervan uit dat documenten bestaan uit woorden die helpen bij het bepalen van de topics.
In deze tutorial hebben we de kernconcepten van topic modeling behandeld, een praktische implementatie, en hoe topic modeling verschilt van andere technieken zoals tekstclassificatie en clusteren. Wil je verder leren? Bekijk dan ook onze andere resources:
Begin vandaag nog met je topic-modelingreis!
Cursus
Cursus
blog
Adel Nehme
15 min

