

Topic Modeling là gì?
Topic modeling là một phương pháp thường dùng để khám phá các mẫu nghĩa tiềm ẩn được thể hiện bởi một corpus văn bản và tự động xác định các chủ đề tồn tại trong đó.
Cụ thể, đây là một dạng mô hình hóa thống kê tận dụng học máy không giám sát để phân tích và xác định các cụm hoặc nhóm từ tương đồng trong một khối văn bản.
Ví dụ, một thuật toán topic modeling có thể được triển khai để xác định liệu nội dung của một tài liệu gợi ý đó là hóa đơn, khiếu nại hay hợp đồng.
Vai trò của topic modeling trong kinh doanh
Theo một số nguồn, trung bình mỗi người tạo ra hơn 1,7MB dữ liệu số mỗi giây. Con số này tương đương hơn 2,5 tỷ tỷ byte dữ liệu mỗi ngày, trong đó 80-90% là phi cấu trúc.
Hãy hình dung một kịch bản doanh nghiệp thuê một người duy nhất để xem xét từng mẩu dữ liệu phi cấu trúc và phân loại chúng theo chủ đề tiềm ẩn. Đó là nhiệm vụ bất khả thi.
Sẽ mất rất nhiều thời gian để hoàn thành và vô cùng tẻ nhạt, hơn nữa rủi ro cao hơn vì con người vốn có định kiến và dễ sai sót hơn máy móc.
Giải pháp là topic modeling.
Với topic modeling, insight từ dữ liệu có thể được rút ra nhanh hơn và có thể còn tốt hơn. Kỹ thuật này kết hợp các chủ đề thành một cấu trúc dễ hiểu, giúp doanh nghiệp nhanh chóng nắm bắt điều gì đang diễn ra.
Ví dụ, một doanh nghiệp muốn hiểu những thách thức lớn nhất của khách hàng có thể dùng topic modeling để học hỏi điều này từ dữ liệu phi cấu trúc.
Tóm lại, topic modeling hỗ trợ doanh nghiệp trong việc:
- Thực hiện phân tích thời gian thực trên dữ liệu văn bản phi cấu trúc
- Học hỏi từ dữ liệu phi cấu trúc ở quy mô lớn
- Xây dựng sự thấu hiểu nhất quán về dữ liệu, bất kể định dạng.
Các khái niệm cốt lõi của Topic Modeling
Chúng ta đã xác định topic modeling cho phép các chuyên gia dữ liệu nhanh chóng phân tích và xác định các cụm hoặc nhóm từ tương đồng trong một khối văn bản ở quy mô lớn.
Nhưng chủ đề (topic) là gì, và topic modeling hoạt động như thế nào?
Chủ đề là gì và các mô hình chủ đề hoạt động ra sao?
Chủ đề là các mô tả tiềm ẩn của một corpus (tập hợp lớn) văn bản. Trực giác mà nói, các tài liệu về một chủ đề cụ thể có xu hướng tạo ra một số từ xuất hiện thường xuyên hơn.
Ví dụ, từ “dog” và “bone” có khả năng xuất hiện trong các tài liệu về chó, trong khi “cat” và “meow” có khả năng xuất hiện trong các tài liệu về mèo. Hệ quả là mô hình chủ đề sẽ quét các tài liệu và tạo ra các cụm từ tương đồng.
Về bản chất, các mô hình chủ đề hoạt động bằng cách suy luận các từ và nhóm những từ tương tự nhau vào các chủ đề để tạo thành các cụm chủ đề.
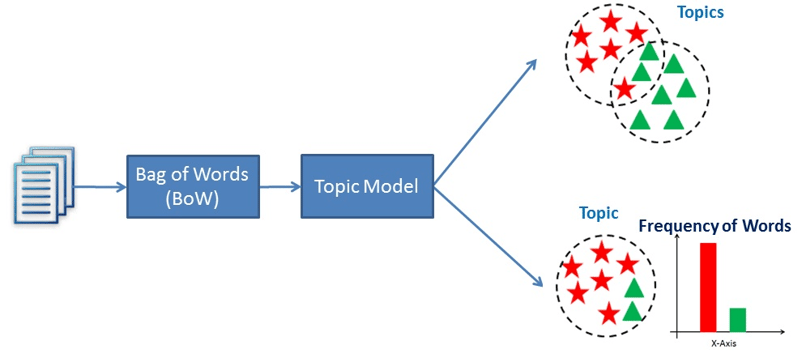
Minh họa cách topic modeling hoạt động
Khám phá các kỹ thuật Topic Modeling
Hai kỹ thuật topic modeling phổ biến là Phân tích ngữ nghĩa tiềm ẩn (LSA) và Phân bổ Dirichlet tiềm ẩn (LDA). Mục tiêu của chúng là khám phá các mẫu nghĩa ẩn trong dữ liệu văn bản giống nhau, nhưng cách đạt được thì khác nhau.
Latent Semantic Analysis (LSA)
Latent Semantic Analysis (LSA) là một kỹ thuật xử lý ngôn ngữ tự nhiên dùng để phân tích mối quan hệ giữa các tài liệu và các thuật ngữ chúng chứa. Phương pháp này lần đầu được giới thiệu trong bài báo năm 1988 có tiêu đề “Using Latent Semantic Analysis to Improve Access to Textual Information” và đến nay vẫn được dùng để tạo dữ liệu có cấu trúc từ tập văn bản phi cấu trúc.
Cụ thể, LSA giả định các từ có nghĩa tương tự sẽ xuất hiện trong các tài liệu tương tự. Nó làm vậy bằng cách xây dựng một ma trận chứa số lần xuất hiện từ theo tài liệu, trong đó mỗi hàng là một từ duy nhất và các cột là từng tài liệu, rồi dùng Phân rã giá trị kỳ dị (SVD) để giảm số hàng trong khi vẫn bảo toàn cấu trúc tương đồng giữa các cột. SVD là phương pháp toán học giúp đơn giản hóa dữ liệu nhưng vẫn giữ các đặc trưng quan trọng. Ở đây nó được dùng để duy trì mối quan hệ giữa từ và tài liệu.
Để xác định độ tương đồng giữa các tài liệu, người ta dùng độ đo cosine. Đây là thước đo tính cosin của góc giữa hai vector, ở đây đại diện cho các tài liệu. Giá trị gần 1 nghĩa là các tài liệu rất giống nhau dựa trên các từ của chúng, trong khi giá trị gần 0 nghĩa là khá khác biệt.
Latent Dirichlet Allocation (LDA)
Latent Dirichlet Allocation (LDA) được đề xuất ban đầu năm 2000 trong bài báo “Inference of population structure using multilocus genotype data.” Bài báo tập trung chủ yếu vào di truyền học quần thể, một phân ngành nghiên cứu khác biệt di truyền trong và giữa các quần thể. Ba năm sau, Latent Dirichlet Allocation được áp dụng trong học máy.
Các tác giả mô tả kỹ thuật này là “một mô hình sinh cho văn bản và các tập dữ liệu rời rạc khác.” Do đó, LDA có thể được mô tả là một kỹ thuật xử lý ngôn ngữ tự nhiên dùng để xác định các chủ đề mà một tài liệu thuộc về dựa trên các từ xuất hiện trong đó.
Cụ thể hơn, LDA là một mạng Bayes, nghĩa là mô hình thống kê sinh giả định tài liệu được tạo thành từ các từ giúp xác định chủ đề. Vì vậy, các tài liệu được ánh xạ tới một danh sách chủ đề bằng cách gán mỗi từ trong tài liệu cho các chủ đề khác nhau. Mô hình này bỏ qua thứ tự từ trong tài liệu và xem chúng như một “túi từ”.
LSA vs LDA
Latent Semantic Analysis (LSA) và Latent Dirichlet Allocation (LDA) đều là các kỹ thuật xử lý ngôn ngữ tự nhiên dùng để tạo dữ liệu có cấu trúc từ tập văn bản phi cấu trúc.
Tuy nhiên, LSA tận dụng Phân rã giá trị kỳ dị (SVD) để giảm chiều của ma trận thuật ngữ–tài liệu và dựa trên giả định rằng các từ có nghĩa tương tự sẽ xuất hiện trong các tài liệu tương tự. Bằng cách tạo biểu diễn văn bản ở không gian chiều thấp hơn, mô hình có thể nắm bắt các mối quan hệ nền tảng giữa các từ để xác định mức độ tương đồng của hai tài liệu.
Ngược lại, LDA là mô hình sinh xác suất sử dụng suy luận Bayes để tìm các chủ đề tiềm ẩn trong một corpus văn bản. Nó giả định mỗi tài liệu là sự kết hợp của một số ít chủ đề tiềm ẩn, và mỗi từ được sinh bởi một chủ đề cụ thể.
Rốt cuộc, LSA cố gắng khám phá các mối quan hệ nền tảng giữa các từ, trong khi LDA tìm cách khám phá các chủ đề tiềm ẩn trong một corpus văn bản. Dù cả hai đều là kỹ thuật tạo biểu diễn vector cho văn bản, chúng dựa trên các giả định nền tảng khác nhau.
Triển khai thực tiễn Topic Modeling
Hãy xem các kỹ thuật này hoạt động thế nào. Hãy dùng DataLab workbook này để theo dõi cùng mã nguồn.
Chuẩn bị dữ liệu
Điều đầu tiên chúng ta cần là dữ liệu.
Với topic modeling, dữ liệu chúng ta dùng được gọi là corpus, đơn giản là một tập hợp văn bản.
Dưới đây là một corpus nhỏ tôi tạo từ các thông tin trên internet:
# Creating example documents
doc_1 = "A whopping 96.5 percent of water on Earth is in our oceans, covering 71 percent of the surface of our planet. And at any given time, about 0.001 percent is floating above us in the atmosphere. If all of that water fell as rain at once, the whole planet would get about 1 inch of rain."
doc_2 = "One-third of your life is spent sleeping. Sleeping 7-9 hours each night should help your body heal itself, activate the immune system, and give your heart a break. Beyond that--sleep experts are still trying to learn more about what happens once we fall asleep."
doc_3 = "A newborn baby is 78 percent water. Adults are 55-60 percent water. Water is involved in just about everything our body does."
doc_4 = "While still in high school, a student went 264.4 hours without sleep, for which he won first place in the 10th Annual Great San Diego Science Fair in 1964."
doc_5 = "We experience water in all three states: solid ice, liquid water, and gas water vapor."
# Create corpus
corpus = [doc_1, doc_2, doc_3, doc_4, doc_5]Tiền xử lý
Bước tiếp theo là làm sạch văn bản:
# Code source: https://www.analyticsvidhya.com/blog/2016/08/beginners-guide-to-topic-modeling-in-python/
import string
import nltk
nltk.download('stopwords')
nltk.download('wordnet')
nltk.download('omw-1.4')
from nltk.corpus import stopwords
from nltk.stem.wordnet import WordNetLemmatizer
# remove stopwords, punctuation, and normalize the corpus
stop = set(stopwords.words('english'))
exclude = set(string.punctuation)
lemma = WordNetLemmatizer()
def clean(doc):
stop_free = " ".join([i for i in doc.lower().split() if i not in stop])
punc_free = "".join(ch for ch in stop_free if ch not in exclude)
normalized = " ".join(lemma.lemmatize(word) for word in punc_free.split())
return normalized
clean_corpus = [clean(doc).split() for doc in corpus]Trong đoạn mã trên, chúng ta:
- Nhập các thư viện cần thiết và tải stopwords cùng wordnet
- Xác định danh sách stopwords tiếng Anh
- Khởi tạo tập ký tự dấu câu cần loại bỏ
- Tạo instance của bộ lemmatizer wordnet
- Tạo hàm để loại bỏ stopwords và dấu câu, đồng thời lemmatize các tài liệu.
- Áp dụng hàm clean cho từng tài liệu trong corpus.
Nhưng như vậy vẫn chưa đủ.
Trước khi có thể dùng dữ liệu này làm đầu vào cho mô hình LDA hoặc LSA, nó phải được chuyển thành ma trận thuật ngữ–tài liệu (term-document matrix). Đây chỉ là biểu diễn toán học của một tập tài liệu và các thuật ngữ trong đó.
Ma trận được tạo bằng cách đếm số lần xuất hiện của từng thuật ngữ trong mỗi tài liệu rồi chuẩn hóa số đếm để tạo ma trận giá trị có thể dùng cho phân tích.
Để làm điều này trong Python, chúng ta sẽ tận dụng thư viện Gensim.
from gensim import corpora
# Creating document-term matrix
dictionary = corpora.Dictionary(clean_corpus)
doc_term_matrix = [dictionary.doc2bow(doc) for doc in clean_corpus]Giờ thì chúng ta có thể huấn luyện các mô hình.
Mô hình hóa
Mô hình đầu tiên chúng ta dùng là LSA:
from gensim.models import LsiModel
# LSA model
lsa = LsiModel(doc_term_matrix, num_topics=3, id2word = dictionary)
# LSA model
print(lsa.print_topics(num_topics=3, num_words=3))
"""
[
(0, '0.555*"water" + 0.489*"percent" + 0.239*"planet"'),
(1, '0.361*"sleeping" + 0.215*"hour" + 0.215*"still"'),
(2, '-0.562*"water" + 0.231*"rain" + 0.231*"planet"')
]
"""Đầu ra này là các chủ đề (mỗi dòng) với các thuật ngữ chủ đề riêng lẻ và trọng số của chúng.
Hãy thử với LDA:
from gensim.models import LdaModel
# LDA model
lda = LdaModel(doc_term_matrix, num_topics=3, id2word = dictionary)
# Results
print(lda.print_topics(num_topics=3, num_words=3))
"""
[
(0, '0.071*"water" + 0.025*"state" + 0.025*"three"'),
(1, '0.030*"still" + 0.028*"hour" + 0.026*"sleeping"'),
(2, '0.073*"percent" + 0.069*"water" + 0.031*"rain"')
]
"""Topic Modeling dùng để làm gì?
Bằng cách loại bỏ các tác vụ thủ công và lặp lại, topic modeling có thể tăng tốc quy trình một cách dễ dàng và tiết kiệm chi phí. Dưới đây là vài ví dụ:
Gắn thẻ phiếu hỗ trợ
Topic modeling có thể giúp đội ngũ chăm sóc khách hàng phân tích yêu cầu hỗ trợ để xác định vấn đề chính và phát hiện các vấn đề lặp lại. Dựa trên dữ liệu đó, họ có thể tạo nội dung tự trợ giúp chi tiết hơn hoặc hỗ trợ khách hàng trực tiếp.
Nâng cao trải nghiệm khách hàng
Topic modeling có thể được dùng để gắn thẻ các cuộc trò chuyện nhằm định tuyến tới đội phù hợp nhất. Ví dụ, một cuộc trò chuyện chứa các từ như “pricing”, “subscription”, “renewal”, v.v. có thể được chuyển thẳng đến bộ phận kế toán để hỗ trợ.
Topic Modeling so với các kỹ thuật khác
Topic modeling và clustering
Topic modeling được dùng để khám phá các chủ đề tiềm ẩn tồn tại trong một tập hợp tài liệu. Điều này liên quan đến việc xác định các mẫu trong từ và cụm từ xuất hiện trong tài liệu và nhóm chúng thành các chủ đề dựa trên mức độ tương đồng.
Ngược lại, clustering là kỹ thuật dùng để nhóm các đối tượng tương tự dựa trên một thước đo tương đồng. Các phương pháp như vậy được dùng để khám phá mẫu và cấu trúc trong dữ liệu bằng cách nhóm các điểm dữ liệu tương tự lại với nhau.
Dù cả hai đều có thể khám phá các mẫu trong dữ liệu văn bản, mục tiêu khác nhau. Topic modeling tập trung vào xác định các chủ đề tiềm ẩn trong một tập tài liệu, còn clustering tập trung vào việc nhóm các điểm dữ liệu tương tự.
Topic modeling và phân loại văn bản
Phân loại văn bản, dù là một kỹ thuật xử lý ngôn ngữ tự nhiên, thuộc nhóm học có giám sát. Cụ thể, phân loại văn bản được dùng để gán nhãn các danh mục được xác định trước cho một đoạn văn bản. Để mô hình làm được điều này, trước tiên nó phải học từ một tập dữ liệu đã gán nhãn trước khi có thể dự đoán trên các mẫu văn bản mới, chưa thấy bao giờ.
Ngược lại, topic modeling là kỹ thuật học không giám sát dùng để tìm các chủ đề tiềm ẩn trong một tập hợp tài liệu văn bản. Điều này có nghĩa nó không cần học từ tập dữ liệu gán nhãn.
Vì vậy, điểm khác biệt là phân loại văn bản dùng để gán nhãn định sẵn cho văn bản, còn topic modeling khám phá các chủ đề tiềm ẩn trong một tập tài liệu.
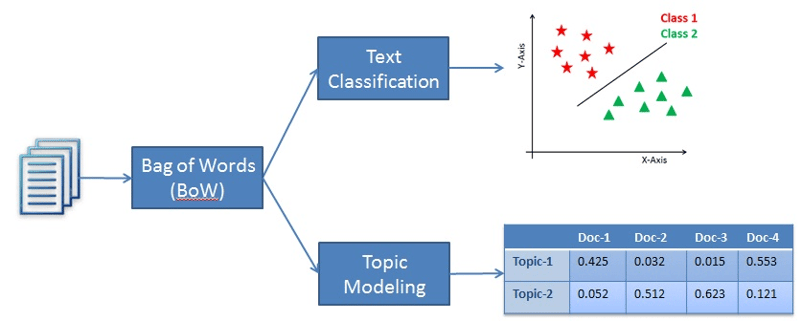
Ví dụ về phân loại so với topic modeling
Kết luận
Topic modeling là một kỹ thuật xử lý ngôn ngữ tự nhiên phổ biến được dùng để tạo dữ liệu có cấu trúc từ tập dữ liệu phi cấu trúc. Nói cách khác, kỹ thuật này giúp doanh nghiệp học được các mẫu nghĩa tiềm ẩn trong một corpus văn bản và tự động xác định các chủ đề tồn tại trong đó.
Hai cách tiếp cận topic modeling phổ biến là LSA và LDA. Cả hai đều tìm cách khám phá các mẫu ẩn trong dữ liệu văn bản, nhưng chúng đưa ra các giả định khác nhau để đạt mục tiêu. Nếu LSA giả định các từ có nghĩa tương tự sẽ xuất hiện trong các tài liệu tương tự, thì LDA giả định tài liệu được tạo thành từ các từ giúp xác định chủ đề.
Trong hướng dẫn này, chúng ta đã đề cập đến các khái niệm cốt lõi của topic modeling, một triển khai thực tiễn, và cách topic modeling khác với các kỹ thuật khác như phân loại văn bản và clustering. Để tiếp tục học, hãy xem thêm một số tài nguyên khác của chúng tôi:


Mục tiêu của phân tích dữ liệu là rút ra insight từ dữ liệu. Truyền thống, dữ liệu thường ở dạng cấu trúc, tức ở định dạng chuẩn hóa để truy cập hiệu quả. Khi thế giới chuyển dịch và số hóa hơn, phần lớn dữ liệu được tạo ra là phi cấu trúc, tức không có mô hình dữ liệu được định nghĩa trước.
Theo Gartner, dữ liệu phi cấu trúc chiếm 80-90% tổng dữ liệu doanh nghiệp mới. Hơn nữa, nó tăng trưởng nhanh gấp ba lần dữ liệu có cấu trúc. Do đó, các chuyên gia phân tích phải áp dụng các kỹ thuật mới để thu được thông tin phù hợp từ tập dữ liệu của mình.
Một kỹ thuật như vậy đang được tận dụng là topic modeling trong lĩnh vực khai phá văn bản. Ở phần còn lại của bài viết, chúng ta sẽ đề cập đến: