
Vai al contenuto principale

14 strumenti essenziali per il data engineering da usare nel 2026

Scopri gli strumenti principali per containerizzazione, infrastructure as code (IaC), gestione dei workflow, data warehousing, ingegneria analitica, elaborazione batch e data streaming.
Aggiornato 29 set 2026  · 10 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

I data engineer sono responsabili della creazione di pipeline in grado di acquisire, elaborare e fornire dati a vari endpoint, come database, data warehouse e piattaforme di analytics. Costruendo e mantenendo queste pipeline, i data engineer consentono a data scientist e analisti di accedere a dati in tempo reale per analisi e decisioni.

Ai data engineer moderni si richiede ancora di più. Devono anche mantenere e distribuire soluzioni dati, gestire i workflow, supervisionare i data warehouse, trasformare e visualizzare i dati e usare vari strumenti di elaborazione batch e streaming per ottimizzare, acquisire ed elaborare diversi tipi di dati.

Scopri cos’è il data engineering, in cosa si differenzia dalla data science, il suo perimetro e come impararlo leggendo la nostra guida, What is Data Engineering?
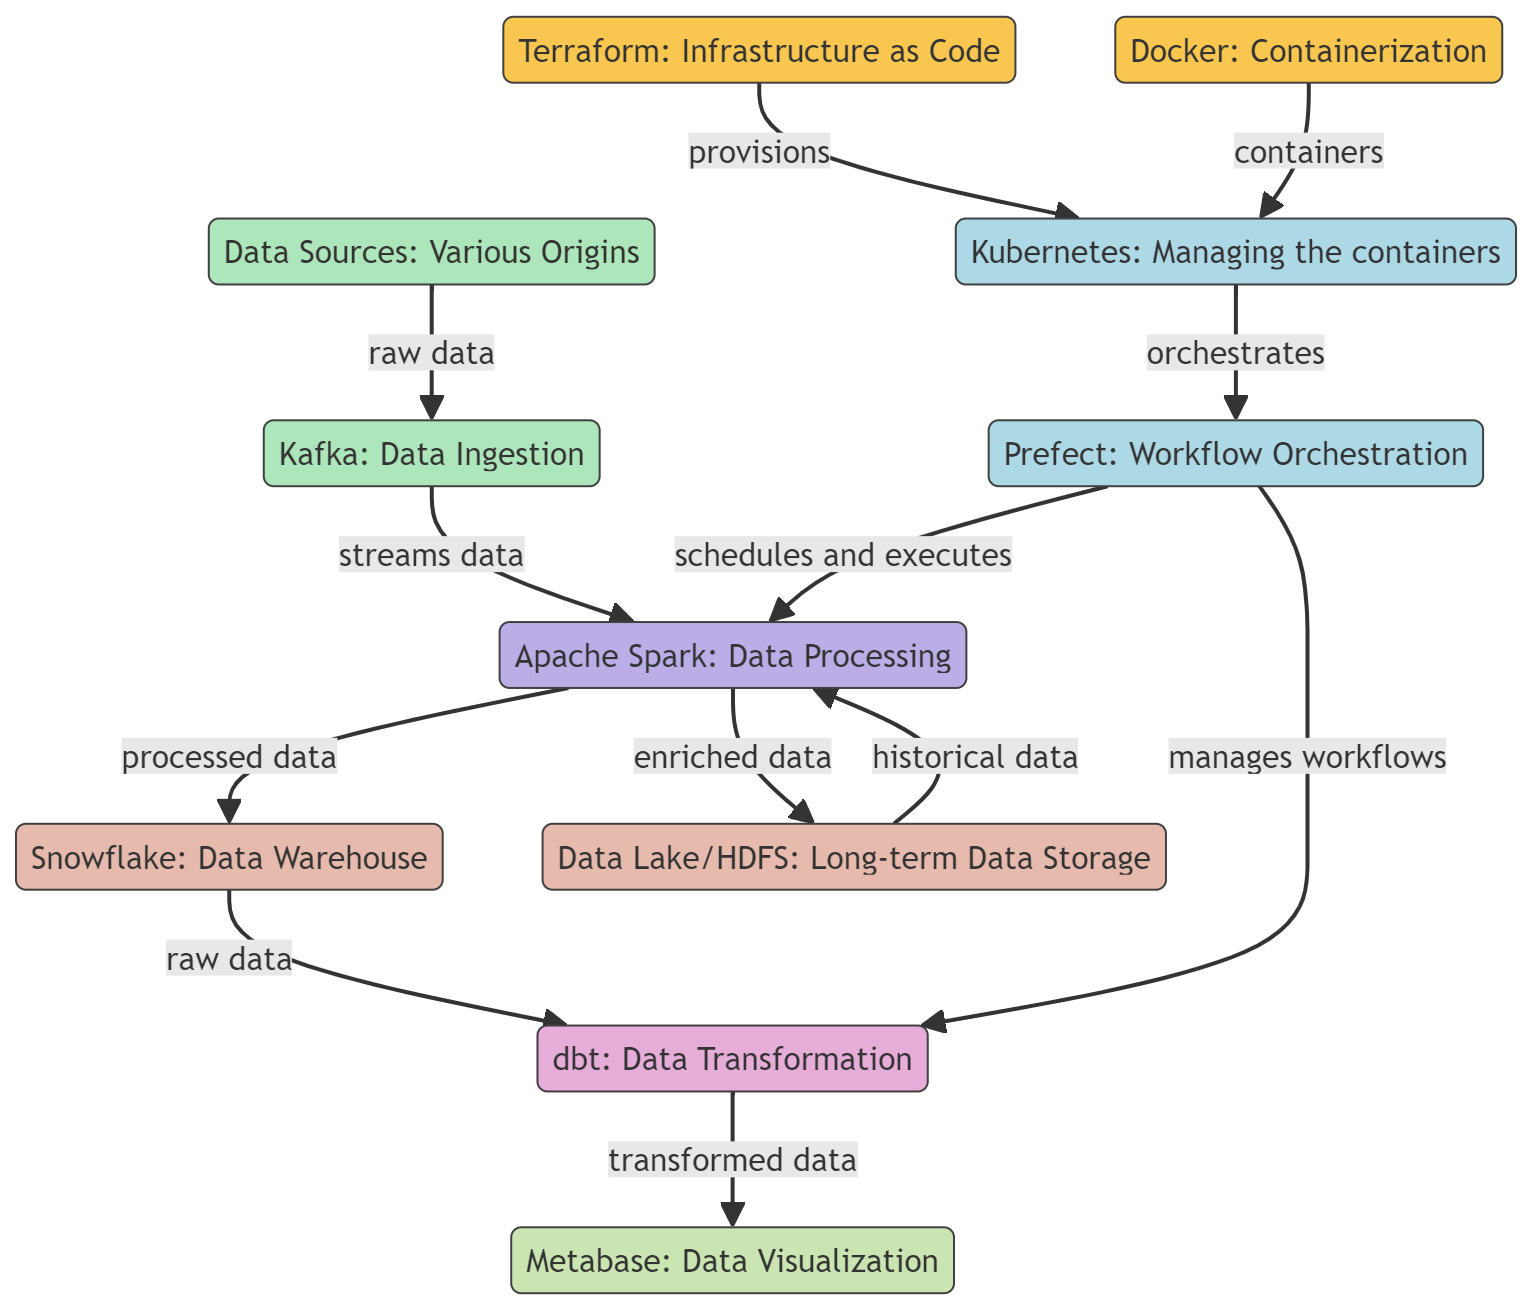
Strumenti per Data Engineer

In questo post, vedremo gli strumenti essenziali che sono popolari e talvolta necessari per i data engineer. Questi strumenti vengono usati per acquisizione, elaborazione, archiviazione, trasformazione e visualizzazione dei dati. Inoltre, daremo uno sguardo agli strumenti per containerizzazione e gestione dei workflow.

Impara le competenze fondamentali di data engineering leggendo il nostro blog How to Become a Data Engineer.

Strumenti di containerizzazione

Gli strumenti di containerizzazione forniscono un modo standardizzato per pacchettizzare, distribuire e gestire le applicazioni in ambienti diversi. Garantiscono coerenza, scalabilità ed efficienza nei workflow di data engineering.

1. Docker

Docker è una piattaforma di containerizzazione molto diffusa, spesso usata nel data engineering per sviluppare, distribuire ed eseguire strumenti e applicazioni dati. Offre un modo leggero, portatile e coerente per pacchettizzare e distribuire strumenti e applicazioni dati, rendendolo una scelta ideale per i data engineer.

Docker può essere usato per creare e gestire container per vari strumenti dati, come database, data warehouse, framework di elaborazione dati e strumenti di visualizzazione. Dai un’occhiata al nostro tutorial Docker for Data Science per saperne di più.

2. Kubernetes

Kubernetes è una piattaforma open-source per automatizzare il deployment, lo scaling e la gestione di applicazioni containerizzate, incluse quelle costruite con Docker.

Docker è uno strumento che può essere usato per pacchettizzare in container applicazioni di elaborazione dati, database e strumenti di analytics. Questo assicura coerenza degli ambienti e isola le applicazioni. Una volta creati i container, Kubernetes interviene per gestirli occupandosi del deployment, dello scaling in base al carico e garantendo alta disponibilità.

Scopri di più sulla containerizzazione con Docker e Kubernetes in un articolo dedicato.

Strumenti di Infrastructure as Code

L’Infrastructure as Code (IaC) semplifica il deployment e la manutenzione dell’infrastruttura cloud utilizzando linguaggi di programmazione generici o configurazioni YAML. Questo approccio favorisce la creazione di ambienti coerenti, ripetibili e automatizzati, facilitando passaggi fluidi tra sviluppo, test e produzione.

3. Terraform

Terraform è uno strumento open-source di infrastructure as code (IaC) creato da HashiCorp. Consente ai data engineer di definire e distribuire infrastrutture dati, come database e pipeline, in modo coerente e affidabile utilizzando un linguaggio di configurazione dichiarativo, che descrive lo stato finale desiderato dell’infrastruttura invece dei passaggi necessari per raggiungerlo.

Terraform supporta il controllo di versione, la gestione delle risorse via codice, la collaborazione in team e l’integrazione con vari strumenti e piattaforme.

4. Pulumi

Pulumi è uno strumento open-source di infrastructure as code che permette agli sviluppatori di creare, distribuire e gestire infrastrutture cloud usando linguaggi di programmazione generici come JavaScript, TypeScript, Java, Python, Go e C#. Supporta un’ampia gamma di provider cloud, tra cui AWS, Azure, GCP e Kubernetes.

Il framework Pulumi fornisce un’interfaccia a riga di comando (CLI) scaricabile, un software development kit (SDK) e un motore di deployment per offrire una piattaforma solida per il provisioning, l’aggiornamento e la gestione dell’infrastruttura cloud.

Strumenti di orchestrazione dei workflow

Gli strumenti di orchestrazione dei workflow automatizzano e gestiscono l’esecuzione di flussi di elaborazione dati complessi, garantendo che le attività vengano eseguite nell’ordine corretto e gestendo le dipendenze.

5. Prefect

Prefect è uno strumento open-source di orchestrazione dei workflow per flussi di lavoro dati moderni e processi ETL (extract, transform, load). Aiuta data engineer e data scientist ad automatizzare e gestire pipeline complesse, assicurando che i dati fluiscano senza intoppi dalla sorgente alla destinazione in modo affidabile ed efficiente.

Prefect offre un modello di esecuzione ibrido che unisce i vantaggi della gestione in cloud con la sicurezza e il controllo dell’esecuzione locale. La sua interfaccia intuitiva e le API ricche facilitano il monitoraggio e la risoluzione dei problemi dei workflow dati.

6. Luigi

Luigi è un pacchetto Python open-source che aiuta a costruire pipeline complesse di job batch di lunga durata. È stato sviluppato da Spotify per gestire la risoluzione delle dipendenze, la gestione dei workflow, la visualizzazione, la gestione degli errori e l’integrazione da riga di comando.

Luigi è progettato per gestire varie attività, tra cui elaborazione, validazione e aggregazione dei dati, e può essere usato per costruire workflow semplici o sofisticati. Si integra con vari strumenti e piattaforme, come Apache Hadoop e Apache Spark, consentendo di creare pipeline per elaborare e analizzare grandi volumi di dati.

Strumenti di data warehouse

I data warehouse offrono soluzioni cloud altamente scalabili per archiviare, interrogare e gestire grandi dataset.

7. Snowflake

Snowflake è un data warehouse cloud che consente l’archiviazione, l’elaborazione e le query analitiche su grandi volumi di dati. Si basa su un’architettura unica che separa storage e compute, permettendo loro di scalare in modo indipendente.

Snowflake può regolare dinamicamente le risorse di calcolo in base alla domanda. Ciò garantisce che le query vengano elaborate in modo tempestivo, efficiente e conveniente. È compatibile con i principali provider cloud, come AWS, GCP e Azure.

Dai un’occhiata al nostro corso Introduction to Snowflake per esplorare questo strumento più nel dettaglio.

8. PostgreSQL

PostgreSQL è un potente sistema di gestione di database relazionali (RDBMS) open-source che può essere usato anche come data warehouse. Come data warehouse, PostgreSQL fornisce un repository centralizzato per archiviare, gestire e analizzare grandi volumi di dati strutturati da varie fonti.

PostgreSQL offre funzionalità come partizionamento, indicizzazione ed esecuzione parallela delle query che gli consentono di gestire in modo efficiente query complesse e grandi dataset.

Ricorda: un data warehouse PostgreSQL è una soluzione locale che potrebbe non scalare quanto alcune soluzioni completamente gestite. Richiede più amministrazione e manutenzione manuale rispetto a queste.

Scopri di più nella nostra guida per principianti a PostgreSQL.

Strumenti di analytics engineering

Gli strumenti di analytics engineering semplificano la trasformazione, il testing e la documentazione dei dati nel data warehouse.

9. dbt

dbt (data build tool) è uno strumento e framework open-source a riga di comando progettato per facilitare i workflow di trasformazione e modellazione dei dati in un ambiente di data warehouse. Supporta tutti i principali data warehouse, tra cui Redshift, BigQuery, Snowflake e PostgreSQL.

dbt è accessibile tramite dbt Core o dbt Cloud. dbt Cloud offre un’interfaccia web, una CLI basata su dbt Cloud, un ambiente ospitato, uno scheduler dei job integrato e integrazioni con altri strumenti.

Puoi apprendere le basi di dbt con il nostro corso Introduction to dbt.

10. Metabase

Metabase è uno strumento open-source di business intelligence (BI) e analytics che consente di creare e condividere dashboard interattivi e report analitici. È pensato per essere intuitivo, permettendo anche a chi non è tecnico di interrogare i dati, visualizzare i risultati e ottenere insight senza dover conoscere SQL o altri linguaggi di query.

Offre configurazione semplice, supporto per diverse fonti dati, un’interfaccia lineare, funzionalità di collaborazione, notifiche personalizzabili e una solida sicurezza per esplorare, analizzare e condividere i dati.

L’analisi dei dati e la creazione di dashboard fanno parte della data science. Scopri le differenze tra Data Scientist e Data Engineer leggendo questo articolo: Data Scientist vs Data Engineer.

Strumenti per l'elaborazione batch

Questi strumenti per data engineer consentono l’elaborazione efficiente di grandi volumi di dati in batch, eseguendo compiti computazionali complessi, analisi dei dati e applicazioni di machine learning su ambienti di calcolo distribuiti.

11. Apache Spark

Apache Spark è un potente framework open-source di calcolo distribuito progettato per l’elaborazione e l’analisi di dati su larga scala. Pur essendo noto per la capacità di gestire dati in streaming in tempo reale, Spark eccelle anche nell’elaborazione batch, rendendolo uno strumento prezioso nei workflow di data engineering.

Apache Spark offre Resilient Distributed Datasets (RDD), API ricche per vari linguaggi di programmazione, elaborazione dei dati su più nodi in un cluster e integrazione fluida con altri strumenti. È altamente scalabile e veloce, ideale per l’elaborazione batch nelle attività di data engineering.

12. Apache Hadoop

Apache Hadoop è un framework open-source molto diffuso per l’archiviazione e l’elaborazione distribuita di grandi dataset. Al centro dell’ecosistema Hadoop ci sono due componenti chiave: l’Hadoop Distributed File System (HDFS) per lo storage e il modello di programmazione MapReduce per l’elaborazione.

Apache Hadoop è uno strumento potente e scalabile per i data engineer, che offre archiviazione conveniente, tolleranza ai guasti, capacità di elaborazione distribuita e integrazione fluida con altri strumenti di elaborazione dei dati.

Strumenti di streaming

Gli strumenti di streaming offrono un modo potente per costruire pipeline di dati in tempo reale, abilitando acquisizione, elaborazione e analisi continue dei dati in streaming.

13. Apache Kafka

Apache Kafka è una piattaforma distribuita di event streaming progettata per l’elaborazione dati in tempo reale ad alte prestazioni e per ottimizzare pipeline su larga scala. È usata per costruire pipeline in tempo reale, analytics in streaming, integrazione dei dati e applicazioni mission-critical.

Kafka è un sistema in grado di gestire grandi quantità di dati con bassa latenza. Archivia i dati in modo distribuito e tollerante ai guasti, garantendo la disponibilità dei dati anche in caso di guasti hardware o problemi di rete.

Kafka è altamente scalabile e supporta più sottoscrittori. Inoltre, si integra bene con diversi strumenti e framework di elaborazione, come Apache Spark, Apache Flink e Apache Storm.

Apache Flink è una piattaforma open-source per l’elaborazione distribuita di stream e batch. Può elaborare flussi di dati in tempo reale, risultando una scelta popolare per costruire pipeline di streaming e applicazioni di analytics real-time.

Flink è uno strumento di elaborazione che fornisce capacità rapide ed efficienti per l’elaborazione in tempo reale e batch. Supporta diverse API (tra cui Java, Scala e Python), consente un’integrazione fluida con altri strumenti di elaborazione e offre una gestione efficiente dello stato. Per questo è una scelta diffusa per analytics in tempo reale, rilevamento frodi e applicazioni IoT, grazie alla capacità di gestire throughput elevati con bassa latenza.

Conclusione

La lista finisce qui, ma non deve essere la fine del tuo percorso nel data engineering. Iscriviti allo skill track Data Engineer in Python per imparare Python, SQL, progettazione di database, cloud computing, data cleaning e visualizzazione. Una volta completato il track, puoi sostenere l’esame di Data Engineer Career Certification e diventare un Data Engineer certificato.

I data engineer svolgono un ruolo cruciale nel costruire e mantenere le pipeline che alimentano analytics e decisioni in tutta l’organizzazione. Poiché volumi e complessità dei dati continuano a crescere in modo esponenziale, i data engineer devono sfruttare gli strumenti giusti per acquisire, elaborare, archiviare e fornire dati di qualità in modo efficiente.

Abbiamo coperto i 14 principali strumenti di data engineering per containerizzazione, provisioning dell’infrastruttura, automazione dei workflow, data warehousing, analytics engineering, elaborazione batch e streaming in tempo reale.

Se sei alle prime armi con il data engineering, inizia imparando Docker, Kubernetes, Terraform, Prefect, Snowflake, dbt, Apache Spark, Apache Kafka e altri.

Dopo aver acquisito dimestichezza con questi strumenti, dai un’occhiata a The Top 21 Data Engineering Interview Questions, Answers, and Examples per prepararti alla tua prossima mossa professionale.


Abid Ali Awan's photo
Author
Abid Ali Awan
LinkedIn
Twitter

In quanto data scientist certificato, sono appassionato di sfruttare tecnologie all’avanguardia per creare applicazioni di machine learning innovative. Con una solida esperienza in riconoscimento vocale, analisi e reportistica dei dati, MLOps, AI conversazionale e NLP, ho affinato le mie competenze nello sviluppo di sistemi intelligenti in grado di avere un impatto concreto. Oltre alla mia expertise tecnica, sono anche un comunicatore efficace, con il talento di rendere chiari e sintetici concetti complessi. Di conseguenza, sono diventato un blogger molto seguito in ambito data science, condividendo idee ed esperienze con una community in crescita di professionisti dei dati. Attualmente mi concentro sulla creazione e sull’editing di contenuti, lavorando con large language model per sviluppare contenuti potenti e coinvolgenti che possano aiutare aziende e singoli a valorizzare al meglio i propri dati.

Argomenti
Data Engineering

Inizia oggi il tuo percorso da Data Engineer!

Programma

Ingegnere dei dati in Python

40 ore
Acquisisci le competenze più richieste per ingerire, pulire e gestire i dati in modo efficiente e per programmare e monitorare le pipeline, distinguendoti nel campo dell'ingegneria dei dati.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

Mostra AltroMostra Altro

