
{count, plural, one {Corso} other {Corsi}}
Introduzione a dbt
{hours} ore
34.1K
Uno dei concetti preliminari che devi conoscere è quello di data warehouse. Un warehouse è il luogo in cui archivi tutti i dati appartenenti a un’azienda.
Le aziende costruiscono warehouse perché abilitano l’analisi e tutto il resto che puoi fare con i dati (ehm, dati strutturati). Memorizzano dati storici organizzati in tabelle e sono strutturati per query e analisi veloci.
Esistono molti strumenti che implementano data warehouse:
e così via.
dbt non ti aiuta a raccogliere o caricare dati negli strumenti sopra, ma a trasformare i dati al loro interno. In altre parole, fa la T nel processo ETL/ELT (extract, transform, load) che è al cuore di tutti i warehouse.
dbt è offerto tramite due interfacce: dbt Core e dbt Cloud.
dbt Core è una libreria open source che implementa la maggior parte delle funzionalità di dbt. Ha un’interfaccia a riga di comando (il comando dbt che imparerai ad amare) che puoi usare per gestire le trasformazioni dei dati nei tuoi progetti.
dbt Cloud è una soluzione enterprise per i team. Oltre alla CLI, dbt Cloud fornisce anche un IDE web più user-friendly. Con questo, non devi preoccuparti troppo delle connessioni al database e della modifica dei file YAML (come vedrai nelle prossime sezioni).
dbt Cloud offre anche funzionalità aggiuntive come pianificazione dei job, integrazioni avanzate e supporto prioritario.
Ecco una tabella che riassume le differenze tra dbt Core e dbt Cloud:
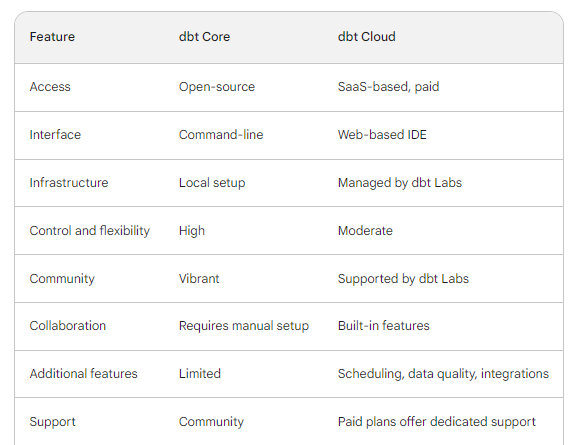
Nonostante le funzionalità extra, tratteremo dbt Core perché è più adatto a progetti locali, test e apprendimento. Puoi installarlo con pip su qualsiasi sistema operativo (dentro un ambiente virtuale, naturalmente).
Userò un ambiente Conda:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
Dovresti sostituire adapter_name con il database che vuoi usare. dbt Labs (l’azienda dietro dbt) ha integrato molti adapter per diverse piattaforme dati.
In questo articolo useremo l’adapter dbt-duckdb per connetterci a un database DuckDB. Ma puoi usare uno qualsiasi degli adapter elencati in questa pagina della documentazione di dbt.
$ pip install dbt-duckdb
Questo è tutto per la configurazione iniziale!
In sostanza, un progetto dbt è una directory sul tuo computer che contiene tutto il necessario per eseguire trasformazioni sui tuoi dati. Contiene molti file .sql (detti modelli) e file YAML (per le configurazioni).
Per creare un progetto dbt, puoi usare il comando dbt init <project_name> nella CLI:
$ dbt init dbt_learnIl terminale ti chiede di inserire un codice che corrisponde agli adapter della tua piattaforma dati disponibili. Dato che hai solo DuckDB, puoi premere 1.
$ cd dbt_learn
All’interno di dbt_learn trovi la seguente struttura:
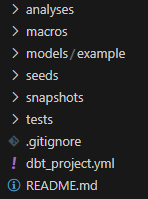
Qui è dove i data engineer diventano software engineer, perché i progetti dbt ti permettono di:
In breve, i progetti dbt offrono un modo potente per gestire e orchestrare le trasformazioni dei dati. Portano nel mondo dei dati i benefici, attesi da tempo, del software engineering.
Abbiamo inizializzato un progetto dbt e ora dobbiamo connetterci a un database esistente (o crearne uno da zero). Per farlo, ci serve un modo sicuro per fornire a dbt le credenziali del database e stabilire una connessione. Qui entra in gioco un profilo di progetto.
Un profilo di progetto è un file YAML che contiene i dettagli di connessione per la piattaforma dati scelta. Il file viene creato nella directory .dbt nella tua $HOME e si chiama profiles.yml. Ecco com’è fatto al momento:
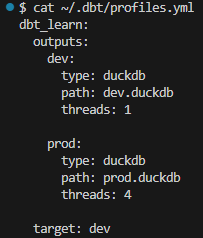
Il file elenca un singolo profilo chiamato dbt_learn per il nostro progetto. Specifica due output: dev e prod.
Gli output sono configurazioni singole che specificano connessioni diverse a data warehouse o database. Attraverso gli output, puoi gestire connessioni a diversi ambienti:
Nel nostro profilo, l’output predefinito è dev, indicato nel campo target. Puoi cambiarlo con qualsiasi altro output in base alle tue esigenze. Per ora, lo lasciamo così com’è.
Nota: puoi cambiare i nomi di profilo e output purché siano referenziati correttamente nel resto dei file dbt.
Il campo path specifica la posizione di un database esistente chiamato dev.duckdb. Se non esiste, verrà creato dall’adapter DuckDB di dbt nella nostra directory di lavoro (all’interno del progetto dbt_learn; il campo path specifica percorsi relativi alla directory del progetto). Dato che non abbiamo un database chiamato dev.duckdb, lasceremo che sia dbt a crearlo eseguendo dbt debug.
$ dbt debug
Il sotto-comando debug serve per testare molti aspetti del progetto, come:
profiles.ymlprofiles.ymldbt_project.yml e altro.Se hai ricevuto un messaggio verde “Tutti i test superati” e è apparso un nuovo database dev.duckdb, sei a posto.
I modelli sono il cuore di dbt, perché rappresentano le trasformazioni vere e proprie per cui dbt è famoso.
Un data model è un’idea concettuale che rappresenta la struttura e le relazioni all’interno di un insieme di dati. I modelli in dbt sono più semplici e specifici. Hanno le seguenti caratteristiche:
.sql (Python è consentito nelle versioni più recenti di dbt)Il nostro progetto dbt_learn arriva pre-popolato con due modelli di esempio in models/example:
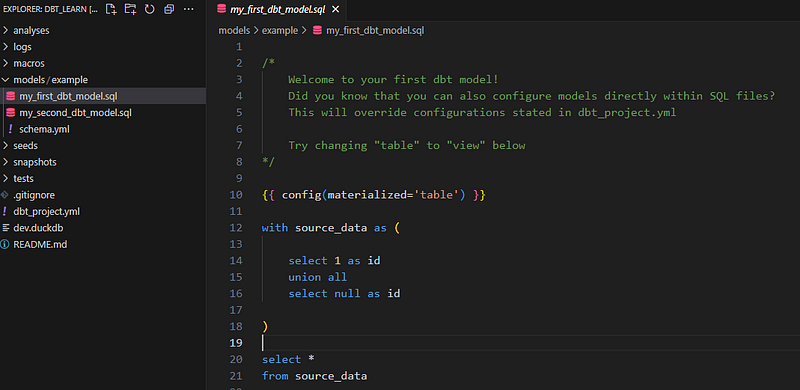
Li elimineremo e creeremo i nostri:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
Nell’ultima riga dello snippet sopra, stiamo creando un modello chiamato average_diamond_price_per_group dentro la directory stats. È importante dare nomi descrittivi ai modelli.
All’interno del modello (file .sql), incolla questa query SQL di prova:
SELECT 1 AS Id
e avvia il modello con dbt run:
$ dbt run
Dovresti ricevere un messaggio verde “Completato con successo”.
Dopo aver impostato tutto, possiamo caricare alcuni dati nel nostro database dev.duckdb. Useremo un file parquet per farlo, dato che DuckDB li supporta nativamente.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
La query dovrebbe restituire lo stesso messaggio di successo.
Per questo tutorial, ho preparato il dataset diamonds come file parquet. In questa gist su GitHub trovi lo snippet per scaricarlo nel tuo workspace.
Abbiamo appena visto come creare il nostro primo modello dbt usando una SELECT che restituisce alcune statistiche di riepilogo su un dataset. Nella pratica, i tuoi modelli dipenderanno dai requisiti di business e da come diversi colleghi lavorano con il database. Perciò non ci concentreremo sulla logica specifica dei modelli dbt, ma su come implementarli correttamente.
In un progetto reale, con ogni probabilità i tuoi modelli dipenderanno l’uno dall’altro, formando una sorta di gerarchia. Nel mondo dei dati, questa gerarchia si chiama DAG (Direct Acyclic Graph) o grafo di lineage.
Un singolo DAG può valere quanto una documentazione di 1000 parole. Dai un’occhiata a questo esempio dalla pagina sui DAG di dbt:
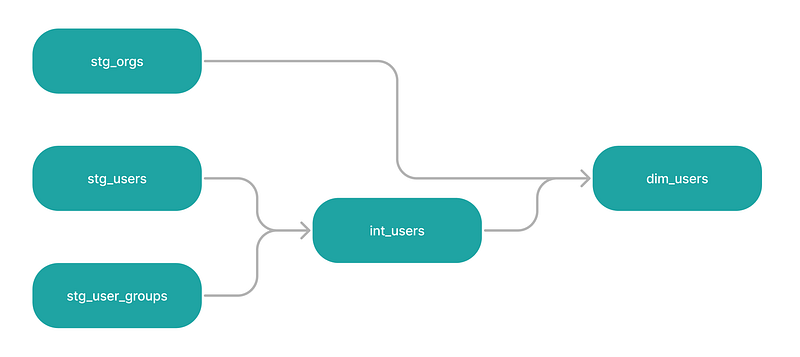
In questo grafo ci sono quattro modelli, tutti collegati linearmente ai modelli a valle. stg_users e stg_user_groups sono modelli padre di int_users che, a sua volta, è un modello padre di dim_users insieme al modello stg_orgs a monte.
Nota: i termini upstream e downstream sono usati di frequente per indicare la posizione relativa di ciascun modello nel DAG.
Un aspetto chiave dei DAG è l’assenza di cicli chiusi. Questo significa che un modello a valle, che è il risultato di modelli precedenti, non può essere unito con un modello a monte. Da qui il termine aciclico.
Oltre alla ricchezza visiva, lo scopo dei DAG è permettere a dbt di costruire/aggiornare i modelli secondo le loro dipendenze. Se non definiamo un DAG per i quattro modelli sopra, dbt li costruirà in ordine alfabetico. Questo porterebbe a vari messaggi rossi ed errori.
Per definire un DAG in dbt, useremo il templating Jinja.
Nel DAG sopra, il modello int_users è il risultato di stg_users e stg_user_groups. Dobbiamo specificare questa relazione nel nostro progetto, altrimenti dbt run esegue tutti i modelli in ordine alfabetico, il che significa che int_users va per primo. Ciò genererà un errore, poiché le sue dipendenze non sono ancora materializzate.
Al momento, il modello int_users potrebbe essere così:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Ora collegheremo i tre modelli trasformandoli in nodi di un DAG usando Jinja:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
Invece di scrivere direttamente i nomi dei modelli, li inseriamo in una funzione Jinja chiamata ref. La sintassi è {{ ref("column_name") }} (attenzione agli spazi e alle virgolette). Quando la query viene compilata, la funzione Jinja viene sostituita con il vero nome del modello.
Nota che stg_users e stg_user_groups devono esistere come file .sql nel tuo progetto dbt.
Ora, quando eseguiamo dbt run, dbt cercherà le dipendenze di ogni modello, le collegherà ed eseguirà il tutto di conseguenza.
La funzione ref in Jinja non è l’unica che possiamo usare in dbt. Anzi, usando altre funzioni e funzionalità di Jinja puoi espandere notevolmente le capacità delle tue istruzioni SQL. Ecco alcuni esempi:
{% set status = 'active' %}  -- Define a variable

SELECT *
FROM customers
WHERE status = {{ status }};
Se abbiamo il file models/model_properties.yml con i seguenti campi:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Possiamo accedere ai suoi campi dentro qualsiasi file .sql usando Jinja:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
Condizionali:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Loop:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
Ecco la macro:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
Ecco come puoi usarla nei modelli:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
Se vuoi approfondire l’uso di Jinja in dbt con SQL, consulta questa pagina della documentazione di dbt.
Un buon sviluppatore sa che deve testare costantemente il proprio codice per bug ed errori. Poiché dbt trasforma i data engineer in software developer, offre un flusso di lavoro semplice per usare test, sia integrati che personalizzati.
Attualmente, dbt offre i seguenti quattro test integrati:
unique - verifica che tutti i valori siano unicinot_null - controlla i valori mancantiaccepted_values - verifica che tutti i valori siano all’interno di un elenco specificato, ha un argomento valuesrelationships - verifica una connessione a una specifica tabella o colonna, ha gli argomenti to e fieldPer specificare quali test usare su quali colonne, utilizziamo un file YAML chiamato model_properties.yml all’interno della directory models.
Nota: model_properties.yml non è necessario per l’esecuzione dei modelli e può avere qualsiasi nome. Ma, se vuoi creare test per validare i dati che alimentano i tuoi modelli, questo file è indispensabile.
Vediamo come usare il test not_null per controllare i valori mancanti nella colonna cut della tabella diamonds. Per prima cosa, crea un file model_properties.yml dentro models:
$ touch models/model_properties.yml
All’interno, incolla il seguente contenuto:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
Nel campo - name sotto models, specifichiamo per quale modello stiamo definendo le proprietà. Poi indichiamo la colonna e il suo nome. Infine, scriviamo il campo tests, sotto il quale elenchiamo il test not_null.
Ora puoi usare questo test per eseguire la validazione dei dati prima di lanciare dbt run. Il comando è dbt test:
$ dbt test
Se ricevi un messaggio di errore, significa che il test non è passato e devi esaminare il problema nella tabella e, se necessario, risolverlo.
Per usare dbt con successo nei tuoi progetti, puoi seguire questo workflow consigliato:
1. Inizializzazione del progetto
dbt e crea un nuovo progetto con dbt init2. Configurazione
profiles.yml nella tua home directory.dbt_project.yml per le impostazioni a livello di progetto (ad es. versione, dipendenze).3. Sviluppo
.sql nella directory models per le definizioni dei modelli..yml nella directory tests per le definizioni dei test.dbt test per eseguire spesso i test durante lo sviluppo.dbt debug per la risoluzione dei problemi.4. Validazione locale (argomenti che non abbiamo trattato)
Best practice aggiuntive:
dbt docs generate per pubblicare in seguito la documentazione dei modelli su un server web (sì, si può!).Abbiamo coperto molte basi in questo tutorial, ma come ho detto all’inizio, dbt è uno strumento enorme con tante funzionalità. Ci vorrà un po’ per padroneggiarlo al punto da usarlo con tranquillità in ambienti di produzione. Perché non usare queste risorse per arrivarci più in fretta?
Inizia oggi il tuo percorso con dbt!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min



