
Corso
MLOps completamente automatizzato
4 ore
6.5K
L’Automated Machine Learning (AutoML) è spesso frainteso.
Molti nel mondo tech pensano che gli strumenti AutoML siano destinati solo a utenti business o team non tecnici che non conoscono come vengono addestrati o distribuiti i modelli di machine learning. Questa supposizione è errata.
Nella pratica, data scientist e ML engineer usano regolarmente i framework AutoML per ridurre i tempi di sperimentazione, migliorare le prestazioni dei modelli e automatizzare le fasi ripetitive del ciclo di vita del machine learning.
Questi strumenti AutoML supportano attività come feature engineering, selezione dei modelli, ottimizzazione degli iperparametri e automazione end-to-end delle pipeline, permettendo ai team di concentrarsi su lavori a maggior valore.
In questo articolo esplorerò alcuni dei migliori framework AutoML disponibili oggi, pensati per utenti con diversi livelli di esperienza. Gli strumenti sono raggruppati in tre categorie chiare:
Per ogni framework evidenziamo le caratteristiche principali e forniamo codice di esempio per iniziare subito a usarlo.
AutoML indica strumenti e sistemi che automatizzano l’intero processo di sviluppo dei modelli di machine learning, dai dati grezzi a un modello addestrato e distribuibile.
I framework AutoML gestiscono molte delle attività ripetitive e tecniche coinvolte nella costruzione dei modelli di machine learning, così che sia i professionisti esperti sia gli utenti meno tecnici possano lavorare in modo più efficiente.
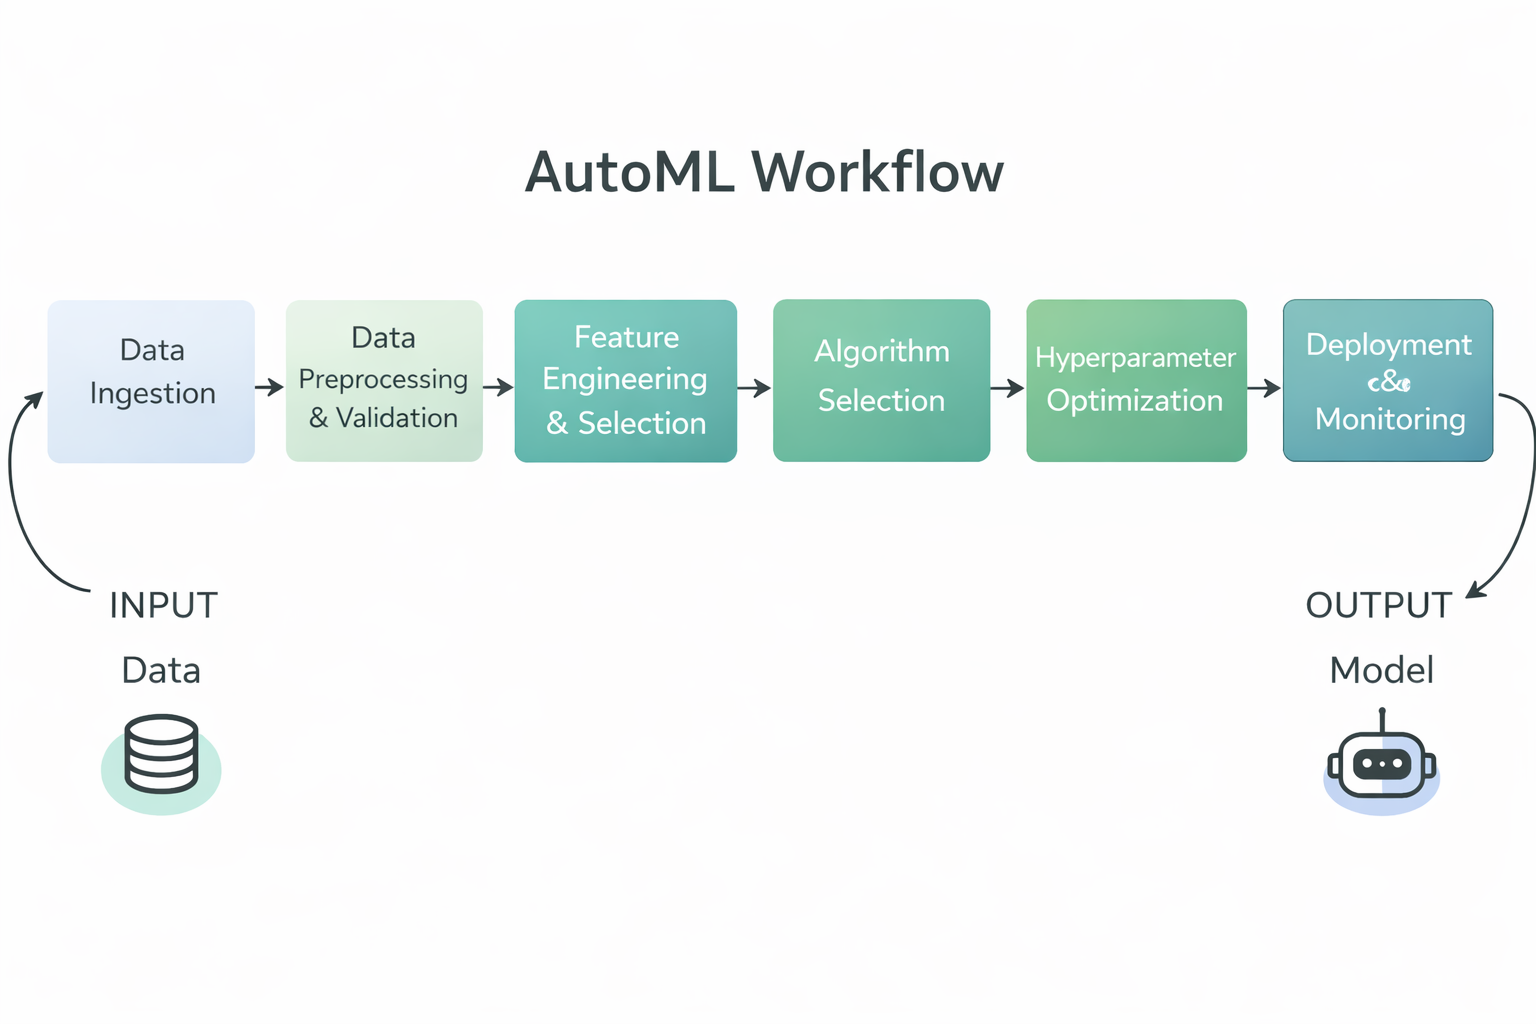
Diagramma del workflow AutoML
In particolare, i framework AutoML in genere automatizzano i seguenti passaggi del workflow di machine learning:
Automatizzando queste attività, i framework AutoML riducono il lavoro manuale, migliorano coerenza e riproducibilità e permettono sia ai team tecnici sia a quelli non tecnici di costruire più rapidamente modelli di machine learning di alta qualità.
I framework AutoML open source offrono strumenti flessibili, trasparenti e a misura di sviluppatore che permettono di automatizzare la costruzione dei modelli mantenendo il pieno controllo su dati, pipeline e workflow di deployment.
TPOT è un framework AutoML open source per Python che usa la programmazione genetica per scoprire e ottimizzare automaticamente pipeline di machine learning complete.
Imposta il design della pipeline come un problema di ricerca evolutiva, esplorando combinazioni di passaggi di preprocessamento, modelli e iperparametri per identificare soluzioni ad alte prestazioni.
TPOT è particolarmente efficace per attività su dati tabellari quando servono sperimentazioni rapide e baseline solide, pur consentendo di ispezionare, esportare e riutilizzare le pipeline risultanti all’interno dei flussi di lavoro standard di scikit-learn.
Caratteristiche principali:
Esempio di codice:
Questo esempio mostra la configurazione minima per usare TPOT. Si caricano feature e label del dataset, si inizializza un TPOTClassifier con le impostazioni predefinite e il metodo fit avvia il processo di ricerca automatizzata.
Durante l’addestramento, TPOT valuta più pipeline candidate usando la programmazione genetica e seleziona un modello ad alte prestazioni in base alla metrica di valutazione specificata.
import tpot
X, y = load_my_data()
est = tpot.TPOTClassifier()
est.fit(X, y)AutoGluon è un framework AutoML open source per Python sviluppato da AWS AI che automatizza i compiti di machine learning con focus su alta accuratezza, codice minimo e supporto per dati tabellari, di testo e immagini.
Costruisce un set diversificato di modelli e usa selezione automatica, ottimizzazione degli iperparametri ed ensemble learning per offrire prestazioni predittive solide su diversi tipi di dati.
Caratteristiche principali:
Esempio di codice:
Questo codice carica i dataset di training e test come dataset tabellari di AutoGluon. Crea quindi un oggetto TabularPredictor specificando la label target e chiama fit per addestrare AutoGluon sui dati tabellari di training. Al termine, usa il modello per generare predizioni sul set di test.
from autogluon.tabular import TabularDataset, TabularPredictor

label = "signature"
train_data = TabularDataset("train.csv")

predictor = TabularPredictor(label=label).fit(train_data)

test_data = TabularDataset("test.csv")
predictions = predictor.predict(test_data.drop(columns=[label]))FLAML (Fast Lightweight AutoML) è una libreria AutoML open source per Python sviluppata da Microsoft Research, progettata per trovare automaticamente ed efficientemente modelli di machine learning di alta qualità minimizzando costi computazionali e uso di risorse, ideale in contesti in cui velocità ed efficienza contano di più.
Caratteristiche principali:
Esempio di codice:
Questo esempio mostra come usare la classe AutoML di FLAML per eseguire una classificazione automatizzata sul dataset Iris, specificando un budget di tempo e la metrica di valutazione prima dell’addestramento e poi usando il modello per ottenere probabilità predittive.
from flaml import AutoML
from sklearn.datasets import load_iris

X_train, y_train = load_iris(return_X_y=True)

automl = AutoML()

automl_settings = {
    "time_budget": 1,
    "metric": "accuracy",
    "task": "classification",
    "log_file_name": "iris.log",
}

automl.fit(X_train=X_train, y_train=y_train, **automl_settings)

print(automl.predict_proba(X_train))AutoKeras è una libreria AutoML open source costruita sopra il framework di deep learning Keras che cerca e addestra automaticamente reti neurali di alta qualità per un’ampia gamma di task, inclusi dati strutturati, immagini e testo, con un minimo di codice.
Usa una ricerca efficiente dell’architettura neurale per trovare architetture e iperparametri adatti, rendendo il deep learning più accessibile sia ai principianti sia ai professionisti esperti.
Caratteristiche principali:
StructuredDataClassifier semplificano l’addestramento di modelli di deep learning complessi con poche righe di codice.Esempio di codice:
Questo esempio importa le librerie necessarie e carica i dataset di training e test dagli URL forniti. Separa feature e label, quindi crea un oggetto ak.StructuredDataClassifier che cerca automaticamente un modello di deep learning efficace. Il modello viene addestrato per un numero definito di prove ed epoche, e il risultato finale di valutazione sul set di test viene stampato.
import keras
import pandas as pd
import autokeras as ak

TRAIN_DATA_URL = "https://storage.googleapis.com/tf-datasets/titanic/train.csv"
TEST_DATA_URL = "https://storage.googleapis.com/tf-datasets/titanic/eval.csv"

train_file_path = keras.utils.get_file("train.csv", TRAIN_DATA_URL)
test_file_path = keras.utils.get_file("eval.csv", TEST_DATA_URL)

train_df = pd.read_csv(train_file_path)
test_df = pd.read_csv(test_file_path)

y_train = train_df["survived"].values
x_train = train_df.drop("survived", axis=1).values

y_test = test_df["survived"].values
x_test = test_df.drop("survived", axis=1).values

clf = ak.StructuredDataClassifier(overwrite=True, max_trials=3)
clf.fit(x_train, y_train, epochs=10)

print(clf.evaluate(x_test, y_test))Le piattaforme AutoML no-code e low-code semplificano lo sviluppo dei modelli astraendo i workflow complessi, abilitando sperimentazione e deployment rapidi per team tecnici e utenti business.
PyCaret è una libreria di machine learning open source e low-code in Python che automatizza il workflow end-to-end per task come classificazione, regressione, clustering, rilevamento anomalie e forecasting di serie temporali, consentendo prototipazione rapida con poche righe di codice e supportando anche un’interfaccia grafica per chi preferisce esperienze low-code o point-and-click.
Caratteristiche principali:
compare_models addestra e valuta molti modelli con cross-validation e fornisce una classifica delle prestazioni per scegliere il migliore.Esempio di codice:
Questo snippet mostra come caricare un dataset integrato, inizializzare il modulo di regressione di PyCaret con setup (che pre-elabora i dati e inizializza l’ambiente ML) e poi usare compare_models per addestrare, valutare e classificare automaticamente vari modelli di regressione, restituendo il migliore.
from pycaret.datasets import get_data
from pycaret.regression import *

data = get_data("insurance")

s = setup(data, target="charges", session_id=123)

best_model = compare_models()MLJAR Studio è un ambiente AutoML no-code e low-code che ti consente di addestrare e confrontare modelli di machine learning tramite un’interfaccia guidata, offrendo anche un workflow opzionale in Python tramite il motore open source mljar-supervised.
Caratteristiche principali:
Esempio di codice:
Non serve codice per usare MLJAR Studio perché puoi eseguire l’AutoML dalla GUI. Tuttavia, il codice seguente mostra l’approccio programmatico opzionale usando la libreria mljar-supervised. Carica un dataset, lo divide in feature e target, esegue il training AutoML e poi genera predizioni usando il modello addestrato.
import pandas as pd
from supervised.automl import AutoML

df = pd.read_csv(
    "https://raw.githubusercontent.com/pplonski/datasets-for-start/master/adult/data.csv",
    skipinitialspace=True,
)

X = df[df.columns[:-1]]
y = df["income"]

automl = AutoML(results_path="mljar_results")
automl.fit(X, y)

predictions = automl.predict(X)H2O AutoML è una funzionalità AutoML open source all’interno della piattaforma H2O che offre machine learning automatizzato e scalabile con supporto per Python, R e una interfaccia grafica no-code chiamata H2O Flow, permettendo a utenti tecnici e non tecnici di costruire, valutare e selezionare modelli con codice minimo. Gli utenti possono lavorare tramite l’interfaccia web Flow per importare dati, eseguire esperimenti AutoML, esplorare i risultati ed esportare i modelli senza scrivere codice.
Caratteristiche principali:
Esempio di codice:
Questo esempio mostra come usare H2O AutoML tramite Python. Inizializza l’ambiente H2O, importa i dataset di training e test, specifica colonne di feature e target, avvia un run AutoML con un limite al numero di modelli e poi mostra una classifica dei migliori modelli.
Nota: sebbene questo sia l’approccio programmatico, le stesse attività possono essere svolte tramite l’interfaccia web H2O Flow senza scrivere codice.
import h2o
from h2o.automl import H2OAutoML

h2o.init()

train = h2o.import_file(
    "https://s3.amazonaws.com/h2o-public-test-data/smalldata/higgs/higgs_train_10k.csv"
)
test = h2o.import_file(
    "https://s3.amazonaws.com/h2o-public-test-data/smalldata/higgs/higgs_test_5k.csv"
)

x = train.columns
y = "response"
x.remove(y)

train[y] = train[y].asfactor()
test[y] = test[y].asfactor()

aml = H2OAutoML(max_models=20, seed=1)
aml.train(x=x, y=y, training_frame=train)

aml.leaderboardLe soluzioni AutoML enterprise offrono piattaforme di machine learning scalabili, sicure e governate, progettate per il deployment in produzione, la conformità e l’uso operativo su larga scala.
DataRobot è una piattaforma AutoML no-code e low-code di livello enterprise che consente a utenti business, analisti e team dati di costruire, distribuire e gestire modelli di machine learning senza programmazione estesa.
La piattaforma automatizza l’intero ciclo di vita del ML, dall’ingestione dei dati e feature engineering fino al training, deployment e monitoraggio dei modelli, offrendo al contempo governance, spiegabilità e controlli operativi necessari in ambienti regolamentati.
Caratteristiche principali:
Esempio di codice:
Sebbene DataRobot sia usato principalmente tramite l’interfaccia no-code, fornisce anche una API Python per controllo programmatico e automazione. L’esempio seguente mostra come autenticarsi su DataRobot, creare un progetto da un dataset ed eseguire AutoPilot per addestrare e valutare automaticamente i modelli.
import datarobot as dr
dr.Client(config_path="./drconfig.yaml")

dataset = dr.Dataset.create_from_file("auto-mpg.csv")

project = dr.Project.create_from_dataset(
    dataset.id,
    project_name="Auto MPG Project"
)

from datarobot import AUTOPILOT_MODE
project.analyze_and_model(
    target="mpg",
    mode=AUTOPILOT_MODE.QUICK
)

project.wait_for_autopilot()Amazon SageMaker Autopilot è una soluzione AutoML completamente gestita di AWS che consente di automatizzare il workflow end-to-end di machine learning con no code o low code, in particolare tramite un’interfaccia web in Amazon SageMaker Canvas o SageMaker Studio.
Gli utenti possono importare dati, configurare la variabile target, valutare i modelli candidati e distribuire i modelli con pochi clic nella console, mentre SDK Python e API restano disponibili come modalità opzionale per rendere gli esperimenti riproducibili o integrarli con altri sistemi.
Caratteristiche principali:
Esempio di codice:
Il codice seguente mostra come eseguire Amazon SageMaker Autopilot in modo programmatico tramite l’SDK Python. Questo approccio è opzionale e può essere usato per riprodurre risultati o integrare in pipeline automatizzate.
from sagemaker import AutoML, AutoMLInput

automl = AutoML(
    role=execution_role,
    target_attribute_name=target_attribute_name,
    sagemaker_session=pipeline_session,
    total_job_runtime_in_seconds=3600,
    mode="ENSEMBLING",
)

automl.fit(
    inputs=[
        AutoMLInput(
            inputs=s3_train_val,
            target_attribute_name=target_attribute_name,
            channel_type="training",
        )
    ]
)Google Cloud AutoML fa parte di Vertex AI, la piattaforma unificata di machine learning di Google Cloud che consente di costruire, addestrare, valutare e distribuire modelli di alta qualità su infrastruttura completamente gestita.
Vertex AI AutoML supporta dati tabellari, NLP, computer vision e video, ed è progettato per essere accessibile tramite un’interfaccia web no-code nella Google Cloud Console.
Tutti i passaggi principali, come creazione del dataset, selezione del task, training, valutazione e deployment, possono essere completati tramite la UI senza scrivere codice.
Caratteristiche principali:
Esempio di codice:
Sebbene Vertex AI AutoML sia pensato principalmente per workflow no-code, l’SDK Python può essere usato per rendere gli esperimenti riproducibili o integrare il training AutoML in pipeline automatizzate.
Il breve snippet seguente inizializza un progetto Vertex AI, crea un dataset di immagini da un indice CSV archiviato in Cloud Storage e avvia un job di training AutoML per immagini.
from google.cloud import aiplatform

aiplatform.init(
    project="YOUR_PROJECT_ID",
    location="us-central1",
    staging_bucket="gs://YOUR_BUCKET",
)

dataset = aiplatform.ImageDataset.create(
    display_name="flowers",
    gcs_source=["gs://cloud-samples-data/ai-platform/flowers/flowers.csv"],
    import_schema_uri=aiplatform.schema.dataset.ioformat.image.single_label_classification,
)

training_job = aiplatform.AutoMLImageTrainingJob(
    display_name="flowers_automl",
    prediction_type="classification",
)

model = training_job.run(
    dataset=dataset,
    model_display_name="flowers_model",
    budget_milli_node_hours=8000,
)Questa tabella confronta i principali framework AutoML in base al livello di automazione, allo stile dell’interfaccia e all’idoneità per sperimentazione open source, workflow low-code e deployment su scala enterprise.
|
Framework |
Categoria |
Livello di codice |
Opzioni di interfaccia |
Caso d’uso principale |
|
TPOT |
Open source |
Alto |
API Python |
Scoperta e ottimizzazione automatica di pipeline per dati tabellari |
|
AutoGluon |
Open source |
Basso |
API Python |
Modelli veloci, accurati e pronti per la produzione su più modalità |
|
FLAML |
Open source |
Basso |
API Python |
Tuning dei modelli efficiente nei costi e attento alle risorse |
|
AutoKeras |
Open source |
Medio |
API Python |
Ricerca di architetture neurali e automazione del deep learning |
|
PyCaret |
Low code |
Molto basso |
API Python, strumenti GUI opzionali |
Sperimentazione rapida e workflow guidati dall’analisi |
|
MLJAR Studio |
No code |
Nessuno |
Web UI, Python opzionale |
Sperimentazione AutoML a misura di business e confronto tra modelli |
|
H2O AutoML |
Ibrido |
Basso |
Web UI (H2O Flow), Python, R |
AutoML scalabile per grandi dataset e deployment enterprise |
|
DataRobot |
Enterprise |
Da nessuno a basso |
Web UI, API Python |
ML enterprise con governance, spiegabilità e MLOps |
|
SageMaker Autopilot |
Enterprise |
Da nessuno a basso |
Console AWS, SDK Python |
AutoML nativo AWS integrato con pipeline di produzione |
|
Google Cloud AutoML |
Enterprise |
Nessuno |
Console Vertex AI, SDK opzionale |
Vision, NLP e AutoML tabellare su infrastruttura GCP gestita |
I framework AutoML sono maturati fino a diventare strumenti di livello produzione che supportano i team lungo l’intero ciclo di vita del machine learning. Nella pratica non si limitano alla sperimentazione o alla prototipazione.
Ho usato framework AutoML per partecipare a competizioni Kaggle, per costruire pipeline di machine learning end-to-end per progetti reali e persino per prepararmi e avere successo in colloqui tecnici.
Dal punto di vista di un data scientist, l’AutoML è un modo potente per stabilire un modello baseline solido e imparziale con pochissimo overhead.
Fornendo semplicemente i dati, questi framework si occupano di feature engineering, selezione dei modelli, tuning degli iperparametri e valutazione. Questo permette di concentrarsi sulla comprensione del problema, sulla validazione delle ipotesi e sul miglioramento dei risultati, invece di spendere tempo eccessivo a ricercare e testare modelli da zero.
L’AutoML non sostituisce l’esperienza. Piuttosto, accelera il workflow fornendo un punto di partenza affidabile che può essere migliorato iterativamente.
La costruzione del modello è solo il primo passo. Scopri come distribuire e monitorare i tuoi modelli AutoML in produzione con il corso MLOps Concepts.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



