
कोर्स
फ़ुली ऑटोमेटेड MLOps
4 घंटा
6.5K
ऑटोमेटेड मशीन लर्निंग (AutoML) को अक्सर गलत समझा जाता है।
टेक जगत में कई लोग मानते हैं कि AutoML टूल केवल बिज़नेस यूज़र्स या गैर-तकनीकी टीमों के लिए होते हैं, जो यह नहीं समझते कि मशीन लर्निंग मॉडल कैसे प्रशिक्षित या डिप्लॉय किए जाते हैं। यह धारणा गलत है।
वास्तव में, डेटा वैज्ञानिक और मशीन लर्निंग इंजीनियर प्रयोग करने के समय को घटाने, मॉडल प्रदर्शन सुधारने और मशीन लर्निंग लाइफसाइकिल के दोहराव वाले चरणों को स्वचालित करने के लिए नियमित रूप से AutoML फ्रेमवर्क का उपयोग करते हैं।
ये AutoML टूल फ़ीचर इंजीनियरिंग, मॉडल चयन, हाइपरपैरामीटर ट्यूनिंग और एंड-टू-एंड पाइपलाइन ऑटोमेशन जैसे कार्यों में सहायक होते हैं, जिससे टीमें उच्च-मूल्य के कार्यों पर ध्यान केंद्रित कर सकें।
इस लेख में, मैं आज उपलब्ध शीर्ष AutoML फ्रेमवर्क का अन्वेषण करूंगा, जिन्हें अलग-अलग विशेषज्ञता स्तरों के उपयोगकर्ताओं के लिए डिज़ाइन किया गया है। टूल्स को तीन स्पष्ट श्रेणियों में समूहीकृत किया गया है:
प्रत्येक फ्रेमवर्क के लिए, हम इसकी प्रमुख विशेषताओं को उजागर करते हैं और उदाहरण कोड प्रदान करते हैं ताकि आप तुरंत इसका उपयोग शुरू कर सकें।
AutoML उन टूल्स और सिस्टम्स को संदर्भित करता है जो कच्चे डेटा से लेकर प्रशिक्षित, डिप्लॉय करने योग्य मॉडल तक पूरे मशीन लर्निंग मॉडल विकास प्रक्रिया को स्वचालित करते हैं।
AutoML फ्रेमवर्क मशीन लर्निंग मॉडल बनाने में शामिल कई दोहरावदार और तकनीकी कार्यों को संभालते हैं ताकि विशेषज्ञ प्रैक्टिशनर और कम तकनीकी उपयोगकर्ता दोनों अधिक कुशलता से काम कर सकें।
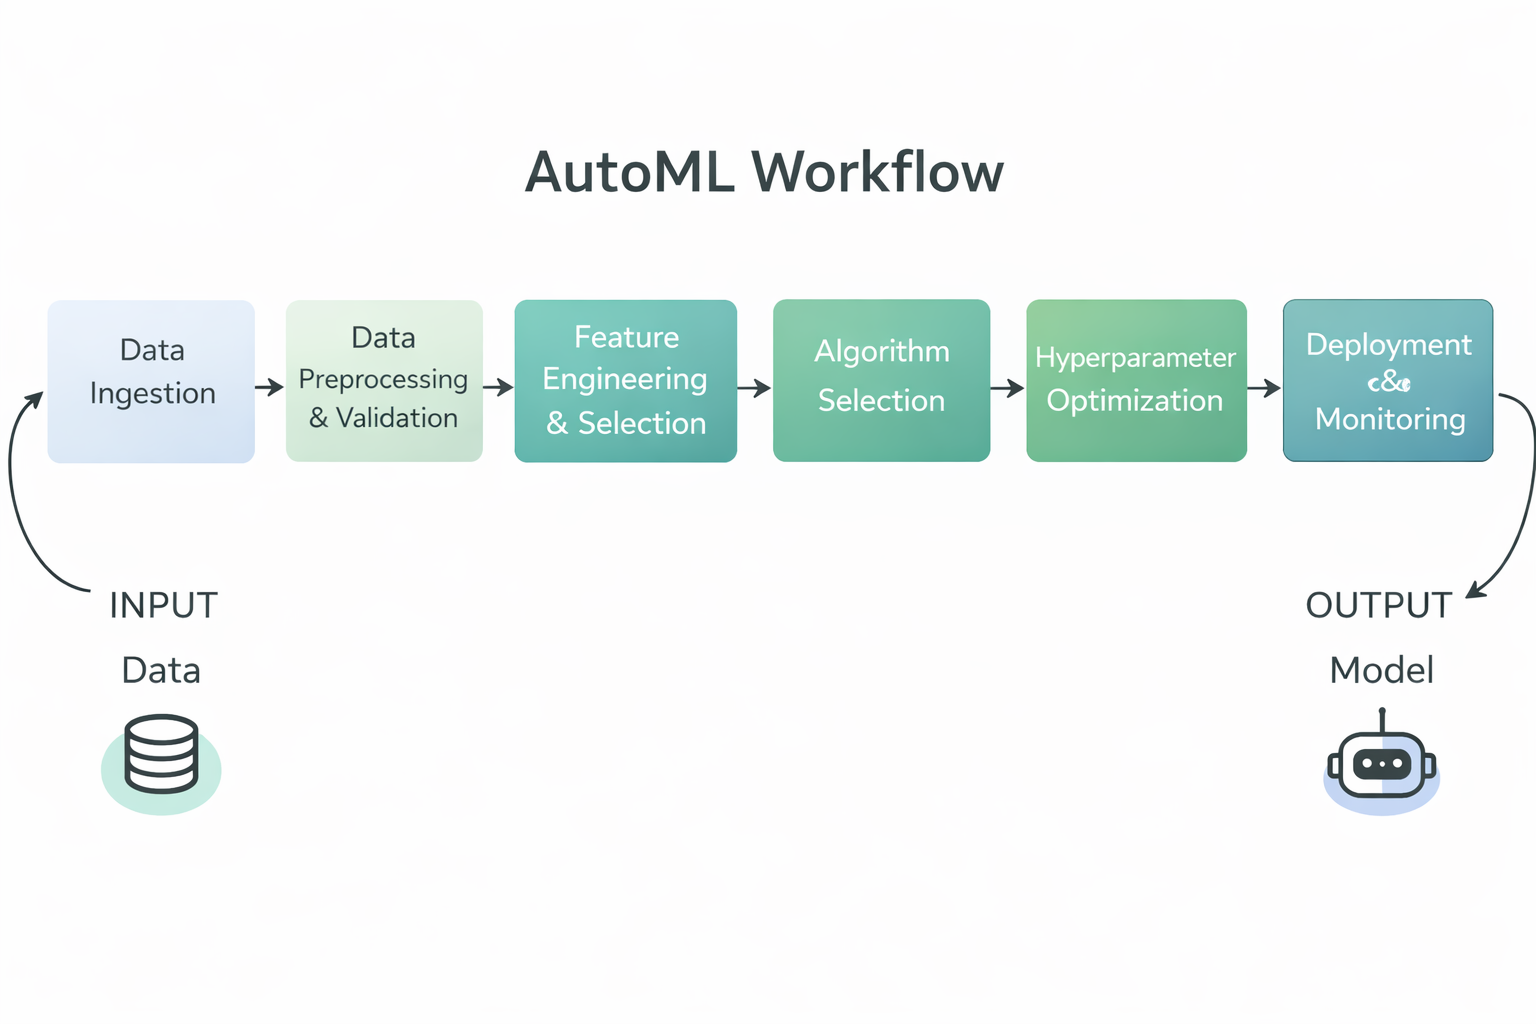
AutoML वर्कफ़्लो डायग्राम
विशेष रूप से, AutoML फ्रेमवर्क आमतौर पर मशीन लर्निंग वर्कफ़्लो में निम्नलिखित चरणों को स्वचालित करते हैं:
इन कार्यों को स्वचालित करके, AutoML फ्रेमवर्क मैनुअल प्रयास घटाते हैं, स्थिरता और पुनरुत्पादकता में सुधार करते हैं, और तकनीकी व गैर-तकनीकी दोनों टीमों के लिए उच्च-गुणवत्ता वाले मशीन लर्निंग मॉडल जल्दी बनाना संभव बनाते हैं।
ओपन सोर्स AutoML फ्रेमवर्क लचीले, पारदर्शी और डेवलपर-फ्रेंडली टूल प्रदान करते हैं, जो प्रैक्टिशनर्स को डेटा, पाइपलाइनों और डिप्लॉयमेंट वर्कफ़्लोज़ पर पूर्ण नियंत्रण बनाए रखते हुए मॉडल बिल्डिंग स्वचालित करने देते हैं।
TPOT एक ओपन सोर्स Python AutoML फ्रेमवर्क है जो जनेटिक प्रोग्रामिंग का उपयोग करके संपूर्ण मशीन लर्निंग पाइपलाइनों की स्वतः खोज और ऑप्टिमाइज़ेशन करता है।
यह पाइपलाइन डिज़ाइन को एक इवोल्यूशनरी सर्च समस्या के रूप में फ्रेम करता है, प्रीप्रोसेसिंग चरणों, मॉडलों और हाइपरपैरामीटर्स के संयोजनों का अन्वेषण करके उच्च-प्रदर्शन समाधान पहचानता है।
TPOT विशेष रूप से टैब्युलर डेटा कार्यों के लिए प्रभावी है, जहाँ तेज़ प्रयोग और मजबूत बेसलाइन्स की आवश्यकता होती है, और साथ ही प्रैक्टिशनर्स को परिणामी पाइपलाइनों का निरीक्षण, निर्यात और मानक scikit-learn वर्कफ़्लो में पुन: उपयोग करने की अनुमति देता है।
मुख्य विशेषताएँ:
कोड उदाहरण:
यह उदाहरण TPOT का उपयोग करने के लिए आवश्यक न्यूनतम सेटअप दिखाता है। डेटासेट के फीचर्स और लेबल लोड किए जाते हैं, एक TPOTClassifier डिफ़ॉल्ट सेटिंग्स के साथ इनिशियलाइज़ किया जाता है, और fit मेथड स्वचालित सर्च प्रक्रिया को ट्रिगर करता है।
प्रशिक्षण के दौरान, TPOT जनेटिक प्रोग्रामिंग का उपयोग करके कई उम्मीदवार पाइपलाइनों का मूल्यांकन करता है और निर्दिष्ट मूल्यांकन मीट्रिक के आधार पर उच्च-प्रदर्शन मॉडल का चयन करता है।
import tpot
X, y = load_my_data()
est = tpot.TPOTClassifier()
est.fit(X, y)AutoGluon AWS AI द्वारा विकसित एक ओपन-सोर्स Python AutoML फ्रेमवर्क है जो उच्च सटीकता, न्यूनतम कोड और टैब्युलर, टेक्स्ट और इमेज डेटा के समर्थन पर केंद्रित होकर मशीन लर्निंग कार्यों को स्वचालित करता है।
यह मॉडलों का विविध सेट बनाता है और स्वचालित मॉडल चयन, हाइपरपैरामीटर ट्यूनिंग और एंसेंबल लर्निंग का उपयोग करके अलग-अलग डेटा प्रकारों में मजबूत प्रेडिक्टिव प्रदर्शन देता है।
मुख्य विशेषताएँ:
कोड उदाहरण:
यह कोड प्रशिक्षण और परीक्षण डेटासेट को AutoGluon टैब्युलर डेटासेट के रूप में लोड करता है। फिर यह लक्ष्य लेबल निर्दिष्ट करते हुए एक TabularPredictor ऑब्जेक्ट बनाता है और fit कॉल करके टैब्युलर प्रशिक्षण डेटा पर AutoGluon को प्रशिक्षित करता है। प्रशिक्षण के बाद, यह प्रशिक्षित मॉडल का उपयोग करके परीक्षण सेट पर प्रेडिक्शंस बनाता है।
from autogluon.tabular import TabularDataset, TabularPredictor

label = "signature"
train_data = TabularDataset("train.csv")

predictor = TabularPredictor(label=label).fit(train_data)

test_data = TabularDataset("test.csv")
predictions = predictor.predict(test_data.drop(columns=[label]))FLAML (Fast Lightweight AutoML) Microsoft Research द्वारा विकसित एक ओपन सोर्स Python AutoML लाइब्रेरी है, जिसे कम से कम कंप्यूटेशनल लागत और संसाधन उपयोग के साथ उच्च-गुणवत्ता वाले मशीन लर्निंग मॉडल स्वतः और कुशलतापूर्वक खोजने के लिए डिज़ाइन किया गया है, जिससे यह उन वातावरणों के लिए आदर्श बनता है जहाँ गति और दक्षता सबसे अधिक मायने रखती है।
मुख्य विशेषताएँ:
कोड उदाहरण:
यह कोड उदाहरण दिखाता है कि FLAML की AutoML क्लास का उपयोग करके Iris डेटासेट पर स्वचालित वर्गीकरण कार्य कैसे करें, जहाँ प्रशिक्षण से पहले समय बजट और मूल्यांकन मीट्रिक निर्दिष्ट किए जाते हैं और फिर प्रशिक्षित मॉडल से प्रेडिक्शन प्रॉबेबिलिटीज प्राप्त की जाती हैं।
from flaml import AutoML
from sklearn.datasets import load_iris

X_train, y_train = load_iris(return_X_y=True)

automl = AutoML()

automl_settings = {
    "time_budget": 1,
    "metric": "accuracy",
    "task": "classification",
    "log_file_name": "iris.log",
}

automl.fit(X_train=X_train, y_train=y_train, **automl_settings)

print(automl.predict_proba(X_train))AutoKeras Keras डीप लर्निंग फ्रेमवर्क पर आधारित एक ओपन-सोर्स AutoML लाइब्रेरी है, जो स्ट्रक्चर्ड डेटा, इमेज और टेक्स्ट सहित व्यापक कार्यों के लिए उच्च-गुणवत्ता वाले न्यूरल नेटवर्क स्वतः खोजती और प्रशिक्षित करती है—और इसके लिए न्यूनतम कोडिंग की आवश्यकता होती है।
यह कुशल न्यूरल आर्किटेक्चर सर्च का उपयोग करके उपयुक्त मॉडल आर्किटेक्चर और हाइपरपैरामीटर्स खोजता है, जिससे डीप लर्निंग शुरुआती और अनुभवी प्रैक्टिशनर्स दोनों के लिए अधिक सुलभ हो जाता है।
मुख्य विशेषताएँ:
StructuredDataClassifier जैसे हाई-लेवल API कुछ पंक्तियों के कोड से जटिल डीप लर्निंग मॉडल का प्रशिक्षण आसान बनाते हैं।कोड उदाहरण:
यह कोड उदाहरण आवश्यक लाइब्रेरी इंपोर्ट करता है और दिए गए URLs से प्रशिक्षण और परीक्षण डेटासेट लोड करता है। यह फीचर्स और लेबल अलग करता है, फिर एक ak.StructuredDataClassifier ऑब्जेक्ट बनाता है जो स्वतः एक मजबूत डीप लर्निंग मॉडल खोजता है। मॉडल को निर्धारित ट्रायल्स और एपॉक्स के लिए प्रशिक्षित किया जाता है, और टेस्ट सेट पर अंतिम मूल्यांकन परिणाम प्रिंट किया जाता है।
import keras
import pandas as pd
import autokeras as ak

TRAIN_DATA_URL = "https://storage.googleapis.com/tf-datasets/titanic/train.csv"
TEST_DATA_URL = "https://storage.googleapis.com/tf-datasets/titanic/eval.csv"

train_file_path = keras.utils.get_file("train.csv", TRAIN_DATA_URL)
test_file_path = keras.utils.get_file("eval.csv", TEST_DATA_URL)

train_df = pd.read_csv(train_file_path)
test_df = pd.read_csv(test_file_path)

y_train = train_df["survived"].values
x_train = train_df.drop("survived", axis=1).values

y_test = test_df["survived"].values
x_test = test_df.drop("survived", axis=1).values

clf = ak.StructuredDataClassifier(overwrite=True, max_trials=3)
clf.fit(x_train, y_train, epochs=10)

print(clf.evaluate(x_test, y_test))
नो-कोड और लो-कोड AutoML प्लेटफ़ॉर्म जटिल वर्कफ़्लो को अमूर्त कर मॉडल विकास को सरल बनाते हैं, जिससे तकनीकी टीमों और बिज़नेस उपयोगकर्ताओं दोनों के लिए तेज़ प्रयोग और डिप्लॉयमेंट संभव होता है।
PyCaret एक ओपन-सोर्स, लो-कोड Python मशीन लर्निंग लाइब्रेरी है जो वर्गीकरण, प्रतिगमन, क्लस्टरिंग, विसंगति पहचान और टाइम सीरीज़ फोरकास्टिंग जैसे कार्यों के लिए एंड-टू-एंड मशीन लर्निंग वर्कफ़्लो को स्वचालित करती है, जिससे कुछ पंक्तियों के कोड में तेज़ प्रोटोटाइपिंग संभव होती है, और जो लो-कोड या क्लिक-थ्रू अनुभव पसंद करने वालों के लिए ग्राफिकल यूज़र इंटरफ़ेस का समर्थन भी करती है।
मुख्य विशेषताएँ:
compare_models फ़ंक्शन क्रॉस-वैलिडेशन का उपयोग करके कई मॉडलों को प्रशिक्षित और मूल्यांकित करता है और सर्वश्रेष्ठ मॉडल चुनने में मदद के लिए प्रदर्शन की लीडरबोर्ड प्रदान करता है।कोड उदाहरण:
यह स्निपेट बिल्ट-इन डेटासेट लोड करना, PyCaret रिग्रेशन मॉड्यूल को setup से इनिशियलाइज़ करना (जो डेटा प्रीप्रोसेस करता है और ML वातावरण तैयार करता है), और फिर compare_models का उपयोग करके विभिन्न रिग्रेशन मॉडलों को स्वचालित रूप से प्रशिक्षित, मूल्यांकित और रैंक करना दिखाता है, तथा सर्वश्रेष्ठ प्रदर्शन करने वाला मॉडल लौटाता है।
from pycaret.datasets import get_data
from pycaret.regression import *

data = get_data("insurance")

s = setup(data, target="charges", session_id=123)

best_model = compare_models()MLJAR Studio एक नो-कोड और लो-कोड AutoML वातावरण है जो गाइडेड इंटरफ़ेस के माध्यम से मशीन लर्निंग मॉडलों को प्रशिक्षित और तुलना करने देता है, जबकि ओपन-सोर्स mljar-supervised इंजन के जरिए वैकल्पिक Python वर्कफ़्लो भी ऑफ़र करता है।
मुख्य विशेषताएँ:
कोड उदाहरण:
MLJAR Studio का उपयोग करने के लिए आपको कोड की आवश्यकता नहीं है क्योंकि आप GUI के माध्यम से AutoML चला सकते हैं। हालाँकि, नीचे दिया गया कोड mljar-supervised लाइब्रेरी का उपयोग करते हुए वैकल्पिक प्रोग्रामेटिक दृष्टिकोण दिखाता है। यह डेटासेट लोड करता है, उसे फीचर्स और टार्गेट में विभाजित करता है, AutoML प्रशिक्षण चलाता है और फिर प्रशिक्षित मॉडल का उपयोग करके प्रेडिक्शंस जनरेट करता है।
import pandas as pd
from supervised.automl import AutoML

df = pd.read_csv(
    "https://raw.githubusercontent.com/pplonski/datasets-for-start/master/adult/data.csv",
    skipinitialspace=True,
)

X = df[df.columns[:-1]]
y = df["income"]

automl = AutoML(results_path="mljar_results")
automl.fit(X, y)

predictions = automl.predict(X)H2O AutoML H2O प्लेटफ़ॉर्म में एक ओपन सोर्स AutoML क्षमता है, जो Python, R और H2O Flow नामक नो-कोड ग्राफिकल इंटरफ़ेस के समर्थन के साथ स्केलेबल, स्वचालित मशीन लर्निंग प्रदान करता है, जिससे तकनीकी और गैर-तकनीकी उपयोगकर्ता दोनों न्यूनतम कोडिंग के साथ मॉडल बना, मूल्यांकित और चयन कर सकते हैं। उपयोगकर्ता वेब-आधारित Flow इंटरफ़ेस के माध्यम से डेटा इम्पोर्ट कर सकते हैं, AutoML प्रयोग चला सकते हैं, परिणामों का अन्वेषण कर सकते हैं और बिना कोड लिखे मॉडल एक्सपोर्ट कर सकते हैं।
मुख्य विशेषताएँ:
कोड उदाहरण:
यह उदाहरण दिखाता है कि Python के माध्यम से H2O AutoML का उपयोग कैसे करें। यह H2O वातावरण इनिशियलाइज़ करता है, प्रशिक्षण और परीक्षण डेटासेट इम्पोर्ट करता है, फीचर और टार्गेट कॉलम निर्दिष्ट करता है, मॉडलों की संख्या पर सीमा के साथ एक AutoML रन शुरू करता है और फिर सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडलों को रैंक करने वाली लीडरबोर्ड दिखाता है।
नोट: हालाँकि यह प्रोग्रामेटिक तरीका है, वही कार्य H2O Flow वेब इंटरफ़ेस के माध्यम से बिना कोई कोड लिखे पूरे किए जा सकते हैं।
import h2o
from h2o.automl import H2OAutoML

h2o.init()

train = h2o.import_file(
    "https://s3.amazonaws.com/h2o-public-test-data/smalldata/higgs/higgs_train_10k.csv"
)
test = h2o.import_file(
    "https://s3.amazonaws.com/h2o-public-test-data/smalldata/higgs/higgs_test_5k.csv"
)

x = train.columns
y = "response"
x.remove(y)

train[y] = train[y].asfactor()
test[y] = test[y].asfactor()

aml = H2OAutoML(max_models=20, seed=1)
aml.train(x=x, y=y, training_frame=train)

aml.leaderboard
एंटरप्राइज़-ग्रेड AutoML समाधान प्रोडक्शन डिप्लॉयमेंट, अनुपालन और बड़े पैमाने पर ऑपरेशनल उपयोग के लिए स्केलेबल, सुरक्षित और गवर्न्ड मशीन लर्निंग प्लेटफ़ॉर्म प्रदान करते हैं।
DataRobot एक एंटरप्राइज़-ग्रेड नो-कोड और लो-कोड AutoML प्लेटफ़ॉर्म है, जो बिज़नेस यूज़र्स, विश्लेषकों और डेटा टीमों को व्यापक प्रोग्रामिंग के बिना मशीन लर्निंग मॉडल बनाने, डिप्लॉय करने और प्रबंधित करने में सक्षम बनाता है।
यह प्लेटफ़ॉर्म डेटा इन्गेशन और फ़ीचर इंजीनियरिंग से लेकर मॉडल प्रशिक्षण, डिप्लॉयमेंट और मॉनिटरिंग तक पूरे मशीन लर्निंग लाइफसाइकिल को स्वचालित करता है, और विनियमित वातावरण में आवश्यक मजबूत गवर्नेंस, एक्सप्लेनेबिलिटी और ऑपरेशनल नियंत्रण प्रदान करता है।
मुख्य विशेषताएँ:
कोड उदाहरण:
हालाँकि DataRobot का प्राथमिक उपयोग इसका नो-कोड इंटरफ़ेस है, यह प्रोग्रामेटिक कंट्रोल और ऑटोमेशन के लिए Python API भी प्रदान करता है। नीचे दिया उदाहरण दिखाता है कि DataRobot के साथ प्रमाणीकरण कैसे करें, किसी डेटासेट से प्रोजेक्ट कैसे बनाएं और AutoPilot चलाकर मॉडलों को स्वतः प्रशिक्षित और मूल्यांकित कैसे करें।
import datarobot as dr
dr.Client(config_path="./drconfig.yaml")

dataset = dr.Dataset.create_from_file("auto-mpg.csv")

project = dr.Project.create_from_dataset(
    dataset.id,
    project_name="Auto MPG Project"
)

from datarobot import AUTOPILOT_MODE
project.analyze_and_model(
    target="mpg",
    mode=AUTOPILOT_MODE.QUICK
)

project.wait_for_autopilot()Amazon SageMaker Autopilot AWS का एक पूर्ण-प्रबंधित AutoML समाधान है, जो विशेष रूप से Amazon SageMaker Canvas या SageMaker Studio के वेब इंटरफ़ेस के माध्यम से बिना कोड या कम कोड के साथ एंड-टू-एंड मशीन लर्निंग वर्कफ़्लो को स्वचालित करने में सक्षम बनाता है।
उपयोगकर्ता कंसोल में कुछ क्लिक से डेटा इम्पोर्ट कर सकते हैं, टार्गेट वेरिएबल कॉन्फ़िगर कर सकते हैं, उम्मीदवार मॉडलों का मूल्यांकन कर सकते हैं और मॉडलों को डिप्लॉय कर सकते हैं, जबकि Python SDK और APIs वैकल्पिक रूप से प्रयोगों को पुनरुत्पाद्य बनाने या अन्य सिस्टम के साथ इंटीग्रेशन के लिए उपलब्ध रहते हैं।
मुख्य विशेषताएँ:
कोड उदाहरण:
नीचे दिया कोड Python SDK का उपयोग करके प्रोग्रामेटिक रूप से Amazon SageMaker Autopilot कैसे चलाएँ, यह दिखाता है। यह तरीका वैकल्पिक है और परिणामों को पुनरुत्पाद्य बनाने या स्वचालित पाइपलाइनों में इंटीग्रेट करने के लिए इस्तेमाल किया जा सकता है।
from sagemaker import AutoML, AutoMLInput

automl = AutoML(
    role=execution_role,
    target_attribute_name=target_attribute_name,
    sagemaker_session=pipeline_session,
    total_job_runtime_in_seconds=3600,
    mode="ENSEMBLING",
)

automl.fit(
    inputs=[
        AutoMLInput(
            inputs=s3_train_val,
            target_attribute_name=target_attribute_name,
            channel_type="training",
        )
    ]
)Google Cloud AutoML Vertex AI का हिस्सा है—Google Cloud का एकीकृत मशीन लर्निंग प्लेटफ़ॉर्म—जो उपयोगकर्ताओं को पूर्ण-प्रबंधित इंफ्रास्ट्रक्चर का उपयोग करके उच्च-गुणवत्ता वाले मॉडल बनाने, प्रशिक्षित करने, मूल्यांकित करने और डिप्लॉय करने में सक्षम बनाता है।
Vertex AI AutoML टैब्युलर डेटा, नैचुरल लैंग्वेज प्रोसेसिंग, कंप्यूटर विज़न और वीडियो कार्यों का समर्थन करता है, और Google Cloud Console में नो-कोड वेब इंटरफ़ेस के माध्यम से सुलभ होने के लिए डिज़ाइन किया गया है।
डेटासेट निर्माण, कार्य चयन, प्रशिक्षण, मूल्यांकन और डिप्लॉयमेंट जैसे सभी कोर चरण UI के माध्यम से बिना कोई कोड लिखे पूरे किए जा सकते हैं।
मुख्य विशेषताएँ:
कोड उदाहरण:
हालाँकि Vertex AI AutoML मुख्य रूप से नो-कोड वर्कफ़्लो के लिए डिज़ाइन किया गया है, Python SDK का उपयोग प्रयोगों को पुनरुत्पाद्य बनाने या AutoML प्रशिक्षण को स्वचालित पाइपलाइनों में इंटीग्रेट करने के लिए किया जा सकता है।
निम्नलिखित छोटा स्निपेट एक Vertex AI प्रोजेक्ट इनिशियलाइज़ करता है, Cloud Storage में संग्रहीत CSV इंडेक्स से एक इमेज डेटासेट बनाता है और एक AutoML इमेज प्रशिक्षण जॉब लॉन्च करता है।
from google.cloud import aiplatform

aiplatform.init(
    project="YOUR_PROJECT_ID",
    location="us-central1",
    staging_bucket="gs://YOUR_BUCKET",
)

dataset = aiplatform.ImageDataset.create(
    display_name="flowers",
    gcs_source=["gs://cloud-samples-data/ai-platform/flowers/flowers.csv"],
    import_schema_uri=aiplatform.schema.dataset.ioformat.image.single_label_classification,
)

training_job = aiplatform.AutoMLImageTrainingJob(
    display_name="flowers_automl",
    prediction_type="classification",
)

model = training_job.run(
    dataset=dataset,
    model_display_name="flowers_model",
    budget_milli_node_hours=8000,
)यह तालिका लोकप्रिय AutoML फ्रेमवर्क की तुलना उनके ऑटोमेशन स्तर, इंटरफ़ेस शैली और ओपन सोर्स प्रयोग, लो-कोड वर्कफ़्लो तथा एंटरप्राइज़-स्केल डिप्लॉयमेंट के अनुरूपता के आधार पर करती है।
|
फ्रेमवर्क |
श्रेणी |
कोड स्तर |
इंटरफ़ेस विकल्प |
प्राथमिक उपयोग-केस |
|
TPOT |
ओपन सोर्स |
उच्च |
Python API |
टैब्युलर डेटा के लिए स्वचालित पाइपलाइन खोज और ऑप्टिमाइज़ेशन |
|
AutoGluon |
ओपन सोर्स |
कम |
Python API |
विभिन्न मोडैलिटी में तेज़, उच्च-सटीकता, प्रोडक्शन-रेडी मॉडल |
|
FLAML |
ओपन सोर्स |
कम |
Python API |
लागत-कुशल और संसाधन-सचेत मॉडल ट्यूनिंग |
|
AutoKeras |
ओपन सोर्स |
मध्यम |
Python API |
न्यूरल आर्किटेक्चर सर्च और डीप लर्निंग ऑटोमेशन |
|
PyCaret |
लो कोड |
बहुत कम |
Python API, वैकल्पिक GUI टूल्स |
तेज़ प्रयोग और एनालिटिक्स-ड्रिवन वर्कफ़्लो |
|
MLJAR Studio |
नो कोड |
कोई नहीं |
Web UI, वैकल्पिक Python |
बिज़नेस-फ्रेंडली AutoML प्रयोग और मॉडल तुलना |
|
H2O AutoML |
हाइब्रिड |
कम |
Web UI (H2O Flow), Python, R |
बड़े डेटासेट और एंटरप्राइज़ डिप्लॉयमेंट के लिए स्केलेबल AutoML |
|
DataRobot |
एंटरप्राइज़ |
कोई नहीं से कम |
Web UI, Python API |
गवर्नेंस, एक्सप्लेनेबिलिटी और MLOps के साथ एंटरप्राइज़ ML |
|
SageMaker Autopilot |
एंटरप्राइज़ |
कोई नहीं से कम |
AWS Console, Python SDK |
प्रोडक्शन पाइपलाइनों के साथ इंटीग्रेटेड AWS नेटिव AutoML |
|
Google Cloud AutoML |
एंटरप्राइज़ |
कोई नहीं |
Vertex AI Console, वैकल्पिक SDK |
मैनेज्ड GCP इंफ्रास्ट्रक्चर पर विज़न, NLP और टैब्युलर AutoML |
AutoML फ्रेमवर्क इतने परिपक्व हो चुके हैं कि वे पूरे मशीन लर्निंग लाइफसाइकिल में टीमों का समर्थन करने वाले प्रोडक्शन-ग्रेड टूल बन गए हैं। व्यावहारिक सेटिंग्स में, वे केवल प्रयोग या प्रोटोटाइपिंग तक सीमित नहीं हैं।
मैंने Kaggle प्रतियोगिताओं में भाग लेने, वास्तविक प्रोजेक्ट्स के लिए संपूर्ण एंड-टू-एंड मशीन लर्निंग पाइपलाइंस बनाने, और यहाँ तक कि तकनीकी इंटरव्यू की तैयारी और सफलता के लिए भी AutoML फ्रेमवर्क का उपयोग किया है।
डेटा वैज्ञानिक के दृष्टिकोण से, AutoML बहुत कम ओवरहेड के साथ एक मजबूत और निष्पक्ष बेसलाइन मॉडल स्थापित करने का शक्तिशाली तरीका है।
सिर्फ डेटा प्रदान करके, ये फ्रेमवर्क फ़ीचर इंजीनियरिंग, मॉडल चयन, हाइपरपैरामीटर ट्यूनिंग और मूल्यांकन का ध्यान रखते हैं। इससे प्रैक्टिशनर्स समस्या को समझने, मान्यताओं को परखने और परिणामों में सुधार पर ध्यान केंद्रित कर सकते हैं—बजाय इसके कि शुरुआत से मॉडलों पर अत्यधिक समय शोध और परीक्षण में लगाएँ।
AutoML विशेषज्ञता का विकल्प नहीं है। बल्कि, यह एक विश्वसनीय शुरुआती बिंदु देकर वर्कफ़्लो को तेज़ करता है, जिसे क्रमिक रूप से बेहतर बनाया जा सकता है।
मॉडल बनाना सिर्फ पहला कदम है। प्रोडक्शन में अपने AutoML मॉडलों को कैसे डिप्लॉय और मॉनिटर करें, यह सीखें MLOps Concepts कोर्स के साथ।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स