
{count, plural, one {Cursus} other {Cursussen}}
Volledig geautomatiseerde MLOps
{hours} uur
6.5K
Automated Machine Learning (AutoML) wordt vaak verkeerd begrepen.
Veel mensen in tech gaan ervan uit dat AutoML-tools alleen bedoeld zijn voor business users of niet-technische teams die niet begrijpen hoe machinelearningmodellen worden getraind of uitgerold. Die aanname klopt niet.
In de praktijk gebruiken data scientists en machine learning engineers regelmatig AutoML-frameworks om experimenteertijd te verkorten, modelprestaties te verbeteren en repetitieve fasen in de machinelearning-levenscyclus te automatiseren.
Deze AutoML-tools ondersteunen taken zoals feature engineering, modelselectie, hyperparametertuning en end-to-end pijplijnautomatisering, zodat teams zich kunnen richten op werk met meer toegevoegde waarde.
In dit artikel bespreek ik enkele van de beste AutoML-frameworks die vandaag beschikbaar zijn, ontworpen voor gebruikers met verschillende ervaringsniveaus. De tools zijn onderverdeeld in drie duidelijke categorieën:
Voor elk framework lichten we de belangrijkste features uit en geven we voorbeeldcode zodat je er meteen mee aan de slag kunt.
AutoML verwijst naar tools en systemen die het volledige ontwikkelproces van machinelearningmodellen automatiseren, van ruwe data tot een getraind, inzetbaar model.
AutoML-frameworks nemen veel van de repetitieve en technische taken bij het bouwen van machinelearningmodellen uit handen, zodat zowel experts als minder technische gebruikers efficiënter kunnen werken.
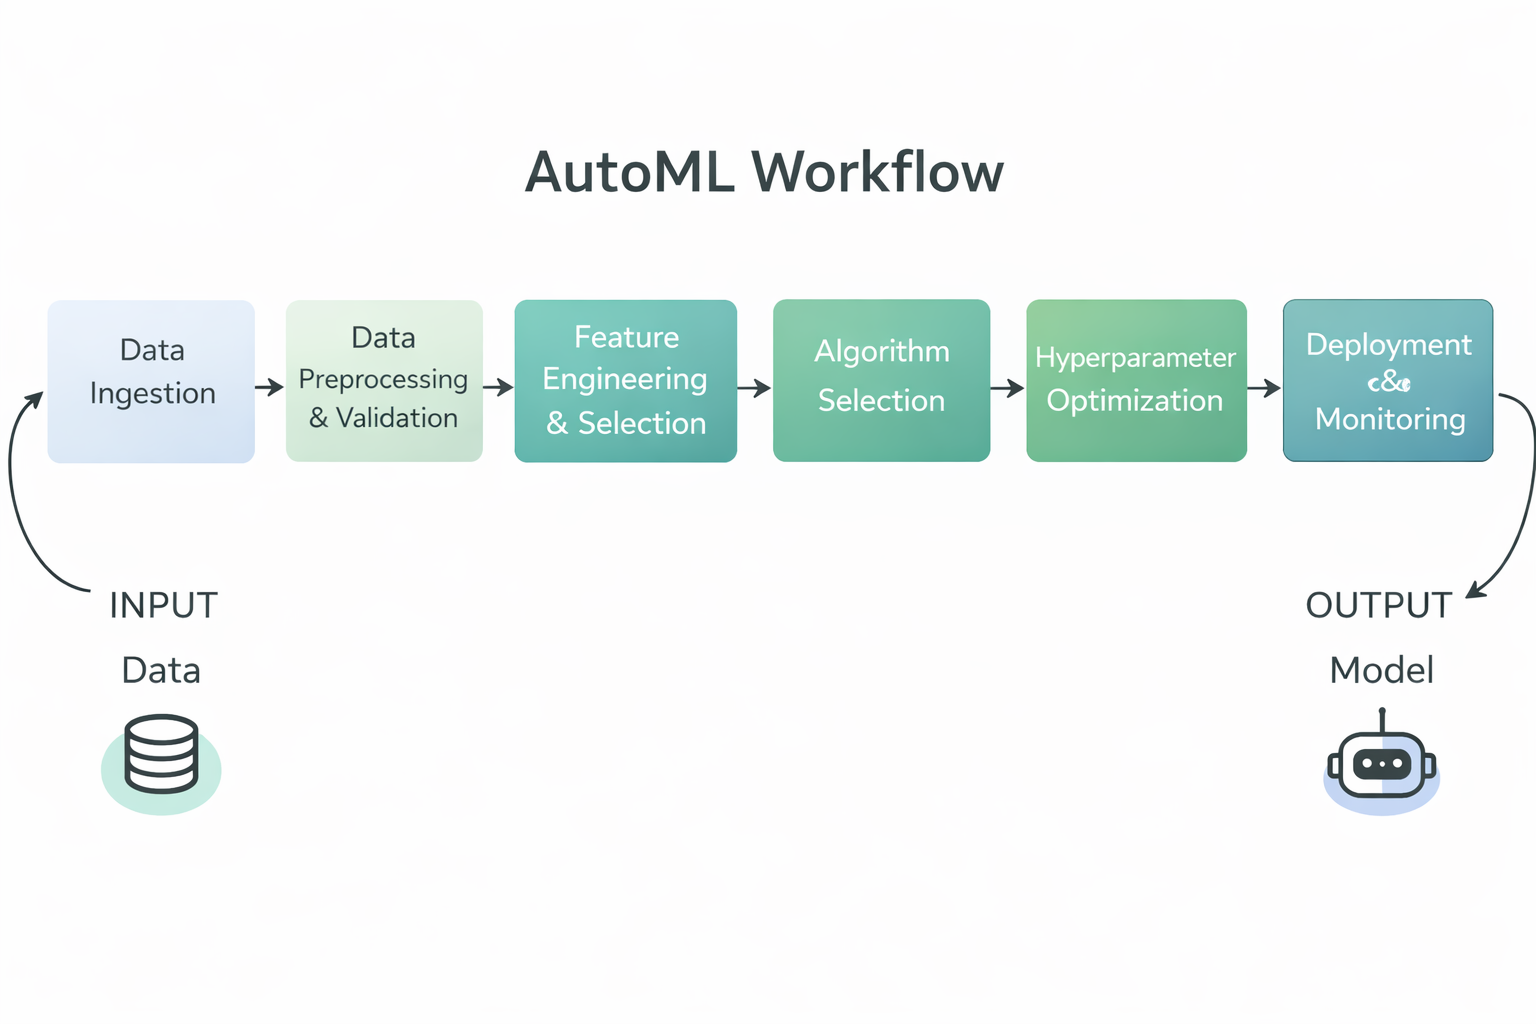
Diagram van de AutoML-werkstroom
Concreet automatiseren AutoML-frameworks doorgaans de volgende stappen in de machinelearning-werkstroom:
Door deze taken te automatiseren verminderen AutoML-frameworks handmatig werk, verbeteren ze consistentie en reproduceerbaarheid, en maken ze het voor zowel technische als niet-technische teams mogelijk om sneller hoogwaardige machinelearningmodellen te bouwen.
Open-source AutoML-frameworks bieden flexibele, transparante en ontwikkelaarsvriendelijke tools waarmee je het bouwen van modellen kunt automatiseren en toch volledige controle houdt over data, pijplijnen en deploymentworkflows.
TPOT is een open-source Python AutoML-framework dat genetische programmering gebruikt om automatisch complete machinelearningpijplijnen te ontdekken en te optimaliseren.
Het benadert pijplijnontwerp als een evolutionair zoekprobleem en verkent combinaties van preprocessingstappen, modellen en hyperparameters om hoogpresterende oplossingen te vinden.
TPOT is vooral effectief voor tabeldata-taken waar snelle experimentatie en sterke baselines nodig zijn, terwijl je de resulterende pijplijnen nog steeds kunt inspecteren, exporteren en hergebruiken binnen standaard scikit-learn-workflows.
Belangrijkste features:
Codevoorbeeld:
Dit voorbeeld laat de minimale setup zien die nodig is om TPOT te gebruiken. De features en labels van de dataset worden geladen, een TPOTClassifier wordt met standaardinstellingen geïnitialiseerd en de fit-methode start het geautomatiseerde zoekproces.
Tijdens de training evalueert TPOT meerdere kandidaatpijplijnen met genetische programmering en kiest het een hoogpresterend model op basis van de opgegeven evaluatiemetric.
import tpot
X, y = load_my_data()
est = tpot.TPOTClassifier()
est.fit(X, y)AutoGluon is een open-source Python AutoML-framework ontwikkeld door AWS AI dat machinelearningtaken automatiseert met focus op hoge nauwkeurigheid, minimale code en ondersteuning voor tabellen, tekst en afbeeldingen.
Het bouwt een diverse set modellen en gebruikt geautomatiseerde modelselectie, hyperparametertuning en ensemble learning om sterke voorspellingen te leveren over verschillende datatypes heen.
Belangrijkste features:
Codevoorbeeld:
Deze code laadt de train- en testdatasets als AutoGluon-tabellendatasets. Vervolgens wordt een TabularPredictor-object aangemaakt met het doellabel en wordt fit aangeroepen om AutoGluon te trainen op de tabeldata. Na training worden met het getrainde model voorspellingen gegenereerd op de testset.
from autogluon.tabular import TabularDataset, TabularPredictor

label = "signature"
train_data = TabularDataset("train.csv")

predictor = TabularPredictor(label=label).fit(train_data)

test_data = TabularDataset("test.csv")
predictions = predictor.predict(test_data.drop(columns=[label]))FLAML (Fast Lightweight AutoML) is een open-source Python AutoML-bibliotheek ontwikkeld door Microsoft Research, ontworpen om automatisch en efficiënt hoogwaardige machinelearningmodellen te vinden met minimale rekentijd en middelen, ideaal in omgevingen waar snelheid en efficiëntie cruciaal zijn.
Belangrijkste features:
Codevoorbeeld:
Dit codevoorbeeld laat zien hoe je de AutoML-klasse van FLAML gebruikt voor een geautomatiseerde classificatietaak op de Iris-dataset, met een tijdsbudget en evaluatiemetric vóór training, en daarna het gebruik van het getrainde model om voorspellingskansen op te halen.
from flaml import AutoML
from sklearn.datasets import load_iris

X_train, y_train = load_iris(return_X_y=True)

automl = AutoML()

automl_settings = {
    "time_budget": 1,
    "metric": "accuracy",
    "task": "classification",
    "log_file_name": "iris.log",
}

automl.fit(X_train=X_train, y_train=y_train, **automl_settings)

print(automl.predict_proba(X_train))AutoKeras is een open-source AutoML-bibliotheek bovenop het Keras deep learning-framework die automatisch hoogwaardige neurale netwerken zoekt en traint voor uiteenlopende taken, waaronder gestructureerde data, afbeeldingen en tekst, met minimale code.
Het gebruikt efficiënte neural architecture search om passende modelarchitecturen en hyperparameters te vinden, waardoor deep learning toegankelijker wordt voor zowel beginners als ervaren practitioners.
Belangrijkste features:
StructuredDataClassifier maken het eenvoudig om complexe deep-learningmodellen te trainen met een paar regels code.Codevoorbeeld:
Dit codevoorbeeld importeert de benodigde libraries en laadt train- en testdatasets van de opgegeven URL’s. Het splitst features en labels, maakt vervolgens een ak.StructuredDataClassifier-object aan dat automatisch naar een sterk deep-learningmodel zoekt. Het model wordt getraind voor een vastgesteld aantal trials en epochs, en het uiteindelijke evaluatieresultaat op de testset wordt geprint.
import keras
import pandas as pd
import autokeras as ak

TRAIN_DATA_URL = "https://storage.googleapis.com/tf-datasets/titanic/train.csv"
TEST_DATA_URL = "https://storage.googleapis.com/tf-datasets/titanic/eval.csv"

train_file_path = keras.utils.get_file("train.csv", TRAIN_DATA_URL)
test_file_path = keras.utils.get_file("eval.csv", TEST_DATA_URL)

train_df = pd.read_csv(train_file_path)
test_df = pd.read_csv(test_file_path)

y_train = train_df["survived"].values
x_train = train_df.drop("survived", axis=1).values

y_test = test_df["survived"].values
x_test = test_df.drop("survived", axis=1).values

clf = ak.StructuredDataClassifier(overwrite=True, max_trials=3)
clf.fit(x_train, y_train, epochs=10)

print(clf.evaluate(x_test, y_test))
No-code- en low-code AutoML-platformen vereenvoudigen modelontwikkeling door complexe workflows te abstraheren, waardoor snelle experimentatie en deployment mogelijk worden voor zowel technische teams als business users.
PyCaret is een open-source, low-code machinelearningbibliotheek in Python die de end-to-end machinelearningwerkstroom automatiseert voor taken zoals classificatie, regressie, clustering, anomaliedetectie en tijdreeksvoorspelling. Zo kun je met slechts een paar regels code snel prototypen, met daarnaast ondersteuning voor een grafische gebruikersinterface voor wie low-code of klik-gestuurde ervaringen verkiest.
Belangrijkste features:
compare_models traint en evalueert veel modellen via cross-validatie en toont een leaderboard om het beste model te kiezen.Codevoorbeeld:
Deze snippet laat zien hoe je een ingebouwde dataset laadt, de PyCaret-regressiemodule initialiseert met setup (dat de data preprocesset en de ML-omgeving initialiseert), en vervolgens compare_models gebruikt om automatisch verschillende regressiemodellen te trainen, evalueren en ranken, en zo de best presterende terug te geven.
from pycaret.datasets import get_data
from pycaret.regression import *

data = get_data("insurance")

s = setup(data, target="charges", session_id=123)

best_model = compare_models()MLJAR Studio is een no-code en low-code AutoML-omgeving waarmee je modellen traint en vergelijkt via een begeleide interface, met daarnaast een optionele Python-workflow via de open-source mljar-supervised-engine.
Belangrijkste features:
Codevoorbeeld:
Je hebt geen code nodig om MLJAR Studio te gebruiken, want je kunt AutoML via de GUI draaien. De onderstaande code toont echter de optionele programmatische aanpak met de mljar-supervised-library. Het laadt een dataset, splitst features en target, voert AutoML-training uit en genereert vervolgens voorspellingen met het getrainde model.
import pandas as pd
from supervised.automl import AutoML

df = pd.read_csv(
    "https://raw.githubusercontent.com/pplonski/datasets-for-start/master/adult/data.csv",
    skipinitialspace=True,
)

X = df[df.columns[:-1]]
y = df["income"]

automl = AutoML(results_path="mljar_results")
automl.fit(X, y)

predictions = automl.predict(X)H2O AutoML is een open-source AutoML-mogelijkheid binnen het H2O-platform die schaalbare, geautomatiseerde machine learning biedt met ondersteuning voor Python, R en een no-code grafische interface genaamd H2O Flow, waardoor zowel technische als niet-technische gebruikers met minimale code modellen kunnen bouwen, evalueren en selecteren. Gebruikers kunnen via de webgebaseerde Flow-interface data importeren, AutoML-experimenten draaien, resultaten verkennen en modellen exporteren zonder code te schrijven.
Belangrijkste features:
Codevoorbeeld:
Dit voorbeeld laat zien hoe je H2O AutoML via Python gebruikt. Het initialiseert de H2O-omgeving, importeert train- en testdatasets, specificeert feature- en targetkolommen, start een AutoML-run met een limiet op het aantal modellen en toont vervolgens een leaderboard met de best presterende modellen.
Opmerking: Hoewel dit de programmatische aanpak is, kun je dezelfde taken via de H2O Flow webinterface uitvoeren zonder code te schrijven.
import h2o
from h2o.automl import H2OAutoML

h2o.init()

train = h2o.import_file(
    "https://s3.amazonaws.com/h2o-public-test-data/smalldata/higgs/higgs_train_10k.csv"
)
test = h2o.import_file(
    "https://s3.amazonaws.com/h2o-public-test-data/smalldata/higgs/higgs_test_5k.csv"
)

x = train.columns
y = "response"
x.remove(y)

train[y] = train[y].asfactor()
test[y] = test[y].asfactor()

aml = H2OAutoML(max_models=20, seed=1)
aml.train(x=x, y=y, training_frame=train)

aml.leaderboard
Enterprise-grade AutoML-oplossingen bieden schaalbare, veilige en beheerde ML-platformen die zijn ontworpen voor productiedeployment, compliance en grootschalig operationeel gebruik.
DataRobot is een enterprise-grade no-code en low-code AutoML-platform waarmee business users, analisten en datateams ML-modellen kunnen bouwen, deployen en beheren zonder uitgebreide programmeerkennis.
Het platform automatiseert de volledige ML-levenscyclus: van data-inname en feature engineering tot modeltraining, deployment en monitoring, met sterke governance, uitlegbaarheid en operationele controls die vereist zijn in gereguleerde omgevingen.
Belangrijkste features:
Codevoorbeeld:
Hoewel DataRobot primair via de no-code interface wordt gebruikt, is er ook een Python-API voor programmatische controle en automatisering. Het onderstaande voorbeeld toont hoe je je bij DataRobot authenticeren, een project vanuit een dataset maken en AutoPilot starten om automatisch modellen te trainen en evalueren.
import datarobot as dr
dr.Client(config_path="./drconfig.yaml")

dataset = dr.Dataset.create_from_file("auto-mpg.csv")

project = dr.Project.create_from_dataset(
    dataset.id,
    project_name="Auto MPG Project"
)

from datarobot import AUTOPILOT_MODE
project.analyze_and_model(
    target="mpg",
    mode=AUTOPILOT_MODE.QUICK
)

project.wait_for_autopilot()Amazon SageMaker Autopilot is een volledig beheerde AutoML-oplossing van AWS waarmee gebruikers de end-to-end ML-werkstroom kunnen automatiseren met no code of low code, met name via een webinterface in Amazon SageMaker Canvas of SageMaker Studio.
Gebruikers kunnen data importeren, de doelfunctie configureren, kandidaatmodellen evalueren en modellen met een paar klikken deployen in de console, terwijl de Python SDK en API’s optioneel beschikbaar blijven om experimenten reproduceerbaar te maken of te integreren met andere systemen.
Belangrijkste features:
Codevoorbeeld:
De onderstaande code toont hoe je Amazon SageMaker Autopilot programmatisch draait met de Python SDK. Deze aanpak is optioneel en kan worden gebruikt om resultaten te reproduceren of te integreren in geautomatiseerde pijplijnen.
from sagemaker import AutoML, AutoMLInput

automl = AutoML(
    role=execution_role,
    target_attribute_name=target_attribute_name,
    sagemaker_session=pipeline_session,
    total_job_runtime_in_seconds=3600,
    mode="ENSEMBLING",
)

automl.fit(
    inputs=[
        AutoMLInput(
            inputs=s3_train_val,
            target_attribute_name=target_attribute_name,
            channel_type="training",
        )
    ]
)Google Cloud AutoML maakt deel uit van Vertex AI, Google Clouds uniforme ML-platform waarmee gebruikers hoogwaardige modellen kunnen bouwen, trainen, evalueren en deployen op volledig beheerde infrastructuur.
Vertex AI AutoML ondersteunt tabeldata, natural language processing, computervisie en videotaken, en is ontworpen om toegankelijk te zijn via een no-code webinterface in de Google Cloud Console.
Alle kernstappen, zoals het maken van datasets, taakselectie, training, evaluatie en deployment, kunnen via de UI worden uitgevoerd zonder code te schrijven.
Belangrijkste features:
Codevoorbeeld:
Hoewel Vertex AI AutoML primair is ontworpen voor no-code workflows, kun je met de Python SDK experimenten reproduceerbaar maken of AutoML-training in geautomatiseerde pijplijnen integreren.
Het volgende korte fragment initialiseert een Vertex AI-project, maakt een afbeeldingsdataset op basis van een CSV-index in Cloud Storage en start een AutoML-trainingsjob voor afbeeldingen.
from google.cloud import aiplatform

aiplatform.init(
    project="YOUR_PROJECT_ID",
    location="us-central1",
    staging_bucket="gs://YOUR_BUCKET",
)

dataset = aiplatform.ImageDataset.create(
    display_name="flowers",
    gcs_source=["gs://cloud-samples-data/ai-platform/flowers/flowers.csv"],
    import_schema_uri=aiplatform.schema.dataset.ioformat.image.single_label_classification,
)

training_job = aiplatform.AutoMLImageTrainingJob(
    display_name="flowers_automl",
    prediction_type="classification",
)

model = training_job.run(
    dataset=dataset,
    model_display_name="flowers_model",
    budget_milli_node_hours=8000,
)Deze tabel vergelijkt populaire AutoML-frameworks op basis van hun automatiseringsniveau, interfacestijl en geschiktheid voor open-source-experimenten, low-code-workflows en enterprise-deployment op schaal.
|
Framework |
Categorie |
Codeniveau |
Interface-opties |
Primair gebruiksdoel |
|
TPOT |
Open source |
Hoog |
Python-API |
Geautomatiseerde ontdekking en optimalisatie van pijplijnen voor tabeldata |
|
AutoGluon |
Open source |
Laag |
Python-API |
Snelle, nauwkeurige, productieklare modellen over modaliteiten heen |
|
FLAML |
Open source |
Laag |
Python-API |
Kostenefficiënte en resourcebewuste modeltuning |
|
AutoKeras |
Open source |
Middel |
Python-API |
Zoektochten naar neurale architecturen en automatisering van deep learning |
|
PyCaret |
Low code |
Zeer laag |
Python-API, optionele GUI-tools |
Snelle experimentatie en analytics-gedreven workflows |
|
MLJAR Studio |
No code |
Geen |
Web-UI, optioneel Python |
Businessvriendelijke AutoML-experimentatie en modelvergelijking |
|
H2O AutoML |
Hybride |
Laag |
Web-UI (H2O Flow), Python, R |
Schaalbare AutoML voor grote datasets en enterprise-deployment |
|
DataRobot |
Enterprise |
Geen tot laag |
Web-UI, Python-API |
Enterprise-ML met governance, uitlegbaarheid en MLOps |
|
SageMaker Autopilot |
Enterprise |
Geen tot laag |
AWS Console, Python SDK |
AWS-native AutoML geïntegreerd met productie-pijplijnen |
|
Google Cloud AutoML |
Enterprise |
Geen |
Vertex AI Console, optionele SDK |
Vision-, NLP- en tabulaire AutoML op beheerde GCP-infrastructuur |
AutoML-frameworks zijn uitgegroeid tot production-grade tools die teams door de volledige machinelearning-levenscyclus ondersteunen. In de praktijk zijn ze niet beperkt tot experimenten of prototyping.
Ik heb AutoML-frameworks gebruikt om mee te doen aan Kaggle-wedstrijden, om complete end-to-end machinelearningpijplijnen voor echte projecten te bouwen en zelfs om me voor te bereiden op en te slagen in technische sollicitatiegesprekken.
Vanuit het perspectief van een data scientist is AutoML een krachtige manier om met minimale overhead een sterke en onbevooroordeelde baseline te vestigen.
Door simpelweg de data aan te leveren, nemen deze frameworks feature engineering, modelselectie, hyperparametertuning en evaluatie uit handen. Hierdoor kunnen practitioners zich richten op het begrijpen van het probleem, het valideren van aannames en het verbeteren van resultaten, in plaats van buitensporig veel tijd te besteden aan het van nul af aan onderzoeken en testen van modellen.
AutoML vervangt geen expertise. Het versnelt juist de workflow door een betrouwbaar startpunt te bieden dat je iteratief kunt verbeteren.
Een model bouwen is pas stap één. Leer hoe je je AutoML-modellen in productie uitrolt en monitort met de MLOps Concepts-cursus.
Topcursussen bij DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

