
Last chance! 50% off DataCamp Premium
Sale ends in
Automated Machine Learning (AutoML) sering disalahpahami.
Banyak orang di bidang teknologi berasumsi bahwa alat AutoML hanya ditujukan untuk pengguna bisnis atau tim non-teknis yang tidak memahami bagaimana model machine learning dilatih atau di-deploy. Asumsi ini tidak tepat.
Dalam praktiknya, data scientist dan machine learning engineer secara rutin menggunakan kerangka AutoML untuk mengurangi waktu eksperimen, meningkatkan kinerja model, dan mengotomatisasi tahap-tahap berulang dalam siklus hidup machine learning.
Alat AutoML ini mendukung tugas seperti rekayasa fitur, pemilihan model, penalaan hyperparameter, dan otomasi pipeline end-to-end, sehingga tim dapat berfokus pada pekerjaan bernilai lebih tinggi.
Dalam artikel ini, saya akan membahas beberapa kerangka AutoML terbaik yang tersedia saat ini, dirancang untuk pengguna pada berbagai tingkat keahlian. Alat-alat tersebut dikelompokkan ke dalam tiga kategori yang jelas:
Untuk setiap kerangka, kami menyoroti fitur utamanya dan memberikan contoh kode agar Anda dapat langsung mulai menggunakannya.
AutoML mengacu pada alat dan sistem yang mengotomatisasi seluruh proses pengembangan model machine learning, dari data mentah hingga model terlatih yang siap di-deploy.
Kerangka AutoML menangani banyak tugas teknis dan berulang dalam membangun model machine learning sehingga praktisi ahli maupun pengguna yang kurang teknis dapat bekerja lebih efisien.
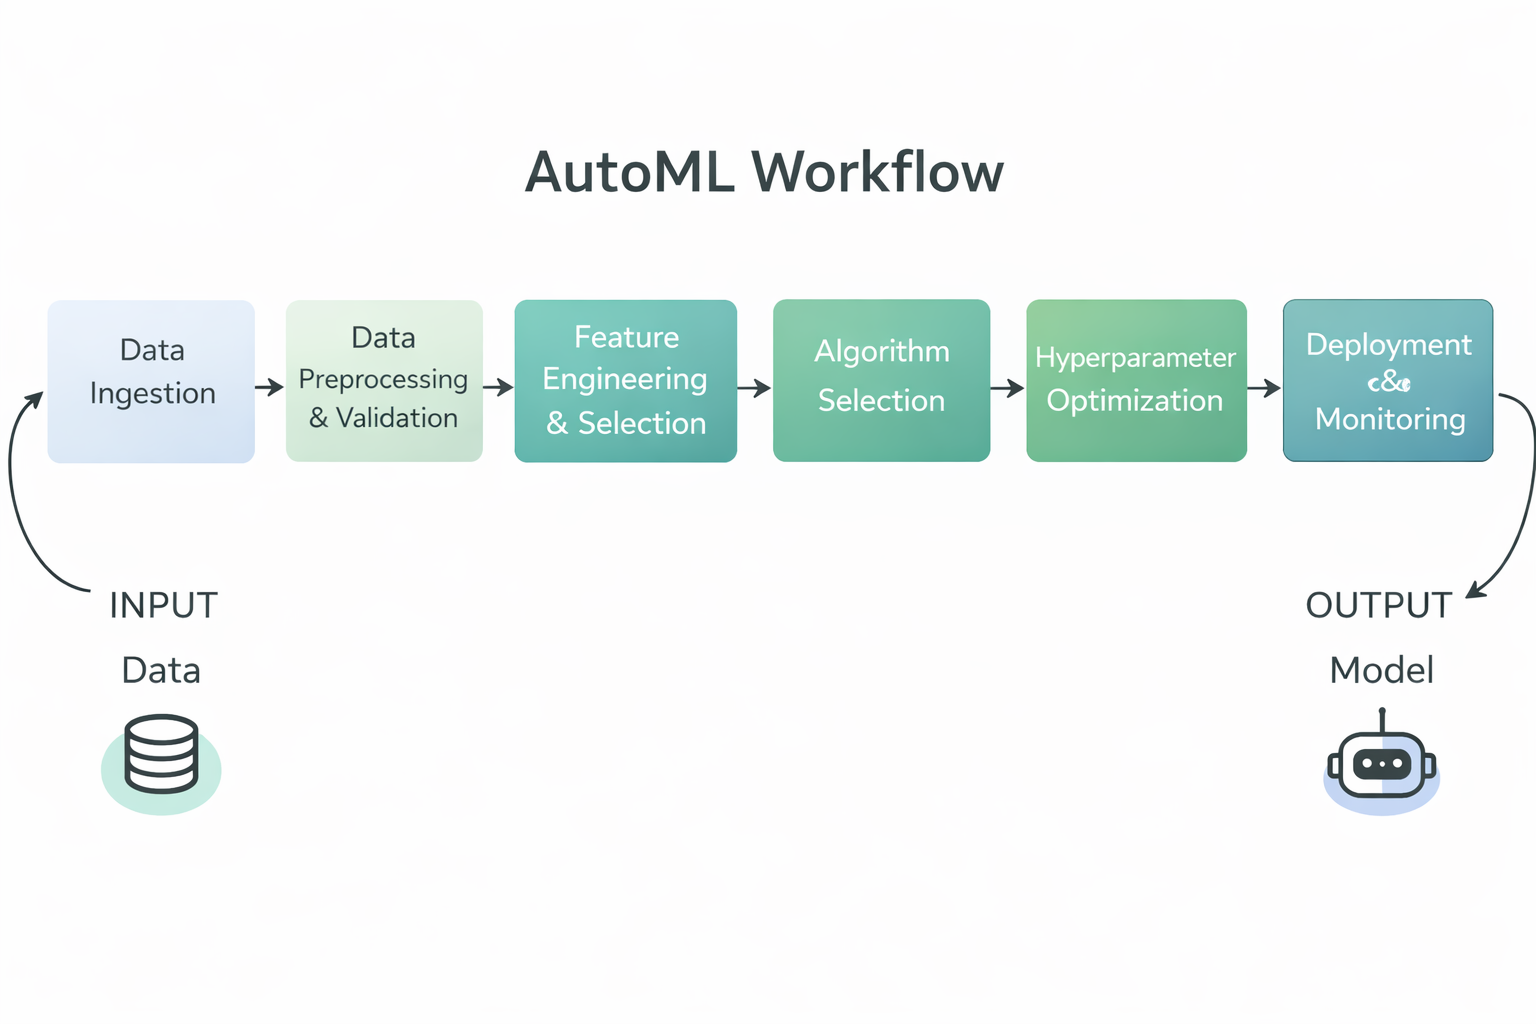
Diagram Alur Kerja AutoML
Secara spesifik, kerangka AutoML biasanya mengotomatisasi langkah-langkah berikut dalam alur kerja machine learning:
Dengan mengotomatisasi tugas-tugas ini, kerangka AutoML mengurangi upaya manual, meningkatkan konsistensi dan reprodusibilitas, serta memungkinkan tim teknis maupun non-teknis membangun model machine learning berkualitas tinggi dengan lebih cepat.
Kerangka AutoML open source menyediakan alat yang fleksibel, transparan, dan ramah pengembang yang memungkinkan praktisi mengotomatisasi pembangunan model sambil tetap mempertahankan kendali penuh atas data, pipeline, dan alur kerja deployment.
TPOT adalah kerangka AutoML Python open source yang menggunakan pemrograman genetik untuk secara otomatis menemukan dan mengoptimalkan pipeline machine learning lengkap.
Ia merumuskan desain pipeline sebagai masalah pencarian evolusioner, mengeksplorasi kombinasi langkah pra-pemrosesan, model, dan hyperparameter untuk mengidentifikasi solusi berkinerja tinggi.
TPOT sangat efektif untuk tugas data tabular di mana eksperimen cepat dan baseline yang kuat diperlukan, sekaligus memungkinkan praktisi untuk meninjau, mengekspor, dan menggunakan kembali pipeline yang dihasilkan dalam alur kerja scikit-learn standar.
Fitur Utama:
Contoh Kode:
Contoh ini menunjukkan penyiapan minimal untuk menggunakan TPOT. Fitur dan label dataset dimuat, sebuah TPOTClassifier diinisialisasi dengan pengaturan default, dan metode fit memicu proses pencarian otomatis.
Selama pelatihan, TPOT mengevaluasi beberapa kandidat pipeline menggunakan pemrograman genetik dan memilih model berkinerja tinggi berdasarkan metrik evaluasi yang ditentukan.
import tpot
X, y = load_my_data()
est = tpot.TPOTClassifier()
est.fit(X, y)AutoGluon adalah kerangka AutoML Python open-source yang dikembangkan oleh AWS AI yang mengotomatisasi tugas machine learning dengan fokus pada akurasi tinggi, kode minimal, dan dukungan untuk data tabular, teks, dan gambar.
Ia membangun beragam set model dan menggunakan pemilihan model otomatis, penalaan hyperparameter, serta pembelajaran ansambel untuk menghadirkan performa prediktif yang kuat di berbagai jenis data.
Fitur Utama:
Contoh Kode:
Kode ini memuat dataset pelatihan dan uji sebagai dataset tabular AutoGluon. Lalu membuat objek TabularPredictor dengan menetapkan label target dan memanggil fit untuk melatih AutoGluon pada data tabular pelatihan. Setelah pelatihan selesai, ia menggunakan model terlatih untuk menghasilkan prediksi pada set uji.
from autogluon.tabular import TabularDataset, TabularPredictor

label = "signature"
train_data = TabularDataset("train.csv")

predictor = TabularPredictor(label=label).fit(train_data)

test_data = TabularDataset("test.csv")
predictions = predictor.predict(test_data.drop(columns=[label]))FLAML (Fast Lightweight AutoML) adalah pustaka AutoML Python open source yang dikembangkan oleh Microsoft Research yang dirancang untuk secara otomatis dan efisien menemukan model machine learning berkualitas tinggi sambil meminimalkan biaya komputasi dan penggunaan sumber daya, sehingga ideal untuk lingkungan yang sangat mementingkan kecepatan dan efisiensi.
Fitur Utama:
Contoh Kode:
Contoh kode ini menunjukkan cara menggunakan kelas AutoML milik FLAML untuk melakukan tugas klasifikasi otomatis pada dataset Iris, dengan menetapkan batas waktu dan metrik evaluasi sebelum pelatihan lalu menggunakan model terlatih untuk memperoleh probabilitas prediksi.
from flaml import AutoML
from sklearn.datasets import load_iris

X_train, y_train = load_iris(return_X_y=True)

automl = AutoML()

automl_settings = {
    "time_budget": 1,
    "metric": "accuracy",
    "task": "classification",
    "log_file_name": "iris.log",
}

automl.fit(X_train=X_train, y_train=y_train, **automl_settings)

print(automl.predict_proba(X_train))AutoKeras adalah pustaka AutoML open-source yang dibangun di atas kerangka Keras deep learning yang secara otomatis mencari dan melatih jaringan saraf berkualitas tinggi untuk berbagai tugas, termasuk data terstruktur, gambar, dan teks, dengan kebutuhan penulisan kode yang minimal.
Ia menggunakan pencarian arsitektur neural yang efisien untuk menemukan arsitektur model dan hyperparameter yang sesuai, sehingga deep learning lebih mudah diakses baik oleh pemula maupun praktisi berpengalaman.
Fitur Utama:
StructuredDataClassifier menyederhanakan pelatihan model deep learning yang kompleks hanya dengan beberapa baris kode.Contoh Kode:
Contoh kode ini mengimpor pustaka yang diperlukan dan memuat dataset pelatihan serta uji dari URL yang disediakan. Kode memisahkan fitur dan label, lalu membuat objek ak.StructuredDataClassifier yang secara otomatis mencari model deep learning yang kuat. Model dilatih untuk sejumlah percobaan dan epoch tertentu, dan hasil evaluasi akhir pada set uji dicetak.
import keras
import pandas as pd
import autokeras as ak

TRAIN_DATA_URL = "https://storage.googleapis.com/tf-datasets/titanic/train.csv"
TEST_DATA_URL = "https://storage.googleapis.com/tf-datasets/titanic/eval.csv"

train_file_path = keras.utils.get_file("train.csv", TRAIN_DATA_URL)
test_file_path = keras.utils.get_file("eval.csv", TEST_DATA_URL)

train_df = pd.read_csv(train_file_path)
test_df = pd.read_csv(test_file_path)

y_train = train_df["survived"].values
x_train = train_df.drop("survived", axis=1).values

y_test = test_df["survived"].values
x_test = test_df.drop("survived", axis=1).values

clf = ak.StructuredDataClassifier(overwrite=True, max_trials=3)
clf.fit(x_train, y_train, epochs=10)

print(clf.evaluate(x_test, y_test))
Platform AutoML tanpa kode dan kode rendah menyederhanakan pengembangan model dengan mengabstraksi alur kerja yang kompleks, memungkinkan eksperimen dan deployment yang cepat untuk tim teknis maupun pengguna bisnis.
PyCaret adalah pustaka machine learning Python open-source berkode rendah yang mengotomatisasi alur kerja machine learning end-to-end untuk tugas seperti klasifikasi, regresi, pengelompokan, deteksi anomali, dan peramalan deret waktu, memungkinkan pembuatan prototipe cepat hanya dengan beberapa baris kode sekaligus mendukung antarmuka grafis bagi mereka yang lebih menyukai pengalaman kode rendah atau klik-klik.
Fitur Utama:
compare_models melatih dan mengevaluasi banyak model menggunakan cross-validation dan menyediakan papan peringkat performa untuk membantu memilih model terbaik.Contoh Kode:
Cuplikan kode ini menunjukkan pemuatan dataset bawaan, inisialisasi modul regresi PyCaret dengan setup (yang melakukan pra-pemrosesan data dan menginisialisasi lingkungan ML), lalu menggunakan compare_models untuk secara otomatis melatih, mengevaluasi, dan memberi peringkat berbagai model regresi, mengembalikan model berkinerja terbaik.
from pycaret.datasets import get_data
from pycaret.regression import *

data = get_data("insurance")

s = setup(data, target="charges", session_id=123)

best_model = compare_models()MLJAR Studio adalah lingkungan AutoML tanpa kode dan kode rendah yang memungkinkan Anda melatih dan membandingkan model machine learning melalui antarmuka terpandu, serta menawarkan alur kerja Python opsional melalui mesin open-source mljar-supervised.
Fitur Utama:
Contoh Kode:
Anda tidak memerlukan kode untuk menggunakan MLJAR Studio karena Anda dapat menjalankan AutoML melalui GUI. Namun, kode di bawah ini menunjukkan pendekatan pemrograman opsional menggunakan pustaka mljar-supervised. Kode ini memuat dataset, membaginya menjadi fitur dan target, menjalankan pelatihan AutoML, lalu menghasilkan prediksi menggunakan model terlatih.
import pandas as pd
from supervised.automl import AutoML

df = pd.read_csv(
    "https://raw.githubusercontent.com/pplonski/datasets-for-start/master/adult/data.csv",
    skipinitialspace=True,
)

X = df[df.columns[:-1]]
y = df["income"]

automl = AutoML(results_path="mljar_results")
automl.fit(X, y)

predictions = automl.predict(X)H2O AutoML adalah kemampuan AutoML open source dalam platform H2O yang menyediakan machine learning otomatis yang dapat diskalakan dengan dukungan untuk Python, R, dan antarmuka grafis tanpa kode bernama H2O Flow, memungkinkan pengguna teknis dan non-teknis membangun, mengevaluasi, dan memilih model dengan penulisan kode minimal. Pengguna dapat bekerja melalui antarmuka Flow berbasis web untuk mengimpor data, menjalankan eksperimen AutoML, mengeksplorasi hasil, dan mengekspor model tanpa menulis kode apa pun.
Fitur Utama:
Contoh Kode:
Contoh ini menunjukkan cara menggunakan H2O AutoML melalui Python. Kode menginisialisasi lingkungan H2O, mengimpor dataset pelatihan dan uji, menentukan kolom fitur dan target, memulai run AutoML dengan batas jumlah model, lalu menampilkan papan peringkat yang memeringkat model berkinerja terbaik.
Catatan: Meskipun ini adalah pendekatan terprogram, tugas yang sama dapat diselesaikan melalui antarmuka web H2O Flow tanpa menulis kode apa pun.
import h2o
from h2o.automl import H2OAutoML

h2o.init()

train = h2o.import_file(
    "https://s3.amazonaws.com/h2o-public-test-data/smalldata/higgs/higgs_train_10k.csv"
)
test = h2o.import_file(
    "https://s3.amazonaws.com/h2o-public-test-data/smalldata/higgs/higgs_test_5k.csv"
)

x = train.columns
y = "response"
x.remove(y)

train[y] = train[y].asfactor()
test[y] = test[y].asfactor()

aml = H2OAutoML(max_models=20, seed=1)
aml.train(x=x, y=y, training_frame=train)

aml.leaderboard
Solusi AutoML tingkat enterprise menghadirkan platform machine learning yang dapat diskalakan, aman, dan terkelola, dirancang untuk deployment produksi, kepatuhan, dan penggunaan operasional dalam skala besar.
DataRobot adalah platform AutoML tanpa kode dan kode rendah tingkat enterprise yang memungkinkan pengguna bisnis, analis, dan tim data membangun, meng-deploy, dan mengelola model machine learning tanpa pemrograman ekstensif.
Platform ini mengotomatisasi seluruh siklus hidup machine learning, dari pemasukan data dan rekayasa fitur hingga pelatihan model, deployment, dan pemantauan, sambil menyediakan tata kelola, keterjelasan, dan kontrol operasional yang kuat yang diperlukan di lingkungan teregulasi.
Fitur Utama:
Contoh Kode:
Meskipun DataRobot terutama digunakan melalui antarmuka tanpa kode, platform ini juga menyediakan API Python untuk kontrol terprogram dan otomasi. Contoh berikut menunjukkan cara melakukan autentikasi dengan DataRobot, membuat proyek dari dataset, dan menjalankan AutoPilot untuk secara otomatis melatih dan mengevaluasi model.
import datarobot as dr
dr.Client(config_path="./drconfig.yaml")

dataset = dr.Dataset.create_from_file("auto-mpg.csv")

project = dr.Project.create_from_dataset(
    dataset.id,
    project_name="Auto MPG Project"
)

from datarobot import AUTOPILOT_MODE
project.analyze_and_model(
    target="mpg",
    mode=AUTOPILOT_MODE.QUICK
)

project.wait_for_autopilot()Amazon SageMaker Autopilot adalah solusi AutoML terkelola penuh dari AWS yang memungkinkan pengguna mengotomatisasi alur kerja machine learning end-to-end dengan tanpa kode atau kode rendah, terutama melalui antarmuka web di Amazon SageMaker Canvas atau SageMaker Studio.
Pengguna dapat mengimpor data, mengonfigurasi variabel target, mengevaluasi model kandidat, dan mendepoy model hanya dengan beberapa klik di konsol, sementara SDK dan API Python tetap tersedia sebagai cara opsional untuk membuat eksperimen dapat direproduksi atau untuk diintegrasikan dengan sistem lain.
Fitur Utama:
Contoh Kode:
Kode di bawah ini menunjukkan cara menjalankan Amazon SageMaker Autopilot secara terprogram menggunakan SDK Python. Pendekatan ini opsional dan dapat digunakan untuk mereproduksi hasil atau mengintegrasikannya ke pipeline otomatis.
from sagemaker import AutoML, AutoMLInput

automl = AutoML(
    role=execution_role,
    target_attribute_name=target_attribute_name,
    sagemaker_session=pipeline_session,
    total_job_runtime_in_seconds=3600,
    mode="ENSEMBLING",
)

automl.fit(
    inputs=[
        AutoMLInput(
            inputs=s3_train_val,
            target_attribute_name=target_attribute_name,
            channel_type="training",
        )
    ]
)Google Cloud AutoML adalah bagian dari Vertex AI, platform machine learning terpadu Google Cloud yang memungkinkan pengguna membangun, melatih, mengevaluasi, dan mendepoy model berkualitas tinggi menggunakan infrastruktur yang sepenuhnya terkelola.
Vertex AI AutoML mendukung data tabular, pemrosesan bahasa alami, visi komputer, dan tugas video, dan dirancang agar dapat diakses melalui antarmuka web tanpa kode di Google Cloud Console.
Semua langkah inti, seperti pembuatan dataset, pemilihan tugas, pelatihan, evaluasi, dan deployment, dapat diselesaikan melalui UI tanpa menulis kode apa pun.
Fitur Utama:
Contoh Kode:
Meskipun Vertex AI AutoML terutama dirancang untuk alur kerja tanpa kode, SDK Python dapat digunakan untuk membuat eksperimen dapat direproduksi atau mengintegrasikan pelatihan AutoML ke pipeline otomatis.
Cuplikan singkat berikut menginisialisasi proyek Vertex AI, membuat dataset gambar dari indeks CSV yang disimpan di Cloud Storage, dan meluncurkan job pelatihan gambar AutoML.
from google.cloud import aiplatform

aiplatform.init(
    project="YOUR_PROJECT_ID",
    location="us-central1",
    staging_bucket="gs://YOUR_BUCKET",
)

dataset = aiplatform.ImageDataset.create(
    display_name="flowers",
    gcs_source=["gs://cloud-samples-data/ai-platform/flowers/flowers.csv"],
    import_schema_uri=aiplatform.schema.dataset.ioformat.image.single_label_classification,
)

training_job = aiplatform.AutoMLImageTrainingJob(
    display_name="flowers_automl",
    prediction_type="classification",
)

model = training_job.run(
    dataset=dataset,
    model_display_name="flowers_model",
    budget_milli_node_hours=8000,
)
Tabel ini membandingkan kerangka AutoML populer berdasarkan tingkat otomasi, gaya antarmuka, dan kesesuaiannya untuk eksperimen open source, alur kerja kode rendah, dan deployment skala enterprise.
|
Kerangka |
Kategori |
Tingkat Kode |
Opsi Antarmuka |
Use Case Utama |
|
TPOT |
Open Source |
Tinggi |
Python API |
Penemuan dan optimasi pipeline otomatis untuk data tabular |
|
AutoGluon |
Open Source |
Rendah |
Python API |
Model siap produksi yang cepat dan akurat lintas modalitas |
|
FLAML |
Open Source |
Rendah |
Python API |
Penalaan model yang hemat biaya dan sadar sumber daya |
|
AutoKeras |
Open Source |
Sedang |
Python API |
Pencarian arsitektur neural dan otomasi deep learning |
|
PyCaret |
Kode Rendah |
Sangat Rendah |
Python API, alat GUI opsional |
Eksperimen cepat dan alur kerja berbasis analitik |
|
MLJAR Studio |
Tanpa Kode |
Tidak Ada |
Web UI, Python opsional |
Eksperimen AutoML yang ramah bisnis dan perbandingan model |
|
H2O AutoML |
Hibrida |
Rendah |
Web UI (H2O Flow), Python, R |
AutoML yang dapat diskalakan untuk dataset besar dan deployment enterprise |
|
DataRobot |
Enterprise |
Tidak Ada hingga Rendah |
Web UI, Python API |
ML enterprise dengan tata kelola, keterjelasan, dan MLOps |
|
SageMaker Autopilot |
Enterprise |
Tidak Ada hingga Rendah |
AWS Console, Python SDK |
AutoML native AWS yang terintegrasi dengan pipeline produksi |
|
Google Cloud AutoML |
Enterprise |
Tidak Ada |
Vertex AI Console, SDK opsional |
AutoML untuk Visi, NLP, dan tabular di infrastruktur GCP terkelola |
Kerangka AutoML telah berkembang menjadi alat siap produksi yang mendukung tim di seluruh siklus hidup machine learning. Dalam pengaturan praktis, alat ini tidak terbatas pada eksperimen atau pembuatan prototipe.
Saya telah menggunakan kerangka AutoML untuk berpartisipasi dalam kompetisi Kaggle, membangun pipeline machine learning end-to-end lengkap untuk proyek nyata, dan bahkan untuk mempersiapkan serta berhasil dalam wawancara teknis.
Dari perspektif data scientist, AutoML adalah cara yang ampuh untuk menetapkan model baseline yang kuat dan tidak bias dengan overhead yang sangat kecil.
Dengan hanya menyediakan data, kerangka ini menangani rekayasa fitur, pemilihan model, penalaan hyperparameter, dan evaluasi. Ini memungkinkan praktisi berfokus pada pemahaman masalah, memvalidasi asumsi, dan meningkatkan hasil, alih-alih menghabiskan terlalu banyak waktu meneliti dan menguji model dari nol.
AutoML tidak menggantikan keahlian. Sebaliknya, ia mempercepat alur kerja dengan menyediakan titik awal andal yang dapat ditingkatkan secara iteratif.
Membangun model hanyalah langkah pertama. Pelajari cara meng-deploy dan memantau model AutoML Anda di produksi melalui kursus MLOps Concepts.
Kursus DataCamp Teratas
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt




