Le tecnologie big data sono fondamentali perché la quantità e la complessità dei dati prodotti dalle aziende aumentano ogni giorno. Gli strumenti tradizionali non bastano a gestire i big data: queste tecnologie consentono una gestione efficiente dei dati e l’estrazione di insight che guidano decisioni informate. Restare aggiornati su strumenti e trend è cruciale per chi vuole entrare o accelerare la carriera in questo ambito.
Che cos’è la tecnologia Big Data?
La tecnologia big data comprende gli strumenti e i framework che elaborano, archiviano e analizzano dataset complessi e di grandi dimensioni.
Secondo Gartner, la definizione di big data è “Asset informativi ad alto volume, alta velocità e alta varietà che richiedono forme innovative ed economicamente vantaggiose di elaborazione delle informazioni per approfondire la conoscenza e migliorare le decisioni”.
Caratteristiche dei Big Data. Fonte immagine: autore
- Volume: la crescita dei volumi di dati è stata enorme. Ogni secondo si generano quantità massicce di dati da social media, sensori, transazioni finanziarie e altro. Gestire questo livello di volume richiede sistemi di archiviazione avanzati e potenza di elaborazione scalabile per tenere il passo.
- Varietà: i dati hanno forme diverse. Possono essere strutturati, come quelli ordinati in fogli di calcolo e database. Oppure non strutturati, come testi, immagini, video e post sui social che non rientrano in un formato semplice. Esistono anche dati semi-strutturati, come file JSON e XML, a metà strada tra i due. Ogni tipo richiede approcci diversi per essere analizzato e compreso.
- Segue la velocità, ovvero la rapidità con cui i dati vengono generati e devono essere elaborati. Con i dispositivi IoT (internet delle cose) e i flussi in tempo reale da social media e transazioni finanziarie, la capacità di acquisire, processare e analizzare velocemente questi dati è diventata fondamentale per prendere decisioni tempestive.
- Veridicità: garantire che i dati siano accurati e affidabili è cruciale, perché dati scorretti portano a decisioni sbagliate e possono danneggiare il business. Allo stesso tempo, puntare alla perfezione assoluta può rallentare i processi e ritardare le decisioni. Serve quindi un equilibrio adeguato in linea con le esigenze dell’azienda.
Le tecnologie big data permettono alle organizzazioni di gestire in modo efficiente dati strutturati e non strutturati e di ricavarne insight significativi. Poiché i dati sono un asset strategico, queste tecnologie sono diventate essenziali per mantenere un vantaggio competitivo sostenibile in settori come sanità, finanza e retail. I big data non sono più solo un’esigenza tecnica: sono diventati un imperativo di business.
Tipi di tecnologie Big Data
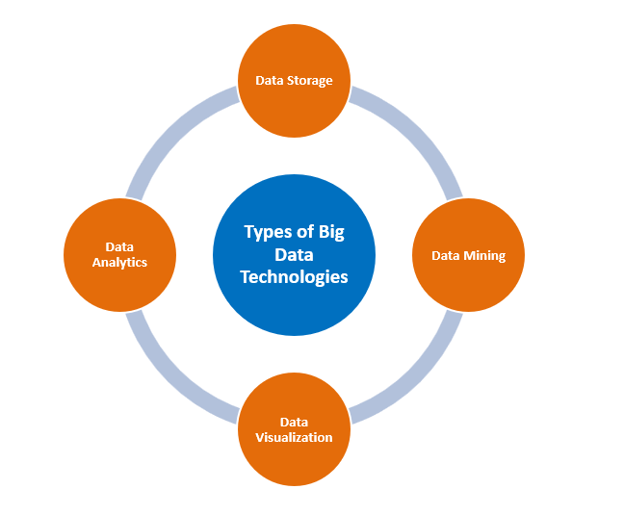
Tipi di tecnologie Big Data. Fonte immagine: autore
Archiviazione dati
Apache Hadoop
Hadoop è un framework open-source che fornisce archiviazione scalabile distribuendo i dati su cluster di macchine. È progettato per scalare da un singolo server a migliaia di macchine, diventando un framework fondamentale e potente nelle infrastrutture big data. L’economicità di Hadoop lo rende anche un’opzione interessante per le organizzazioni che gestiscono enormi quantità di dati a un costo inferiore rispetto ai database tradizionali.
Hadoop ha due componenti principali:
- HDFS: un sistema di archiviazione scalabile che suddivide i dati in blocchi più piccoli distribuendoli su più server. Ciò significa che, anche se alcuni server falliscono, i dati restano al sicuro.
- MapReduce è invece un modello di programmazione che divide attività grandi in parti più piccole, elaborabili in parallelo per accelerare il processo.
Apache Spark
Apache Spark è un altro strumento potente per i big data. A differenza di MapReduce di Hadoop, Spark elabora i dati in memoria, risultando molto più veloce ed efficiente. Gestisce anche vari tipi di attività, tra cui batch processing, dati in tempo reale, machine learning e analisi di grafi, rendendolo una scelta versatile per esigenze diverse.
Gli RDD (Resilient Distributed Datasets) di Spark gli permettono di memorizzare i dati in memoria ed elaborarli rapidamente, garantendo al contempo tolleranza ai guasti. Spark può anche lavorare con HDFS di Hadoop per l’archiviazione sfruttando le sue capacità di elaborazione veloce.
MongoDB
MongoDB è un database NoSQL progettato per dati non strutturati. La sua flessibilità nel gestire tipi di dati vari lo rende ideale per ambienti in rapida crescita e applicazioni dinamiche. La scalabilità orizzontale di MongoDB è particolarmente utile in scenari in cui i database relazionali non bastano, come le piattaforme social e l’analisi in tempo reale. È spesso usato per analytics in tempo reale, sistemi di gestione dei contenuti e applicazioni Internet of Things (IoT), dove flessibilità e velocità sono fondamentali.
Data mining
RapidMiner
RapidMiner di Altair è una piattaforma di analisi dei dati e AI che supporta l’intero ciclo di vita della data science, consentendo di estrarre insight da grandi dataset e costruire modelli predittivi con facilità.
La natura open-source e l’integrazione con librerie di machine learning gli conferiscono un vantaggio per chi vuole prototipare rapidamente e distribuire in produzione.
La piattaforma unificata è progettata per diversi profili – da data scientist e ingegneri ad analisti di business e manager – per lavorare in un unico ambiente.
Puoi anche integrare RapidMiner con più librerie di machine learning come TensorFlow, Weka e H2O, così da sperimentare rapidamente diversi algoritmi e approcci.
Presto
Presto si definisce “un motore SQL di query veloce e affidabile per data analytics e l’open lakehouse”.
Il motore offre un’interfaccia ANSI SQL semplice, consentendo di interrogare grandi dataset da più fonti. Fornisce anche analytics in tempo reale. Presto è efficiente per le aziende che necessitano di analisi interattive su dati distribuiti. La capacità di interrogare i data lake senza dover trasformare i dati lo rende un favorito tra i data engineer in cerca di flessibilità e performance.
Data analytics
Apache Spark
Big data analytics è probabilmente uno dei primi concetti che vengono in mente quando si parla di Apache Spark. Questo perché Spark eccelle nell’elaborazione su larga scala grazie all’architettura in-memory, abilitando analytics in tempo reale e tempi di processamento più rapidi.
Per l’uso di dati batch e in streaming, Spark è ben attrezzato, ed è per questo che è impiegato in machine learning, elaborazione in tempo reale e persino nell’analisi di grafi.
La caratteristica più importante in questo ambito è il calcolo iterativo di Spark, alla base del suo ampio utilizzo nei problemi di machine learning che richiedono molteplici cicli di calcolo intensivo.
Inoltre, il supporto API per Python, Java, Scala e altri linguaggi di programmazione agevola il passaggio tra sviluppatori e, quindi, all’interno delle organizzazioni.
Splunk
Le capacità di analytics in tempo reale e AI di Splunk permettono alle aziende di monitorare i dati generati dalle macchine, rilevare anomalie e prendere decisioni data-driven più velocemente.
Splunk è stato un grande alleato per le organizzazioni che dipendono dalla disponibilità istantanea di intelligence operativa. Raccoglie ed elabora una varietà di dati generati dalle macchine, inclusi log, metriche ed eventi, che aiutano a capire cosa sta accadendo nei sistemi IT di un’organizzazione.
Splunk vanta anche una funzione sostanziale di reportistica, che aiuta gli utenti finali a costruire dashboard complesse multi-pagina, facili da interpretare e gradevoli da vedere.
Data visualization
Tableau
Il sito di Tableau lo definisce “una piattaforma di analisi visiva che trasforma il modo in cui usiamo i dati per risolvere i problemi, consentendo a persone e organizzazioni di sfruttare al massimo i loro dati”.
Leader nel campo della business intelligence, offre un’interfaccia potente e intuitiva per creare visualizzazioni dinamiche che forniscono insight approfonditi. La capacità di integrare dati da varie fonti lo rende ancor più in linea con le esigenze degli utenti di business.
Il suo punto di forza è la versatilità: dai dashboard di alto livello per i manager a report dettagliati con drill-down per gli analisti.
Power BI
Secondo Microsoft, “Power BI è un insieme di servizi software, app e connettori che lavorano insieme per trasformare le tue fonti di dati non correlate in insight coerenti, visivamente coinvolgenti e interattivi”.
Power BI si integra perfettamente con altri strumenti, soprattutto quelli Microsoft, e consente di creare report completi e interattivi. I team possono collaborare in tempo reale grazie al servizio basato su cloud.
Applicazioni delle tecnologie Big Data
Sanità
I big data stanno rivoluzionando il settore sanitario in molte aree applicative:
Una delle applicazioni chiave è la predizione tramite analytics, in cui variabili come storia clinica, genetica, pressione sanguigna e altri dati legati allo stile di vita vengono analizzate per prevedere la probabilità di malattie. Ciò consente interventi precoci e trattamenti personalizzati, aiutando a prevenire o gestire le condizioni in modo più efficace e a ridurre i costi sanitari.
Il monitoraggio preventivo dei pazienti è un’altra area in cui i big data brillano. I dispositivi indossabili raccolgono dati sanitari in tempo reale consentendo di rilevare tempestivamente anomalie e intervenire subito. È particolarmente utile per gestire condizioni croniche e prevenire i ricoveri ripetuti.
Nella ricerca medica, i big data accelerano la scoperta di nuovi farmaci e trattamenti analizzando enormi dataset da trial clinici, studi genomici e cartelle cliniche. Questo avviene attraverso una migliore identificazione, sperimentazione e valutazione dell’efficacia dei farmaci, portando a progressi più rapidi.
Infine, le tecniche di ottimizzazione lineare e non lineare, abilitate dalle tecnologie big data, possono essere usate per ottimizzare la programmazione, ridurre i tempi di attesa e migliorare l’erogazione complessiva delle cure.
Finanza
Le istituzioni finanziarie usano i big data per molti casi d’uso, tra cui:
- Il trading quantitativo utilizza algoritmi per analizzare dati di mercato in tempo reale, prezzi storici e trend per eseguire operazioni più rapidamente che mai. Ciò richiede la gestione di grandi volumi di dati in tempo reale, un’area che necessita di capacità big data.
- Il rilevamento delle frodi è probabilmente l’applicazione più nota. Le analytics sui big data possono individuare pattern e anomalie in tempo reale e segnalare le transazioni sospette per ulteriori verifiche. Questo aiuta a prevenire le frodi, proteggere i clienti e ridurre le perdite.
- Tecniche di machine learning non supervisionato possono essere applicate ai big data per abilitare la customer analytics, rendendo possibili decisioni strategiche legate a marketing mirato, raccomandazioni di investimento e pianificazione finanziaria personalizzata.
- Infine, i big data migliorano l’efficienza operativa identificando colli di bottiglia e automatizzando i processi. Dalla manutenzione predittiva all’ottimizzazione dei processi, le istituzioni finanziarie possono ridurre i costi, migliorare la produttività e offrire servizi migliori.
Retail
I retailer sfruttano i big data in diverse aree applicative, come:
- I big data aiutano a ottimizzare supply chain e gestione dell’inventario analizzando dati storici di vendita, domanda e performance dei fornitori. Questo assicura, da un lato, di evitare carenze di prodotto e, dall’altro, di non far crescere i costi di giacenza.
- La location analytics è un’altra area in cui i big data fanno la differenza. Sfruttando e analizzando dati geografici e demografici, le catene retail possono prendere decisioni guidate dai dati su localizzazione dei negozi, tipologie di store e strategia.
- I big data stanno anche trasformando il retail convertendo enormi quantità di dati dei clienti in insight azionabili. Analizzare il comportamento dei clienti, come cronologia degli acquisti e pattern di navigazione, permette ai retailer di offrire suggerimenti di prodotto su misura. Questo migliora l’esperienza d’acquisto e aumenta vendite e fidelizzazione.
Trend emergenti nelle tecnologie Big Data
Edge computing
Secondo la definizione di IBM, “l’edge computing è un framework di calcolo distribuito che porta le applicazioni aziendali più vicino alle fonti di dati, come dispositivi IoT o server edge locali. Questa prossimità ai dati alla fonte può offrire vantaggi significativi, tra cui insight più rapidi, tempi di risposta migliorati e migliore disponibilità di banda”.
La prossimità ai dati ne consente l’elaborazione più vicino alla fonte, riducendo la latenza e migliorando la velocità delle decisioni. È cruciale nelle applicazioni IoT in cui l’elaborazione in tempo reale è essenziale. Inoltre, non dovendo trasferire i dati in sedi centralizzate, l’edge computing può ridurre l’uso di banda e i tempi di risposta. Il risultato sono decisioni data-driven più rapide e accurate.
Integrazione dell’AI
Secondo la definizione di RST, “l’integrazione dell’AI intreccia le capacità di intelligenza artificiale direttamente in prodotti e sistemi. Invece di operare come strumento esterno, l’AI viene integrata nativamente per potenziare ogni aspetto delle prestazioni”.
Integrare l’intelligenza artificiale (AI) con i big data ha trasformato il modo in cui le aziende analizzano e agiscono sui dati. Gli algoritmi di AI, in particolare i modelli di machine learning (ML), consentono ai sistemi di rilevare pattern, fare previsioni e automatizzare i processi decisionali.
Per esempio, nella manifattura l’integrazione dell’AI aiuta con la manutenzione predittiva, permettendo di individuare quando un macchinario rischia di guastarsi e intervenire in anticipo. Questo riduce i tempi di fermo e i costi operativi. Allo stesso modo, il rilevamento di anomalie basato su AI può identificare transazioni insolite in finanza, aiutando a prevenire frodi in tempo reale.
Ambienti cloud ibridi
Secondo Microsoft, “un cloud ibrido — talvolta chiamato cloud ibrido — è un ambiente di calcolo che combina un data center on-premise con un cloud pubblico, consentendo la condivisione di dati e applicazioni tra i due”.
Un’architettura cloud ibrida combina il meglio della scalabilità del cloud pubblico con la sicurezza on-premise. Offre la flessibilità di conservare in casa i dati sensibili in modo sicuro, usando il cloud per carichi più ampi e meno sensibili. Gli ambienti ibridi sono anche convenienti perché permettono di scalare l’infrastruttura in base alle esigenze.
Sfide nell’implementazione delle tecnologie Big Data
Implementare tecnologie big data offre numerosi vantaggi, ma comporta anche diverse sfide. Alcune considerazioni sono elencate di seguito:
- Integrazione dei dati: integrare dati da varie fonti – strutturati, non strutturati, semi-strutturati – pone sfide nel garantire coerenza e accuratezza.
- Scalabilità: con la crescita dei volumi di dati, l’infrastruttura deve poter scalare in modo efficiente senza degradare le prestazioni.
- Sicurezza: proteggere i dati sensibili negli ecosistemi big data richiede una crittografia robusta, controlli di accesso e conformità normativa. Con regolamenti come GDPR e CCPA, le organizzazioni di tutto il mondo sono sotto crescente pressione per implementare pratiche di sicurezza garantendo al contempo la privacy degli utenti.
- Costi elevati: implementare e mantenere un’infrastruttura big data richiede investimenti significativi sia in tecnologia sia in talenti.
- Qualità e governance dei dati: poiché i dati sono raccolti da più fonti, garantirne accuratezza, coerenza e affidabilità diventa una sfida. Inoltre, la mancanza di governance può portare a problemi di conformità e rischi di business.
Conclusione
Le tecnologie big data sono un’esigenza strategica per ottenere vantaggi competitivi ricavando insight azionabili da dataset massivi. Dallo storage all’analisi e alla visualizzazione, questi strumenti sono i pilastri su cui si basa il moderno decision making data-driven. Restare informati sui trend emergenti come integrazione dell’AI, edge computing e architetture cloud ibride consente alle aziende di scalare in modo efficiente e innovare nella gestione dei dati. Padroneggiare queste tecnologie permette di trasformare dati grezzi in asset di valore, generando vantaggio competitivo in un’economia data-centrica. Tuttavia, è importante comprendere costi e altre sfide prima di prendere decisioni di implementazione.
Per approfondire, valuta le seguenti risorse:





Le tecnologie big data sono fondamentali perché la quantità e la complessità dei dati prodotti dalle aziende aumentano ogni giorno. Gli strumenti tradizionali non bastano a gestire i big data: queste tecnologie consentono una gestione efficiente dei dati e l’estrazione di insight che guidano decisioni informate. Restare aggiornati su strumenti e trend è cruciale per chi vuole entrare o accelerare la carriera in questo ambito.
Che cos’è la tecnologia Big Data?
La tecnologia big data comprende gli strumenti e i framework che elaborano, archiviano e analizzano dataset complessi e di grandi dimensioni.
Secondo Gartner, la definizione di big data è “Asset informativi ad alto volume, alta velocità e alta varietà che richiedono forme innovative ed economicamente vantaggiose di elaborazione delle informazioni per approfondire la conoscenza e migliorare le decisioni”.
Caratteristiche dei Big Data. Fonte immagine: autore
Le tecnologie big data permettono alle organizzazioni di gestire in modo efficiente dati strutturati e non strutturati e di ricavarne insight significativi. Poiché i dati sono un asset strategico, queste tecnologie sono diventate essenziali per mantenere un vantaggio competitivo sostenibile in settori come sanità, finanza e retail. I big data non sono più solo un’esigenza tecnica: sono diventati un imperativo di business.
Tipi di tecnologie Big Data
Tipi di tecnologie Big Data. Fonte immagine: autore
Archiviazione dati
Apache Hadoop
Hadoop è un framework open-source che fornisce archiviazione scalabile distribuendo i dati su cluster di macchine. È progettato per scalare da un singolo server a migliaia di macchine, diventando un framework fondamentale e potente nelle infrastrutture big data. L’economicità di Hadoop lo rende anche un’opzione interessante per le organizzazioni che gestiscono enormi quantità di dati a un costo inferiore rispetto ai database tradizionali.
Hadoop ha due componenti principali:
Apache Spark
Apache Spark è un altro strumento potente per i big data. A differenza di MapReduce di Hadoop, Spark elabora i dati in memoria, risultando molto più veloce ed efficiente. Gestisce anche vari tipi di attività, tra cui batch processing, dati in tempo reale, machine learning e analisi di grafi, rendendolo una scelta versatile per esigenze diverse.
Gli RDD (Resilient Distributed Datasets) di Spark gli permettono di memorizzare i dati in memoria ed elaborarli rapidamente, garantendo al contempo tolleranza ai guasti. Spark può anche lavorare con HDFS di Hadoop per l’archiviazione sfruttando le sue capacità di elaborazione veloce.
MongoDB
MongoDB è un database NoSQL progettato per dati non strutturati. La sua flessibilità nel gestire tipi di dati vari lo rende ideale per ambienti in rapida crescita e applicazioni dinamiche. La scalabilità orizzontale di MongoDB è particolarmente utile in scenari in cui i database relazionali non bastano, come le piattaforme social e l’analisi in tempo reale. È spesso usato per analytics in tempo reale, sistemi di gestione dei contenuti e applicazioni Internet of Things (IoT), dove flessibilità e velocità sono fondamentali.
Data mining
RapidMiner
RapidMiner di Altair è una piattaforma di analisi dei dati e AI che supporta l’intero ciclo di vita della data science, consentendo di estrarre insight da grandi dataset e costruire modelli predittivi con facilità.
La natura open-source e l’integrazione con librerie di machine learning gli conferiscono un vantaggio per chi vuole prototipare rapidamente e distribuire in produzione.
La piattaforma unificata è progettata per diversi profili – da data scientist e ingegneri ad analisti di business e manager – per lavorare in un unico ambiente.
Puoi anche integrare RapidMiner con più librerie di machine learning come TensorFlow, Weka e H2O, così da sperimentare rapidamente diversi algoritmi e approcci.
Presto
Presto si definisce “un motore SQL di query veloce e affidabile per data analytics e l’open lakehouse”.
Il motore offre un’interfaccia ANSI SQL semplice, consentendo di interrogare grandi dataset da più fonti. Fornisce anche analytics in tempo reale. Presto è efficiente per le aziende che necessitano di analisi interattive su dati distribuiti. La capacità di interrogare i data lake senza dover trasformare i dati lo rende un favorito tra i data engineer in cerca di flessibilità e performance.
Data analytics
Apache Spark
Big data analytics è probabilmente uno dei primi concetti che vengono in mente quando si parla di Apache Spark. Questo perché Spark eccelle nell’elaborazione su larga scala grazie all’architettura in-memory, abilitando analytics in tempo reale e tempi di processamento più rapidi.
Per l’uso di dati batch e in streaming, Spark è ben attrezzato, ed è per questo che è impiegato in machine learning, elaborazione in tempo reale e persino nell’analisi di grafi.
La caratteristica più importante in questo ambito è il calcolo iterativo di Spark, alla base del suo ampio utilizzo nei problemi di machine learning che richiedono molteplici cicli di calcolo intensivo.
Inoltre, il supporto API per Python, Java, Scala e altri linguaggi di programmazione agevola il passaggio tra sviluppatori e, quindi, all’interno delle organizzazioni.
Splunk
Le capacità di analytics in tempo reale e AI di Splunk permettono alle aziende di monitorare i dati generati dalle macchine, rilevare anomalie e prendere decisioni data-driven più velocemente.
Splunk è stato un grande alleato per le organizzazioni che dipendono dalla disponibilità istantanea di intelligence operativa. Raccoglie ed elabora una varietà di dati generati dalle macchine, inclusi log, metriche ed eventi, che aiutano a capire cosa sta accadendo nei sistemi IT di un’organizzazione.
Splunk vanta anche una funzione sostanziale di reportistica, che aiuta gli utenti finali a costruire dashboard complesse multi-pagina, facili da interpretare e gradevoli da vedere.
Data visualization
Tableau
Il sito di Tableau lo definisce “una piattaforma di analisi visiva che trasforma il modo in cui usiamo i dati per risolvere i problemi, consentendo a persone e organizzazioni di sfruttare al massimo i loro dati”.
Leader nel campo della business intelligence, offre un’interfaccia potente e intuitiva per creare visualizzazioni dinamiche che forniscono insight approfonditi. La capacità di integrare dati da varie fonti lo rende ancor più in linea con le esigenze degli utenti di business.
Il suo punto di forza è la versatilità: dai dashboard di alto livello per i manager a report dettagliati con drill-down per gli analisti.
Power BI
Secondo Microsoft, “Power BI è un insieme di servizi software, app e connettori che lavorano insieme per trasformare le tue fonti di dati non correlate in insight coerenti, visivamente coinvolgenti e interattivi”.
Power BI si integra perfettamente con altri strumenti, soprattutto quelli Microsoft, e consente di creare report completi e interattivi. I team possono collaborare in tempo reale grazie al servizio basato su cloud.
Applicazioni delle tecnologie Big Data
Sanità
I big data stanno rivoluzionando il settore sanitario in molte aree applicative:
Una delle applicazioni chiave è la predizione tramite analytics, in cui variabili come storia clinica, genetica, pressione sanguigna e altri dati legati allo stile di vita vengono analizzate per prevedere la probabilità di malattie. Ciò consente interventi precoci e trattamenti personalizzati, aiutando a prevenire o gestire le condizioni in modo più efficace e a ridurre i costi sanitari.
Il monitoraggio preventivo dei pazienti è un’altra area in cui i big data brillano. I dispositivi indossabili raccolgono dati sanitari in tempo reale consentendo di rilevare tempestivamente anomalie e intervenire subito. È particolarmente utile per gestire condizioni croniche e prevenire i ricoveri ripetuti.
Nella ricerca medica, i big data accelerano la scoperta di nuovi farmaci e trattamenti analizzando enormi dataset da trial clinici, studi genomici e cartelle cliniche. Questo avviene attraverso una migliore identificazione, sperimentazione e valutazione dell’efficacia dei farmaci, portando a progressi più rapidi.
Infine, le tecniche di ottimizzazione lineare e non lineare, abilitate dalle tecnologie big data, possono essere usate per ottimizzare la programmazione, ridurre i tempi di attesa e migliorare l’erogazione complessiva delle cure.
Finanza
Le istituzioni finanziarie usano i big data per molti casi d’uso, tra cui:
Retail
I retailer sfruttano i big data in diverse aree applicative, come:
Trend emergenti nelle tecnologie Big Data
Edge computing
Secondo la definizione di IBM, “l’edge computing è un framework di calcolo distribuito che porta le applicazioni aziendali più vicino alle fonti di dati, come dispositivi IoT o server edge locali. Questa prossimità ai dati alla fonte può offrire vantaggi significativi, tra cui insight più rapidi, tempi di risposta migliorati e migliore disponibilità di banda”.
La prossimità ai dati ne consente l’elaborazione più vicino alla fonte, riducendo la latenza e migliorando la velocità delle decisioni. È cruciale nelle applicazioni IoT in cui l’elaborazione in tempo reale è essenziale. Inoltre, non dovendo trasferire i dati in sedi centralizzate, l’edge computing può ridurre l’uso di banda e i tempi di risposta. Il risultato sono decisioni data-driven più rapide e accurate.
Integrazione dell’AI
Secondo la definizione di RST, “l’integrazione dell’AI intreccia le capacità di intelligenza artificiale direttamente in prodotti e sistemi. Invece di operare come strumento esterno, l’AI viene integrata nativamente per potenziare ogni aspetto delle prestazioni”.
Integrare l’intelligenza artificiale (AI) con i big data ha trasformato il modo in cui le aziende analizzano e agiscono sui dati. Gli algoritmi di AI, in particolare i modelli di machine learning (ML), consentono ai sistemi di rilevare pattern, fare previsioni e automatizzare i processi decisionali.
Per esempio, nella manifattura l’integrazione dell’AI aiuta con la manutenzione predittiva, permettendo di individuare quando un macchinario rischia di guastarsi e intervenire in anticipo. Questo riduce i tempi di fermo e i costi operativi. Allo stesso modo, il rilevamento di anomalie basato su AI può identificare transazioni insolite in finanza, aiutando a prevenire frodi in tempo reale.
Ambienti cloud ibridi
Secondo Microsoft, “un cloud ibrido — talvolta chiamato cloud ibrido — è un ambiente di calcolo che combina un data center on-premise con un cloud pubblico, consentendo la condivisione di dati e applicazioni tra i due”.
Un’architettura cloud ibrida combina il meglio della scalabilità del cloud pubblico con la sicurezza on-premise. Offre la flessibilità di conservare in casa i dati sensibili in modo sicuro, usando il cloud per carichi più ampi e meno sensibili. Gli ambienti ibridi sono anche convenienti perché permettono di scalare l’infrastruttura in base alle esigenze.
Sfide nell’implementazione delle tecnologie Big Data
Implementare tecnologie big data offre numerosi vantaggi, ma comporta anche diverse sfide. Alcune considerazioni sono elencate di seguito:
Conclusione
Le tecnologie big data sono un’esigenza strategica per ottenere vantaggi competitivi ricavando insight azionabili da dataset massivi. Dallo storage all’analisi e alla visualizzazione, questi strumenti sono i pilastri su cui si basa il moderno decision making data-driven. Restare informati sui trend emergenti come integrazione dell’AI, edge computing e architetture cloud ibride consente alle aziende di scalare in modo efficiente e innovare nella gestione dei dati. Padroneggiare queste tecnologie permette di trasformare dati grezzi in asset di valore, generando vantaggio competitivo in un’economia data-centrica. Tuttavia, è importante comprendere costi e altre sfide prima di prendere decisioni di implementazione.
Per approfondire, valuta le seguenti risorse: