Corso
Capire il Machine Learning
2 ore
313.7K
Questo post del blog introdurrà il concetto di "transfer learning" e come viene utilizzato nelle applicazioni di machine learning. Il transfer learning non è un modello o una tecnica di machine learning; è piuttosto una "metodologia di progettazione" all'interno del machine learning. Un altro tipo di "metodologia di progettazione" è, per esempio, l'active learning.
Nel prossimo post del blog spiegheremo come usare l'active learning insieme al transfer learning per sfruttare al meglio i dati esistenti (e nuovi). In senso ampio, le applicazioni di machine learning che sfruttano informazioni esterne per migliorare le prestazioni o le capacità di generalizzazione utilizzano il transfer learning.
L'idea generale del transfer learning è usare la conoscenza appresa da compiti per i quali è disponibile un'ampia quantità di dati etichettati in contesti in cui sono disponibili solo pochi dati etichettati. Creare dati etichettati è costoso, quindi sfruttare al meglio i dataset esistenti è fondamentale.
In un modello di machine learning tradizionale, l'obiettivo principale è generalizzare a dati mai visti sulla base dei pattern appresi dai dati di training. Con il transfer learning, cerchi di dare il via a questo processo di generalizzazione partendo da pattern appresi per un compito diverso. In sostanza, invece di iniziare l'apprendimento da un foglio bianco (spesso inizializzato casualmente), parti da pattern che sono stati appresi per risolvere un altro compito.
Il trasferimento di conoscenza e pattern è possibile in un'ampia varietà di domini. Il post di oggi illustrerà il transfer learning guardando a diversi esempi in questi vari domini. L'obiettivo è incoraggiare i data scientist a sperimentare il transfer learning nei loro progetti di machine learning e renderli consapevoli dei vantaggi e degli svantaggi.
Ci sono tre ragioni per cui ritengo che una buona comprensione del transfer learning sia una competenza fondamentale per un data scientist:
 |
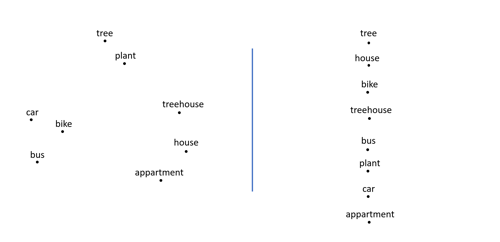 |
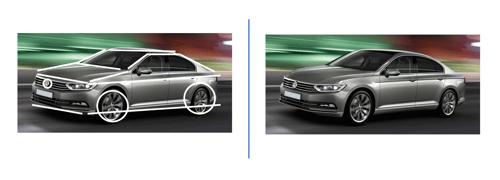
Il transfer learning, come dice il nome, richiede la capacità di trasferire conoscenza da un dominio a un altro. Il transfer learning può essere interpretato ad alto livello, cioè le architetture dei modelli NLP possono essere riutilizzate in problemi di previsione di sequenze, poiché molti problemi NLP possono essere ricondotti intrinsecamente alla previsione di sequenze. Il transfer learning può anche essere interpretato a basso livello, dove riusi effettivamente i parametri da un modello in un altro modello (skip-gram, continuous bag-of-words, ecc.). I requisiti del transfer learning sono da un lato specifici del problema e dall'altro specifici del modello. Le prossime due sezioni tratteranno rispettivamente un approccio ad alto livello e uno a basso livello al transfer learning. Anche se in letteratura troverai tipicamente questi concetti con nomi diversi, l'idea generale del transfer learning resta la stessa.
Nell'apprendimento multi-task, alleni un modello su compiti diversi allo stesso tempo. In genere si usano modelli di deep learning perché possono essere adattati in modo flessibile.
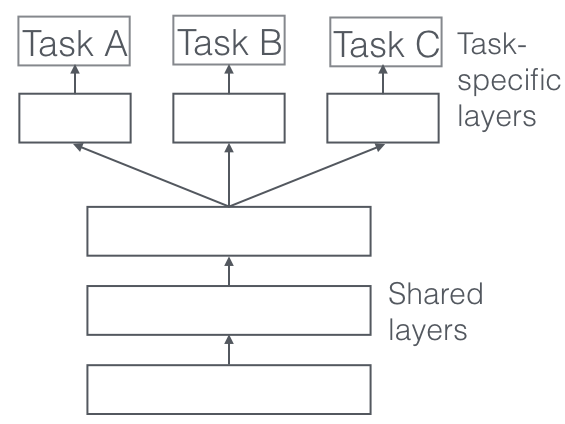
L'architettura della rete viene adattata in modo che i primi strati siano usati su compiti diversi, seguiti da strati e output specifici per ciascun compito. L'idea generale è che addestrando una rete su compiti differenti, la rete generalizzerà meglio, poiché il modello è chiamato a performare bene su compiti per i quali è richiesta una "conoscenza" o una "elaborazione" simile.
Un esempio nell'ambito del Natural Language Processing è un modello il cui obiettivo finale è eseguire il riconoscimento di entità. Invece di addestrare il modello solo sul compito di entity recognition, lo usi anche per eseguire la classificazione delle parti del discorso, la previsione della prossima parola, ... In questo modo, il modello beneficerà della struttura appresa da questi compiti e dai diversi dataset. Consiglio vivamente questo blog di Sebastian Rude e questo blog, entrambi dedicati al multi-task learning per approfondire l'argomento.
Uno dei grandi vantaggi di un modello di deep learning è che l'estrazione delle feature è "automatica". Sulla base dei dati etichettati e della backpropagation, la rete è in grado di determinare le feature utili per un compito. La rete "capisce" quale parte dell'input è importante per, ad esempio, classificare un'immagine. Ciò significa che il lavoro manuale di definizione delle feature viene astratto. Le reti di deep learning possono essere riutilizzate in altri problemi, poiché il tipo di feature estratte è spesso utile anche per altri problemi. In sostanza, in un featuriser usi i primi strati della rete per determinare le feature utili, ma non usi l'output della rete, poiché è troppo specifico del compito.
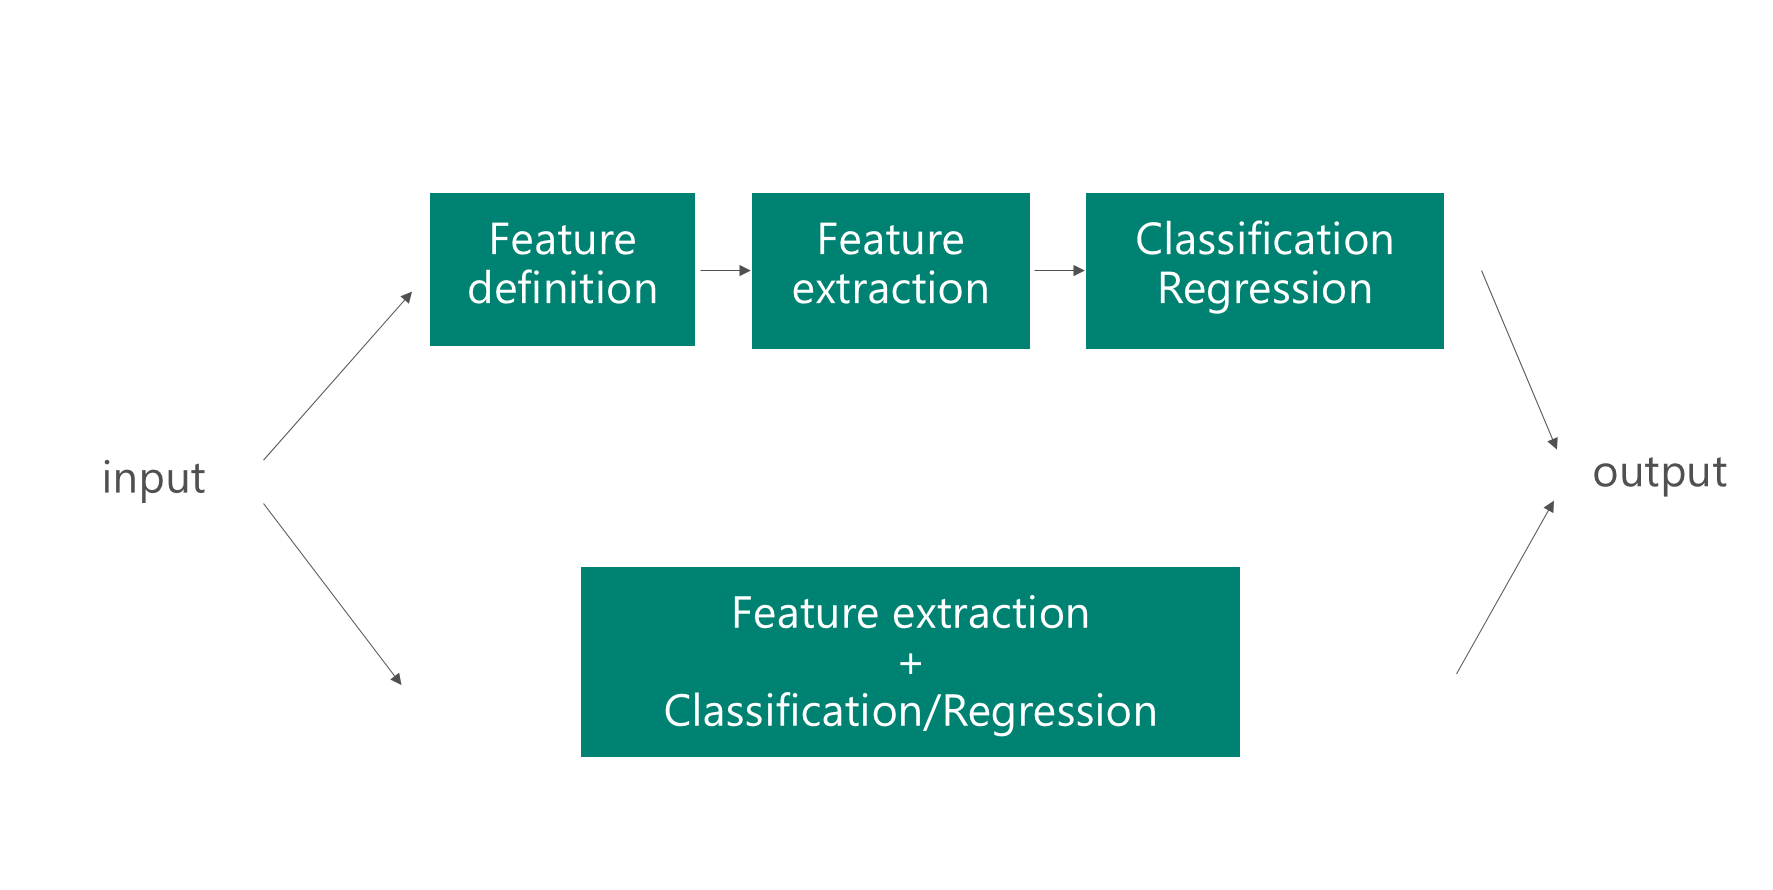
Dato che i sistemi di deep learning sono bravi nell'estrazione delle feature, come puoi riutilizzare reti esistenti per eseguire l'estrazione di feature per altri compiti? È possibile fornire un campione di dati in input alla rete e prendere come output uno degli strati intermedi della rete. Questo strato intermedio può essere interpretato come una rappresentazione a lunghezza fissa e processata dei dati grezzi. In genere, il concetto di featuriser è usato nel contesto della computer vision. Le immagini vengono quindi date in input a una rete pre-addestrata (per esempio, VGG o AlexNet) e si usa un metodo di machine learning diverso sulla nuova rappresentazione dei dati. Estrarre uno strato intermedio come rappresentazione dell'immagine riduce significativamente la dimensione dei dati originali, rendendoli più adatti alle tecniche tradizionali di machine learning (ad esempio, la regressione logistica o le SVM funzionano meglio con una rappresentazione piccola di un'immagine, come dimensione 128, rispetto all'originale, ad esempio 128x128=16384 dimensioni).
Uno dei miei post precedenti ha discusso di come molte pipeline NLP oggi utilizzino i word embedding. Questi word embedding sono un modo più informativo di rappresentare le parole rispetto alle one-hot encoding. Sono ampiamente usati ed esistono diverse varianti. In genere queste varianti differiscono per il corpus da cui provengono, come Wikipedia, articoli di news, ecc., e per le differenze nei modelli di embedding. È importante capire il background di questi modelli e dei corpora per sapere se il transfer learning con i word embedding ha senso. In genere le persone non chiamerebbero l'uso dei word embedding transfer learning, eppure non sono d'accordo, data la somiglianza con il transfer learning nella computer vision. In sostanza, usare i word embedding significa usare un featuriser o la rete di embedding per convertire le parole in vettori.
Anche se word2vec ha già 4 anni, è ancora un approccio molto influente ai word embedding. D'altro canto, approcci recenti come FastText hanno reso disponibili i word embedding in un gran numero di lingue. Gli embedding di word2vec o FastText rappresentano un passo avanti significativo rispetto agli approcci bag-of-words. Tuttavia, la loro utilità è in genere determinata dal dominio del problema.
Immagina di costruire un servizio di raccomandazione di notizie per venditori. I venditori vogliono ricevere notizie su aziende che potrebbero essere interessate al prodotto che stanno vendendo. Il vocabolario usato negli articoli di news è in genere abbastanza generico o generale, il che significa che viene usato un vocabolario spesso supportato dalla maggior parte dei word embedding (a seconda del corpus su cui sono addestrati). Inoltre, se fai raccogliere ai venditori gli articoli che leggono per un paio di settimane, avrai subito a disposizione un grande corpus etichettato. Potendo riutilizzare i word embedding è possibile che il motore di raccomandazione performi significativamente meglio.
D'altra parte, immagina di dover eseguire la classificazione degli argomenti su contratti legali. Non su un qualsiasi tipo di contratti legali, ma su contratti legali francesi nell'ambito del diritto della concorrenza. Questi tipi di dataset in genere non sono etichettati, o è disponibile solo un set limitato di documenti etichettati. La prossima sezione descriverà perché in questo caso il transfer learning pronto all'uso ti porterà solo fino a un certo punto:
Ti consiglio vivamente di leggere questo eccellente post su lo stato attuale dei word embedding. Tenere conto dei problemi e delle soluzioni menzionati in questo post è fondamentale per creare sistemi NLP e word embedding robusti quando si lavora con quantità limitate di dati.
Gensim, spacy e FastText sono tre ottimi framework che ti permettono di usare rapidamente i word embedding nella tua applicazione di machine learning. Inoltre, supportano anche l'addestramento di embedding personalizzati. Dai un'occhiata a questo tutorial su gensim, a questo su spacy o a questo tutorial su FastText per saperne di più!
Le tecniche di deep learning hanno portato a successi significativi nella computer vision. Invece di dover definire manualmente feature specifiche del problema, per esempio le feature Histogram of Oriented Gradients (HoG), istogrammi, ecc., il deep learning consente ai professionisti di addestrare modelli che prendono immagini grezze come input. La complessità originaria della definizione delle feature si è ora spostata verso la complessità della definizione della rete. Sebbene le architetture siano spesso riutilizzate, non esiste una strategia unica per comporre le architetture di rete. In genere, le tecniche di deep learning sono state inventate e applicate in contesti di ricerca su dataset enormi (come Imagenet o MS Coco). Per aumentare le prestazioni su questi grandi dataset, i ricercatori hanno ideato architetture di rete con profondità e complessità crescenti. Queste architetture danno luogo a modelli con milioni di parametri che (in genere) non sono scalabili a piccoli dataset di immagini. Addestrare un'architettura come la Residual Network (ResNet) o la VGG su un dataset con meno di 5.000 immagini porterà semplicemente a un overfitting significativo. La recente tendenza del deep learning ha portato a notevoli progressi, eppure sembra che i data scientist con dataset piccoli siano stati lasciati al freddo.
Come si è scoperto, le reti di deep learning apprendono rappresentazioni gerarchiche delle feature (vedi questo post di Distill). Ciò significa che i livelli inferiori apprendono feature di basso livello, come i bordi, mentre i livelli superiori apprendono concetti di livello più alto, ma non interpretabili, come le forme. Questa idea di rappresentazioni gerarchiche delle feature si presenta anche quando la rete è addestrata su dataset differenti, indicando che possono essere riutilizzate in domini di problema diversi.
Due approcci sono usati quando si applica il transfer learning a problemi di computer vision.
L'API di Keras ti permette di caricare reti pre-addestrate e mantenere fissi diversi strati durante l'addestramento. Nella prossima sezione discuterò di nuovo due casi d'uso, rispettivamente uno in cui il transfer learning è utile e un altro in cui non lo è.
Immagina di lavorare nella tutela della fauna selvatica e di voler classificare i diversi animali che compaiono in un feed video in diretta. Soprattutto se stai cercando di monitorare specie in via di estinzione, è possibile che tu non riesca a raccogliere molti dati etichettati. Dato che le reti pre-addestrate sono spesso addestrate su un ampio dominio di concetti (che vanno dal cibo, agli animali e agli oggetti), usare una rete pre-addestrata come featuriser o come inizializzatore è sicuramente un'opzione.
D'altra parte, immagina di dover analizzare immagini radiografiche per oncologi. Queste immagini non sono le tipiche foto di gatti e cani, poiché sono l'output di una scansione eseguita su un paziente. Queste immagini, sebbene convertite in immagini RGB, sono in genere in scala di grigi per illustrare i risultati della scansione. Sebbene una rete pre-addestrata sia in grado di rilevare forme e bordi dalle immagini RGB, molto probabilmente avrà difficoltà a rilevarli sulle immagini radiografiche, poiché queste non sono presenti nei dati di training del modello pre-addestrato. Inoltre, in scenari medici, la quantità di dati etichettati è in genere bassa. Esistono diverse tecniche per sfruttare i dati non etichettati (potenzialmente abbondanti), ma in genere richiedono più lavoro e fine-tuning. In genere, queste tecniche cercano di pre-addestrare i pesi della rete di classificazione, addestrando iterativamente ciascun livello a ricostruire le immagini (usando strati convoluzionali e deconvoluzionali). Una combinazione di queste tecniche e di reti pre-addestrate è spesso utilizzata per migliorare la convergenza.
Entrambi i metodi di computer vision menzionati sopra si basano su un'assunzione importante: i pattern estratti nel dataset originale sono utili nel contesto del nuovo dataset. Questa utilità è difficile da quantificare, eppure è un'assunzione importante da considerare. Le immagini sismiche, iperspettrali o persino mediche mostrano una somiglianza limitata con le immagini in ImageNet. Determinare quale segnale stradale contiene un'immagine, invece, si basa su pattern abbastanza simili. Comprendere il dominio del problema di computer vision è cruciale per applicarlo con successo. Conoscendo il background dei modelli (dataset, tecniche, ecc.) usati nel transfer learning, puoi evitare di sprecare tempo durante la sperimentazione e concentrarti sul fine-tuning di quei modelli che potrebbero fare la differenza.
Corsi di Machine Learning
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



