
Programma
Ingegnere dei dati in Python
40 ore
Pratica and corso your progress.
Continua Con GoogleApache Spark e Apache Flink sono due framework open source per l’elaborazione dei dati ampiamente usati per big data e analytics. Pur essendo entrambi strumenti potenti con solide capacità di elaborazione, differiscono per architettura e funzionalità chiave.
Esploreremo le caratteristiche principali di Spark e Flink, concentrandoci su modelli di elaborazione, astrazioni dei dati, gestione dello stato e prestazioni. Vedremo anche come ciascun framework gestisce l’elaborazione batch e quella in tempo reale. Capire differenze e similitudini ti aiuterà a scegliere il framework giusto per le tue esigenze.
Sappiamo tutti che il volume di dati disponibili cresce in modo esponenziale. Le organizzazioni che cercano di sfruttare i big data possono imbattersi in problemi di scalabilità ed efficienza.
I framework di elaborazione dati sono una soluzione necessaria perché supportano un’ampia gamma di operazioni sui dati, tra cui ingestion, trasformazione e archiviazione, anche quando si lavora con terabyte di dati. Offrono un vasto insieme di strumenti e API, dandoti flessibilità per svolgere attività che vanno dalle operazioni di base al machine learning. Inoltre, i framework di elaborazione forniscono un livello di astrazione della complessità che semplifica lo sviluppo e il debugging delle applicazioni di data processing.
In generale, i framework di elaborazione dati funzionano distribuendo il carico di lavoro su più nodi in un cluster. Alcuni framework sono pensati in modo specifico per il trattamento dei dati in tempo reale, permettendoti di analizzare i dati man mano che arrivano. Altri sono ottimizzati per l’elaborazione batch, utile per analisi retrospettive.
Apache Spark è un framework di calcolo distribuito open source progettato per gestire grandi volumi di dati in modo efficiente e rapido. Utilizza un modello di programmazione in memoria, il che significa che può memorizzare i dati nella memoria principale dei nodi del cluster, accelerando sensibilmente l’elaborazione rispetto ad altri strumenti che si affidano maggiormente all’accesso al disco. La sua interfaccia facile da usare ti consente di eseguire operazioni complesse sui dati tramite un set di API in vari linguaggi, come Python e R, due dei principali linguaggi per la Data Science.
Apache Spark può eseguire operazioni in modo resiliente, cioè tollera i guasti dei nodi del cluster e si ripristina automaticamente. Questa potente funzionalità è dovuta al componente Resilient Distributed Dataset (RDD), una raccolta distribuita di unità di base che contengono record di dati.
D’altra parte, il modello di esecuzione di Spark, il Directed Acyclic Graph (DAG), ti permette di ottimizzare l’esecuzione parallela dei task. Questo componente consente a Spark di distribuire i task sui diversi nodi dello stesso cluster, sfruttando tutte le risorse disponibili.
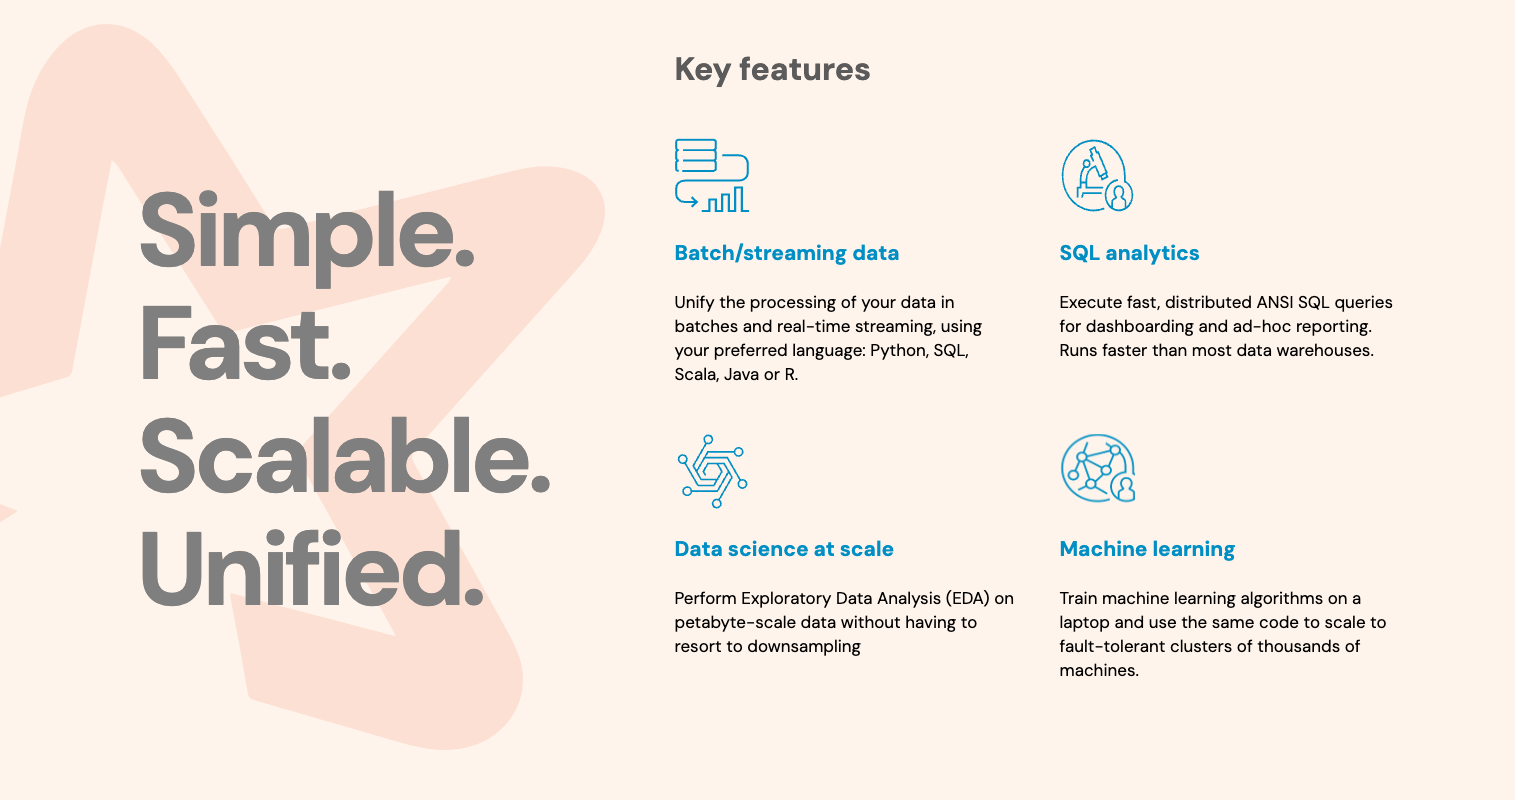 Caratteristiche principali di Apache Spark. Fonte
Apache Flink è un sistema di elaborazione dati open source che si distingue quando devi analizzare dati in tempo reale ed elaborare grandi moli di dati con bassa latenza e alte prestazioni. Con la stessa infrastruttura, Apache Flink può anche elaborare dati batch, un grande vantaggio quando devi creare ed eseguire pipeline complesse che trattano dati in tempo reale su sistemi distribuiti. Offre un set di API in vari linguaggi, tra cui Python e R, e librerie specializzate che ti aiutano a costruire pipeline di elaborazione di eventi per il machine learning.
Apache Flink tratta i tuoi dati come flussi continui di eventi, cosa utile in applicazioni in cui i dati vengono ricevuti ed elaborati costantemente. Questo modello di programmazione basato sui flussi è una caratteristica chiave che porta a una bassa latenza nella risposta agli eventi. Inoltre, con le operazioni di Apache Flink puoi costruire pipeline di elaborazione dati complesse e altamente personalizzate.
Flink gestisce in modo efficiente lo stato nelle applicazioni di elaborazione dati in tempo reale. Ciò significa che puoi mantenere e aggiornare lo stato delle tue applicazioni man mano che i dati arrivano, con tolleranza ai guasti.
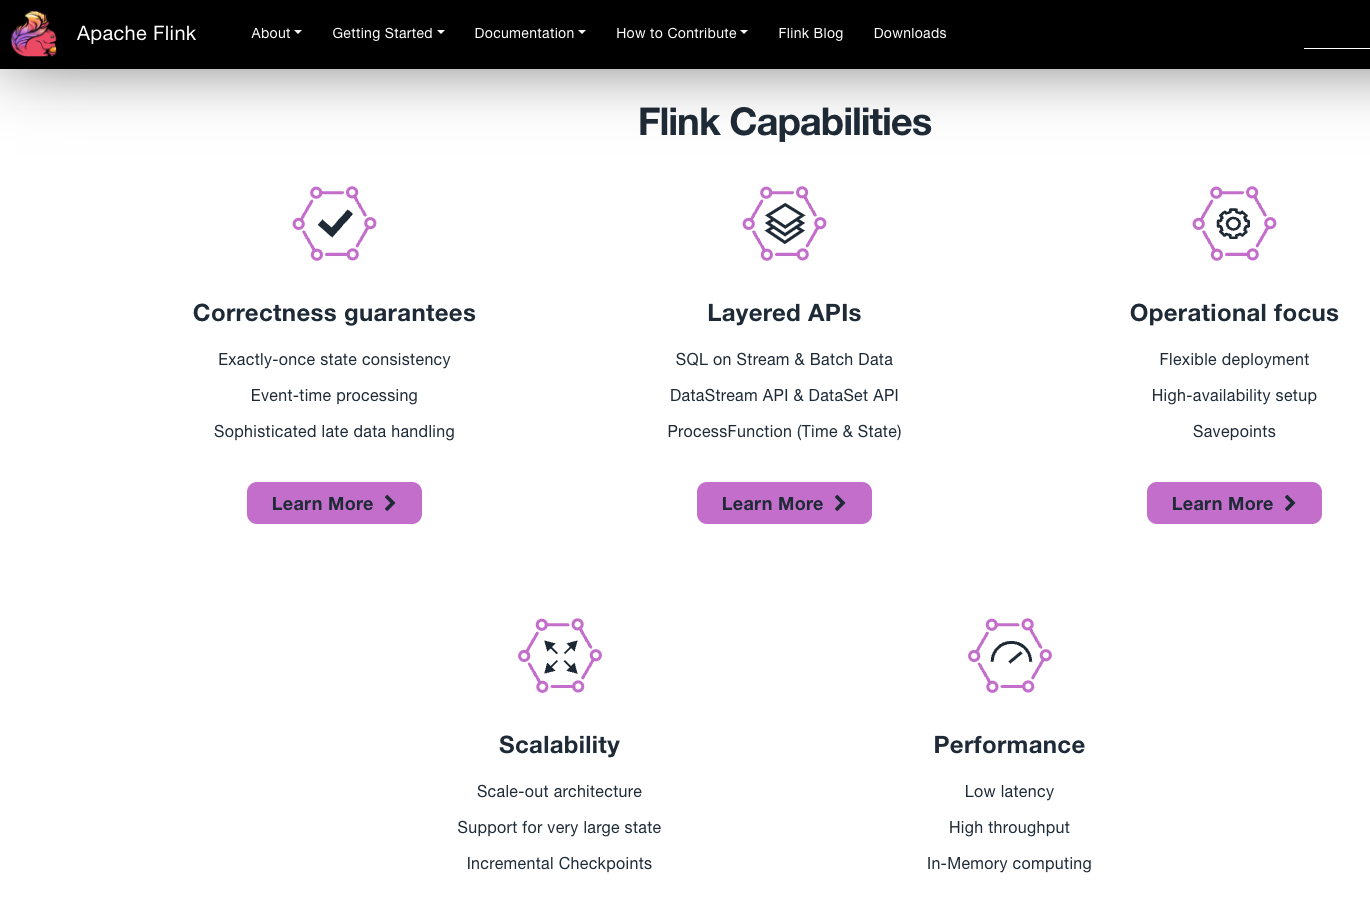 Caratteristiche principali di Flink. Fonte
Sfruttare le funzionalità di un framework di elaborazione dati adatto può aiutarti a migliorare le prestazioni e l’efficienza della tua pipeline. Tra tutte le funzionalità offerte da Spark e Flink, ci sono alcuni punti chiave da valutare quando scegli tra questi strumenti:
Anche se Spark e Flink hanno caratteristiche distintive, condividono diverse proprietà importanti. Entrambi sono progettati per gestire attività di elaborazione dati su larga scala con bassa latenza. Offrono un set di API in vari linguaggi, tra cui Python, Scala, Java e R, e sono integrati in un più ampio ecosistema di strumenti per i big data. Inoltre, Spark e Flink implementano ottimizzazioni delle prestazioni.
Vediamo ciascuna di queste somiglianze:
Apache Flink e Apache Spark sono progettati per elaborare grandi volumi di dati in un cluster di computer. Questa caratteristica ti permette di scalare orizzontalmente la tua applicazione per gestire dataset enormi allocando e deallocando dinamicamente risorse al carico di lavoro su più nodi con bassa latenza. Entrambi i framework possono gestire sia elaborazione batch sia streaming.
Sia Spark sia Flink forniscono API e astrazioni di alto livello implementate in vari linguaggi, tra cui Scala, Python e Java, che ti permettono di scrivere ed eseguire pipeline nel linguaggio che preferisci. Queste API rendono i framework facili da usare nello sviluppo di applicazioni di data processing. Inoltre, Flink include librerie per il machine learning (FlinkML), l’elaborazione di eventi complessi (FlinkCEP) e l’elaborazione di grafi (Gelly). Spark offre anch’esso librerie per il machine learning (MLlib), l’elaborazione di grafi (GraphX) e l’elaborazione di dati in tempo reale (GraphX).
Apache Spark così come Apache Flink sono integrati con un ecosistema esaustivo di strumenti per i big data, che include Hadoop Distributed File System, Apache Kafka e sistemi di storage cloud come Amazon S3.
Entrambi i framework implementano ottimizzazioni delle prestazioni che massimizzano l’efficienza dell’elaborazione dei dati. Questa caratteristica ti permette di eseguire compiti complessi sfruttando l’esecuzione parallela, la pianificazione dei task e l’ottimizzazione delle query di Spark e Flink. Spark impiega l’ottimizzatore Catalyst mentre Flink usa un ottimizzatore basato sui costi per l’elaborazione batch.
Apache Spark e Apache Flink condividono molte somiglianze per quanto riguarda le capacità di base e gli approcci all’elaborazione dei dati. Tuttavia, presentano anche differenze significative per quanto riguarda i loro punti di forza e le aree di focus dei modelli di elaborazione, la maturità dei rispettivi ecosistemi e del supporto linguistico, e l’approccio all’ottimizzazione e alla gestione dello stato.
Apache Flink è focalizzato principalmente sull’elaborazione dei dati in tempo reale. Poiché questo framework è costruito sopra un runtime di streaming, può gestire anche l’elaborazione batch. Dall’altro lato, Apache Spark è stato originariamente progettato per il batch processing, risultando più adatto ad analisi retrospettive di grandi dataset. Implementando un approccio a micro-batch, Spark può elaborare anche dati in streaming ma con latenze generalmente più alte rispetto a Flink.
Come accennato, entrambi i framework forniscono API in più linguaggi di programmazione. Tuttavia, il supporto di Flink per Python è meno maturo, il che può rappresentare una limitazione se lavori con un team a forte componente data scientist.
Sebbene entrambi i framework abbiano una buona integrazione con gli strumenti per i big data, Apache Spark dispone di un ecosistema più ampio e maturo, con una varietà di connettori, librerie e tool disponibili. Apache Flink sta ampliando il set di strumenti ed estensioni disponibili, ma può ancora essere considerato un ecosistema meno maturo.
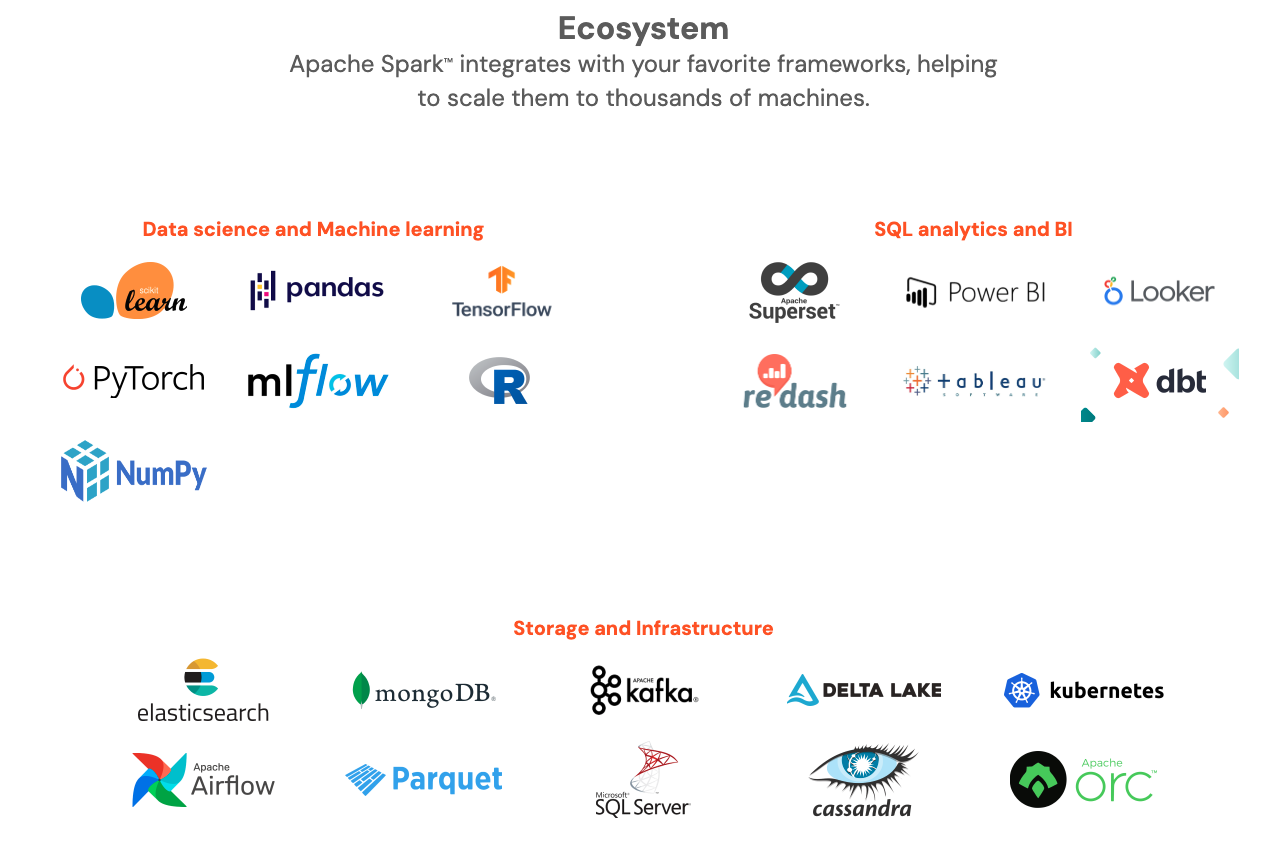
Ecosistema di Apache Spark. Fonte
Apache Flink ti consente di lavorare con una gestione dello stato più avanzata e flessibile, il che può rappresentare un vantaggio se stai lavorando con pipeline che devono mantenere e aggiornare lo stato in tempo reale, come elaborazioni su event-time e processing-time windows o finestre per gestire pattern di eventi complessi. Spark consente funzionalità di windowing di base che funzionano bene quando sono richieste elaborazione batch e micro-batching.
Apache Flink e Apache Spark mostrano molte somiglianze ma differiscono in modo sostanziale per approccio di elaborazione e relativa latenza, prestazioni e gestione dello stato. Hanno anche una maturità dell’ecosistema e un supporto dei linguaggi leggermente diversi. La scelta del framework dipenderà principalmente dai requisiti specifici del tuo progetto. Tuttavia, ci sono aree in cui Spark o Flink eccellono rispetto all’altro:
Spark è stato originariamente progettato per l’elaborazione batch, ma ora supporta i dati in streaming tramite il modulo Spark Streaming. Flink, invece, è stato sviluppato specificamente per i dati in streaming, ma ora supporta anche l’elaborazione batch.
Spark utilizza Resilient Distributed Datasets e tecniche di partizionamento dei dati per aumentare l’elaborazione parallela e ottimizzare l’uso delle risorse. Flink sfrutta operator chaining ed esecuzione a pipeline, migliorando l’elaborazione parallela e l’efficienza nella gestione delle risorse. In generale, Flink è considerato più veloce e offre prestazioni migliori nelle applicazioni di elaborazione in tempo reale.
Spark offre funzionalità di windowing di base principalmente adatte a implementazioni basate sul tempo, ideali per finestre temporali fisse o scorrevoli sia per l’elaborazione batch sia per lo streaming. Flink vanta funzionalità di windowing più avanzate, tra cui finestre basate su event-time e processing-time, session windows e funzioni di finestra personalizzate. Le capacità di windowing di Flink sono notevolmente più versatili ed efficienti, rendendolo la scelta preferita per esigenze complesse.
Spark utilizza l’ottimizzatore Catalyst, eccellente nell’ottimizzare trasformazioni dei dati e query di elaborazione, e integra il motore di esecuzione Tungsten per migliorare le prestazioni del framework. Flink dispone di un ottimizzatore basato sui costi progettato specificamente per i task di batch processing, che valuta risorse disponibili e caratteristiche dei dati per scegliere l’approccio più efficiente. Inoltre, l’esecuzione basata su pipeline e lo scheduling a bassa latenza di Flink migliorano sensibilmente le velocità di elaborazione. La scelta tra Spark e Flink per l’ottimizzazione dipende dai casi d’uso specifici, poiché entrambi offrono vantaggi distinti.
Spark raggiunge la tolleranza ai guasti tramite i Resilient Distributed Datasets (RDD), strutture di dati immutabili e partizionate che consentono una ricostruzione rapida in caso di errori. Flink, invece, utilizza un approccio basato su snapshot distribuiti, catturando lo stato dell’applicazione in checkpoint specifici, il che facilita un recupero rapido dai guasti con un impatto minimo sulle prestazioni. Sebbene entrambi i framework forniscano un’efficace tolleranza ai guasti, il metodo di Flink in genere comporta tempi di recupero più rapidi e minori interruzioni dei processi in corso, rendendolo preferibile negli scenari in cui minimizzare i tempi di fermo è critico.
Spark supporta una gamma di linguaggi di programmazione tra cui Scala, Java, Python e R, risultando molto attraente sia per sviluppatori sia per data scientist grazie all’ampio potenziale collaborativo e a un set completo di API per questi linguaggi. Flink, pur supportando Java, Scala e Python con API intuitive e facili da usare, offre capacità Python più limitate, il che può ostacolarne l’adozione tra i team di data science. Il superiore supporto Python di Spark lo rende più appetibile per i team data-centric dove Python è predominante.
Spark vanta un ecosistema completo e maturo, che si integra senza problemi con un’ampia gamma di strumenti big data come Hadoop, Hive e Pig, tra gli altri. Questa estesa compatibilità rende Spark una scelta solida per ambienti dati complessi che richiedono set di strumenti diversificati. Flink ha un insieme di integrazioni più limitato con altri strumenti big data, sebbene eccella nell’integrazione con Apache Kafka. Grazie a integrazioni più complete e mature, Spark in genere presenta un ecosistema più forte.
Di seguito trovi una tabella che riassume le principali differenze tra Spark e Flink:
| Categorie | Spark | Flink | Vincitore |
|---|---|---|---|
| Elaborazione dei dati | Modello orientato al batch | Modello orientato al real-time | Dipende |
| Prestazioni | RDD e partizionamento dei dati | Operator chaining ed esecuzione a pipeline | Flink |
| Windowing | Funzionalità basate sul tempo | Event-time, session e funzioni personalizzate | Flink |
| Ottimizzazione | Ottimizzatore Catalyst | Ottimizzatore basato sui costi | Dipende |
| Tolleranza ai guasti | Ottenuta tramite RDD | Snapshot distribuiti | Flink |
| Supporto linguaggi e API | Supporto completo | Diversi linguaggi, Python non avanzato | Spark |
| Ecosistema | Integrazione completa con strumenti big data | Integrazione con alcuni strumenti, eccelle con Kafka | Spark |
Scegliere il framework di elaborazione dati più adatto può migliorare le prestazioni della tua pipeline. Tra tutti i framework, Apache Spark e Apache Flink si distinguono come strumenti potenti e versatili, ciascuno con i propri punti di forza e capacità.
Spark è eccellente per l’elaborazione batch, offrendo una varietà di strumenti, API e un’integrazione completa con altre tecnologie big data. Se vuoi imparare a usare Spark da Python, dai un’occhiata al nostro corso Introduction to PySpark e al tutorial Getting Started with Pyspark. Flink si distingue per l’elaborazione in tempo reale e lo streaming perché offre una gestione efficiente dello stato, funzionalità di windowing e prestazioni a bassa latenza.
In definitiva, la scelta tra questi due framework dipenderà dai requisiti e dalle necessità specifiche del tuo progetto. Per comprenderli a fondo, la cosa migliore è continuare a leggere e fare pratica usando le risorse seguenti.
Impara con DataCamp
Programma
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



