Bigdatatechnologieën zijn essentieel nu de omvang en complexiteit van de data die bedrijven produceren elke dag toeneemt. Traditionele tools zijn niet toereikend om big data te verwerken; deze technologieën maken juist efficiënte gegevensverwerking mogelijk en helpen om inzichten te halen die leiden tot beter onderbouwde beslissingen. Bijblijven met de nieuwste tools en trends is cruciaal als je je carrière in dit domein wilt starten of versnellen.
Wat is bigdatatechnologie?
Bigdatatechnologie verwijst naar de tools en frameworks die complexe en grote datasets verwerken, opslaan en analyseren.
Volgens Gartner is de definitie van big data: “Informatie-assets met een hoog volume, hoge snelheid en grote variëteit die kosteneffectieve, innovatieve vormen van informatieverwerking vereisen voor betere inzichten en besluitvorming.”
Kenmerken van big data. Bron afbeelding: auteur
- Volume: De groei in datavolume is enorm geweest. Elke seconde wordt er een enorme hoeveelheid data gegenereerd uit sociale media, sensoren, financiële transacties en meer. Het beheren van dit volume vraagt om geavanceerde opslagsystemen en schaalbare verwerkingskracht om bij te blijven.
- Variëteit: Data komt in allerlei vormen. Het kan gestructureerd zijn, zoals netjes georganiseerde gegevens in spreadsheets en databases. Of ongestructureerd, zoals tekst, afbeeldingen, video’s en socialmediaberichten die niet in een eenvoudig formaat passen. Daarnaast is er semigestructureerde data, zoals JSON- en XML-bestanden, die er tussenin valt. Elk type data vereist een andere aanpak om te analyseren en te begrijpen.
- Vervolgens is er snelheid (velocity), wat verwijst naar de snelheid waarmee data wordt gegenereerd en verwerkt moet worden. Met IoT-apparaten en realtime stromen van sociale media en financiële transacties is het vermogen om deze data snel te verzamelen, verwerken en analyseren cruciaal geworden voor tijdige beslissingen.
- Waarheidsgetrouwheid (veracity): Zorgen dat data accuraat en betrouwbaar is, is cruciaal, omdat slechte data kan leiden tot verkeerde beslissingen en zelfs schade aan een bedrijf. Tegelijkertijd kan te veel streven naar perfectie dingen vertragen, wat besluitvorming vertraagt. Er moet dus een goede balans worden gevonden die past bij de zakelijke behoeften.
Bigdatatechnologieën stellen organisaties in staat om gestructureerde en ongestructureerde data efficiënt te verwerken en daar betekenisvolle inzichten uit te halen. Omdat data een strategisch bezit is, zijn bigdatatechnologieën essentieel geworden om een duurzaam concurrentievoordeel te behouden in sectoren als gezondheidszorg, financiën en retail. Big data is niet langer slechts een technische vereiste; het is uitgegroeid tot een zakelijke noodzaak.
Typen bigdatatechnologieën
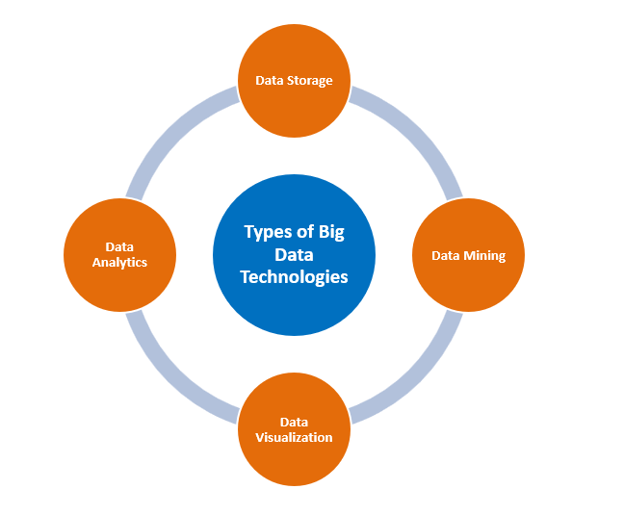
Typen bigdatatechnologieën. Bron afbeelding: auteur
Gegevensopslag
Apache Hadoop
Hadoop is een open-sourceframework dat schaalbare opslag biedt door data te distribueren over clusters van machines. Het is ontworpen om op te schalen van één server naar duizenden machines en is daarmee een fundamenteel en krachtig framework in bigdatainfrastructuren. Hadoop is ook kosteneffectief, wat het aantrekkelijk maakt voor organisaties die enorme hoeveelheden data willen beheren tegen lagere kosten dan met traditionele databases.
Hadoop heeft twee hoofdcomponenten:
- HDFS: een schaalbaar opslagsysteem dat data in kleinere blokken opdeelt en verspreidt over meerdere servers. Dit betekent dat de data veilig blijft, zelfs als sommige servers uitvallen.
- MapReduce is een programmeermodel dat grote taken opsplitst in kleinere stukken die gelijktijdig verwerkt kunnen worden, waardoor het proces versnelt.
Apache Spark
Apache Spark is een ander krachtig hulpmiddel voor big data. In tegenstelling tot Hadoop’s MapReduce verwerkt Spark data in het geheugen, waardoor het veel sneller en efficiënter is. Het kan bovendien verschillende taken aan, waaronder batchverwerking, realtime data, machine learning en grafanalyse, waardoor het een veelzijdige keuze is voor uiteenlopende bigdatabehoeften.
Sparks resilient distributed datasets (RDD’s) stellen het in staat data in het geheugen op te slaan en snel te verwerken, met behoud van fouttolerantie. Spark kan ook samenwerken met Hadoops HDFS voor opslag, terwijl het profiteert van zijn snelle verwerkingsmogelijkheden.
MongoDB
MongoDB is een NoSQL-database die is ontworpen voor ongestructureerde data. De flexibiliteit om uiteenlopende datatypen te verwerken maakt het ideaal voor snelgroeiende dataomgevingen en dynamische applicaties. Doordat MongoDB horizontaal kan schalen, is het bijzonder nuttig in scenario’s waar relationele databases tekortschieten, zoals socialmediaplatforms en realtime analytics. Het wordt vaak gebruikt voor realtime data-analyse, contentmanagementsystemen en Internet of Things (IoT)-applicaties, waar flexibiliteit en snelheid belangrijk zijn.
Datamining
RapidMiner
Altair’s RapidMiner is een data-analyse- en AI-platform dat de volledige datascience-levenscyclus ondersteunt, waarmee je grote datasets kunt minen en met gemak voorspellende modellen kunt bouwen.
Het open-sourcekarakter en de integratie met machinelearningbibliotheken geven het een voorsprong voor wie snel wil prototypen en in productie wil gaan.
Het uniforme platform is ontworpen voor verschillende vaardigheidsniveaus – van data scientists en -engineers tot businessanalisten en executives – om dat allemaal in één omgeving te doen.
Je kunt RapidMiner ook integreren met meerdere machinelearningbibliotheken zoals TensorFlow, Weka en H2O, zodat je snel met verschillende algoritmen en benaderingen kunt experimenteren.
Presto
Presto noemt zichzelf een “snelle en betrouwbare SQL-query-engine voor data-analyse en de open lakehouse”.
De engine biedt één eenvoudige ANSI SQL-interface, waarmee je grote datasets uit meerdere bronnen kunt bevragen. Het biedt ook realtime analytics. Presto is efficiënt voor bedrijven die interactieve analyses op gedistribueerde data nodig hebben. Doordat Presto datalakes kan bevragen zonder datatransformatie, is het favoriet bij data-engineers die flexibiliteit en prestaties zoeken.
Data-analyse
Apache Spark
Big data analytics is waarschijnlijk een van de eerste termen waar mensen aan denken bij Apache Spark. Dat komt doordat Spark uitblinkt in grootschalige gegevensverwerking met zijn in-memory architectuur, waardoor realtime analytics en snellere dataverwerking mogelijk zijn.
Als het gaat om het benutten van batch- en streamingdata, is Spark daar uitstekend voor toegerust. Daarom wordt het vaak ingezet voor machine learning, realtime verwerking en zelfs bij grafanalyse.
De belangrijkste eigenschap hierbij is de iteratieve berekening van Spark, wat zorgt voor brede toepassing bij machinelearningproblemen waarbij meerdere rondes van rekenintensieve stappen nodig zijn.
Daarnaast maakt API-ondersteuning voor Python, Java, Scala en andere programmeertalen het gemakkelijk om binnen en tussen teams te werken in organisaties.
Splunk
Met realtime data-analyse en AI-mogelijkheden stelt Splunk bedrijven in staat machinegegenereerde data te monitoren, afwijkingen op te sporen en sneller datagedreven beslissingen te nemen.
Splunk is een waardevol hulpmiddel voor organisaties die afhankelijk zijn van onmiddellijke operationele inzichten. Het verzamelt en verwerkt allerlei machine-gegenereerde data, waaronder logs, metrics en events, die helpen te begrijpen wat er gebeurt binnen de IT-systemen van een organisatie.
Splunk heeft ook een krachtige rapportagefunctie waarmee eindgebruikers complexe dashboards met meerdere pagina’s kunnen bouwen die gemakkelijk te interpreteren en prettig om te zien zijn.
Datavisualisatie
Tableau
De website van Tableau definieert het als “een platform voor visuele analytics dat de manier waarop we data gebruiken om problemen op te lossen transformeert — en mensen en organisaties in staat stelt het maximale uit hun data te halen.”
Als leider in business intelligence biedt het gebruikers een krachtige, intuïtieve interface om dynamische visualisaties te maken die diepgaande inzichten geven. Doordat het data uit verschillende bronnen kan integreren, sluit het goed aan op de behoeften van zakelijke gebruikers.
De kracht zit in de veelzijdigheid: van high-level executive dashboards tot gedetailleerde, door te klikken rapporten voor data-analisten.
Power BI
Volgens Microsoft is “Power BI een verzameling softwareservices, apps en connectors die samenwerken om je losse databronnen om te zetten in samenhangende, visueel rijke en interactieve inzichten.”
Power BI integreert naadloos met andere tools, vooral die van Microsoft, en maakt het mogelijk om uitgebreide, interactieve rapporten te bouwen. Teams kunnen door de cloudservice in realtime samenwerken.
Toepassingen van bigdatatechnologieën
Gezondheidszorg
Big data verandert de zorgsector via tal van toepassingsgebieden:
Een van de belangrijkste toepassingen is predictive analytics, waarbij variabelen zoals patiëntgeschiedenis, genetica, bloeddruk en andere lifestylegegevens worden geanalyseerd om de kans op ziekten te voorspellen. Dit maakt vroege interventie en gepersonaliseerde behandelingen mogelijk, wat helpt om aandoeningen effectiever te voorkomen of te managen en tegelijkertijd de zorgkosten te verlagen.
Preventieve patiëntmonitoring is een ander gebied waarin big data uitblinkt. Realtime gezondheidsdata wordt verzameld via wearables, wat vroege detectie van afwijkingen en tijdige interventie mogelijk maakt. Dit is vooral nuttig bij het managen van chronische aandoeningen en het voorkomen van heropnames in het ziekenhuis.
In medisch onderzoek versnelt big data de ontdekking van nieuwe medicijnen en behandelingen door enorme datasets uit klinische proeven, genomische studies en patiëntendossiers te analyseren. Dit gebeurt via betere identificatie, testen en evaluatie van de effectiviteit van geneesmiddelen, wat tot snellere doorbraken leidt.
Tot slot kunnen lineaire en niet-lineaire optimalisatietechnieken, gefaciliteerd door bigdatatechnologieën, worden ingezet om roosters te optimaliseren, wachttijden te verkorten en de algehele zorgverlening te verbeteren.
Financiën
Financiële instellingen gebruiken big data voor veel usecases, zoals:
- Kwantiatieve handel maakt gebruik van algoritmen om realtime marktdata, historische prijzen en trends te analyseren en sneller dan ooit transacties uit te voeren. Dit vereist het verwerken van grote hoeveelheden realtime data, een gebied dat bigdatacapaciteiten vraagt.
- Fraudedetectie is veruit de bekendste toepassing. Bigdata-analyse kan patronen en afwijkingen in realtime opsporen en verdachte transacties markeren voor nader onderzoek. Dit helpt financiële instellingen fraude te voorkomen, klanten te beschermen en financiële verliezen te beperken.
- Ongesuperviseerde machinelearningtechnieken kunnen op big data worden toegepast voor klantanalyse, wat strategische beslissingen mogelijk maakt over gerichte marketing, beleggingsaanbevelingen en gepersonaliseerde financiële planning.
- Tot slot verhoogt big data de operationele efficiëntie door knelpunten te identificeren en processen te automatiseren. Van voorspellend onderhoud tot procesoptimalisatie: financiële instellingen kunnen kosten verlagen, de productiviteit verbeteren en betere diensten leveren.
Retail
Retailers zetten big data in voor verschillende toepassingsgebieden, zoals:
- Big data helpt retailers bij het optimaliseren van supply chain- en voorraadbeheer door historische verkoopdata, vraag en leveranciersprestaties te analyseren. Dit zorgt er enerzijds voor dat producttekorten worden voorkomen, en anderzijds dat voorraadkosten niet oplopen.
- Locatie-analyse is een ander gebied waarin big data een onderscheidende rol speelt. Door geografische en demografische data te benutten en te analyseren, kunnen retailketens analytisch onderbouwde beslissingen nemen over winkellocaties, winkelformules en strategie.
- Big data transformeert ook het retail-landschap door enorme hoeveelheden klantdata om te zetten in actiegerichte inzichten. Het analyseren van klantgedrag, zoals aankoopgeschiedenis en browsepatronen, stelt retailers in staat om gepersonaliseerde productaanbevelingen te doen. Dit verbetert de winkelervaring en verhoogt omzet en klantloyaliteit.
Opkomende trends in bigdatatechnologieën
Edge computing
Volgens de definitie van IBM is “edge computing een gedistribueerd computingsframework dat bedrijfsapplicaties dichter bij databronnen brengt, zoals IoT-apparaten of lokale edge-servers. Deze nabijheid tot data bij de bron kan sterke zakelijke voordelen opleveren, waaronder snellere inzichten, betere reactietijden en betere bandbreedtebeschikbaarheid”.
De nabijheid tot data maakt verwerking dichter bij de bron mogelijk, wat de latentie vermindert en de snelheid van besluitvorming verbetert. Dit is cruciaal in IoT-toepassingen waar realtime verwerking essentieel is. Omdat je data niet naar centrale locaties hoeft te verplaatsen, kan edge computing ook het bandbreedtegebruik en de responstijden verlagen. Dit betekent snellere en nauwkeurigere datagedreven besluitvorming.
AI-integratie
Volgens de definitie van RST is “AI-integratie het naadloos verweven van mogelijkheden van kunstmatige intelligentie rechtstreeks in producten en systemen. In plaats van dat AI als een externe tool opereert, wordt het analytische vermogen ingebed om alle facetten van prestaties te verbeteren.”
Het integreren van kunstmatige intelligentie (AI) met big data heeft de manier waarop bedrijven data analyseren en erop handelen veranderd. AI-algoritmen, met name machinelearningmodellen, stellen systemen in staat patronen te detecteren, voorspellingen te doen en besluitvormingsprocessen te automatiseren.
In de maakindustrie helpt AI-integratie bijvoorbeeld bij voorspellend onderhoud, waardoor bedrijven kunnen identificeren wanneer apparatuur waarschijnlijk uitvalt en preventieve maatregelen kunnen nemen. Dit vermindert stilstand en operationele kosten. Evenzo kan AI-gedreven anomaliedetectie ongewone transacties in de financiële sector identificeren en zo fraude in realtime helpen voorkomen.
Hybride cloudomgevingen
Volgens Microsoft is “een hybride cloud — soms cloudhybride genoemd — een computeromgeving die een on-premises datacenter combineert met een publieke cloud, waardoor data en applicaties tussen beide gedeeld kunnen worden.”
Een hybride cloudarchitectuur combineert het beste van de schaalbaarheid van de publieke cloud en de veiligheid van on-premises. Het biedt de flexibiliteit om gevoelige data veilig intern op te slaan, terwijl je de cloud gebruikt voor grotere, minder gevoelige taken. Hybride cloudomgevingen bieden ook kostenefficiëntie doordat bedrijven hun infrastructuur kunnen opschalen of juist verkleinen afhankelijk van hun behoeften.
Uitdagingen bij het implementeren van bigdatatechnologieën
Er zijn verschillende voordelen aan het implementeren van bigdatatechnologieën, maar ze brengen ook hun eigen uitdagingen met zich mee. Enkele overwegingen staan hieronder:
- Dataintegratie: Het integreren van data uit verschillende bronnen – gestructureerd, ongestructureerd, semigestructureerd – brengt uitdagingen met zich mee om consistentie en nauwkeurigheid te waarborgen.
- Schaalbaarheid: Naarmate datavolumes groeien, moet de infrastructuur efficiënt kunnen schalen zonder prestatiedaling.
- Beveiligingszorgen: Het beveiligen van gevoelige data binnen bigdata-ecosystemen vereist robuuste versleuteling, toegangsbeheer en naleving van regelgeving. Met regels zoals de AVG en CCPA staan organisaties wereldwijd onder toenemende druk om beveiligingspraktijken te implementeren en tegelijkertijd de privacy van gebruikers te waarborgen.
- Hoge kosten: Het implementeren en onderhouden van een bigdatainfrastructuur vereist aanzienlijke investeringen in zowel technologie als talent.
- Datakwaliteit en governance: Doordat data uit meerdere bronnen wordt verzameld, is het een uitdaging om de nauwkeurigheid, consistentie en betrouwbaarheid te waarborgen. Ook kan een gebrek aan governance leiden tot complianceproblemen en bedrijfsrisico’s.
Conclusie
Bigdatatechnologieën zijn een strategische vereiste voor organisaties om concurrentievoordeel te behalen door actiegerichte inzichten uit enorme datasets te halen. Van opslag tot analytics en visualisatie: deze tools vormen de pijlers waarop moderne datagedreven besluitvorming rust. Op de hoogte blijven van opkomende trends zoals AI-integratie, edge computing en hybride cloudarchitecturen stelt bedrijven in staat om efficiënt te schalen en te innoveren in datamanagement. Het beheersen van deze technologieën stelt organisaties in staat om ruwe data om te zetten in waardevolle assets en zo concurrentievoordeel te behalen in een datagedreven economie. Het is echter belangrijk de kosten en andere uitdagingen te begrijpen voordat je implementatiebeslissingen neemt.
Voor verdere verdieping kun je de volgende bronnen bekijken:




Bigdatatechnologieën zijn essentieel nu de omvang en complexiteit van de data die bedrijven produceren elke dag toeneemt. Traditionele tools zijn niet toereikend om big data te verwerken; deze technologieën maken juist efficiënte gegevensverwerking mogelijk en helpen om inzichten te halen die leiden tot beter onderbouwde beslissingen. Bijblijven met de nieuwste tools en trends is cruciaal als je je carrière in dit domein wilt starten of versnellen.
Wat is bigdatatechnologie?
Bigdatatechnologie verwijst naar de tools en frameworks die complexe en grote datasets verwerken, opslaan en analyseren.
Volgens Gartner is de definitie van big data: “Informatie-assets met een hoog volume, hoge snelheid en grote variëteit die kosteneffectieve, innovatieve vormen van informatieverwerking vereisen voor betere inzichten en besluitvorming.”
Kenmerken van big data. Bron afbeelding: auteur
Bigdatatechnologieën stellen organisaties in staat om gestructureerde en ongestructureerde data efficiënt te verwerken en daar betekenisvolle inzichten uit te halen. Omdat data een strategisch bezit is, zijn bigdatatechnologieën essentieel geworden om een duurzaam concurrentievoordeel te behouden in sectoren als gezondheidszorg, financiën en retail. Big data is niet langer slechts een technische vereiste; het is uitgegroeid tot een zakelijke noodzaak.
Typen bigdatatechnologieën
Typen bigdatatechnologieën. Bron afbeelding: auteur
Gegevensopslag
Apache Hadoop
Hadoop is een open-sourceframework dat schaalbare opslag biedt door data te distribueren over clusters van machines. Het is ontworpen om op te schalen van één server naar duizenden machines en is daarmee een fundamenteel en krachtig framework in bigdatainfrastructuren. Hadoop is ook kosteneffectief, wat het aantrekkelijk maakt voor organisaties die enorme hoeveelheden data willen beheren tegen lagere kosten dan met traditionele databases.
Hadoop heeft twee hoofdcomponenten:
Apache Spark
Apache Spark is een ander krachtig hulpmiddel voor big data. In tegenstelling tot Hadoop’s MapReduce verwerkt Spark data in het geheugen, waardoor het veel sneller en efficiënter is. Het kan bovendien verschillende taken aan, waaronder batchverwerking, realtime data, machine learning en grafanalyse, waardoor het een veelzijdige keuze is voor uiteenlopende bigdatabehoeften.
Sparks resilient distributed datasets (RDD’s) stellen het in staat data in het geheugen op te slaan en snel te verwerken, met behoud van fouttolerantie. Spark kan ook samenwerken met Hadoops HDFS voor opslag, terwijl het profiteert van zijn snelle verwerkingsmogelijkheden.
MongoDB
MongoDB is een NoSQL-database die is ontworpen voor ongestructureerde data. De flexibiliteit om uiteenlopende datatypen te verwerken maakt het ideaal voor snelgroeiende dataomgevingen en dynamische applicaties. Doordat MongoDB horizontaal kan schalen, is het bijzonder nuttig in scenario’s waar relationele databases tekortschieten, zoals socialmediaplatforms en realtime analytics. Het wordt vaak gebruikt voor realtime data-analyse, contentmanagementsystemen en Internet of Things (IoT)-applicaties, waar flexibiliteit en snelheid belangrijk zijn.
Datamining
RapidMiner
Altair’s RapidMiner is een data-analyse- en AI-platform dat de volledige datascience-levenscyclus ondersteunt, waarmee je grote datasets kunt minen en met gemak voorspellende modellen kunt bouwen.
Het open-sourcekarakter en de integratie met machinelearningbibliotheken geven het een voorsprong voor wie snel wil prototypen en in productie wil gaan.
Het uniforme platform is ontworpen voor verschillende vaardigheidsniveaus – van data scientists en -engineers tot businessanalisten en executives – om dat allemaal in één omgeving te doen.
Je kunt RapidMiner ook integreren met meerdere machinelearningbibliotheken zoals TensorFlow, Weka en H2O, zodat je snel met verschillende algoritmen en benaderingen kunt experimenteren.
Presto
Presto noemt zichzelf een “snelle en betrouwbare SQL-query-engine voor data-analyse en de open lakehouse”.
De engine biedt één eenvoudige ANSI SQL-interface, waarmee je grote datasets uit meerdere bronnen kunt bevragen. Het biedt ook realtime analytics. Presto is efficiënt voor bedrijven die interactieve analyses op gedistribueerde data nodig hebben. Doordat Presto datalakes kan bevragen zonder datatransformatie, is het favoriet bij data-engineers die flexibiliteit en prestaties zoeken.
Data-analyse
Apache Spark
Big data analytics is waarschijnlijk een van de eerste termen waar mensen aan denken bij Apache Spark. Dat komt doordat Spark uitblinkt in grootschalige gegevensverwerking met zijn in-memory architectuur, waardoor realtime analytics en snellere dataverwerking mogelijk zijn.
Als het gaat om het benutten van batch- en streamingdata, is Spark daar uitstekend voor toegerust. Daarom wordt het vaak ingezet voor machine learning, realtime verwerking en zelfs bij grafanalyse.
De belangrijkste eigenschap hierbij is de iteratieve berekening van Spark, wat zorgt voor brede toepassing bij machinelearningproblemen waarbij meerdere rondes van rekenintensieve stappen nodig zijn.
Daarnaast maakt API-ondersteuning voor Python, Java, Scala en andere programmeertalen het gemakkelijk om binnen en tussen teams te werken in organisaties.
Splunk
Met realtime data-analyse en AI-mogelijkheden stelt Splunk bedrijven in staat machinegegenereerde data te monitoren, afwijkingen op te sporen en sneller datagedreven beslissingen te nemen.
Splunk is een waardevol hulpmiddel voor organisaties die afhankelijk zijn van onmiddellijke operationele inzichten. Het verzamelt en verwerkt allerlei machine-gegenereerde data, waaronder logs, metrics en events, die helpen te begrijpen wat er gebeurt binnen de IT-systemen van een organisatie.
Splunk heeft ook een krachtige rapportagefunctie waarmee eindgebruikers complexe dashboards met meerdere pagina’s kunnen bouwen die gemakkelijk te interpreteren en prettig om te zien zijn.
Datavisualisatie
Tableau
De website van Tableau definieert het als “een platform voor visuele analytics dat de manier waarop we data gebruiken om problemen op te lossen transformeert — en mensen en organisaties in staat stelt het maximale uit hun data te halen.”
Als leider in business intelligence biedt het gebruikers een krachtige, intuïtieve interface om dynamische visualisaties te maken die diepgaande inzichten geven. Doordat het data uit verschillende bronnen kan integreren, sluit het goed aan op de behoeften van zakelijke gebruikers.
De kracht zit in de veelzijdigheid: van high-level executive dashboards tot gedetailleerde, door te klikken rapporten voor data-analisten.
Power BI
Volgens Microsoft is “Power BI een verzameling softwareservices, apps en connectors die samenwerken om je losse databronnen om te zetten in samenhangende, visueel rijke en interactieve inzichten.”
Power BI integreert naadloos met andere tools, vooral die van Microsoft, en maakt het mogelijk om uitgebreide, interactieve rapporten te bouwen. Teams kunnen door de cloudservice in realtime samenwerken.
Toepassingen van bigdatatechnologieën
Gezondheidszorg
Big data verandert de zorgsector via tal van toepassingsgebieden:
Een van de belangrijkste toepassingen is predictive analytics, waarbij variabelen zoals patiëntgeschiedenis, genetica, bloeddruk en andere lifestylegegevens worden geanalyseerd om de kans op ziekten te voorspellen. Dit maakt vroege interventie en gepersonaliseerde behandelingen mogelijk, wat helpt om aandoeningen effectiever te voorkomen of te managen en tegelijkertijd de zorgkosten te verlagen.
Preventieve patiëntmonitoring is een ander gebied waarin big data uitblinkt. Realtime gezondheidsdata wordt verzameld via wearables, wat vroege detectie van afwijkingen en tijdige interventie mogelijk maakt. Dit is vooral nuttig bij het managen van chronische aandoeningen en het voorkomen van heropnames in het ziekenhuis.
In medisch onderzoek versnelt big data de ontdekking van nieuwe medicijnen en behandelingen door enorme datasets uit klinische proeven, genomische studies en patiëntendossiers te analyseren. Dit gebeurt via betere identificatie, testen en evaluatie van de effectiviteit van geneesmiddelen, wat tot snellere doorbraken leidt.
Tot slot kunnen lineaire en niet-lineaire optimalisatietechnieken, gefaciliteerd door bigdatatechnologieën, worden ingezet om roosters te optimaliseren, wachttijden te verkorten en de algehele zorgverlening te verbeteren.
Financiën
Financiële instellingen gebruiken big data voor veel usecases, zoals:
Retail
Retailers zetten big data in voor verschillende toepassingsgebieden, zoals:
Opkomende trends in bigdatatechnologieën
Edge computing
Volgens de definitie van IBM is “edge computing een gedistribueerd computingsframework dat bedrijfsapplicaties dichter bij databronnen brengt, zoals IoT-apparaten of lokale edge-servers. Deze nabijheid tot data bij de bron kan sterke zakelijke voordelen opleveren, waaronder snellere inzichten, betere reactietijden en betere bandbreedtebeschikbaarheid”.
De nabijheid tot data maakt verwerking dichter bij de bron mogelijk, wat de latentie vermindert en de snelheid van besluitvorming verbetert. Dit is cruciaal in IoT-toepassingen waar realtime verwerking essentieel is. Omdat je data niet naar centrale locaties hoeft te verplaatsen, kan edge computing ook het bandbreedtegebruik en de responstijden verlagen. Dit betekent snellere en nauwkeurigere datagedreven besluitvorming.
AI-integratie
Volgens de definitie van RST is “AI-integratie het naadloos verweven van mogelijkheden van kunstmatige intelligentie rechtstreeks in producten en systemen. In plaats van dat AI als een externe tool opereert, wordt het analytische vermogen ingebed om alle facetten van prestaties te verbeteren.”
Het integreren van kunstmatige intelligentie (AI) met big data heeft de manier waarop bedrijven data analyseren en erop handelen veranderd. AI-algoritmen, met name machinelearningmodellen, stellen systemen in staat patronen te detecteren, voorspellingen te doen en besluitvormingsprocessen te automatiseren.
In de maakindustrie helpt AI-integratie bijvoorbeeld bij voorspellend onderhoud, waardoor bedrijven kunnen identificeren wanneer apparatuur waarschijnlijk uitvalt en preventieve maatregelen kunnen nemen. Dit vermindert stilstand en operationele kosten. Evenzo kan AI-gedreven anomaliedetectie ongewone transacties in de financiële sector identificeren en zo fraude in realtime helpen voorkomen.
Hybride cloudomgevingen
Volgens Microsoft is “een hybride cloud — soms cloudhybride genoemd — een computeromgeving die een on-premises datacenter combineert met een publieke cloud, waardoor data en applicaties tussen beide gedeeld kunnen worden.”
Een hybride cloudarchitectuur combineert het beste van de schaalbaarheid van de publieke cloud en de veiligheid van on-premises. Het biedt de flexibiliteit om gevoelige data veilig intern op te slaan, terwijl je de cloud gebruikt voor grotere, minder gevoelige taken. Hybride cloudomgevingen bieden ook kostenefficiëntie doordat bedrijven hun infrastructuur kunnen opschalen of juist verkleinen afhankelijk van hun behoeften.
Uitdagingen bij het implementeren van bigdatatechnologieën
Er zijn verschillende voordelen aan het implementeren van bigdatatechnologieën, maar ze brengen ook hun eigen uitdagingen met zich mee. Enkele overwegingen staan hieronder:
Conclusie
Bigdatatechnologieën zijn een strategische vereiste voor organisaties om concurrentievoordeel te behalen door actiegerichte inzichten uit enorme datasets te halen. Van opslag tot analytics en visualisatie: deze tools vormen de pijlers waarop moderne datagedreven besluitvorming rust. Op de hoogte blijven van opkomende trends zoals AI-integratie, edge computing en hybride cloudarchitecturen stelt bedrijven in staat om efficiënt te schalen en te innoveren in datamanagement. Het beheersen van deze technologieën stelt organisaties in staat om ruwe data om te zetten in waardevolle assets en zo concurrentievoordeel te behalen in een datagedreven economie. Het is echter belangrijk de kosten en andere uitdagingen te begrijpen voordat je implementatiebeslissingen neemt.
Voor verdere verdieping kun je de volgende bronnen bekijken: