Vai al contenuto principale

Che cos’è il Change Data Capture (CDC)? Guida per principianti

Questa guida esplora metodi, casi d’uso, strumenti di implementazione, sfide e best practice del CDC per aiutarti a costruire pipeline dati scalabili e a bassa latenza.
Aggiornato 29 set 2026  · 11 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Il Change Data Capture (CDC) mantiene efficienti le pipeline dati catturando solo insert, update e delete invece di ricaricare interi dataset. Questo riduce i tempi di elaborazione e il carico sul sistema.

Il CDC è inoltre essenziale nello streaming dati in tempo reale, integrandosi con piattaforme come Apache Kafka per abilitare architetture event-driven.

Vediamo nel dettaglio il CDC e come può migliorare i tuoi progetti dati!

Che cos’è il Change Data Capture (CDC)?

Il Change Data Capture è un approccio che rileva, cattura e inoltra solo i dati modificati da un sistema sorgente verso sistemi a valle come data warehouse, dashboard o applicazioni di streaming.

Invece di rielaborare interi dataset, il CDC si concentra esclusivamente sulle modifiche incrementali, assicurando che i sistemi di destinazione abbiano sempre accesso ai dati più aggiornati disponibili.

In un progetto di analytics in tempo reale, ho affrontato ritardi significativi nei report a causa di aggiornamenti batch. Passando a una soluzione CDC basata sui log, ho ridotto drasticamente il ritardo di freschezza dei dati da ore a secondi, rendendo il dashboard di analytics davvero real time. 

Con questa esperienza personale a sottolineare il valore pratico del CDC, passiamo ora ai diversi metodi utilizzati per implementarlo.

Metodi per implementare il Change Data Capture

Prima di entrare nelle tecniche specifiche, è importante riconoscere che non esiste un unico approccio adatto a ogni scenario. Di seguito trovi quattro metodi CDC comuni, ciascuno con i propri vantaggi e compromessi.

CDC basato sui log

Il CDC basato sui log legge i transaction log di un database (comunemente chiamati Write-Ahead Log, o WAL) per identificare le modifiche istantaneamente, man mano che si verificano. Questo metodo è altamente efficiente perché opera a basso livello, catturando i cambiamenti con un impatto minimo sul sistema di produzione.

  • Vantaggi: Basso overhead di sistema e prestazioni quasi in tempo reale lo rendono ideale per ambienti ad alto volume.
  • Svantaggi: Richiede accesso privilegiato ai transaction log e dipende da impostazioni corrette di retention dei log.

Per esempio, in PostgreSQL puoi configurare la replica logica per catturare le modifiche dal WAL:

-- Enable logical replication
ALTER SYSTEM SET wal_level = logical;

-- Create a logical replication slot to capture changes
SELECT pg_create_logical_replication_slot('cdc_slot', 'pgoutput');

-- Fetch recent changes from the WAL
SELECT * FROM pg_logical_slot_get_changes('cdc_slot', NULL, NULL);

Questo approccio permette a uno strumento di CDC (come Debezium o AWS DMS, che vedremo più avanti) di trasmettere continuamente le modifiche del database a un sistema a valle senza affidarsi a query pianificate.

CDC basato su trigger

Il CDC basato su trigger utilizza trigger di database associati agli eventi delle tabelle sorgenti (insert, update o delete) per registrare automaticamente le modifiche non appena si verificano. Questo metodo è semplice per i database che supportano i trigger e offre una cattura immediata dei cambiamenti; tuttavia, può aggiungere carico extra al database e complicare le modifiche di schema se non gestito con attenzione.  

  •  Vantaggi: Semplice da implementare sui database che supportano i trigger e garantisce una cattura immediata delle modifiche.
  • Svantaggi: Può aggiungere carico extra al database e può complicare le modifiche di schema se non gestito con attenzione.

Il CDC basato su trigger offre immediatezza, ma al costo potenziale di un overhead aggiuntivo, quindi è più adatto in ambienti con volumi di transazioni moderati.

In PostgreSQL, puoi creare un trigger per registrare le modifiche da una tabella customers in una tabella separata customers_audit:

-- Create an audit table to store changes
CREATE TABLE customers_audit (
    audit_id SERIAL PRIMARY KEY,
    operation_type TEXT,
    customer_id INT,
    customer_name TEXT,
    modified_at TIMESTAMP DEFAULT now()
);

-- Create a function to insert change records
CREATE OR REPLACE FUNCTION capture_customer_changes()
RETURNS TRIGGER AS $
BEGIN
    IF TG_OP = 'INSERT' THEN
        INSERT INTO customers_audit (operation_type, customer_id, customer_name)
        VALUES ('INSERT', NEW.id, NEW.name);
    ELSIF TG_OP = 'UPDATE' THEN
        INSERT INTO customers_audit (operation_type, customer_id, customer_name)
        VALUES ('UPDATE', NEW.id, NEW.name);
    ELSIF TG_OP = 'DELETE' THEN
        INSERT INTO customers_audit (operation_type, customer_id, customer_name)
        VALUES ('DELETE', OLD.id, OLD.name);
    END IF;
    RETURN NULL; -- No need to modify original table data
END;
$ LANGUAGE plpgsql;

-- Attach the trigger to the customers table
CREATE TRIGGER customer_changes_trigger
AFTER INSERT OR UPDATE OR DELETE ON customers
FOR EACH ROW EXECUTE FUNCTION capture_customer_changes();

Questo trigger garantisce che ogni INSERT, UPDATE o DELETE sulla tabella customers venga registrato in customers_audit in tempo reale.

CDC basato su polling

Il CDC basato su polling interroga periodicamente il database sorgente per verificare le modifiche in base a una colonna timestamp o di versione. Sebbene questo metodo eviti la necessità di accedere direttamente ai transaction log o ai trigger, può introdurre latenza perché le modifiche vengono rilevate solo a intervalli fissi.  

  • Vantaggi: Semplice da implementare quando non sono disponibili accesso ai log o trigger.
  • Svantaggi: Può ritardare la cattura delle modifiche e aumentare il carico se il polling è troppo frequente.

Questo approccio funziona bene quando l’accesso in tempo reale ai log non è disponibile, con il compromesso di un leggero ritardo nel rilevamento delle modifiche.

Immagina una tabella products con una colonna version_number che viene incrementata a ogni aggiornamento:

SELECT *
FROM products
WHERE version_number > 1050
ORDER BY version_number ASC;

Qui, 1050 è l’ultimo numero di versione elaborato nel ciclo di polling precedente. Questo garantisce che vengano recuperate solo le nuove modifiche senza basarsi sui timestamp, rendendo il metodo più robusto quando gli orologi di sistema non sono affidabili.

CDC basato su timestamp

Il CDC basato su timestamp si affida a una colonna dedicata che registra l’ora dell’ultima modifica per ogni record. Confrontando questi timestamp, il sistema identifica i record cambiati dall’ultimo controllo. 

Questo metodo è simile al CDC basato su polling ma è più strutturato, poiché richiede un meccanismo esplicito per tracciare le modifiche:

  • Il CDC basato su polling è un approccio più ampio che interroga periodicamente le modifiche usando qualsiasi pattern identificabile (timestamp, numeri di versione o altri indicatori).
  • Il CDC basato su timestamp dipende da una colonna di timestamp che deve essere mantenuta accuratamente nel database sorgente.

Sebbene sia facile da implementare quando il database aggiorna automaticamente i timestamp, dipende dalla coerenza degli orologi di sistema e dall’affidabilità degli aggiornamenti dei timestamp.

  • Vantaggi: Approccio semplice quando i sistemi aggiornano automaticamente i timestamp.
  • Svantaggi: L’accuratezza dipende dalla sincronizzazione costante degli orologi e da aggiornamenti affidabili dei timestamp.

Supponiamo di avere una tabella orders con una colonna last_modified che si aggiorna ogni volta che una riga viene inserita o modificata. La seguente query SQL recupera tutte le modifiche dall’ultimo controllo:

SELECT *
FROM orders
WHERE last_modified > '2025-02-25 12:00:00'
ORDER BY last_modified ASC;

Questo metodo funziona bene quando il database aggiorna automaticamente il timestamp alla modifica, ad esempio usando trigger o meccanismi integrati come DEFAULT now() di PostgreSQL o ON UPDATE CURRENT_TIMESTAMP di MySQL.

Tabella di confronto dei metodi CDC

Ecco una tabella di confronto che mette in evidenza le principali differenze tra i quattro metodi di Change Data Capture (CDC):

Caratteristica

CDC basato sui log

CDC basato su trigger

CDC basato su polling

CDC basato su timestamp

Come funziona

Legge i transaction log del database (WAL, binlog, ecc.) per catturare le modifiche in tempo reale.

Usa trigger di database per registrare le modifiche in una tabella di audit.

Interroga periodicamente le modifiche usando un numero di versione o altri criteri.

Confronta i timestamp in una colonna per rilevare le modifiche.

Latenza

Quasi in tempo reale (bassa latenza).

Immediata (i trigger si eseguono all’istante).

Intervalli pianificati (possono introdurre ritardi).

Dipende dalla frequenza di polling (bassa o moderata).

Overhead di sistema

Basso (non richiede query sulle tabelle).

Alto (i trigger vengono eseguiti a ogni modifica).

Moderato (dipende dalla frequenza di polling).

Basso o moderato (si basa su timestamp).

Complessità di implementazione

Alta (richiede accesso ai transaction log e retention adeguata).

Medio-alta (richiede la creazione di trigger e la manutenzione di una tabella di audit).

Bassa (si basa su semplici query SQL).

Bassa (semplice se i timestamp sono gestiti automaticamente).

Requisiti di accesso

Accesso privilegiato ai transaction log.

Richiede accesso DDL per creare trigger.

Nessun accesso speciale necessario (SQL standard).

Nessun accesso speciale necessario (SQL standard).

Supporta le delete?

Sì (catturate dai log).

Sì (se registrate nella tabella di audit).

Richiede tracciamento extra (ad es., una tabella delete separata).

Solo se si usano soft delete (deleted_at).

Caso d’uso ideale

Replica in tempo reale ad alto volume dove è cruciale un carico minimo sul database.

Carichi piccoli o medi che richiedono cattura istantanea delle modifiche.

Quando CDC basato su log e trigger non sono disponibili, ma sono accettabili aggiornamenti periodici.

Quando i timestamp vengono aggiornati automaticamente e un polling frequente è fattibile.

Strumenti comuni

Debezium, AWS DMS, StreamSets, Striim, HVR

Trigger nativi del database (PostgreSQL, MySQL, SQL Server, Oracle)

Apache Airflow, script ETL (Python, SQL)

Job ETL, pipeline dati batch

Casi d’uso del Change Data Capture

Comprendere i metodi è solo metà della storia; vedere come il CDC offre valore tangibile in scenari reali è altrettanto importante.

Data warehousing in tempo reale

Il CDC abilita aggiornamenti continui e incrementali ai data warehouse propagando solo le modifiche invece di ricaricare dataset completi. Questo approccio garantisce che gli strumenti di business intelligence e i dashboard mostrino i dati più aggiornati. 

Per esempio, un’azienda retail può aggiornare il proprio dashboard delle vendite in quasi tempo reale per far emergere rapidamente trend e insight.

Replica dei dati

Il CDC replica i dati tra sistemi assicurando che ogni modifica effettuata nel sistema sorgente venga immediatamente rispecchiata nei database di destinazione. Ciò è particolarmente utile durante progetti di migrazione dei dati o quando si mantengono backup e repliche in ambienti ibridi.

Per esempio, replicare i dati da sistemi on‑premises a database cloud come AWS RDS o Snowflake garantisce coerenza tra piattaforme.

Sincronizzazione dei dati

Nei sistemi distribuiti—come quelli che coinvolgono microservizi o applicazioni multiple—il CDC assicura che ogni componente lavori sui dati più aggiornati sincronizzando le modifiche in tempo reale. 

Per esempio, sincronizzare le informazioni dei clienti tra varie piattaforme mantiene un’esperienza utente coerente ovunque.

Audit e monitoraggio dei dati

Infine, il CDC fornisce log di modifica dettagliati essenziali per finalità di audit. Tracciando chi ha effettuato le modifiche e quando sono avvenute, i team possono soddisfare requisiti normativi, risolvere problemi e svolgere analisi forensi approfondite.

Le istituzioni finanziarie, per esempio, si basano su log CDC completi per auditare le modifiche ai dati dei clienti e garantire la conformità a rigorose politiche di data governance.

Strumenti per implementare il Change Data Capture

Dopo aver esplorato metodi e casi d’uso, vediamo alcuni strumenti popolari che facilitano l’implementazione del CDC. La scelta giusta dipende dal tuo caso d’uso—che tu abbia bisogno di streaming in tempo reale, migrazione al cloud o soluzioni ETL enterprise.

AWS Database Migration Service (DMS)

AWS DMS utilizza CDC basato sui log per replicare continuamente i dati dai sistemi on‑premises al cloud AWS con downtime minimo, risultando un’ottima scelta per le migrazioni. AWS DMS è una soluzione robusta se il tuo obiettivo è spostare i dati nel cloud con un’elevata affidabilità.

Ideale per: Migrazioni al cloud e architetture basate su AWS.
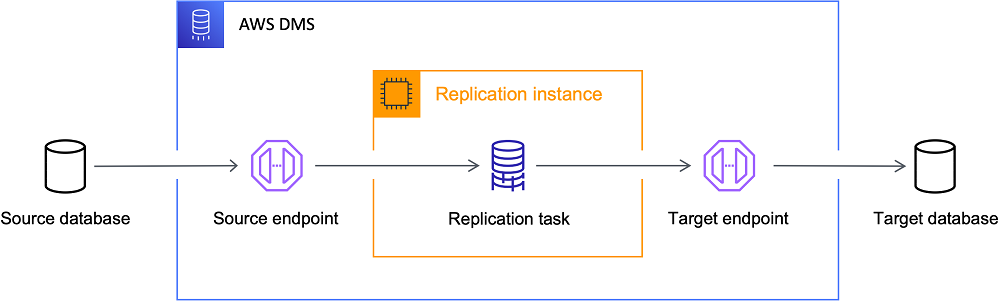
Architettura di AWS DMS.

L’architettura di AWS DMS. Fonte immagine: AWS

Debezium

Debezium è una piattaforma CDC open source che cattura e invia in streaming le modifiche del database verso sistemi come Apache Kafka. 

Personalmente, ho trovato Debezium estremamente utile per trasmettere in streaming le modifiche del database a Kafka, soprattutto in ambienti distribuiti dove più servizi dipendono da aggiornamenti in tempo reale. La sua scalabilità e le capacità di integrazione lo rendono un’opzione di spicco.

Ideale per: Streaming dati in tempo reale e architetture event-driven.
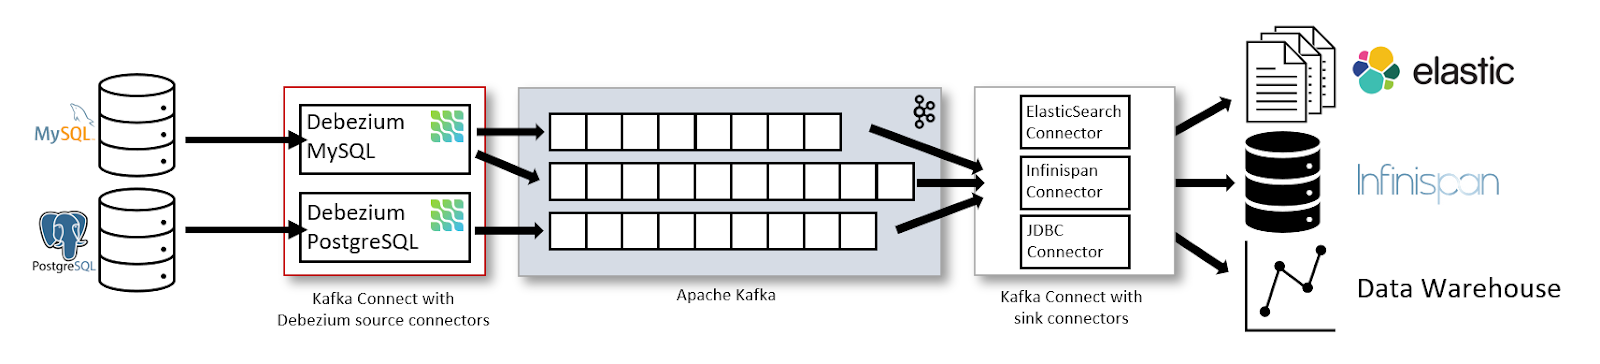
Architettura di data streaming con Kafka Connect e Debezium.

L’architettura di data streaming con Kafka Connect e Debezium. Fonte immagine: Debezium

Apache Kafka

Apache Kafka non è uno strumento CDC in sé, ma funge da spina dorsale per l’elaborazione degli eventi CDC quando abbinato a strumenti come Debezium. Kafka abilita pipeline event-driven affidabili, analytics in tempo reale e sincronizzazione dei dati tra più consumer.

Ideale per: Trasmettere dati CDC verso architetture event-driven.

Per illustrare come inviare eventi CDC a Kafka, considera il seguente snippet Python. Il codice inizializza un producer Kafka e invia un evento CDC (che rappresenta un’operazione di update su una tabella orders) a un topic Kafka chiamato cdc-topic:

from kafka import KafkaProducer
import json

# Initialize the Kafka producer with bootstrap servers and a JSON serializer for values.
producer = KafkaProducer(
    bootstrap_servers='localhost:9092',
    value_serializer=lambda v: json.dumps(v).encode('utf-8')
)

# Define a CDC event that includes details of the operation.
cdc_event = {
    "table": "orders",
    "operation": "update",
    "data": {"order_id": 123, "status": "shipped"}
}

# Send the CDC event to the 'cdc-topic' and flush to ensure transmission.
producer.send('cdc-topic', cdc_event)
producer.flush()
print("CDC event sent successfully!")

Talend e Informatica

Talend e Informatica sono piattaforme ETL complete che offrono funzionalità CDC integrate per catturare ed elaborare le modifiche ai dati, riducendo le configurazioni manuali. Sono particolarmente vantaggiose in scenari complessi di trasformazione dei dati, dove soluzioni integrate possono semplificare le operazioni.

Ideale per: Soluzioni ETL di livello enterprise con CDC integrato.

Soluzioni CDC native del database

Diversi database relazionali offrono funzionalità CDC native, riducendo la necessità di strumenti esterni:

  • Replica logica di PostgreSQL: cattura le modifiche nel WAL e le invia agli abbonati.
  • Change Data Capture (CDC) di SQL Server: usa i transaction log per tracciare automaticamente le modifiche.
  • Replicazione del binary log (binlog) di MySQL: registra le modifiche per finalità di replica.

Ideale per: Ridurre al minimo le dipendenze da strumenti CDC esterni.

Google Datastream e Azure Data Factory

I provider cloud offrono anche soluzioni CDC per i propri ecosistemi:

  • Google Datastream: un servizio CDC e di replica completamente gestito per gli utenti di Google Cloud.
  • Azure Data Factory CDC: abilita il tracciamento delle modifiche e la replica per Azure SQL, CosmosDB e Synapse Analytics.

Ideale per: CDC all’interno degli ambienti Google Cloud o Microsoft Azure.

Sfide e limitazioni del CDC

Sebbene il CDC offra vantaggi significativi, presenta anche sfide che devono essere gestite per un’implementazione affidabile.

Gestione dei problemi di integrità dei dati

Mantenere l’integrità dei dati può essere impegnativo in presenza di interruzioni di rete, transazioni in ritardo o malfunzionamenti del sistema. Protocolli di gestione errori robusti e riconciliazioni regolari sono fondamentali per prevenire discrepanze tra sistemi sorgente e di destinazione. Affrontare questi problemi in anticipo aiuta a mantenere una pipeline dati affidabile.

Overhead prestazionale

Alcuni metodi CDC—in particolare quelli basati su trigger o su polling frequente—possono introdurre carico aggiuntivo sui database sorgente. Bilanciare la necessità di aggiornamenti quasi in tempo reale con i vincoli prestazionali dei sistemi di produzione è la chiave per un funzionamento regolare.

Gestione di trasformazioni dati complesse

Sebbene il CDC catturi in modo efficiente le modifiche raw, potrebbe essere necessaria un’ulteriore elaborazione a valle, come pulizia o trasformazione dei dati. Integrare la logica di trasformazione senza ritardare le consegne o introdurre errori aggiunge complessità all’implementazione del CDC, quindi è necessaria un’attenta pianificazione.

Best practice per implementare il CDC

Passare dalla teoria alla pratica richiede il rispetto delle best practice. Ecco alcuni suggerimenti concreti tratti dalla mia esperienza che mi hanno aiutato a costruire pipeline CDC robuste.

Scegli il metodo di implementazione giusto

Seleziona un approccio CDC che sia in linea con il volume dei dati, i requisiti di latenza e l’architettura del sistema. Il CDC basato sui log è di solito ottimale per ambienti ad alta transazionalità, mentre i metodi basati su trigger o polling possono essere più adatti ad applicazioni più piccole. Valutare le tue esigenze specifiche in anticipo può far risparmiare tempo e risorse in seguito.

Monitora i job

Implementa un monitoraggio completo con dashboard in tempo reale e avvisi automatici. Revisioni regolari dei log e health check sono essenziali per garantire che ogni modifica sia catturata accuratamente e che eventuali problemi vengano affrontati tempestivamente. 

Una piccola errata configurazione del CDC basato sui log in un progetto è passata inosservata per giorni, causando una perdita silente di dati nelle analytics a valle. L’implementazione di avvisi Grafana ha aiutato a intercettare subito gli aggiornamenti mancanti, prevenendo errori costosi.

Garantisci la qualità dei dati

Integra checkpoint di validazione dei dati all’interno della pipeline CDC per assicurare che vengano propagate solo modifiche accurate e coerenti. 

Dalla mia esperienza, impostare controlli di validazione automatizzati nella pipeline CDC mi ha risparmiato ore di debugging di problemi di propagazione errata dei dati. Strumenti come dbt e Apache Airflow sono stati fondamentali per imporre coerenza tra più sistemi a valle.

Testa le implementazioni prima del deployment

Prima di portare in produzione la tua soluzione CDC, testala a fondo in un ambiente di staging. Simula carichi di lavoro reali e scenari di failure e valida funzionalità come rollback e time travel per assicurarti che il sistema si comporti come previsto in tutte le condizioni. Questo testing rigoroso è importante per un rilascio in produzione senza intoppi.

Gestisci l’evoluzione dello schema in modo strategico

Il tuo sistema CDC deve adattarsi ai cambiamenti di schema senza interruzioni man mano che i dataset evolvono. Usa strumenti che supportano l’evoluzione automatica dello schema e mantieni un controllo di versione adeguato, così che i nuovi campi vengano integrati senza problemi. Questo approccio strategico evita errori inaspettati e downtime quando le strutture dei dati cambiano.

Conclusione

Catturando con precisione solo i dati modificati, il CDC riduce il carico di sistema e consente ad analytics e applicazioni di streaming in tempo reale di funzionare correttamente. Che tu stia implementando replica, sincronizzazione o audit logging, scegliere il metodo CDC appropriato e seguire le best practice è la chiave per costruire una pipeline dati affidabile ed efficiente. 

Per chi vuole approfondire, ti invito a esplorare i seguenti corsi DataCamp:

Buon coding—e brindiamo alla costruzione di sistemi dati resilienti e in tempo reale!

FAQ

In che modo il CDC migliora l’analytics in tempo reale nelle architetture dati moderne?

Il CDC riduce la necessità di job ETL massivi catturando solo le modifiche incrementali dai database sorgente. Questo assicura che i dashboard analitici e le applicazioni di streaming abbiano sempre accesso ai dati più recenti, riducendo latenza e carico di sistema.

Quali sono i passi pratici per testare un’implementazione CDC prima del deployment completo?

Configura un ambiente di staging per simulare i carichi di produzione; monitora integrità dei dati, latenza e gestione errori; ed esegui test di rollback usando funzionalità di time travel, se disponibili, per validare le procedure di recupero.

Come posso gestire l’evoluzione dello schema quando uso il CDC?

Incorpora versioning dello schema e step di validazione automatizzati nella pipeline CDC. Testa le modifiche di schema in un ambiente controllato per garantire la retrocompatibilità e sfrutta strumenti CDC che supportano l’evoluzione automatica dello schema.

Quale metodo CDC scegliere per un ambiente ad alto volume e bassa latenza?

Il CDC basato sui log è generalmente l’opzione migliore per tali ambienti, poiché legge direttamente dai transaction log del database (WAL) e minimizza l’impatto sui carichi di produzione, fornendo aggiornamenti quasi in tempo reale.

Which CDC method should be chosen for a high-volume, low-latency environment?

Log-based CDC is generally the best option for such environments, as it reads directly from database transaction logs (WAL) and minimizes the impact on production workloads, providing near‑real‑time updates.


Khalid Abdelaty's photo
Author
Khalid Abdelaty
LinkedIn

Sono un data engineer e community builder: lavoro su pipeline dati, cloud e strumenti di AI, e scrivo tutorial pratici e ad alto impatto per DataCamp e per sviluppatori alle prime armi.

Argomenti
Data Engineering
Analisi dei dati

Approfondisci il data engineering con questi corsi!

Corso

Introduzione al Data Engineering

4 ore
130.1K
Scopri il mondo dell'ingegneria dei dati in questo breve corso, che parla di strumenti e argomenti come ETL e cloud computing.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Mostra AltroMostra Altro

