मुख्य सामग्री पर जाएं

चेंज डेटा कैप्चर (CDC) क्या है? शुरुआती मार्गदर्शिका

यह मार्गदर्शिका स्केलेबल और कम‑लेटेंसी डेटा पाइपलाइंस बनाने में आपकी मदद के लिए CDC की विधियाँ, उपयोग‑मामले, इम्प्लीमेंटेशन टूल्स, चुनौतियाँ, और सर्वोत्तम प्रथाएँ समझाती है।
अपडेट किया गया 25 सित॰ 2026  · 11 मि॰ पढ़ें

AI के साथ खोजें

ChatGPTClaudePerplexity

चेंज डेटा कैप्चर (CDC) पूरी डेटासेट को फिर से लोड करने के बजाय केवल इंसर्ट, अपडेट, और डिलीट को कैप्चर करके डेटा पाइपलाइनों को कुशल बनाए रखने में मदद करता है। इससे प्रोसेसिंग समय और सिस्टम लोड कम होता है।

CDC रियल‑टाइम डेटा स्ट्रीमिंग में भी महत्वपूर्ण है, जो Apache Kafka जैसे प्लेटफ़ॉर्म के साथ एकीकृत होकर इवेंट‑ड्रिवन आर्किटेक्चर सक्षम करता है।

आइए CDC को समझते हैं और देखते हैं कि यह आपके डेटा प्रोजेक्ट्स को कैसे बेहतर बना सकता है!

चेंज डेटा कैप्चर (CDC) क्या है?

चेंज डेटा कैप्चर ऐसा दृष्टिकोण है जो स्रोत सिस्टम से केवल संशोधित डेटा का पता लगाता है, उसे कैप्चर करता है और डाउनस्ट्रीम सिस्टम्स जैसे डेटा वेयरहाउस, डैशबोर्ड्स, या स्ट्रीमिंग एप्लिकेशन तक अग्रेषित करता है।

पूरी डेटासेट को दोबारा प्रोसेस करने के बजाय, CDC केवल क्रमिक परिवर्तनों पर ध्यान देता है, जिससे टारगेट सिस्टम को हमेशा उपलब्ध सबसे नवीनतम डेटा तक पहुँच मिलती रहती है।

एक रियल‑टाइम एनालिटिक्स प्रोजेक्ट में, बैच अपडेट्स के कारण मुझे रिपोर्टिंग में काफी देरी का सामना करना पड़ा। लॉग‑आधारित CDC समाधान अपनाने से मैंने डेटा की फ्रेशनैस की देरी घंटों से सेकंड में घटा दी, जिससे एनालिटिक्स डैशबोर्ड वास्तव में रियल‑टाइम हो गया। 

CDC के इस व्यावहारिक मूल्य को निजी अनुभव से रेखांकित करते हुए, अब आइए CDC को लागू करने के विभिन्न तरीकों पर बढ़ते हैं।

चेंज डेटा कैप्चर लागू करने के तरीके

विशिष्ट तकनीकों में जाने से पहले, यह समझना महत्वपूर्ण है कि हर परिदृश्य के लिए कोई एक तरीका उपयुक्त नहीं होता। नीचे चार सामान्य CDC विधियाँ दी गई हैं, जिनमें प्रत्येक के अपने लाभ और समझौते हैं।

लॉग‑आधारित CDC

लॉग‑आधारित CDC डेटाबेस के ट्रांज़ैक्शन लॉग्स (आम तौर पर Write‑Ahead Logs या WAL) को पढ़कर जैसे ही परिवर्तन होते हैं, उन्हें तुरंत पहचानता है। यह तरीका इसलिए अत्यधिक कुशल है क्योंकि यह निम्न स्तर पर काम करता है और प्रोडक्शन सिस्टम में न्यूनतम व्यवधान के साथ परिवर्तन कैप्चर करता है।

  • लाभ: कम सिस्टम ओवरहेड और लगभग रियल‑टाइम प्रदर्शन इसे उच्च‑वॉल्यूम वातावरण के लिए आदर्श बनाते हैं।
  • हानियाँ: ट्रांज़ैक्शन लॉग्स तक विशेषाधिकारयुक्त पहुँच की आवश्यकता होती है और उचित लॉग रिटेंशन सेटिंग्स पर निर्भर करता है।

उदाहरण के लिए, PostgreSQL में आप WAL से परिवर्तन कैप्चर करने के लिए लॉजिकल रिप्लिकेशन सेट कर सकते हैं:

-- Enable logical replication
ALTER SYSTEM SET wal_level = logical;

-- Create a logical replication slot to capture changes
SELECT pg_create_logical_replication_slot('cdc_slot', 'pgoutput');

-- Fetch recent changes from the WAL
SELECT * FROM pg_logical_slot_get_changes('cdc_slot', NULL, NULL);

यह तरीका किसी CDC टूल (जैसे Debezium या AWS DMS, जिन पर हम आगे बात करेंगे) को बिना शेड्यूल्ड क्वेरी पर निर्भर हुए, डेटाबेस परिवर्तनों को लगातार डाउनस्ट्रीम सिस्टम तक स्ट्रीम करने देता है।

ट्रिगर‑आधारित CDC

ट्रिगर‑आधारित CDC स्रोत टेबल इवेंट्स (इंसर्ट, अपडेट, या डिलीट) से जुड़े डेटाबेस ट्रिगर्स का उपयोग करता है ताकि जैसे ही परिवर्तन हों, वे स्वतः रिकॉर्ड हो जाएँ। यह तरीका उन डेटाबेस के लिए सीधा है जो ट्रिगर्स को सपोर्ट करते हैं और त्वरित कैप्चर प्रदान करता है; हालाँकि, यह डेटाबेस पर अतिरिक्त लोड डाल सकता है और यदि सावधानी से न संभाला जाए तो स्कीमा परिवर्तनों को जटिल बना सकता है।  

  •  लाभ: ट्रिगर्स सपोर्ट करने वाले डेटाबेस पर लागू करना आसान और परिवर्तन का तुरंत कैप्चर सुनिश्चित करता है।
  • हानियाँ: यह डेटाबेस पर अतिरिक्त लोड डाल सकता है और सावधानीपूर्वक प्रबंधन न होने पर स्कीमा परिवर्तन जटिल कर सकता है।

ट्रिगर‑आधारित CDC तात्कालिकता देता है, लेकिन संभावित अतिरिक्त ओवरहेड की कीमत पर, इसलिए यह मध्यम ट्रांज़ैक्शन वॉल्यूम वाले परिवेशों में सबसे उपयुक्त है।

PostgreSQL में, आप customers टेबल से होने वाले परिवर्तनों को एक अलग customers_audit टेबल में लॉग करने के लिए एक ट्रिगर बना सकते हैं:

-- Create an audit table to store changes
CREATE TABLE customers_audit (
    audit_id SERIAL PRIMARY KEY,
    operation_type TEXT,
    customer_id INT,
    customer_name TEXT,
    modified_at TIMESTAMP DEFAULT now()
);

-- Create a function to insert change records
CREATE OR REPLACE FUNCTION capture_customer_changes()
RETURNS TRIGGER AS $
BEGIN
    IF TG_OP = 'INSERT' THEN
        INSERT INTO customers_audit (operation_type, customer_id, customer_name)
        VALUES ('INSERT', NEW.id, NEW.name);
    ELSIF TG_OP = 'UPDATE' THEN
        INSERT INTO customers_audit (operation_type, customer_id, customer_name)
        VALUES ('UPDATE', NEW.id, NEW.name);
    ELSIF TG_OP = 'DELETE' THEN
        INSERT INTO customers_audit (operation_type, customer_id, customer_name)
        VALUES ('DELETE', OLD.id, OLD.name);
    END IF;
    RETURN NULL; -- No need to modify original table data
END;
$ LANGUAGE plpgsql;

-- Attach the trigger to the customers table
CREATE TRIGGER customer_changes_trigger
AFTER INSERT OR UPDATE OR DELETE ON customers
FOR EACH ROW EXECUTE FUNCTION capture_customer_changes();

यह ट्रिगर सुनिश्चित करता है कि customers टेबल पर हर INSERT, UPDATE, या DELETE रियल‑टाइम में customers_audit में लॉग हो जाए।

पोलिंग‑आधारित CDC

पोलिंग‑आधारित CDC समय‑समय पर स्रोत डेटाबेस को क्वेरी करता है ताकि टाइमस्टैम्प या वर्ज़न कॉलम के आधार पर परिवर्तन जाँचे जा सकें। जबकि इस तरीके में ट्रांज़ैक्शन लॉग्स या ट्रिगर्स तक सीधी पहुँच की ज़रूरत नहीं पड़ती, यह विलंब ला सकता है क्योंकि परिवर्तन केवल निश्चित अंतराल पर ही पकड़े जाते हैं।  

  • लाभ: जब लॉग एक्सेस या ट्रिगर्स उपलब्ध न हों, तब लागू करना आसान।
  • हानियाँ: परिवर्तन कैप्चर में देरी कर सकता है और यदि पोलिंग बहुत बार हो तो लोड बढ़ा सकता है।

जब लॉग्स तक रियल‑टाइम पहुँच उपलब्ध न हो, तब यह तरीका उपयोगी रहता है; हालाँकि इसकी कीमत परिवर्तनों के पता लगाने में हल्का विलंब है।

मान लें कि एक products टेबल में version_number कॉलम है जो हर अपडेट पर बढ़ता है:

SELECT *
FROM products
WHERE version_number > 1050
ORDER BY version_number ASC;

यहाँ 1050 पिछले पोलिंग चक्र से अंतिम प्रोसेस्ड वर्ज़न नंबर है। इससे यह सुनिश्चित होता है कि केवल नए परिवर्तन ही फ़ेच हों, और टाइमस्टैम्प पर निर्भरता न रहे, जो तब उपयोगी है जब सिस्टम क्लॉक्स भरोसेमंद न हों।

टाइमस्टैम्प‑आधारित CDC

टाइमस्टैम्प‑आधारित CDC एक समर्पित कॉलम पर निर्भर करता है जो प्रत्येक रिकॉर्ड के अंतिम संशोधित समय को दर्ज करता है। इन टाइमस्टैम्प की तुलना करके, सिस्टम यह पहचानता है कि पिछली जाँच के बाद किन रिकॉर्ड्स में परिवर्तन हुआ है। 

यह तरीका पोलिंग‑आधारित CDC जैसा है, लेकिन अधिक संरचित है, क्योंकि इसमें परिवर्तनों को ट्रैक करने का एक स्पष्ट तंत्र आवश्यक होता है:

  • पोलिंग‑आधारित CDC एक व्यापक तरीका है जो किसी भी पहचाने जाने योग्य पैटर्न (टाइमस्टैम्प, वर्ज़न नंबर, या अन्य संकेतक) का उपयोग करके समय‑समय पर परिवर्तन क्वेरी करता है।
  • टाइमस्टैम्प‑आधारित CDC एक टाइमस्टैम्प कॉलम पर निर्भर करता है, जिसे स्रोत डेटाबेस में सटीकता से मेंटेन किया जाना चाहिए।

जब डेटाबेस टाइमस्टैम्प को स्वचालित रूप से अपडेट करता है तो इसे लागू करना आसान है, लेकिन यह सिस्टम क्लॉक्स की स्थिरता और टाइमस्टैम्प अपडेट की विश्वसनीयता पर निर्भर करता है।

  • लाभ: तब सरल जब सिस्टम टाइमस्टैम्प को स्वतः अपडेट करते हैं।
  • हानियाँ: सटीकता घड़ियों के सुसंगत समन्वय और विश्वसनीय टाइमस्टैम्प अपडेट पर निर्भर करती है।

मान लें हमारे पास orders टेबल है जिसमें last_modified कॉलम है जो किसी पंक्ति के इंसर्ट या संशोधित होने पर अपडेट होता है। निम्न SQL क्वेरी पिछली जाँच के बाद हुए सभी परिवर्तन लाती है:

SELECT *
FROM orders
WHERE last_modified > '2025-02-25 12:00:00'
ORDER BY last_modified ASC;

यह तरीका तब अच्छी तरह काम करता है जब डेटाबेस संशोधन पर टाइमस्टैम्प को स्वतः अपडेट करता है, जैसे PostgreSQL के DEFAULT now() या MySQL के ON UPDATE CURRENT_TIMESTAMP जैसे इनबिल्ट मैकेनिज़्म या ट्रिगर्स का उपयोग करके।

CDC विधियों की तुलना तालिका

यहाँ चार चेंज डेटा कैप्चर (CDC) विधियों के प्रमुख अंतर को उजागर करती हुई एक तुलना तालिका दी गई है:

विशेषता

लॉग‑आधारित CDC

ट्रिगर‑आधारित CDC

पोलिंग‑आधारित CDC

टाइमस्टैम्प‑आधारित CDC

कैसे काम करता है

रियल‑टाइम में परिवर्तन कैप्चर करने के लिए डेटाबेस ट्रांज़ैक्शन लॉग्स (WAL, binlog, आदि) पढ़ता है।

परिवर्तनों को एक ऑडिट टेबल में लॉग करने के लिए डेटाबेस ट्रिगर्स का उपयोग करता है।

वर्ज़न नंबर या अन्य मानदंडों का उपयोग करके समय‑समय पर परिवर्तनों के लिए क्वेरी करता है।

परिवर्तन का पता लगाने के लिए कॉलम में टाइमस्टैम्प की तुलना करता है।

लेटेंसी

लगभग रियल‑टाइम (कम लेटेंसी)।

तात्कालिक (ट्रिगर्स तुरंत निष्पादित होते हैं)।

शेड्यूल्ड अंतराल (देरी ला सकते हैं)।

पोलिंग आवृत्ति पर निर्भर (कम से मध्यम लेटेंसी)।

सिस्टम ओवरहेड

कम (टेबल्स को क्वेरी करने की आवश्यकता नहीं)।

उच्च (हर परिवर्तन पर ट्रिगर्स चलते हैं)।

मध्यम (पोलिंग आवृत्ति पर निर्भर)।

कम से मध्यम (टाइमस्टैम्प पर निर्भर)।

इम्प्लीमेंटेशन जटिलता

उच्च (ट्रांज़ैक्शन लॉग्स तक पहुँच और उचित रिटेंशन की आवश्यकता)।

मध्यम‑उच्च (ट्रिगर्स बनाना और ऑडिट टेबल मेंटेन करना पड़ता है)।

कम (सरल SQL क्वेरियों पर आधारित)।

कम (यदि टाइमस्टैम्प स्वतः प्रबंधित हों तो सरल)।

एक्सेस आवश्यकताएँ

ट्रांज़ैक्शन लॉग्स तक विशेषाधिकारयुक्त पहुँच।

ट्रिगर्स बनाने के लिए DDL एक्सेस की आवश्यकता।

कोई विशेष एक्सेस आवश्यक नहीं (मानक SQL)।

कोई विशेष एक्सेस आवश्यक नहीं (मानक SQL)।

डिलीट सपोर्ट?

हाँ (लॉग्स से कैप्चर होता है)।

हाँ (यदि ऑडिट टेबल में लॉग किया गया हो)।

अतिरिक्त ट्रैकिंग की ज़रूरत (जैसे, अलग डिलीट टेबल)।

केवल तभी जब सॉफ्ट डिलीट्स (deleted_at) उपयोग हों।

सर्वोत्तम उपयोग मामला

उच्च‑वॉल्यूम, रियल‑टाइम रिप्लिकेशन जहाँ न्यूनतम डेटाबेस लोड महत्वपूर्ण हो।

छोटे से मध्यम वर्कलोड्स जिन्हें त्वरित परिवर्तन कैप्चर चाहिए।

जब लॉग‑आधारित CDC और ट्रिगर्स उपलब्ध न हों, लेकिन समय‑समय पर अपडेट स्वीकार्य हों।

जब टाइमस्टैम्प स्वतः अपडेट होते हों और बार‑बार पोलिंग संभव हो।

आम टूल्स

Debezium, AWS DMS, StreamSets, Striim, HVR

डेटाबेस‑नेटिव ट्रिगर्स (PostgreSQL, MySQL, SQL Server, Oracle)

Apache Airflow, ETL स्क्रिप्ट्स (Python, SQL)

ETL जॉब्स, बैच डेटा पाइपलाइंस

चेंज डेटा कैप्चर के उपयोग‑मामले

तरीकों को समझना आधी कहानी है; वास्तविक दुनिया के परिदृश्यों में CDC किस तरह ठोस मूल्य देता है, यह देखना उतना ही महत्वपूर्ण है।

रियल‑टाइम डेटा वेयरहाउसिंग

CDC पूर्ण डेटासेट्स को फिर से लोड करने के बजाय केवल परिवर्तनों को प्रसारित करके डेटा वेयरहाउस में सतत, क्रमिक अपडेट सक्षम करता है। इस तरीके से बिज़नेस इंटेलिजेंस टूल्स और डैशबोर्ड्स में सबसे ताज़ा डेटा दिखता रहता है। 

उदाहरण के लिए, एक रिटेल कंपनी अपने सेल्स डैशबोर्ड को लगभग रियल‑टाइम में अपडेट कर सकती है, जिससे उभरते रुझान और इनसाइट्स तुरंत दिखें।

डेटा प्रतिलिपि (रिप्लिकेशन)

CDC यह सुनिश्चित करके सिस्टम्स के बीच डेटा की प्रतिलिपि बनाता है कि स्रोत सिस्टम में किया गया कोई भी परिवर्तन तुरंत टारगेट डेटाबेस में परिलक्षित हो। यह विशेष रूप से डेटा माइग्रेशन प्रोजेक्ट्स के दौरान या हाइब्रिड वातावरण में बैकअप्स और प्रतिकृतियाँ बनाए रखने के समय उपयोगी है।

उदाहरण के लिए, ऑन‑प्रिमाइस सिस्टम्स से AWS RDS या Snowflake जैसे क्लाउड डेटाबेस में डेटा की प्रतिकृति बनाना प्लेटफ़ॉर्म्स में स्थिरता सुनिश्चित करता है।

डेटा सिंक्रोनाइज़ेशन

डिस्ट्रीब्यूटेड सिस्टम्स—जैसे माइक्रोसर्विसेज़ या अनेक एप्लिकेशन—में CDC रियल‑टाइम में परिवर्तनों को सिंक्रोनाइज़ करके सुनिश्चित करता है कि हर घटक सबसे अद्यतन डेटा पर काम करे। 

उदाहरण के लिए, विभिन्न प्लेटफ़ॉर्म्स पर ग्राहक जानकारी का सिंक्रोनाइज़ेशन हर जगह एकसमान उपयोगकर्ता अनुभव बनाए रखता है।

डेटा ऑडिटिंग और मॉनिटरिंग

अंततः, CDC विस्तृत परिवर्तन लॉग प्रदान करता है जो ऑडिटिंग उद्देश्यों के लिए आवश्यक होते हैं। यह ट्रैक करके कि परिवर्तन किसने और कब किए, टीमें नियामकीय आवश्यकताओं को पूरा कर सकती हैं, समस्याओं का निवारण कर सकती हैं, और गहन फॉरेंसिक विश्लेषण कर सकती हैं।

उदाहरण के लिए, वित्तीय संस्थान व्यापक CDC लॉग्स पर निर्भर रहते हैं ताकि ग्राहक डेटा में संशोधनों का ऑडिट कर सकें और सख्त डेटा गवर्नेंस नीतियों का अनुपालन सुनिश्चित कर सकें।

चेंज डेटा कैप्चर लागू करने के टूल्स

विधियों और उपयोग‑मामलों की पड़ताल करने के बाद, आइए कुछ लोकप्रिय टूल्स देखें जो CDC इम्प्लीमेंटेशन में सहायक हैं। सही चुनाव आपके उपयोग‑मामले पर निर्भर करता है—चाहे आपको रियल‑टाइम स्ट्रीमिंग, क्लाउड माइग्रेशन, या एंटरप्राइज़ ETL समाधान चाहिए।

AWS Database Migration Service (DMS)

AWS DMS लॉग‑आधारित CDC का उपयोग करके ऑन‑प्रिमाइस सिस्टम्स से AWS क्लाउड तक न्यूनतम डाउनटाइम के साथ लगातार डेटा की प्रतिकृति बनाता है, जो माइग्रेशन के लिए उत्कृष्ट विकल्प है। यदि आपका लक्ष्य डेटा को भरोसेमंद अपटाइम के साथ क्लाउड में ले जाना है, तो AWS DMS एक मजबूत समाधान है।

किसके लिए सर्वोत्तम: क्लाउड माइग्रेशन और AWS‑आधारित आर्किटेक्चर।
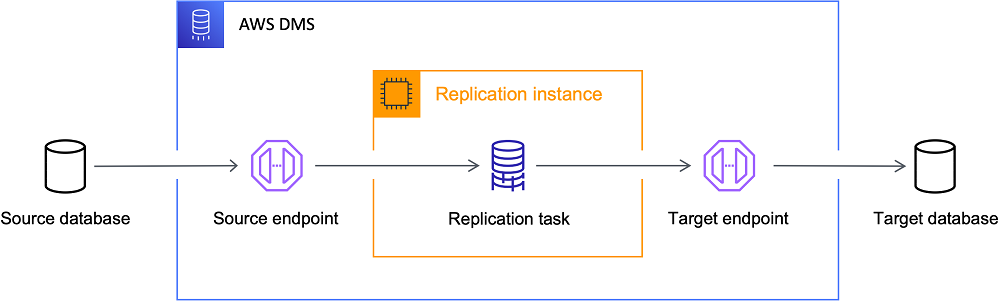
AWS DMS आर्किटेक्चर।

AWS DMS आर्किटेक्चर। इमेज स्रोत: AWS

Debezium

Debezium एक ओपन‑सोर्स CDC प्लेटफ़ॉर्म है जो डेटाबेस परिवर्तनों को कैप्चर करके Apache Kafka जैसे सिस्टम्स में स्ट्रीम करता है। 

व्यक्तिगत रूप से, मुझे Debezium वितरित वातावरणों में, जहाँ अनेक सेवाएँ रियल‑टाइम अपडेट पर निर्भर होती हैं, Kafka में डेटाबेस परिवर्तनों को स्ट्रीम करने के लिए बेहद उपयोगी लगा है। इसकी स्केलेबिलिटी और इंटीग्रेशन क्षमताएँ इसे एक उत्कृष्ट विकल्प बनाती हैं।

किसके लिए सर्वोत्तम: रियल‑टाइम डेटा स्ट्रीमिंग और इवेंट‑ड्रिवन आर्किटेक्चर।
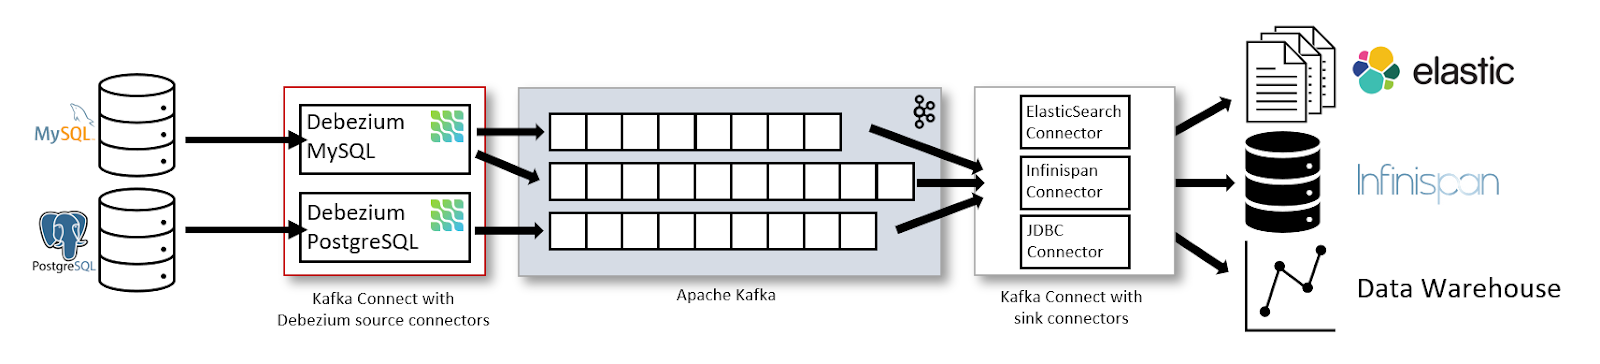
Kafka Connect और Debezium के साथ डेटा स्ट्रीमिंग आर्किटेक्चर।

Kafka Connect और Debezium के साथ डेटा स्ट्रीमिंग आर्किटेक्चर। इमेज स्रोत: Debezium

Apache Kafka

Apache Kafka स्वयं कोई CDC टूल नहीं है, लेकिन Debezium जैसे टूल्स के साथ मिलकर CDC इवेंट्स को प्रोसेस करने की रीढ़ का काम करता है. Kafka विश्वसनीय इवेंट‑ड्रिवन पाइपलाइंस, रियल‑टाइम एनालिटिक्स, और अनेक कंज़्यूमर्स के बीच डेटा सिंक्रोनाइज़ेशन सक्षम करता है।

किसके लिए सर्वोत्तम: CDC डेटा को इवेंट‑ड्रिवन आर्किटेक्चर तक स्ट्रीम करना।

यह दर्शाने के लिए कि CDC इवेंट्स Kafka को कैसे भेजे जा सकते हैं, नीचे दिया गया Python स्निपेट देखें। यह कोड एक Kafka प्रोड्यूसर इनिशियलाइज़ करता है और एक CDC इवेंट (जो orders टेबल पर एक अपडेट ऑपरेशन का प्रतिनिधित्व करता है) को cdc-topic नामक Kafka टॉपिक पर भेजता है:

from kafka import KafkaProducer
import json

# Initialize the Kafka producer with bootstrap servers and a JSON serializer for values.
producer = KafkaProducer(
    bootstrap_servers='localhost:9092',
    value_serializer=lambda v: json.dumps(v).encode('utf-8')
)

# Define a CDC event that includes details of the operation.
cdc_event = {
    "table": "orders",
    "operation": "update",
    "data": {"order_id": 123, "status": "shipped"}
}

# Send the CDC event to the 'cdc-topic' and flush to ensure transmission.
producer.send('cdc-topic', cdc_event)
producer.flush()
print("CDC event sent successfully!")

Talend और Informatica

Talend और Informatica व्यापक ETL प्लेटफ़ॉर्म हैं जो बिल्ट‑इन CDC फ़ंक्शनलिटी प्रदान करते हैं ताकि डेटा परिवर्तनों को कैप्चर और प्रोसेस किया जा सके, जिससे मैनुअल कॉन्फ़िगरेशन घटते हैं। ये विशेष रूप से जटिल डेटा ट्रांसफॉर्मेशन परिदृश्यों में लाभकारी हैं, जहाँ एकीकृत समाधान संचालन को सरल बना सकते हैं।

किसके लिए सर्वोत्तम: एंटरप्राइज़‑ग्रेड ETL समाधान जिनमें बिल्ट‑इन CDC हो।

डेटाबेस‑नेटिव CDC समाधान

कई रिलेशनल डेटाबेस नेटिव CDC फीचर्स प्रदान करते हैं, जिससे बाहरी टूल्स पर निर्भरता कम होती है:

  • PostgreSQL लॉजिकल रिप्लिकेशन: WAL में परिवर्तन कैप्चर करता है और उन्हें सब्सक्राइबर्स तक स्ट्रीम करता है।
  • SQL Server चेंज डेटा कैप्चर (CDC): ट्रांज़ैक्शन लॉग्स का उपयोग करके स्वतः परिवर्तनों को ट्रैक करता है।
  • MySQL बाइनरी लॉग (binlog) रिप्लिकेशन: प्रतिकृति उद्देश्यों के लिए परिवर्तनों को लॉग करता है।

किसके लिए सर्वोत्तम: बाहरी CDC टूल्स पर निर्भरता को न्यूनतम करना।

Google Datastream और Azure Data Factory

क्लाउड प्रदाता भी अपने इकोसिस्टम के लिए CDC समाधान प्रदान करते हैं:

  • Google Datastream: Google Cloud उपयोगकर्ताओं के लिए पूरी तरह प्रबंधित CDC और रिप्लिकेशन सेवा।
  • Azure Data Factory CDC: Azure SQL, CosmosDB, और Synapse Analytics के लिए चेंज ट्रैकिंग और रिप्लिकेशन सक्षम करता है।

किसके लिए सर्वोत्तम: Google Cloud या Microsoft Azure वातावरणों के भीतर CDC।

CDC की चुनौतियाँ और सीमाएँ

जहाँ CDC महत्वपूर्ण लाभ देता है, वहीं एक विश्वसनीय इम्प्लीमेंटेशन के लिए कुछ चुनौतियाँ भी साथ लाता है जिनका प्रबंधन आवश्यक है।

डेटा अखंडता संबंधी मुद्दों का सामना

नेटवर्क बाधाओं, विलंबित ट्रांज़ैक्शंस, या सिस्टम गड़बड़ियों से निपटते समय डेटा अखंडता बनाए रखना चुनौतीपूर्ण हो सकता है। मज़बूत एरर‑हैंडलिंग प्रोटोकॉल और नियमित सामंजस्य (रिकंसिलिएशन) स्रोत और लक्ष्य सिस्टम्स के बीच विसंगतियों को रोकने के लिए बेहद महत्वपूर्ण हैं। प्रारंभिक चरण में इन मुद्दों को संबोधित करना विश्वसनीय डेटा पाइपलाइन बनाए रखने में मदद करता है।

प्रदर्शन ओवरहेड

कुछ CDC विधियाँ—खासकर वे जो ट्रिगर्स या बार‑बार पोलिंग पर निर्भर हैं—स्रोत डेटाबेस पर अतिरिक्त लोड ला सकती हैं। आपके प्रोडक्शन सिस्टम्स की प्रदर्शन सीमाओं के साथ लगभग रियल‑टाइम अपडेट की आवश्यकता के बीच संतुलन स्थापित करना सुचारू संचालन की कुंजी है।

जटिल डेटा ट्रांसफॉर्मेशन प्रबंधन

यद्यपि CDC कच्चे परिवर्तनों को कुशलतापूर्वक कैप्चर करता है, डाउनस्ट्रीम में अतिरिक्त प्रोसेसिंग—जैसे डेटा क्लेंसिंग या ट्रांसफॉर्मेशन—की आवश्यकता हो सकती है। ट्रांसफॉर्मेशन लॉजिक का एकीकरण इस तरह करें कि डिलीवरी में देरी न हो या त्रुटियाँ न आएँ; यह CDC इम्प्लीमेंटेशन में जटिलता जोड़ता है, इसलिए सावधानीपूर्वक योजना आवश्यक है।

CDC लागू करने के सर्वोत्तम अभ्यास

व्यवहार में सिद्धांत उतारने के लिए सर्वोत्तम प्रथाओं का पालन ज़रूरी है। यहाँ मेरे अनुभव से कुछ कारगर सुझाव हैं जिन्होंने मुझे मज़बूत CDC पाइपलाइंस बनाने में मदद की।

उपयुक्त इम्प्लीमेंटेशन विधि चुनें

ऐसी CDC विधि चुनें जो आपके डेटा वॉल्यूम, लेटेंसी आवश्यकताओं और सिस्टम आर्किटेक्चर से मेल खाती हो। उच्च ट्रांज़ैक्शन वाले वातावरण के लिए प्रायः लॉग‑आधारित CDC सर्वोत्तम होता है, जबकि ट्रिगर‑ या पोलिंग‑आधारित विधियाँ छोटे अनुप्रयोगों के लिए अधिक उपयुक्त हो सकती हैं। प्रारंभ में आवश्यकताओं का आकलन समय और संसाधन बचा सकता है।

जॉब्स की निगरानी करें

रियल‑टाइम डैशबोर्ड्स और स्वचालित अलर्ट्स के साथ व्यापक मॉनिटरिंग लागू करें। नियमित लॉग रिव्यू और हेल्थ चेक आवश्यक हैं ताकि हर परिवर्तन सटीकता से कैप्चर हो और किसी भी समस्या का तुरंत समाधान हो सके। 

एक प्रोजेक्ट में, एक मामूली लॉग‑आधारित CDC मिसकन्फ़िगरेशन कई दिनों तक अनदेखा रह गया, जिससे डाउनस्ट्रीम एनालिटिक्स में चुपचाप डेटा लॉस हुआ। Grafana अलर्ट्स लागू करने से मिसिंग अपडेट तुरंत पकड़ में आने लगे और महंगी त्रुटियों से बचाव हुआ।

डेटा गुणवत्ता सुनिश्चित करें

CDC पाइपलाइन के भीतर डेटा वैलिडेशन चेकपॉइंट्स एकीकृत करें ताकि केवल सटीक और सुसंगत परिवर्तन ही प्रसारित हों। 

मेरे अनुभव में, CDC पाइपलाइन में स्वचालित वैलिडेशन चेक्स सेटअप करने से गलत डेटा प्रसार की डीबगिंग में घंटे बच गए। dbt और Apache Airflow जैसे टूल्स ने अनेक डाउनस्ट्रीम सिस्टम्स में स्थिरता लागू करने में अहम भूमिका निभाई है।

डिप्लॉयमेंट से पहले परीक्षण करें

प्रोडक्शन में ले जाने से पहले अपने CDC समाधान का स्टेजिंग वातावरण में भरपूर परीक्षण करें। वास्तविक वर्कलोड्स और फेल्योर परिदृश्यों का सिमुलेशन करें और रोलबैक व टाइम‑ट्रैवल जैसी विशेषताओं का सत्यापन करें ताकि हर स्थिति में सिस्टम अपेक्षित व्यवहार करे। यह कड़े परीक्षण सुचारू प्रोडक्शन रोलआउट के लिए महत्वपूर्ण है।

स्कीमा इवोल्यूशन को रणनीतिक ढंग से संभालें

जैसे‑जैसे आपके डेटासेट विकसित होते हैं, आपका CDC सिस्टम बिना व्यवधान के स्कीमा परिवर्तनों के अनुकूल होना चाहिए। ऐसे टूल्स का उपयोग करें जो स्वतः स्कीमा इवोल्यूशन सपोर्ट करें और उचित वर्शन कंट्रोल बनाए रखें ताकि नए फ़ील्ड्स सहजता से एकीकृत हों। यह रणनीतिक दृष्टिकोण डेटा संरचनाओं में परिवर्तन होने पर अनपेक्षित त्रुटियों और डाउनटाइम से बचाता है।

निष्कर्ष

केवल संशोधित डेटा को सटीकता से कैप्चर करके, CDC सिस्टम लोड को न्यूनतम करता है और रियल‑टाइम एनालिटिक्स तथा स्ट्रीमिंग एप्लिकेशंस को सही ढंग से कार्य करने देता है। चाहे आप डेटा रिप्लिकेशन, सिंक्रोनाइज़ेशन, या ऑडिट लॉगिंग लागू कर रहे हों, उपयुक्त CDC विधि का चयन और सर्वोत्तम प्रथाओं का पालन एक विश्वसनीय और कुशल डेटा पाइपलाइन बनाने की कुंजी है। 

जो लोग अपनी समझ को और गहरा करना चाहते हैं, उनके लिए मैं निम्नलिखित DataCamp पाठ्यक्रमों को देखने की सलाह देता/देती हूँ:

  • Introduction to Data Engineering – मज़बूत डेटा पाइपलाइंस बनाने और विभिन्न डेटा स्रोतों को एकीकृत करने की बुनियादी तकनीकें सीखें।  
  • Big Data Fundamentals with PySpark – बड़े डेटासेट्स को प्रोसेस और विश्लेषित करने के लिए Apache Spark और PySpark के साथ प्रायोगिक अनुभव प्राप्त करें।
  • Data Engineer in Python – Python का उपयोग करके एन्ड‑टू‑एन्ड डेटा पाइपलाइंस बनाएँ, और Apache Kafka जैसे टूल्स के साथ स्ट्रीमिंग डेटा इंटीग्रेशन का व्यावहारिक अनुभव लें।

हैप्पी कोडिंग—और आइए मिलकर मज़बूत, रियल‑टाइम डेटा सिस्टम्स बनाएँ!

FAQs

आधुनिक डेटा आर्किटेक्चर में CDC रियल‑टाइम एनालिटिक्स को कैसे बेहतर बनाता है?

CDC स्रोत डेटाबेस से केवल क्रमिक परिवर्तनों को कैप्चर करके भारी‑भरकम ETL जॉब्स की आवश्यकता को कम करता है। इससे एनालिटिकल डैशबोर्ड्स और स्ट्रीमिंग एप्लिकेशन को हमेशा नवीनतम डेटा उपलब्ध रहता है, लेटेंसी और सिस्टम लोड कम होता है।

पूर्ण डिप्लॉयमेंट से पहले CDC इम्प्लीमेंटेशन का परीक्षण करने के व्यावहारिक कदम क्या हैं?

प्रोडक्शन लोड्स का सिमुलेशन करने के लिए स्टेजिंग वातावरण सेट करें; डेटा अखंडता, लेटेंसी, और एरर‑हैंडलिंग की निगरानी करें; और यदि उपलब्ध हों तो टाइम‑ट्रैवल सुविधाओं का उपयोग करके रोलबैक टेस्ट करें, ताकि रिकवरी प्रक्रियाओं का सत्यापन हो सके।

CDC उपयोग करते समय स्कीमा इवोल्यूशन को कैसे संभालें?

CDC पाइपलाइन में स्कीमा वर्शनिंग और स्वचालित वैलिडेशन स्टेप्स शामिल करें। नियंत्रित वातावरण में स्कीमा परिवर्तनों का परीक्षण करें ताकि बैकवर्ड कम्पैटिबिलिटी सुनिश्चित हो सके, और ऐसे CDC टूल्स का लाभ लें जो स्वतः स्कीमा इवोल्यूशन सपोर्ट करते हों।

CDC पाइपलाइंस के लिए आप किन मॉनिटरिंग टूल्स या प्रैक्टिस की सिफारिश करते हैं?

CDC निष्पादन मेट्रिक्स को ट्रैक करने के लिए (Grafana जैसे टूल्स का उपयोग करके) डैशबोर्ड्स और अलर्टिंग सिस्टम्स को एकीकृत करें। प्रदर्शन बाधाएँ या डेटा गुणवत्ता से जुड़ी समस्याएँ जल्दी पहचानने के लिए नियमित लॉग समीक्षा और स्वचालित हेल्थ चेक्स सहायक होते हैं।

उच्च‑वॉल्यूम, कम‑लेटेंसी वाले वातावरण के लिए कौन‑सी CDC विधि चुननी चाहिए?

ऐसे वातावरणों के लिए लॉग‑आधारित CDC सामान्यतः सर्वोत्तम विकल्प है, क्योंकि यह सीधे डेटाबेस ट्रांज़ैक्शन लॉग्स (WAL) से पढ़ता है और प्रोडक्शन वर्कलोड्स पर प्रभाव को न्यूनतम रखता है, साथ ही लगभग रियल‑टाइम अपडेट प्रदान करता है।


Khalid Abdelaty's photo
Author
Khalid Abdelaty
LinkedIn

मैं एक डेटा इंजीनियर और कम्युनिटी बिल्डर हूँ, जो डेटा पाइपलाइनों, क्लाउड, और AI टूलिंग के साथ काम करता/करती हूँ, साथ ही DataCamp और उभरते डेवलपर्स के लिए व्यावहारिक, असरदार ट्यूटोरियल लिखता/लिखती हूँ।

विषय
डेटा इंजीनियरिंग
डेटा विश्लेषण

इन पाठ्यक्रमों के साथ डेटा इंजीनियरिंग के बारे में और जानें!

कोर्स

Introduction to Data Engineering

4 घंटा
130K
डेटा इंजीनियरिंग की दुनिया को इस संक्षिप्त पाठ्यक्रम में जानें, जिसमें ETL और क्लाउड कंप्यूटिंग जैसे टूल और विषय शामिल हैं।
विवरण देखेंRight Arrow
पाठ्यक्रम शुरू करें

लर्निंग पाथ

पेशेवर डेटा इंजीनियर में Python

40 घंटा
हमारे Professional Data Engineer ट्रैक के साथ आज डेटा इंजीनियरिंग भूमिकाओं में क्रांति ला रहे उन्नत कौशल और अत्याधुनिक टूल्स में गहराई से उतरें।
और देखेंRight Arrow