Cursus
Change Data Capture (CDC) houdt datapijplijnen efficiënt door alleen inserts, updates en deletes vast te leggen in plaats van volledige datasets opnieuw te laden. Dit verkort de verwerkingstijd en verlaagt de systeembelasting.
CDC is ook essentieel voor realtime datastreaming en integreert met platforms zoals Apache Kafka om event‑gedreven architecturen mogelijk te maken.
Laten we in CDC duiken en kijken hoe het je dataprojecten kan verbeteren!
Wat is Change Data Capture (CDC)?
Change Data Capture is een aanpak die alleen de gewijzigde data uit een bronsysteem detecteert, vastlegt en doorstuurt naar downstreamsystemen zoals datawarehouses, dashboards, of streamingtoepassingen.
In plaats van volledige datasets opnieuw te verwerken, richt CDC zich uitsluitend op incrementele wijzigingen, zodat doelsystemen altijd toegang hebben tot de meest actuele data.
In een realtime analytics‑project had ik te maken met flinke rapportagevertragingen door batchupdates. Door over te stappen op een log‑gebaseerde CDC‑oplossing bracht ik de versheidslag van uren terug naar seconden, waardoor het analytics‑dashboard écht realtime werd.
Met deze persoonlijke ervaring als bewijs van de praktische waarde van CDC, gaan we nu verder met de verschillende methoden om CDC te implementeren.
Methoden om Change Data Capture te implementeren
Voordat we in specifieke technieken duiken, is het belangrijk te erkennen dat er geen one‑size‑fits‑all is. Hieronder staan vier veelvoorkomende CDC‑methoden, elk met eigen voordelen en afwegingen.
Log‑gebaseerde CDC
Log‑gebaseerde CDC leest de transactielogs van een database (vaak Write‑Ahead Logs, of WAL) om wijzigingen direct te identificeren zodra ze plaatsvinden. Deze methode is zeer efficiënt omdat ze op laag niveau werkt en wijzigingen vastlegt met minimale verstoring van het productiesysteem.
- Voordelen: Lage systeembelasting en near‑realtime prestaties maken het ideaal voor omgevingen met hoog volume.
- Nadelen: Vereist geprivilegieerde toegang tot transactielogs en is afhankelijk van de juiste logretentie‑instellingen.
In PostgreSQL kun je bijvoorbeeld logische replicatie instellen om wijzigingen vast te leggen vanuit de WAL:
-- Enable logical replication
ALTER SYSTEM SET wal_level = logical;
-- Create a logical replication slot to capture changes
SELECT pg_create_logical_replication_slot('cdc_slot', 'pgoutput');
-- Fetch recent changes from the WAL
SELECT * FROM pg_logical_slot_get_changes('cdc_slot', NULL, NULL);
Deze aanpak stelt een CDC‑tool (zoals Debezium of AWS DMS, waar we later op ingaan) in staat om databasewijzigingen continu naar een downstreamsysteem te streamen zonder geplande queries.
Trigger‑gebaseerde CDC
Trigger‑gebaseerde CDC gebruikt databasetriggers die gekoppeld zijn aan bron‑tabelevents (inserts, updates of deletes) om wijzigingen automatisch vast te leggen zodra ze plaatsvinden. Deze methode is rechttoe rechtaan voor databases die triggers ondersteunen en biedt directe vastlegging; wel kan ze extra belasting toevoegen aan de database en schemawijzigingen bemoeilijken als dit niet zorgvuldig wordt beheerd.
- Voordelen: Eenvoudig te implementeren op databases die triggers ondersteunen en zorgt voor directe vastlegging van wijzigingen.
- Nadelen: Kan extra belasting toevoegen aan de database en schemawijzigingen bemoeilijken als dit niet zorgvuldig wordt beheerd.
Trigger‑gebaseerde CDC biedt directheid, maar mogelijk tegen de prijs van extra overhead, en is daarom het meest geschikt in omgevingen met een gemiddeld transactievolume.
In PostgreSQL kun je een trigger maken om wijzigingen uit een customers-tabel te loggen in een aparte customers_audit-tabel:
-- Create an audit table to store changes
CREATE TABLE customers_audit (
audit_id SERIAL PRIMARY KEY,
operation_type TEXT,
customer_id INT,
customer_name TEXT,
modified_at TIMESTAMP DEFAULT now()
);
-- Create a function to insert change records
CREATE OR REPLACE FUNCTION capture_customer_changes()
RETURNS TRIGGER AS $
BEGIN
IF TG_OP = 'INSERT' THEN
INSERT INTO customers_audit (operation_type, customer_id, customer_name)
VALUES ('INSERT', NEW.id, NEW.name);
ELSIF TG_OP = 'UPDATE' THEN
INSERT INTO customers_audit (operation_type, customer_id, customer_name)
VALUES ('UPDATE', NEW.id, NEW.name);
ELSIF TG_OP = 'DELETE' THEN
INSERT INTO customers_audit (operation_type, customer_id, customer_name)
VALUES ('DELETE', OLD.id, OLD.name);
END IF;
RETURN NULL; -- No need to modify original table data
END;
$ LANGUAGE plpgsql;
-- Attach the trigger to the customers table
CREATE TRIGGER customer_changes_trigger
AFTER INSERT OR UPDATE OR DELETE ON customers
FOR EACH ROW EXECUTE FUNCTION capture_customer_changes();
Deze trigger zorgt ervoor dat elke INSERT, UPDATE of DELETE op de customers-tabel in realtime wordt gelogd in customers_audit.
Polling‑gebaseerde CDC
Polling‑gebaseerde CDC bevraagt periodiek de brondatabase om te kijken of er wijzigingen zijn op basis van een timestamp‑ of versie‑kolom. Hoewel deze methode geen directe toegang tot transactielogs of triggers vereist, kan ze latentie introduceren omdat wijzigingen alleen op vaste intervallen worden gedetecteerd.
- Voordelen: Eenvoudig te implementeren wanneer logtoegang of triggers niet beschikbaar zijn.
- Nadelen: Kan de vastlegging van wijzigingen vertragen en de belasting verhogen als te vaak wordt gepolld.
Deze aanpak werkt goed wanneer realtime toegang tot logs niet beschikbaar is, met als trade‑off een kleine vertraging in het detecteren van wijzigingen.
Stel je een products-tabel voor met een version_number-kolom die bij elke update wordt verhoogd:
SELECT *
FROM products
WHERE version_number > 1050
ORDER BY version_number ASC;
Hier is 1050 het laatst verwerkte versienummer uit de vorige pollingcyclus. Zo worden alleen nieuwe wijzigingen opgehaald zonder te vertrouwen op timestamps, wat robuuster is wanneer systeemtijden onbetrouwbaar zijn.
Timestamp‑gebaseerde CDC
Timestamp‑gebaseerde CDC vertrouwt op een speciale kolom die de laatst gewijzigde tijd voor elk record bijhoudt. Door deze timestamps te vergelijken, identificeert het systeem records die sinds de vorige controle zijn gewijzigd.
Deze methode lijkt op polling‑gebaseerde CDC, maar is meer gestructureerd omdat er een expliciet mechanisme nodig is om wijzigingen te volgen:
- Polling‑gebaseerde CDC is een bredere aanpak die periodiek op wijzigingen bevraagt met elk herkenbaar patroon (timestamps, versienummers of andere indicatoren).
- Timestamp‑gebaseerde CDC is afhankelijk van een timestampkolom die nauwkeurig moet worden bijgehouden in de brondatabase.
Het is eenvoudig te implementeren wanneer de database automatisch timestamps bijwerkt, maar het is afhankelijk van consistente systeemtijden en betrouwbare timestampupdates.
- Voordelen: Eenvoudige aanpak wanneer systemen automatisch timestamps bijwerken.
- Nadelen: Nauwkeurigheid hangt af van consistente kloksynchronisatie en betrouwbare timestampupdates.
Stel dat we een orders-tabel hebben met een last_modified-kolom die wordt bijgewerkt wanneer een rij wordt ingevoegd of gewijzigd. De volgende SQL‑query haalt alle wijzigingen sinds de laatste controle op:
SELECT *
FROM orders
WHERE last_modified > '2025-02-25 12:00:00'
ORDER BY last_modified ASC;
Deze methode werkt goed wanneer de database de timestamp automatisch bijwerkt bij wijziging, bijvoorbeeld met triggers of ingebouwde mechanismen zoals PostgreSQL’s DEFAULT now() of MySQL’s ON UPDATE CURRENT_TIMESTAMP.
Vergelijkingstabel van CDC‑methoden
Hier is een vergelijkingstabel met de belangrijkste verschillen tussen de vier Change Data Capture (CDC)‑methoden:
|
Kenmerk |
Log‑gebaseerde CDC |
Trigger‑gebaseerde CDC |
Polling‑gebaseerde CDC |
Timestamp‑gebaseerde CDC |
|
Werking |
Leest transactielogs van de database (WAL, binlog, etc.) om wijzigingen realtime vast te leggen. |
Gebruikt databasetriggers om wijzigingen in een audit‑tabel te loggen. |
Bevraagt periodiek op wijzigingen met een versienummer of andere criteria. |
Vergelijkt timestamps in een kolom om wijzigingen te detecteren. |
|
Latentie |
Near realtime (lage latentie). |
Direct (triggers worden onmiddellijk uitgevoerd). |
Geplande intervallen (kan vertraging introduceren). |
Afhankelijk van pollfrequentie (lage tot matige latentie). |
|
Systeembelasting |
Laag (vereist geen table scans). |
Hoog (triggers draaien bij elke wijziging). |
Matig (afhankelijk van pollfrequentie). |
Laag tot matig (vertrouwt op timestamps). |
|
Complexiteit implementatie |
Hoog (vereist toegang tot transactielogs en juiste retentie). |
Middel‑hoog (triggers aanmaken en audit‑tabel onderhouden). |
Laag (steunt op eenvoudige SQL‑queries). |
Laag (eenvoudig als timestamps automatisch worden beheerd). |
|
Toegangsvereisten |
Geprivilegieerde toegang tot transactielogs. |
DDL‑toegang vereist om triggers te maken. |
Geen speciale toegang nodig (standaard SQL). |
|
Ondersteunt deletes? |
Ja (vastgelegd via logs). |
Ja (als dit in de audit‑tabel wordt gelogd). |
Extra tracking nodig (bijv. een aparte delete‑tabel). |
Alleen bij soft deletes (deleted_at). |
|
Beste usecase |
Hoogvolume, realtime replicatie waarbij minimale databaselast cruciaal is. |
Kleine tot middelgrote workloads die directe vastlegging nodig hebben. |
Wanneer log‑gebaseerde CDC en triggers niet beschikbaar zijn, maar periodieke updates acceptabel zijn. |
Wanneer timestamps automatisch worden bijgewerkt en frequent pollen haalbaar is. |
|
Gangbare tools |
Debezium, AWS DMS, StreamSets, Striim, HVR |
Database‑native triggers (PostgreSQL, MySQL, SQL Server, Oracle) |
Apache Airflow, ETL‑scripts (Python, SQL) |
ETL‑jobs, batchdatapijplijnen |
Usecases voor Change Data Capture
De methoden begrijpen is maar de helft; zien hoe CDC tastbare waarde levert in praktijksituaties is net zo belangrijk.
Realtime datawarehousing
CDC maakt continue, incrementele updates naar datawarehouses mogelijk door alleen de wijzigingen door te zetten in plaats van complete datasets te herladen. Zo tonen BI‑tools en dashboards altijd de meest actuele data.
Een retailbedrijf kan bijvoorbeeld zijn salesdashboard in near‑realtime bijwerken om opkomende trends en inzichten snel zichtbaar te maken.
Datareplicatie
CDC repliceert data over systemen door ervoor te zorgen dat elke wijziging in het bronsysteem direct wordt gespiegeld in doeldatabases. Dit is vooral nuttig bij datamigraties of bij het onderhouden van back‑ups en replica’s in hybride omgevingen.
Data repliceren van on‑premises systemen naar clouddatabases zoals AWS RDS of Snowflake garandeert bijvoorbeeld consistentie over platforms.
Datasynchronisatie
In gedistribueerde systemen—zoals bij microservices of meerdere applicaties—zorgt CDC ervoor dat elke component met de meest actuele data werkt door wijzigingen realtime te synchroniseren.
Door bijvoorbeeld klantgegevens over verschillende platforms te synchroniseren, blijft de gebruikerservaring overal consistent.
Data‑auditing en monitoring
Tot slot levert CDC gedetailleerde wijzigingslogs die essentieel zijn voor auditdoeleinden. Door bij te houden wie wijzigingen heeft doorgevoerd en wanneer, kunnen teams voldoen aan regelgeving, problemen oplossen en diepgaande forensische analyses uitvoeren.
Financiële instellingen vertrouwen bijvoorbeeld op uitgebreide CDC‑logs om wijzigingen in klantdata te auditen en te voldoen aan strikte datagovernance‑richtlijnen.
Tools om Change Data Capture te implementeren
Na de methoden en usecases bekijken we enkele populaire tools die CDC‑implementaties faciliteren. De juiste keuze hangt af van je usecase—of je nu realtime streaming, cloudmigratie of enterprise ETL‑oplossingen nodig hebt.
AWS Database Migration Service (DMS)
AWS DMS gebruikt log‑gebaseerde CDC om continu data te repliceren van on‑premises systemen naar de AWS‑cloud met minimale downtime, wat het een uitstekende keuze maakt voor migraties. AWS DMS is een robuuste oplossing als je data betrouwbaar naar de cloud wilt verplaatsen.
Beste voor: Cloudmigraties en AWS‑gebaseerde architecturen.
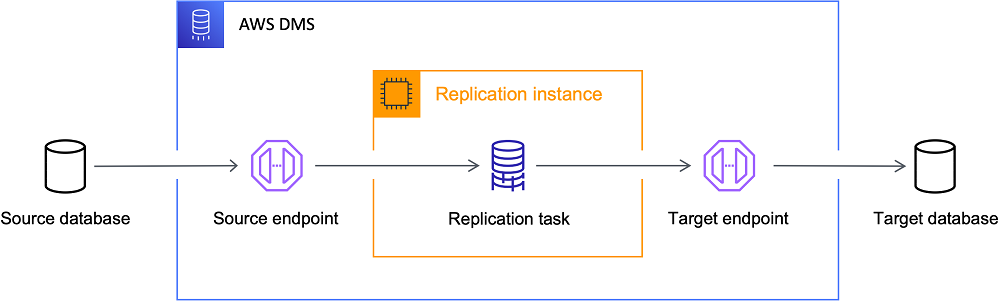
De AWS DMS‑architectuur. Beeldbron: AWS
Debezium
Debezium is een open‑source CDC‑platform dat databasewijzigingen vastlegt en streamt naar systemen zoals Apache Kafka.
Ik heb Debezium persoonlijk erg nuttig gevonden voor het streamen van databasewijzigingen naar Kafka, vooral in gedistribueerde omgevingen waar meerdere services afhankelijk zijn van realtime updates. De schaalbaarheid en integraties maken het een opvallende optie.
Beste voor: Realtime datastreaming en event‑gedreven architecturen.
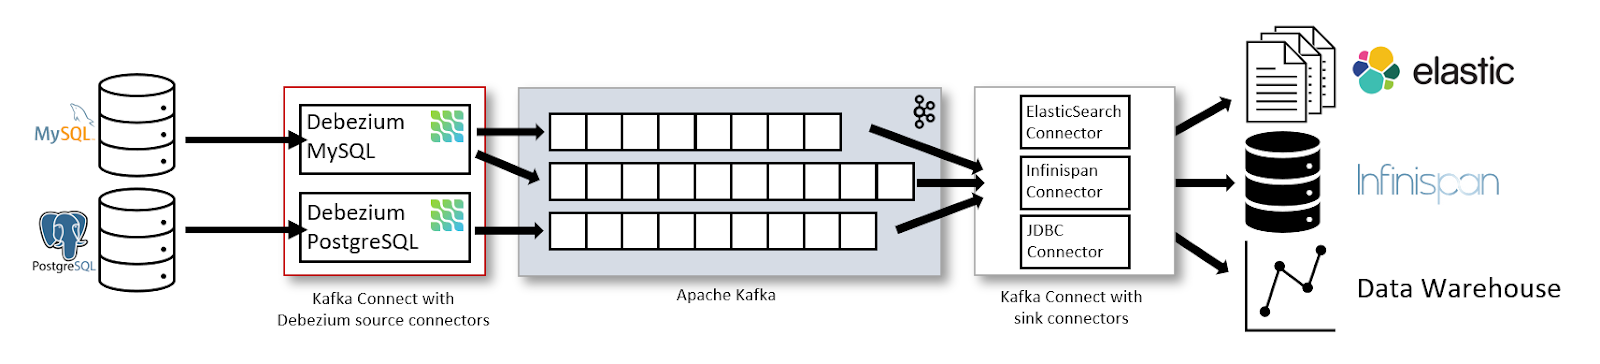
De datastreamingarchitectuur met Kafka Connect en Debezium. Beeldbron: Debezium
Apache Kafka
Apache Kafka is zelf geen CDC‑tool, maar vormt de ruggengraat voor het verwerken van CDC‑events in combinatie met tools zoals Debezium. Kafka maakt betrouwbare event‑gedreven pijplijnen, realtime analytics en datasynchronisatie over meerdere consumers mogelijk.
Beste voor: CDC‑data streamen naar event‑gedreven architecturen.
Om te illustreren hoe CDC‑events naar Kafka kunnen worden gestuurd, zie de volgende Python‑snippet. De code initialiseert een Kafka‑producer en verstuurt een CDC‑event (dat een update‑operatie op een orders-tabel voorstelt) naar een Kafka‑topic met de naam cdc-topic:
from kafka import KafkaProducer
import json
# Initialize the Kafka producer with bootstrap servers and a JSON serializer for values.
producer = KafkaProducer(
bootstrap_servers='localhost:9092',
value_serializer=lambda v: json.dumps(v).encode('utf-8')
)
# Define a CDC event that includes details of the operation.
cdc_event = {
"table": "orders",
"operation": "update",
"data": {"order_id": 123, "status": "shipped"}
}
# Send the CDC event to the 'cdc-topic' and flush to ensure transmission.
producer.send('cdc-topic', cdc_event)
producer.flush()
print("CDC event sent successfully!")
Talend en Informatica
Talend en Informatica zijn uitgebreide ETL‑platformen met ingebouwde CDC‑functionaliteit om dataveranderingen vast te leggen en te verwerken, waardoor handmatige configuratie afneemt. Ze zijn vooral voordelig in complexe datatransformatiescenario’s, waar geïntegreerde oplossingen de operatie kunnen vereenvoudigen.
Beste voor: Enterprise‑grade ETL‑oplossingen met ingebouwde CDC.
Database‑native CDC‑oplossingen
Verschillende relationele databases bieden native CDC‑features, waardoor de noodzaak voor externe tools afneemt:
- PostgreSQL logische replicatie: Legt wijzigingen vast in WAL en streamt ze naar subscribers.
- SQL Server Change Data Capture (CDC): Gebruikt transactielogs om wijzigingen automatisch te volgen.
- MySQL binary log (binlog)‑replicatie: Logt wijzigingen voor replicatiedoeleinden.
Beste voor: Het minimaliseren van afhankelijkheden van externe CDC‑tools.
Google Datastream en Azure Data Factory
Cloudproviders bieden ook CDC‑oplossingen voor hun ecosystemen:
- Google Datastream: Een volledig beheerde CDC‑ en replicatieservice voor Google Cloud‑gebruikers.
- Azure Data Factory CDC: Maakt change tracking en replicatie mogelijk voor Azure SQL, CosmosDB en Synapse Analytics.
Beste voor: CDC binnen Google Cloud‑ of Microsoft Azure‑omgevingen.
Uitdagingen en beperkingen van CDC
Hoewel CDC aanzienlijk voordeel biedt, zijn er ook uitdagingen die moeten worden beheerd voor een betrouwbare implementatie.
Omgaan met dataintegriteitsproblemen
Het waarborgen van dataintegriteit kan lastig zijn bij netwerkonderbrekingen, vertraagde transacties of systeemfouten. Robuuste error‑handling en regelmatige reconciliaties zijn cruciaal om discrepanties tussen bron en doel te voorkomen. Door dit vroeg aan te pakken, blijft je datapijplijn betrouwbaar.
Prestatie‑overhead
Bepaalde CDC‑methoden—met name die met triggers of frequente polling—kunnen extra belasting op brondatabases veroorzaken. De balans vinden tussen near‑realtime updates en de prestatiegrenzen van je productieomgeving is essentieel voor een soepele werking.
Complexe datatransformaties beheren
Hoewel CDC efficiënt ruwe wijzigingen vastlegt, kan aanvullende downstreamverwerking nodig zijn, zoals opschonen of transformatie. Transformatielogica integreren zonder leveringen te vertragen of fouten te introduceren, voegt complexiteit toe aan de CDC‑implementatie, dus zorgvuldige planning is nodig.
Best practices voor het implementeren van CDC
Theorie omzetten in praktijk vraagt om best practices. Hier zijn praktische tips uit mijn ervaring die hielpen bij het bouwen van robuuste CDC‑pijplijnen.
Kies de juiste implementatiemethode
Kies een CDC‑aanpak die aansluit bij je datavolume, latentie‑eisen en systeemarchitectuur. Log‑gebaseerde CDC is meestal optimaal voor omgevingen met veel transacties, terwijl trigger‑ of polling‑gebaseerde methoden geschikter kunnen zijn voor kleinere applicaties. Een vroege evaluatie van je behoeften bespaart later tijd en middelen.
Monitor jobs
Implementeer uitgebreide monitoring met realtime dashboards en geautomatiseerde alerts. Regelmatige logreviews en health‑checks zijn essentieel om te zorgen dat elke wijziging correct wordt vastgelegd en issues snel worden aangepakt.
Een kleine misconfiguratie in log‑gebaseerde CDC bleef in een project dagen onopgemerkt, wat leidde tot stille dataverlies in downstream analytics. Met Grafana‑alerts konden we ontbrekende updates direct detecteren en kostbare fouten voorkomen.
Borg datakwaliteit
Integreer validatie‑checkpoints in de CDC‑pijplijn om ervoor te zorgen dat alleen nauwkeurige en consistente wijzigingen worden doorgezet.
Uit mijn ervaring bleek dat geautomatiseerde validatiechecks in de CDC‑pijplijn me uren debuggen van foutieve datapropagatie bespaarden. Tools zoals dbt en Apache Airflow waren cruciaal om consistentie in meerdere downstreamsystemen af te dwingen.
Test implementaties vóór uitrol
Voordat je je CDC‑oplossing naar productie brengt, test je die grondig in een stagingomgeving. Simuleer real‑world workloads en falende scenario’s en valideer functies zoals rollback en time travel, zodat het systeem zich onder alle omstandigheden naar verwachting gedraagt. Deze rigoureuze tests zijn belangrijk voor een soepele productierol‑out.
Ga strategisch om met schema‑evolutie
Je CDC‑systeem moet zich zonder verstoring kunnen aanpassen aan schemawijzigingen naarmate je datasets evolueren. Gebruik tools die automatische schema‑evolutie ondersteunen en hanteer goede versiecontrole, zodat nieuwe velden soepel worden geïntegreerd. Zo voorkom je onverwachte fouten en downtime bij veranderende datastructuren.
Conclusie
Door alleen de gewijzigde data precies vast te leggen, minimaliseert CDC de systeembelasting en maakt het realtime analytics en streamingtoepassingen echt mogelijk. Of je nu replicatie, synchronisatie of auditlogging implementeert: de juiste CDC‑methode kiezen en best practices volgen is de sleutel tot een betrouwbare en efficiënte datapijplijn.
Voor wie zich verder wil verdiepen, raad ik de volgende DataCamp‑cursussen aan:
- Introduction to Data Engineering – Leer fundamentele technieken om robuuste datapijplijnen te bouwen en diverse databronnen te integreren.
- Big Data Fundamentals with PySpark – Doe praktijkervaring op met Apache Spark en PySpark om grote datasets te verwerken en te analyseren.
- Data Engineer in Python – Bouw end‑to‑end datapijplijnen met Python, met praktische ervaring met tools zoals Apache Kafka voor streamingdataintegratie.
Happy coding—en op naar robuuste, realtime datasystemen!
FAQs
Hoe verbetert CDC realtime analytics in moderne data‑architecturen?
CDC minimaliseert de noodzaak voor bulk‑ETL‑jobs door alleen incrementele wijzigingen uit brondatabases vast te leggen. Hierdoor hebben analysetools en streamingapps altijd toegang tot de meest recente data, met minder latentie en lagere systeembelasting.
Welke praktische stappen kun je nemen om een CDC‑implementatie te testen vóór volledige uitrol?
Richt een stagingomgeving in om productielasten te simuleren; monitor dataintegriteit, latentie en foutafhandeling; en voer rollback‑tests uit met time‑travelfuncties (indien beschikbaar) om herstelprocedures te valideren.
Hoe kan ik omgaan met schema‑evolutie bij het gebruik van CDC?
Neem schemaversiebeheer en geautomatiseerde validatiestappen op in de CDC‑pijplijn. Test schemawijzigingen in een gecontroleerde omgeving om achterwaartse compatibiliteit te garanderen en gebruik CDC‑tools die automatische schema‑evolutie ondersteunen.
Welke monitoringtools of -praktijken raad je aan voor CDC‑pijplijnen?
Integreer dashboards (met tools zoals Grafana) en alerteringssystemen om CDC‑metriek te volgen. Regelmatige logreviews en geautomatiseerde health‑checks helpen prestatieknelpunten of datakwaliteitsproblemen vroegtijdig te detecteren.
Welke CDC‑methode kies je voor een omgeving met hoog volume en lage latentie?
Log‑gebaseerde CDC is over het algemeen de beste optie voor zulke omgevingen, omdat het direct leest uit transactielogs (WAL) en de impact op productie‑workloads minimaliseert, met near‑realtime updates.
Ik ben een data-engineer en communitybouwer die werkt aan datapijplijnen, cloud en AI-tools, en tegelijkertijd praktische, impactvolle tutorials schrijft voor DataCamp en beginnende developers.


