
Corso
Gestione responsabile dei dati per l'AI
1 ore
11.1K
Pratica and corso your progress.
Continua Con GoogleLa data federation è una tecnica di integrazione dei dati che fornisce una vista unificata dei dati provenienti da più fonti senza consolidarli fisicamente. Immaginala come un meccanismo sofisticato che ti consente di accedere e interrogare in tempo reale dati distribuiti su vari sistemi come se fossero tutti archiviati in un'unica posizione.
Molte organizzazioni gestiscono enormi quantità di dati provenienti da fonti eterogenee. Per prendere decisioni informate è importante poter accedere e analizzare questi dati in tempo reale senza la seccatura della duplicazione. La data federation lo rende possibile.
La data federation viene utilizzata anche in alcune architetture dati per consolidare i dati, come nelle data fabric (leggi di più in questo articolo su che cos'è una data fabric).
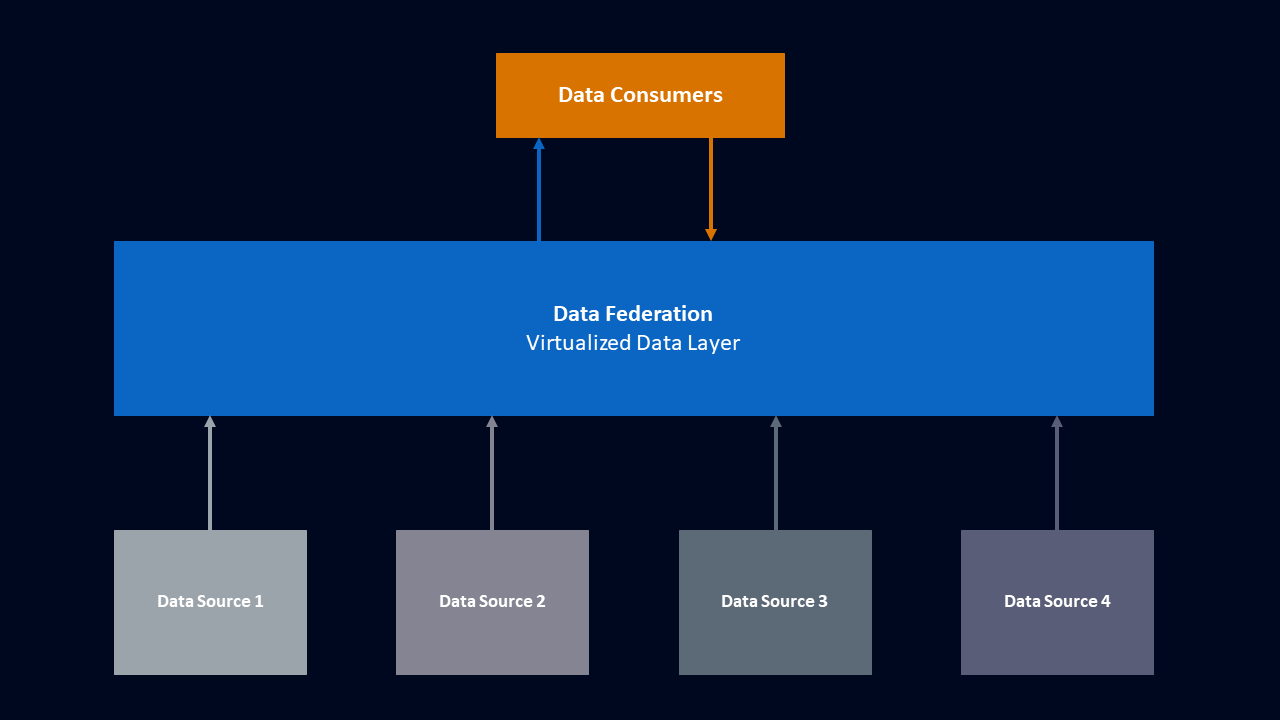
Il grafico sopra è una vista semplificata di una data federation. La data federation virtualizza e aggrega i dati da molte fonti diverse con cui gli utilizzatori dei dati possono interagire.
Una data federation si basa su diversi principi fondamentali. Vediamone alcuni.
Invece di ricollocare fisicamente i dati, la data federation li mantiene nella loro posizione originale e li rende accessibili tramite un livello virtuale. Questo approccio elimina la necessità di duplicare i dati garantendo al contempo l'accesso in tempo reale alle informazioni più aggiornate. Virtualizzando l'accesso ai dati, le organizzazioni possono mantenere l'integrità e la sicurezza dei dati nella loro posizione originale beneficiando di una vista unificata.
Gli utenti interagiscono con un'unica interfaccia o un unico linguaggio di interrogazione, semplificando l'accesso ai dati da più fonti. Questo accesso unificato snellisce il recupero dei dati. Questo processo consente ad analisti, data scientist e altri stakeholder di interrogare e analizzare facilmente i dati senza dover affrontare le complessità di ciascuna fonte.
Uno schema è un blueprint che definisce come sono organizzati i dati all'interno di un database. Le fonti dati spesso hanno schemi diversi, ovvero organizzano ed etichettano i dati in modi differenti. La mappatura degli schemi consiste nell'allineare questi schemi per creare una vista dei dati coerente.
Per esempio, una fonte dati potrebbe usare "CustomerID" per riferirsi all'identificativo del cliente, mentre un'altra potrebbe usare "CustID". La mappatura degli schemi traduce queste etichette diverse perché siano comprese come la stessa entità.
Armonizzando i diversi schemi, gli strumenti di data federation garantiscono che i dati da fonti eterogenee possano integrarsi senza soluzione di continuità. Questo fornisce un modello dati coerente e affidabile su cui gli utenti possono contare per analisi e report accurati.
La data federation privilegia l'elaborazione on-demand. Le query vengono eseguite in tempo reale tra le fonti federate, minimizzando la duplicazione e garantendo l'accesso ai dati più aggiornati. Questa capacità di elaborazione dinamica è cruciale per decisioni e analisi tempestive. Elaborando i dati su richiesta, la data federation supporta un processo decisionale agile e informato.
Ora che sappiamo cos'è una data federation, vediamo come funziona.
La data federation integra senza attriti dati provenienti da fonti eterogenee. Al suo centro c'è un'architettura strutturata progettata per facilitare questa integrazione in modo efficiente. Questa architettura è composta da tre parti principali:
Le fonti dati possono essere viste come isole, ognuna con informazioni preziose. Queste fonti spaziano da dati strutturati in database a dati non strutturati in storage cloud e flussi in tempo reale. La data federation integra queste fonti eterogenee, creando una vista coesa del panorama dei dati.
Il livello di federazione fornisce un'interfaccia unificata per accedere e interrogare i dati. Traduce le query degli utenti in comandi che ogni fonte può comprendere, facilitando l'accesso e l'elaborazione in tempo reale. Questo livello è cruciale per mantenere l'integrità dei dati, garantire un recupero efficiente e offrire una vista coerente su tutte le fonti.
Possiamo pensare a questo livello di federazione come a un live streaming di ciascuna isola di dati. Consente ai consumatori di dati di vedere e utilizzare i dati su ogni isola, senza spostarli o copiarli.
Varie applicazioni e strumenti, come piattaforme di business intelligence, ambienti di data science e sistemi operativi, interagiscono con i dati federati tramite il livello di federazione. Attraverso questi strumenti, analisti, data scientist e altri consumatori possono utilizzare i dati. Questi utilizzatori possono quindi sfruttare i dati integrati per analisi, report e decisioni.
Quando inviamo una query a un sistema federato, questa arriva prima al livello di federazione. Pensa al livello di federazione come a un traduttore intelligente. Prende la nostra query principale e la suddivide in sottoquery più piccole. Ogni sottoquery è personalizzata per recuperare i dati dalle diverse fonti in cui sono archiviati, come database o storage cloud.
Queste sottoquery vengono quindi inviate in tempo reale alle varie fonti. Ogni fonte elabora la propria parte della query e restituisce i risultati. Il livello di federazione raccoglie poi tutti questi risultati e li combina in un unico risultato aggregato.
Questo processo snello ci consente di accedere e analizzare dati provenienti da più fonti come se fossero un unico dataset unificato. In questo modo diventa più semplice raccogliere dati in tutta l'organizzazione.
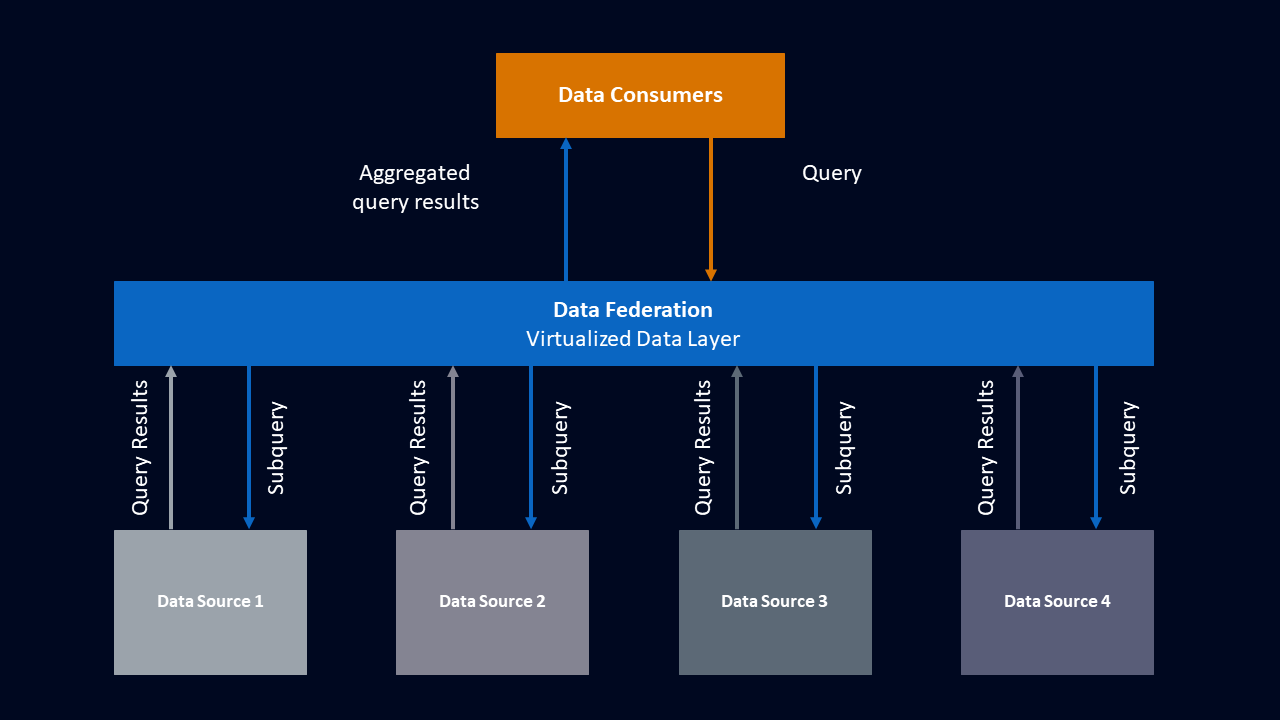
Il grafico sopra è una vista semplificata di questo processo. Un consumatore di dati interroga la data federation. Quest'ultima scompone la query in una serie di sottoquery e le invia alla fonte appropriata. Ogni fonte restituisce i propri risultati, che la data federation poi aggrega per trasmetterli al consumatore.
La data federation offre numerosi vantaggi per le organizzazioni con panorami dati complessi.
Riducendo al minimo le copie dei dati, la federazione abbassa i costi di archiviazione e limita il rischio di incoerenze tra i dataset. Questo approccio snello ottimizza l'allocazione delle risorse e migliora l'integrità dei dati.
La data federation semplifica anche l'accesso ai dati fornendo un unico punto da cui interrogare i dati di tutta l'organizzazione. Questo punto di accesso centralizzato snellisce il recupero e l'analisi. La natura in tempo reale della data federation assicura che gli utenti abbiano accesso ai dati più aggiornati su tutte le fonti federate, elemento fondamentale per decisioni tempestive.
La data federation snellisce gli sforzi di integrazione eliminando la necessità di complessi processi ETL (extract, transform, load) tipicamente associati al consolidamento dei dati. Questo accelera il ritmo dell'integrazione e riduce il potenziale di errore.
L'intrinseca flessibilità della data federation consente alle organizzazioni di aggiungere o rimuovere facilmente fonti dati secondo necessità, senza interrompere applicazioni o flussi di lavoro esistenti. Questa flessibilità permette di adattarsi rapidamente alle esigenze in evoluzione senza essere vincolati da architetture rigide.
Pur offrendo numerosi vantaggi, la data federation presenta anche diverse sfide che le organizzazioni devono affrontare.
Problemi di performance possono sorgere a causa della complessità delle query su più fonti. Gli sforzi di ottimizzazione possono aiutare a garantire un recupero ed elaborazione efficienti. È importante investire in un'infrastruttura robusta e utilizzare tecniche di ottimizzazione delle query. Queste possono mitigare colli di bottiglia prestazionali e mantenere reattività nell'accesso e nell'analisi dei dati.
Un'altra sfida significativa è la complessità degli schemi. Mappare schemi provenienti da fonti diverse può essere impegnativo. Le strutture eterogenee delle fonti richiedono strumenti e tecniche sofisticati per armonizzare gli schemi e garantire coerenza nei dati federati. I professionisti dei dati possono utilizzare strategie di modellazione e mappatura degli schemi per superare queste difficoltà, creando una vista unificata che rifletta accuratamente la semantica sottostante.
Per saperne di più sulla mappatura degli schemi, ti suggerisco di consultare questo corso di Database Design.
La data governance può essere una sfida con i dati federati. Le organizzazioni devono stabilire e applicare policy per qualità, sicurezza e privacy dei dati su tutte le fonti federate. È importante implementare processi di governance, come il tracciamento della data lineage, i controlli di accesso e le misure di privacy. Questi aiutano a mitigare i rischi e a mantenere l'integrità dei dati federati.
Per ulteriori informazioni sulla data governance, ascolta Making Data Governance Fun e How Data Leaders Can Make Data Governance a Priority. Questa cheat sheet sulla data governance è anche una buona risorsa.
La data federation è utile a tutti i livelli di un'organizzazione.
La data federation consente agli analisti di creare report e dashboard completi che aggregano dati da diversi reparti o sistemi. Fornendo una vista unificata delle informazioni, le organizzazioni ottengono insight preziosi sulle proprie operazioni, abilitando decisioni informate e una pianificazione strategica.
Con un accesso semplice a fonti eterogenee per l'addestramento e la validazione dei modelli, i data scientist possono sfruttare tutto il patrimonio informativo disponibile in azienda. Questi dati aggregati possono migliorare l'accuratezza e la robustezza dei modelli, potenziando le capacità predittive. La data federation libera anche tempo per quei data scientist che altrimenti dovrebbero costruire pipeline complesse per alimentare i loro modelli.
Aggregando flussi di dati da fonti eterogenee, le organizzazioni ottengono una visione olistica delle operazioni, individuano colli di bottiglia e ottimizzano i workflow. Questo migliora l'efficienza complessiva. La visibilità in tempo reale dei dati consente inoltre ai decisori di reagire rapidamente a condizioni in cambiamento.
La data federation è utile quando gli auditor richiedono accesso a una vista completa dei tuoi dati attraverso varie fonti. Fornendo una piattaforma unificata per accedere e analizzare i dati, può facilitare la conformità normativa e lo svolgimento degli audit. La data federation dovrebbe essere affiancata da data lineage e documentazione adeguata per rendere più semplici le verifiche di conformità.
Dai un'occhiata a Che cos'è la data lineage e a Data Governance Concepts per maggiori informazioni.
La data federation viene talvolta confusa con il data warehousing. Tuttavia, esistono differenze importanti tra i due approcci.
La data federation si basa sul principio della virtualizzazione: i dati restano nelle loro posizioni originali e sono accessibili in tempo reale tramite un livello virtuale. Questo consente di accedere ai dati più aggiornati senza duplicazione, riduce i costi di storage e limita le incoerenze tra i dataset.
Il data warehousing, invece, concentra i dati in un repository centralizzato. Questo approccio è adatto all'archiviazione di dati storici, offrendo una vista completa delle tendenze passate. Tuttavia, il data warehousing richiede tipicamente processi ETL estesi per consolidare i dati da varie fonti nel warehouse.
Puoi saperne di più sui data warehouse in questo corso introduttivo su Data Warehousing Concepts o in questo tutorial su Come scegliere la giusta soluzione di cloud data warehouse.
Data federation e data warehousing offrono approcci diversi all'integrazione dei dati. Ciascuno ha punti di forza e limiti.
La data federation eccelle nel fornire accesso in tempo reale a dati aggiornati riducendo al minimo la duplicazione. È ideale per ambienti dinamici e agili.
Il data warehousing è più adatto all'archiviazione e all'analisi di dati storici. Può richiedere processi ETL più estesi e manca della flessibilità offerta dalla data federation.
Quando scegli tra data federation e data warehousing, considera il caso d'uso specifico, il volume dei dati e la necessità di analisi in tempo reale rispetto a quelle storiche.
A seconda del tuo panorama dati, implementare una data federation può essere una sfida. Ma con un'attenta pianificazione, la scelta degli strumenti adeguati e la considerazione dei requisiti della nostra organizzazione, è un compito gestibile che darà i suoi frutti. Ecco alcuni passaggi da considerare in qualsiasi implementazione.
Dobbiamo iniziare valutando a fondo l'attuale panorama dati della nostra organizzazione. Identifica le fonti presenti tra sistemi, database e applicazioni. Scopri quali tipi di dati sono archiviati in ciascuna fonte e con quale frequenza vengono aggiornati. Questo aiuterà a garantire che la nostra soluzione di data federation possa supportare l'accesso in tempo reale ai dati più aggiornati.
Come per qualsiasi progetto, è importante definire chiaramente gli obiettivi. Delinea i casi d'uso e i requisiti per la data federation all'interno dell'organizzazione. Determina gli obiettivi di business che intendi raggiungere tramite la data federation: ad esempio migliorare l'accessibilità ai dati, snellire i processi di integrazione o abilitare analytics in tempo reale. Identifica gli stakeholder chiave e coinvolgili in questa fase per assicurarti che la soluzione risponda anche alle loro esigenze.
Scegli gli strumenti e le tecnologie adeguati in base ai requisiti dell'organizzazione e ai vincoli di budget. Considera fattori come le capacità di virtualizzazione dei dati, la scalabilità, la facilità d'integrazione con i sistemi esistenti e il supporto per varie fonti. Valuta sia opzioni commerciali sia open-source per trovare la soluzione migliore alle nostre esigenze. Di seguito una tabella con alcuni strumenti popolari usati nella data federation.
|
Strumento |
Funzionalità |
Modello di licenza |
|
Accesso ai dati in tempo reale, mappatura degli schemi, ottimizzazione delle query |
A pagamento |
|
|
Flessibile ed estensibile, soluzioni personalizzate di data federation |
Open source |
|
|
Interrogare i dati archiviati in Amazon S3 usando SQL standard |
A pagamento |
Progetta una federazione in linea con requisiti e casi d'uso dell'organizzazione. Determina il posizionamento del livello di federazione nell'infrastruttura esistente e definisci i punti di integrazione con fonti e consumatori di dati. Considera sicurezza, ottimizzazione delle performance e scalabilità per assicurare che la federazione possa supportare sia le esigenze attuali sia quelle future.
Una volta configurata la data federation e stabilite le connessioni alle fonti, è importante verificarne il corretto funzionamento. Metti alla prova la soluzione in modo approfondito per individuare eventuali problemi o colli di bottiglia prestazionali e affina l'implementazione secondo necessità.
Distribuisci la soluzione di data federation in produzione e monitora prestazioni e affidabilità. Stabilisci meccanismi di monitoraggio e alerting per rilevare e risolvere proattivamente eventuali problemi. Ottimizza continuamente l'architettura di federazione e i processi di integrazione per mantenere l'efficacia della soluzione in linea con le esigenze di business in evoluzione.
La data federation offre vantaggi significativi alle organizzazioni che vogliono sbloccare il valore di dati dispersi in sistemi diversi. Fornendo una vista virtualizzata e unificata dei dati provenienti da più fonti, migliora l'accesso, riduce le ridondanze e semplifica gli sforzi di integrazione.
Approfondisci la gestione dei dati con Un'introduzione alle data pipeline per aspiranti professionisti dei dati. Consiglio anche questo corso su Responsible AI Data Management.
Impara la gestione dei dati con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



