
{count, plural, one {Cursus} other {Cursussen}}
Verantwoord AI-gegevensbeheer
{hours} uur
11K
Datafederatie is een data-integratietechniek die een uniforme weergave biedt van data uit meerdere bronnen zonder deze fysiek te consolideren. Zie het als een geavanceerd mechanisme waarmee je data uit verschillende systemen in realtime kunt benaderen en bevragen, alsof alles op één locatie staat.
Veel organisaties werken met grote hoeveelheden data uit uiteenlopende bronnen. Voor goed onderbouwde beslissingen is het belangrijk om deze data in realtime te kunnen benaderen en analyseren, zonder gedoe met dataduplicatie. Datafederatie maakt dit mogelijk.
Datafederatie wordt in sommige data-architecturen ook gebruikt om data te consolideren, zoals in data fabrics (lees meer in dit artikel over wat een data fabric is).
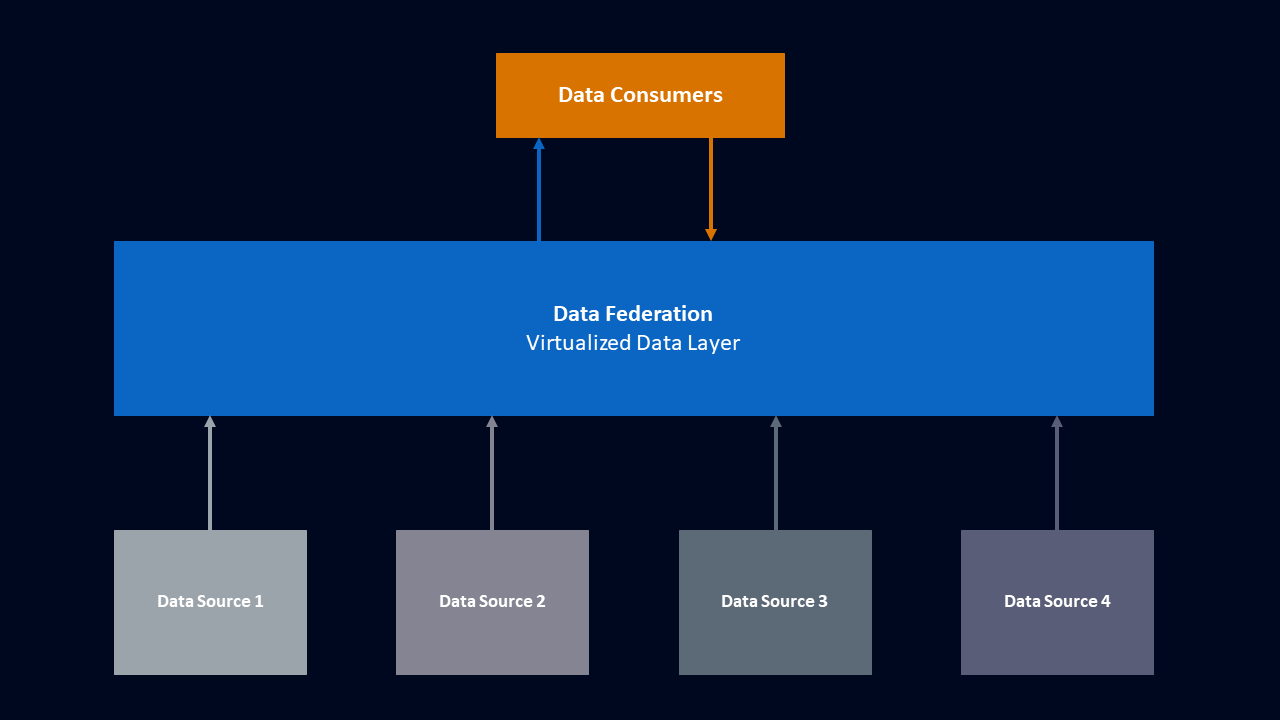
De bovenstaande afbeelding is een vereenvoudigde weergave van een datafederatie. De datafederatie virtualiseert en aggregeert data uit veel verschillende bronnen zodat dataconsumenten ermee kunnen werken.
Een datafederatie werkt volgens meerdere kernprincipes. Laten we er een paar doornemen.
In plaats van data fysiek te verplaatsen, blijft datafederatie bij de oorspronkelijke bron en wordt deze toegankelijk gemaakt via een virtuele laag. Deze aanpak elimineert de noodzaak van dataduplicatie en biedt tegelijk realtime toegang tot de meest actuele informatie. Door data-toegang te virtualiseren behouden organisaties de integriteit en veiligheid van hun data op de oorspronkelijke locatie, terwijl ze profiteren van een uniforme weergave.
Gebruikers werken met één interface of querytaal, waardoor het eenvoudiger wordt om data uit meerdere bronnen te benaderen. Deze uniforme toegang stroomlijnt het ophalen van data. Zo kunnen analisten, data scientists en andere stakeholders data eenvoudig bevragen en analyseren zonder de complexiteit van elke afzonderlijke databron te hoeven doorgronden.
Een schema is een blauwdruk die definieert hoe data in een database is georganiseerd. Databronnen hebben vaak verschillende schema’s, wat betekent dat ze hun data anders organiseren en labelen. Schematoewijzing houdt in dat deze schema’s op elkaar worden afgestemd om een consistente datakweergave te creëren.
Zo kan de ene bron "CustomerID" gebruiken voor een klant-id, terwijl een andere "CustID" hanteert. Schematoewijzing vertaalt deze verschillende labels zodat ze als dezelfde entiteit worden begrepen.
Door de verschillende schema’s te harmoniseren zorgen datafederatietools ervoor dat data uit diverse bronnen naadloos geïntegreerd kan worden. Dit levert een consistent en betrouwbaar datamodel op dat gebruikers kunnen vertrouwen voor nauwkeurige analyses en rapportages.
Datafederatie legt de nadruk op on-demand verwerking. Queries worden in realtime uitgevoerd over gefedereerde bronnen, wat dataduplicatie minimaliseert en ervoor zorgt dat gebruikers toegang hebben tot de meest actuele data. Deze dynamische verwerkingscapaciteit is cruciaal voor tijdige besluitvorming en analyse. Door data on-demand te verwerken ondersteunt datafederatie wendbare en goed geïnformeerde beslissingen.
Nu we weten wat een datafederatie is, kijken we hoe het werkt.
Datafederatie integreert naadloos data uit uiteenlopende bronnen. De kern wordt gevormd door een gestructureerde architectuur die deze integratie efficiënt faciliteert. Deze architectuur bestaat uit drie hoofdonderdelen:
Je kunt databronnen zien als eilanden, elk met waardevolle informatie. Deze bronnen variëren van gestructureerde data in databases tot ongestructureerde data in cloudopslag en realtime datastromen. Datafederatie integreert deze diverse bronnen en creëert zo een samenhangend beeld van het datalandschap.
De federatielaag biedt een uniforme interface voor het benaderen en bevragen van data. Ze vertaalt gebruikersqueries naar opdrachten die elke databron kan begrijpen, waardoor realtime toegang en verwerking mogelijk worden. Deze laag is cruciaal om dataintegriteit te waarborgen, efficiënt data op te halen en een consistente datakweergave over alle bronnen te bieden.
Je kunt deze federatielaag zien als een live videostream van elk data-eiland. Het stelt dataconsumenten in staat om de data op elk eiland te zien en te gebruiken, zonder deze te verplaatsen of te kopiëren.
Verschillende applicaties en tools, zoals business intelligence-platforms, data science-omgevingen en operationele systemen, werken via de federatielaag met de gefedereerde data. Via deze tools kunnen data-analisten, data scientists en andere dataconsumenten de data gebruiken. Zij kunnen de geïntegreerde data vervolgens inzetten voor analyse, rapportage en besluitvorming.
Wanneer we een query indienen bij een gefedereerd systeem, gaat deze eerst naar de federatielaag. Zie de federatielaag als een slimme vertaler. Ze neemt onze hoofdquery en splitst die op in kleinere subqueries. Elke subquery wordt afgestemd om data op te halen uit de verschillende bronnen waar die informatie is opgeslagen, zoals databases of cloudopslag.
Deze subqueries worden vervolgens in realtime naar de diverse databronnen gestuurd. Elke bron verwerkt zijn deel van de query en stuurt de resultaten terug. De federatielaag verzamelt al deze resultaten en voegt ze samen tot één geaggregeerd resultaat.
Dit gestroomlijnde proces stelt ons in staat om data uit meerdere bronnen te benaderen en te analyseren alsof het één uniforme dataset is. Zo wordt het eenvoudiger om data uit de hele organisatie te verzamelen.
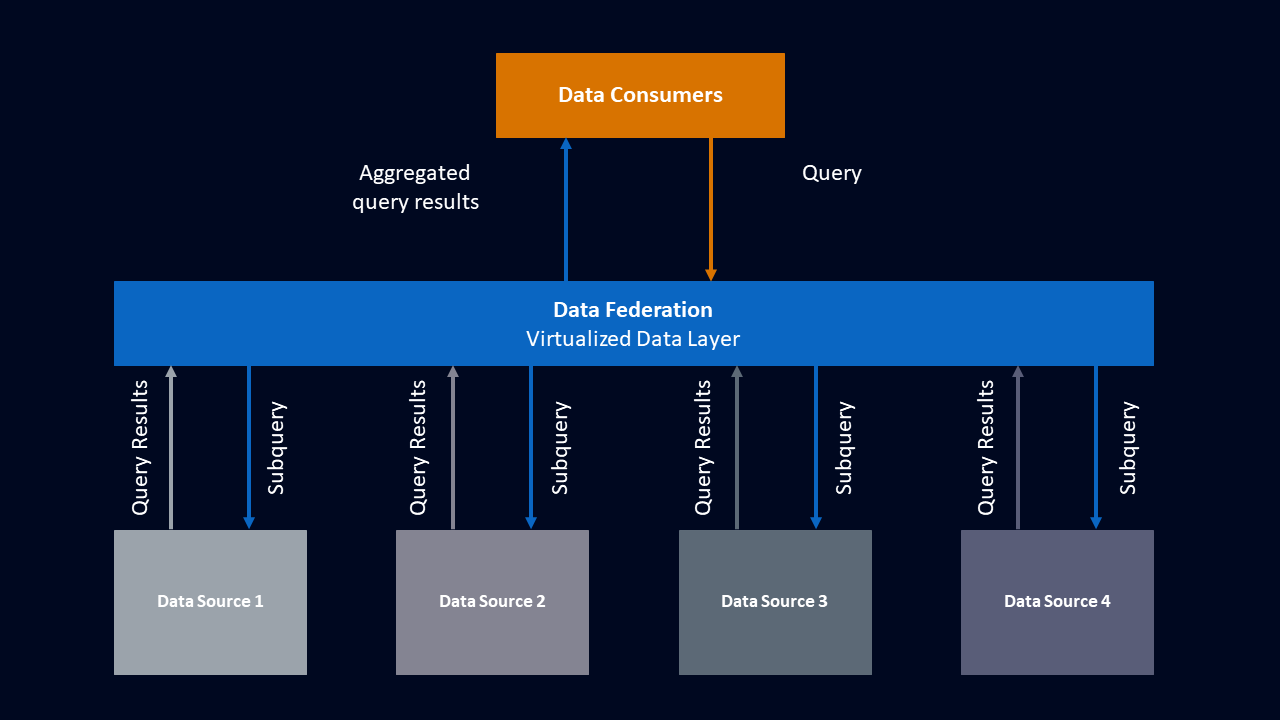
De bovenstaande afbeelding is een vereenvoudigde weergave van dit proces. Een dataconsument bevraagt de datafederatie. Die splitst de query op in een reeks subqueries en stuurt ze naar de juiste databron. Elke bron stuurt zijn resultaten terug, die de datafederatie vervolgens aggregeert en teruggeeft aan de dataconsument.
Datafederatie biedt verschillende belangrijke voordelen voor organisaties met complexe datalandschappen.
Door het aantal kopieën van data te minimaliseren, verlaagt federatie de opslagkosten en vermindert het de kans op inconsistenties tussen datasets. Deze gestroomlijnde aanpak optimaliseert de inzet van resources en verbetert de dataintegriteit.
Datafederatie vereenvoudigt ook de data-toegang door één centrale plek te bieden om data uit de hele organisatie te bevragen. Dit centrale toegangspunt stroomlijnt het ophalen en analyseren van data. Het realtime karakter van datafederatie zorgt ervoor dat gebruikers toegang hebben tot de meest actuele data over alle gefedereerde bronnen, wat belangrijk is voor tijdige besluitvorming.
Datafederatie stroomlijnt dataintegratie door de noodzaak weg te nemen van complexe ETL-processen (extract, transform, load) die traditioneel bij dataconsolidatie horen. Dit versnelt het integratieproces en verkleint de kans op fouten.
De inherente flexibiliteit van datafederatie maakt het voor organisaties eenvoudig om databronnen toe te voegen of te verwijderen zonder bestaande applicaties of workflows te verstoren. Deze flexibiliteit stelt organisaties in staat snel in te spelen op veranderende databehoeften zonder te worden belemmerd door starre data-architecturen.
Hoewel het veel voordelen biedt, kent datafederatie ook enkele uitdagingen waar organisaties mee aan de slag moeten.
Prestatieproblemen kunnen ontstaan door de complexiteit van queries over meerdere bronnen. Optimalisatie-inspanningen kunnen helpen om data efficiënt op te halen en te verwerken. Het is belangrijk te investeren in robuuste infrastructuur en technieken voor queryoptimalisatie. Deze kunnen prestatieknelpunten verminderen en de responsiviteit bij data-toegang en -analyse behouden.
Een andere belangrijke uitdaging is schemacomplexiteit. Het mappen van schema’s uit diverse bronnen kan ontmoedigend zijn. De uiteenlopende structuren van databronnen vereisen geavanceerde tools en technieken om schema’s te harmoniseren en consistentie binnen de gefedereerde data te waarborgen. Dataprofessionals kunnen datamodellering en strategieën voor schematoewijzing inzetten om deze uitdagingen te overwinnen. Zo creëren we een uniforme weergave van de data die de onderliggende semantiek nauwkeurig weergeeft.
Wil je meer leren over schematoewijzing, bekijk dan deze Database Design-cursus.
Data governance kan een uitdaging zijn bij gefedereerde data. Organisaties moeten beleid opstellen en handhaven voor datakwaliteit, beveiliging en privacy over gefedereerde bronnen heen. Het is belangrijk om processen voor data governance te implementeren, zoals data lineage-tracking, toegangscontroles en privacymaatregelen. Deze helpen risico’s te beperken en de integriteit van gefedereerde data te behouden.
Voor meer informatie over data governance, bekijk Making Data Governance Fun en How Data Leaders Can Make Data Governance a Priority. Deze cheat sheet data governance is ook een goede bron.
Datafederatie is nuttig op alle niveaus in een organisatie.
Datafederatie stelt analisten in staat om uitgebreide rapporten en dashboards te maken die data uit verschillende afdelingen of systemen aggregeren. Door een uniforme weergave van informatie krijgen organisaties waardevolle inzichten in hun operaties, wat geïnformeerde besluitvorming en strategische planning mogelijk maakt.
Met eenvoudige toegang tot diverse databronnen voor modeltraining en -validatie kunnen data scientists het volledige spectrum aan beschikbare informatie in hun organisatie benutten. Deze geaggregeerde data kan de nauwkeurigheid en robuustheid van datamodellen verbeteren, wat de voorspellende mogelijkheden vergroot. Datafederatie bespaart bovendien tijd voor data scientists die anders complexe datapijplijnen zouden moeten bouwen om hun modellen te voeden.
Door datastromen uit uiteenlopende bronnen te aggregeren, krijgen organisaties een holistisch beeld van hun operaties, identificeren ze knelpunten en optimaliseren ze workflows. Dit verbetert de algehele efficiëntie van de organisatie. De realtime zichtbaarheid van de data stelt besluitvormers bovendien in staat om snel te reageren op veranderende omstandigheden.
Datafederatie is behulpzaam wanneer auditors toegang nodig hebben tot een compleet beeld van je data over verschillende bronnen heen. Door een uniform platform te bieden voor het benaderen en analyseren van data, kan datafederatie het makkelijker maken om aan regelgeving te voldoen en audits uit te voeren. Koppel datafederatie aan data lineage en goede documentatie om compliance-audits te vereenvoudigen.
Bekijk Wat is data lineage en Data Governance Concepts voor meer informatie.
Datafederatie wordt soms verward met datawarehousing. Er zijn echter enkele belangrijke verschillen tussen beide.
Datafederatie werkt volgens het principe van virtualisatie, waarbij data op de oorspronkelijke locaties blijft en in realtime wordt benaderd via een virtuele laag. Deze aanpak maakt toegang tot de meest actuele data mogelijk zonder duplicatie, minimaliseert opslagkosten en vermindert inconsistenties tussen datasets.
Bij datawarehousing wordt data geconsolideerd in een centrale opslagplaats. Deze gecentraliseerde aanpak is geschikt voor het opslaan van historische data en biedt een compleet beeld van trends uit het verleden. Datawarehousing vereist echter doorgaans uitgebreide ETL-processen om data uit verschillende bronnen in het warehouse te consolideren.
Je kunt meer leren over datawarehouses in deze introductiecursus Data Warehousing Concepts of in deze tutorial over De juiste cloud data warehouse-oplossing kiezen.
Datafederatie en datawarehousing bieden verschillende manieren van data-integratie. Elke aanpak heeft sterke punten en beperkingen.
Datafederatie blinkt uit in realtime toegang tot actuele data, terwijl dataduplicatie minimaal blijft. Het is ideaal voor dynamische en wendbare omgevingen.
Datawarehousing is het meest geschikt voor het opslaan en analyseren van historische data. Het vereist mogelijk uitgebreidere ETL-processen en mist de flexibiliteit van datafederatie.
Wanneer je kiest tussen datafederatie en datawarehousing, houd dan rekening met de specifieke use-case, het datavolume en de behoefte aan realtime- versus historische analyse.
Afhankelijk van je datalandschap kan het implementeren van een datafederatie een uitdaging zijn. Maar met zorgvuldige planning, de juiste tools en oog voor de vereisten van je organisatie is het een beheersbare taak die zijn vruchten zal afwerpen. Hier zijn een paar stappen om in elke federatie-implementatie te overwegen.
We moeten beginnen met een grondige beoordeling van het huidige datalandschap van onze organisatie. Identificeer de aanwezige databronnen in verschillende systemen, databases en applicaties. Begrijp welke typen data in elke bron zijn opgeslagen en hoe vaak deze worden bijgewerkt. Dit helpt om te waarborgen dat onze datafederatieoplossing realtime toegang tot de meest actuele data kan bieden.
Zoals bij elk project is het belangrijk om onze doelen duidelijk te definiëren. Leg de use-cases en vereisten voor datafederatie binnen de organisatie vast. Bepaal de specifieke bedrijfsdoelen die je met datafederatie wilt bereiken. Dit kunnen bijvoorbeeld het verbeteren van de datatoegankelijkheid, het stroomlijnen van integratieprocessen of het mogelijk maken van realtime analytics zijn. Identificeer belangrijke stakeholders en betrek hen in deze stap, zodat de oplossing ook aan hun behoeften voldoet.
Kies de juiste tools en technologieën op basis van de vereisten en het budget van de organisatie. Overweeg factoren zoals mogelijkheden voor datavirtualisatie, schaalbaarheid, eenvoudige integratie met bestaande systemen en ondersteuning voor verschillende databronnen. Evalueer zowel commerciële als open-sourceopties om de beste match voor onze behoeften te vinden. Hieronder staat een tabel met een paar populaire tools die voor datafederatie worden gebruikt.
|
Tool |
Functies |
Licentiemodel |
|
Realtime data-toegang, schematoewijzing, queryoptimalisatie |
Betaald |
|
|
Flexibel en uitbreidbaar, maatwerkoplossingen voor datafederatie |
Open-source |
|
|
Query’s uitvoeren op data in Amazon S3 met standaard SQL |
Betaald |
Ontwerp een federatie die aansluit bij de vereisten en use-cases van de organisatie. Bepaal de plaats van de federatielaag binnen de bestaande infrastructuur en definieer de integratiepunten met databronnen en dataconsumenten. Houd rekening met dataveiligheid, prestatieoptimalisatie en schaalbaarheid, zodat de federatie zowel huidige als toekomstige databehoeften kan ondersteunen.
Zodra onze datafederatie is opgezet en geconfigureerd om met onze databronnen te verbinden, is het belangrijk om te controleren of alles goed werkt. Test de oplossing grondig om eventuele problemen of prestatieknelpunten te identificeren en verfijn onze implementatie waar nodig.
Zet de datafederatieoplossing in productie en monitor de prestaties en betrouwbaarheid. Richt monitoring- en alarmeringsmechanismen in om problemen proactief te detecteren en aan te pakken. Optimaliseer de federatiearchitectuur en integratieprocessen continu om te zorgen dat de oplossing effectief blijft en aansluit bij veranderende bedrijfsbehoeften.
Datafederatie biedt aanzienlijke voordelen voor organisaties die de waarde willen ontsluiten van data die verspreid is over verschillende systemen. Door een gevirtualiseerde, uniforme weergave van data uit meerdere bronnen te bieden, verbetert datafederatie de data-toegang, vermindert duplicatie en vereenvoudigt integratie-inspanningen.
Leer meer over databeheer met An Introduction to Data Pipelines for Aspiring Data Professionals. Ik raad ook deze cursus aan over Responsible AI Data Management.
Leer databeheer met deze cursussen!
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

