
Kurs
Verantwortungsvolle KI-Datenverwaltung
1 Std.
10.7K
Verschaffe deinem Team Zugang zur gesamten DataCamp-Bibliothek mit zentralisierten Berichten, Aufgaben, Projekten und mehr
Data Federation ist eine Datenintegrationstechnik, die eine einheitliche Sicht auf Daten aus mehreren Quellen bietet, ohne sie physisch zu konsolidieren. Stell es dir als einen ausgeklügelten Mechanismus vor, der dir erlaubt, Daten über verschiedene Systeme hinweg in Echtzeit zu nutzen und abzufragen, als lägen sie alle an einem Ort.
Viele Organisationen arbeiten mit großen Datenmengen aus heterogenen Quellen. Für fundierte Entscheidungen ist es entscheidend, diese Daten in Echtzeit zugreifen und analysieren zu können – ohne den Aufwand doppelter Datenhaltung. Genau das ermöglicht Data Federation.
Data Federation kommt auch in einigen Datenarchitekturen zum Einsatz, um Daten zu konsolidieren – etwa in Data Fabrics (mehr dazu im Artikel Was ein Data Fabric ist).
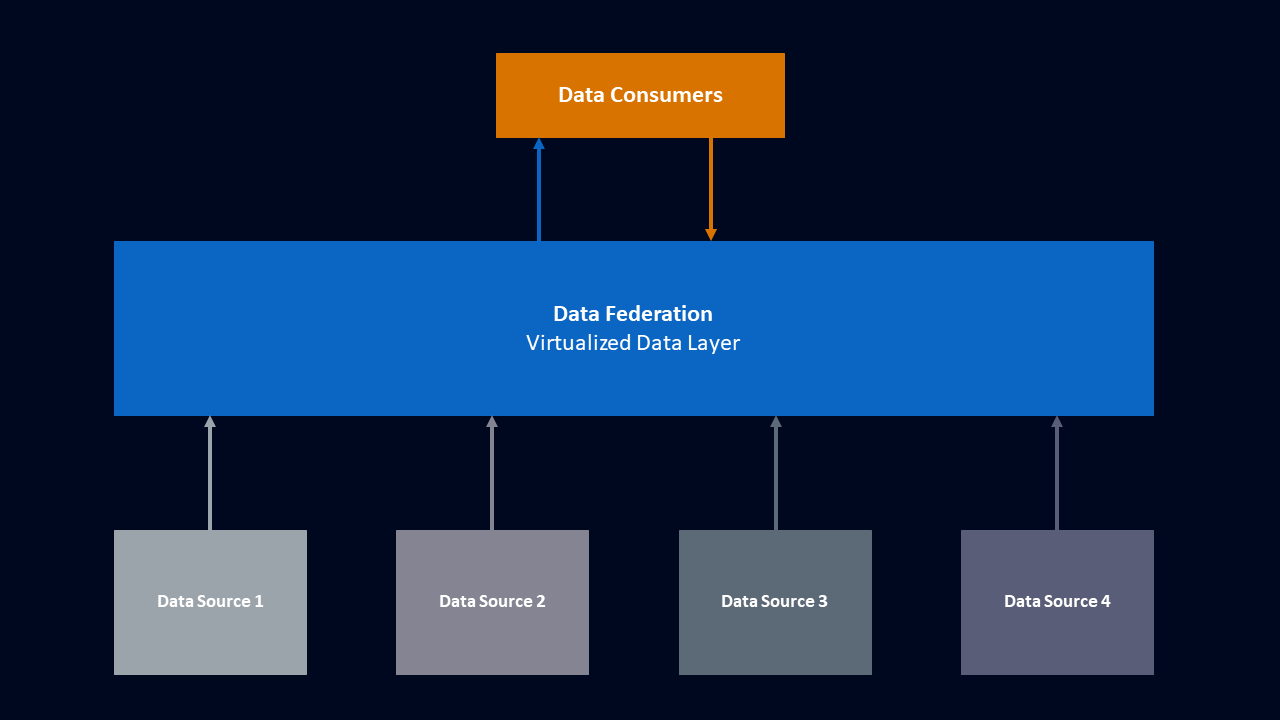
Die obige Grafik zeigt eine vereinfachte Sicht auf eine Data Federation. Die Federation virtualisiert und aggregiert Daten aus vielen unterschiedlichen Quellen, mit denen Datenkonsumentinnen und -konsumenten arbeiten können.
Eine Data Federation basiert auf mehreren Kernprinzipien. Schauen wir uns einige davon an.
Anstatt Daten physisch zu verlagern, verbleiben sie in ihrer ursprünglichen Quelle und werden über eine virtuelle Schicht zugänglich gemacht. Dadurch entfallen doppelte Datenbestände, während der Echtzeitzugriff auf aktuelle Informationen gewährleistet bleibt. Durch die Virtualisierung des Datenzugriffs kann die Integrität und Sicherheit der Daten am Ursprungsort gewahrt werden – bei gleichzeitig einheitlicher Sicht.
Nutzende arbeiten mit einer einzigen Oberfläche oder Abfragesprache, was den Zugriff auf Daten aus mehreren Quellen vereinfacht. Dieser einheitliche Zugriff beschleunigt die Datenabfrage. So können Analystinnen, Data Scientists und andere Stakeholder Daten abfragen und analysieren, ohne die Komplexität der einzelnen Quellen kennen zu müssen.
Ein Schema ist ein Bauplan, der festlegt, wie Daten in einer Datenbank organisiert sind. Datenquellen haben oft unterschiedliche Schemata, das heißt, sie strukturieren und benennen Daten verschieden. Beim Schemamapping werden diese Schemata aufeinander abgebildet, um eine konsistente Sicht zu schaffen.
Zum Beispiel kann eine Quelle "CustomerID" für eine Kundenkennung verwenden, während eine andere "CustID" nutzt. Schemamapping übersetzt diese Bezeichnungen, sodass sie als dieselbe Entität verstanden werden.
Durch die Harmonisierung unterschiedlicher Schemata sorgen Federation-Tools für eine nahtlose Integration heterogener Quellen. So entsteht ein konsistentes und verlässliches Datenmodell, dem Nutzende für präzise Analysen und Reports vertrauen können.
Data Federation setzt auf bedarfsgesteuerte Verarbeitung. Abfragen werden in Echtzeit über die föderierten Quellen ausgeführt, was Dubletten minimiert und sicherstellt, dass Nutzende stets auf aktuelle Daten zugreifen. Diese dynamische Verarbeitung ist entscheidend für zeitnahe Analysen und Entscheidungen. Durch On-Demand-Verarbeitung unterstützt Data Federation ein agiles, fundiertes Handeln.
Nun, da wir wissen, was Data Federation ist, schauen wir uns an, wie sie funktioniert.
Data Federation integriert nahtlos Daten aus unterschiedlichen Quellen. Im Kern steht eine strukturierte Architektur, die diese Integration effizient ermöglicht. Sie besteht aus drei Hauptbestandteilen:
Datenquellen lassen sich als Inseln denken, die jeweils wertvolle Informationen beherbergen. Diese reichen von strukturierten Daten in Datenbanken über unstrukturierte Daten in Cloud-Speichern bis zu Echtzeit-Streams. Data Federation integriert diese Vielfalt und schafft eine kohärente Sicht auf die Datenlandschaft.
Die Federation-Schicht stellt eine einheitliche Schnittstelle für den Zugriff und die Abfrage bereit. Sie übersetzt Nutzerabfragen in Befehle, die jede Datenquelle versteht, und ermöglicht so Echtzeitzugriff und -verarbeitung. Diese Schicht ist entscheidend, um Datenintegrität zu wahren, die Abfrage effizient zu halten und über alle Quellen hinweg eine konsistente Sicht zu bieten.
Man kann sich den Federation-Layer wie einen Livestream jeder Dateninsel vorstellen. Er erlaubt es Datenkonsumentinnen und -konsumenten, die Daten jeder Insel zu sehen und zu nutzen – ohne sie zu verschieben oder zu kopieren.
Verschiedene Anwendungen und Tools – etwa Business-Intelligence-Plattformen, Data-Science-Umgebungen und operative Systeme – greifen über die Federation-Schicht auf die föderierten Daten zu. Darüber nutzen Data Analysts, Data Scientists und andere Datennutzende die Daten für Analysen, Berichte und Entscheidungen.
Wenn wir eine Abfrage an ein föderiertes System senden, landet sie zuerst in der Federation-Schicht. Denk an diese Schicht als eine clevere Übersetzerin: Sie nimmt die Hauptabfrage und zerlegt sie in kleinere Teilabfragen. Jede Teilabfrage ist so zugeschnitten, dass sie Daten aus der jeweiligen Quelle holt – etwa aus Datenbanken oder Cloud-Speichern.
Diese Teilabfragen werden dann in Echtzeit an die verschiedenen Quellen gesendet. Jede Quelle verarbeitet ihren Teil und liefert Ergebnisse zurück. Die Federation-Schicht sammelt diese Ergebnisse und führt sie zu einem aggregierten Resultat zusammen.
Dieser schlanke Prozess erlaubt es, Daten aus vielen Quellen so zu nutzen und zu analysieren, als wären sie ein einheitlicher Datensatz. Das erleichtert die Datensammlung über die gesamte Organisation hinweg.
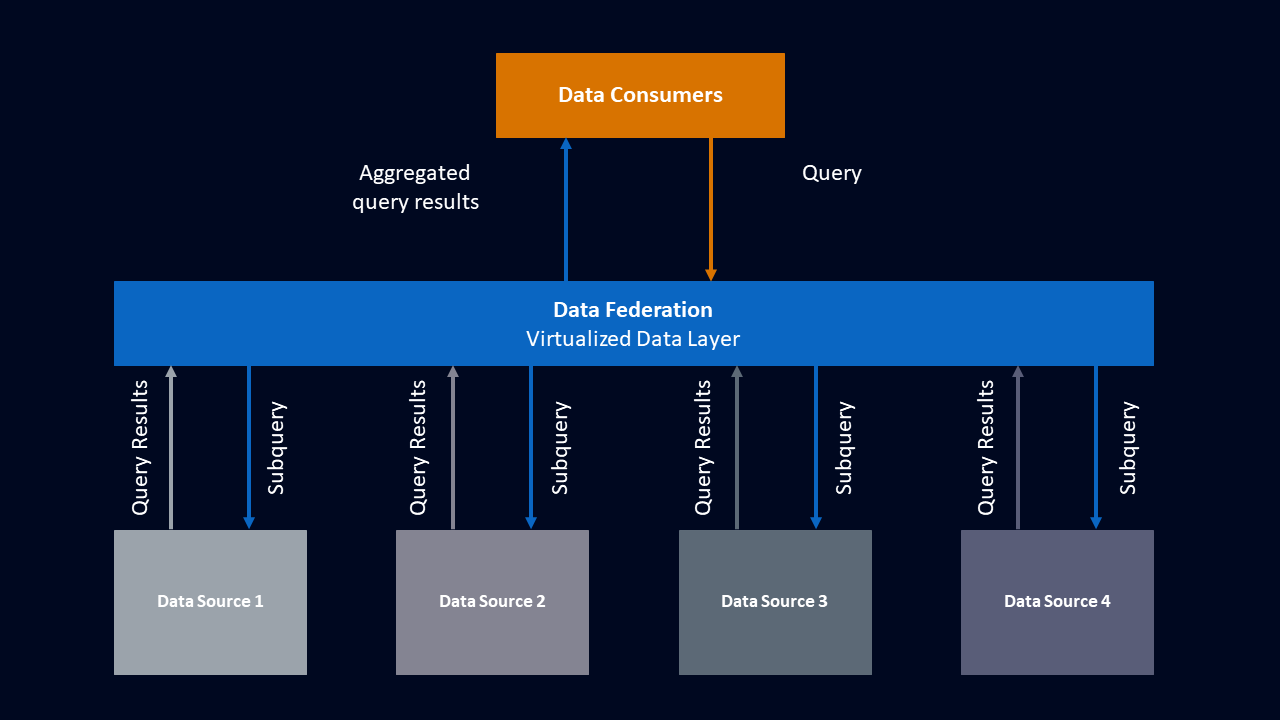
Die obige Grafik zeigt eine vereinfachte Darstellung dieses Ablaufs. Eine datenverbrauchende Anwendung stellt eine Abfrage an die Data Federation. Diese zerlegt die Abfrage in Teilabfragen und sendet sie an die passenden Quellen. Jede Quelle liefert ihre Ergebnisse zurück, die von der Federation aggregiert und an die anfragende Anwendung zurückgegeben werden.
Data Federation bietet mehrere zentrale Vorteile für Organisationen mit komplexen Datenlandschaften.
Durch die Minimierung von Datenkopien senkt Federation die Speicherkosten und reduziert das Risiko von Inkonsistenzen zwischen Datensätzen. Dieser schlanke Ansatz optimiert Ressourcen und stärkt die Datenintegrität.
Data Federation vereinfacht den Datenzugriff, indem sie einen zentralen Ort bietet, um Daten aus der gesamten Organisation abzufragen. Dieser zentrale Zugriffspunkt beschleunigt Abruf und Analyse. Die Echtzeitnatur stellt sicher, dass Nutzende stets auf die aktuellsten Daten aller föderierten Quellen zugreifen können – entscheidend für rechtzeitige Entscheidungen.
Data Federation verschlankt Integrationsvorhaben, da komplexe ETL-Prozesse (Extract, Transform, Load), die bei Konsolidierung üblich sind, weitgehend entfallen. Das beschleunigt die Integration und verringert Fehlerrisiken.
Die inhärente Flexibilität von Data Federation ermöglicht es, Datenquellen bei Bedarf einfach hinzuzufügen oder zu entfernen, ohne bestehende Anwendungen oder Workflows zu stören. So können Organisationen schnell auf veränderte Datenbedarfe reagieren, statt von starren Architekturen gebremst zu werden.
Neben zahlreichen Vorteilen bringt Data Federation auch Herausforderungen mit sich, die Organisationen angehen müssen.
Leistungsprobleme können durch die Komplexität von Abfragen über mehrere Quellen entstehen. Optimierungsmaßnahmen helfen, eine effiziente Datenabfrage und -verarbeitung sicherzustellen. Es ist wichtig, in robuste Infrastruktur zu investieren und Abfrageoptimierung einzusetzen. So lassen sich Engpässe mindern und die Reaktionsfähigkeit beim Datenzugriff erhalten.
Eine weitere große Herausforderung ist die Schema-Komplexität. Das Abbilden heterogener Schemata kann anspruchsvoll sein. Unterschiedliche Datenstrukturen erfordern ausgefeilte Tools und Techniken, um Schemata zu harmonisieren und Konsistenz über die Föderation hinweg sicherzustellen. Data-Profis können Datenmodellierung und Schemamapping-Strategien nutzen, um diese Hürden zu überwinden und eine einheitliche Sicht zu schaffen, die die zugrunde liegende Semantik korrekt widerspiegelt.
Wenn du mehr über Schemamapping lernen willst, empfehle ich diesen Database Design Kurs.
Data Governance kann bei föderierten Daten herausfordernd sein. Organisationen müssen Richtlinien zu Datenqualität, Sicherheit und Datenschutz über alle Quellen hinweg etablieren und durchsetzen. Wichtig sind Prozesse wie Data-Lineage-Tracking, Zugriffskontrollen und Datenschutzmaßnahmen. Sie mindern Risiken und sichern die Integrität der föderierten Daten.
Weitere Informationen zu Data Governance findest du in Making Data Governance Fun und How Data Leaders Can Make Data Governance a Priority. Dieses Data-Governance-Cheat Sheet ist ebenfalls hilfreich.
Data Federation ist auf allen Ebenen einer Organisation nützlich.
Data Federation befähigt Analystinnen und Analysten, aussagekräftige Reports und Dashboards zu erstellen, die Daten aus verschiedenen Abteilungen oder Systemen aggregieren. Durch die einheitliche Sicht gewinnen Organisationen wertvolle Einblicke in ihre Abläufe und treffen fundierte, strategische Entscheidungen.
Mit einfachem Zugriff auf vielfältige Datenquellen für Training und Validierung können Data Scientists das gesamte Informationsspektrum der Organisation nutzen. Aggregierte Daten verbessern Genauigkeit und Robustheit von Modellen und stärken die Vorhersagefähigkeit. Data Federation spart zudem Zeit, da nicht erst komplexe Datenpipelines für Modelle gebaut werden müssen.
Durch die Aggregation von Datenströmen aus unterschiedlichen Quellen erhalten Organisationen einen ganzheitlichen Blick auf ihre Abläufe, erkennen Engpässe und optimieren Workflows. Das steigert die Effizienz insgesamt. Die Echtzeitsicht versetzt Entscheidungsträger in die Lage, schnell auf Veränderungen zu reagieren.
Gerade wenn Prüferinnen und Prüfer eine vollständige Sicht auf Daten über verschiedene Quellen benötigen, ist Data Federation hilfreich. Eine einheitliche Plattform für Zugriff und Analyse erleichtert die Einhaltung von Vorgaben und die Durchführung von Audits. Für reibungslosere Compliance-Prüfungen sollte Data Federation mit Data Lineage und sauberer Dokumentation kombiniert werden.
Sieh dir Was ist Data Lineage und Data Governance Concepts für weitere Infos an.
Data Federation wird manchmal mit Data Warehousing verwechselt. Es gibt jedoch wichtige Unterschiede.
Data Federation basiert auf Virtualisierung: Daten verbleiben an ihren Ursprungsorten und werden über eine virtuelle Schicht in Echtzeit zugänglich. So greifen Nutzende auf die aktuellsten Daten zu, ohne sie zu duplizieren – das senkt Speicherbedarf und reduziert Inkonsistenzen.
Data Warehousing konsolidiert Daten in einem zentralen Repository. Dieser Ansatz eignet sich gut für die Speicherung historischer Daten und einen Gesamtblick auf vergangene Trends. Allerdings erfordert er in der Regel umfangreiche ETL-Prozesse, um Daten aus verschiedenen Quellen ins Warehouse zu laden.
Mehr über Data Warehouses erfährst du in diesem Kurs zur Einführung in Data Warehousing Concepts oder in diesem Tutorial zu Der richtigen Cloud-Data-Warehouse-Lösung.
Data Federation und Data Warehousing bieten unterschiedliche Ansätze zur Datenintegration – mit jeweils eigenen Stärken und Grenzen.
Data Federation überzeugt durch Echtzeitzugriff auf aktuelle Daten bei minimaler Duplizierung. Ideal für dynamische, agile Umgebungen.
Data Warehousing eignet sich am besten für die Speicherung und Analyse historischer Daten. Es erfordert oft umfangreichere ETL-Prozesse und ist weniger flexibel als Federation.
Bei der Entscheidung zwischen beiden Ansätzen zählen Use Case, Datenvolumen und der Bedarf an Echtzeit- versus historischer Analyse.
Je nach Datenlandschaft kann die Einführung einer Data Federation anspruchsvoll sein. Mit sorgfältiger Planung, der Wahl geeigneter Tools und der Ausrichtung an den Anforderungen der Organisation ist sie jedoch gut machbar – und zahlt sich aus. Hier sind einige Schritte, die du bei jeder Federation-Implementierung berücksichtigen solltest.
Starte mit einer gründlichen Bestandsaufnahme der aktuellen Datenlandschaft. Identifiziere Datenquellen in Systemen, Datenbanken und Anwendungen. Verstehe, welche Datentypen wo liegen und wie häufig sie aktualisiert werden. So stellst du sicher, dass die Federation-Lösung Echtzeitzugriff auf die aktuellsten Daten unterstützen kann.
Wie bei jedem Projekt gilt: Ziele klar definieren. Lege die Use Cases und Anforderungen an die Data Federation fest. Bestimme die geschäftlichen Ziele – etwa bessere Datenzugänglichkeit, schlankere Integration oder Echtzeitanalysen. Beziehe zentrale Stakeholder ein, damit die Lösung deren Bedürfnisse erfüllt.
Wähle passende Tools und Technologien basierend auf Anforderungen und Budget. Berücksichtige Faktoren wie Datenvirtualisierung, Skalierbarkeit, einfache Integration in bestehende Systeme und Unterstützung verschiedener Datenquellen. Prüfe kommerzielle und Open-Source-Optionen, um den besten Fit zu finden. Nachfolgend einige gängige Tools für Data Federation.
|
Tool |
Funktionen |
Lizenzmodell |
|
Echtzeitzugriff, Schemamapping, Abfrageoptimierung |
Kostenpflichtig |
|
|
Flexibel und erweiterbar, für individuelle Federation-Lösungen |
Open Source |
|
|
Abfrage von in Amazon S3 gespeicherten Daten mit Standard-SQL |
Kostenpflichtig |
Entwirf eine Föderation, die zu Anforderungen und Use Cases passt. Bestimme die Position der Federation-Schicht in der bestehenden Infrastruktur und definiere die Integrationspunkte zu Quellen und Konsumentinnen bzw. Konsumenten. Beachte Datensicherheit, Performanceoptimierung und Skalierbarkeit, damit die Föderation aktuelle wie zukünftige Bedarfe trägt.
Sobald die Föderation eingerichtet und mit den Datenquellen verbunden ist, gilt es, die Funktionsfähigkeit sicherzustellen. Teste gründlich, identifiziere Probleme oder Engpässe und verfeinere die Implementierung bei Bedarf.
Stelle die Lösung produktiv und überwache Leistung und Zuverlässigkeit. Etabliere Monitoring und Alerts, um Probleme proaktiv zu erkennen und zu beheben. Optimiere Architektur und Integrationsprozesse kontinuierlich, damit die Lösung wirksam bleibt und sich mit den Geschäftsanforderungen weiterentwickelt.
Data Federation bietet großen Mehrwert für Organisationen, die verstreute Daten nutzbar machen wollen. Mit einer virtualisierten, einheitlichen Sicht auf Daten aus vielen Quellen verbessert sie den Zugriff, reduziert Redundanzen und vereinfacht die Integration.
Lerne mehr über Datenmanagement mit An Introduction to Data Pipelines for Aspiring Data Professionals. Außerdem empfehle ich diesen Kurs zu Responsible AI Data Management.
Verschaffe deinem Team Zugang zur gesamten DataCamp-Bibliothek mit zentralisierten Berichten, Aufgaben, Projekten und mehr
Lerne Datenmanagement mit diesen Kursen!
Kurs
Kurs
Kurs