
Corso
ETL and ELT in Python
4 ore
40K
I dati sono fondamentali per aziende e organizzazioni, e il compito di organizzare il flusso di tutte queste informazioni è esattamente dove le data pipeline brillano. Quindi, cosa sono le data pipeline e cosa devi sapere per costruirne una tua?
I dati sono il linfa vitale delle aziende e delle organizzazioni moderne: guidano le decisioni, gli insight e l'innovazione. Tuttavia, gestire e sfruttare la potenza dei dati può essere un compito complesso e impegnativo. È qui che entrano in gioco le data pipeline. Ma cosa sono le data pipeline?
Una data pipeline è un sistema che recupera dati da varie fonti e li convoglia in una nuova destinazione, come un database, un repository o un'applicazione, eseguendo lungo il percorso eventuali trasformazioni necessarie (convertire i dati da un formato o una struttura a un'altra). Gli utenti finali di questa pipeline possono essere analisti, data scientist o figure di business.
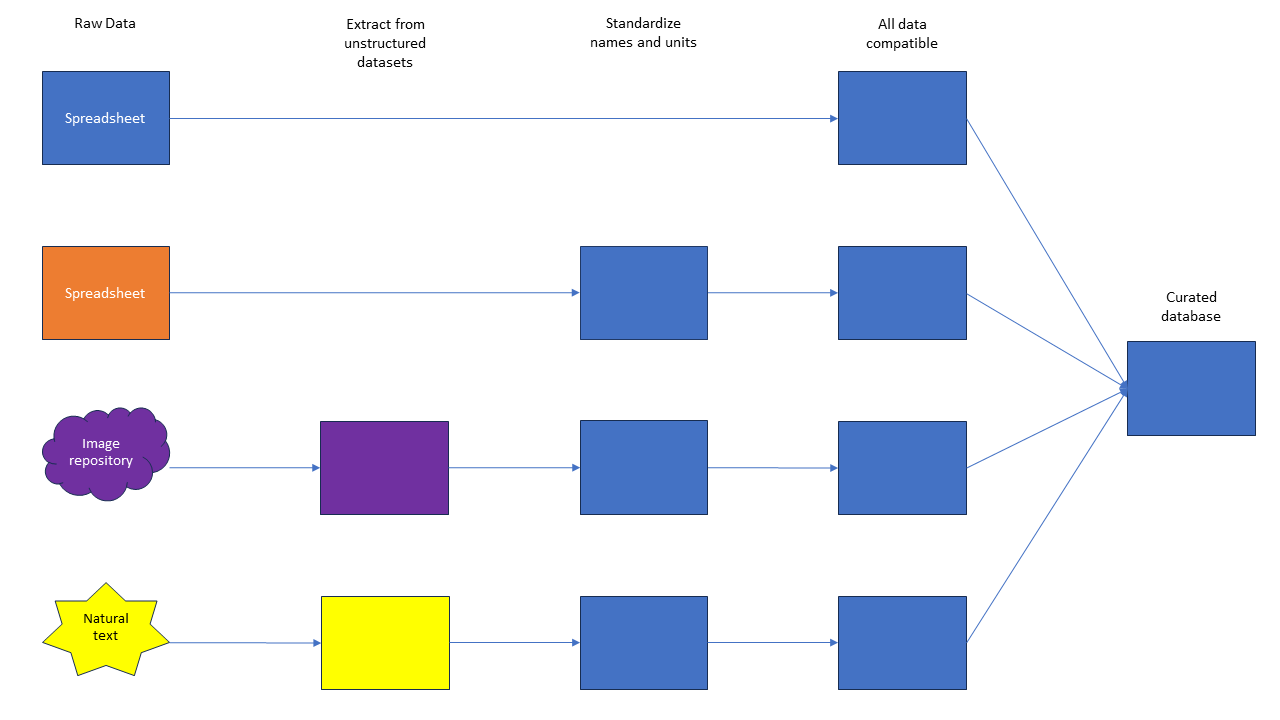
Figura 1: Esempio di una semplice data pipeline. In questo esempio, hai quattro sorgenti dati: due strutturate e due non strutturate. Attraverso una serie di passaggi, estrai dati strutturati dai set non strutturati, standardizzi tutti i nomi e le unità e, una volta resi compatibili, puoi creare un unico database curato con tutte le informazioni necessarie. Questo database può poi essere usato da analisti, scienziati o leader aziendali.
Anche se può sembrare un compito semplice, comporta molte scelte e grattacapi. In molte organizzazioni, costruire e mantenere pipeline è un lavoro a sé, gestito da data engineer. In altre, è solo uno dei tanti compiti affidati a un data scientist. Chi mantiene la pipeline dipende spesso dalle dimensioni dell'organizzazione, dalla complessità delle pipeline e dai fondi disponibili.
Creare una pipeline affidabile, sicura e puntuale è una parte cruciale dei processi decisionali data-driven. Che tu voglia dedicarti al data engineering o a qualsiasi altro ruolo nel ciclo dei dati, vale la pena capire come funzionano le data pipeline.
Potresti chiederti perché dovresti costruire una pipeline. Se hai lavorato con dataset preconfezionati o con dati che provengono da un'unica fonte, come quelli che trovi su Kaggle o negli esercizi di DataCamp, probabilmente non ne hai mai avuto bisogno. Questi dataset curati sono già predisposti perché gli analisti possano prelevarli e lavorarci direttamente.
Tuttavia, se vuoi combinare informazioni da molte fonti, potresti dover impostare una pipeline per assicurarti che tutti i dati siano accessibili per la tua analisi.
Ecco alcuni motivi chiave per cui potresti considerare l'uso di data pipeline:
Per esempio, immagina di voler sapere se il GPA medio degli studenti in un distretto scolastico correla con il reddito medio della contea o con la dimensione della popolazione. Per questa analisi, potresti dover prelevare i dati sul GPA da ciascun distretto scolastico in esame, i dati sul reddito dall'IRS e la dimensione della popolazione dal Census Bureau.
Probabilmente potresti raccogliere queste informazioni manualmente una volta sola. Ma immagina di dover ripetere regolarmente l'analisi. Costruire una pipeline affidabile può aiutarti ad automatizzare la raccolta, risparmiando tempo e grattacapi.
Oltre a raccogliere i dati in un unico posto, le pipeline possono aiutarti a gestire le incoerenze tra fonti diverse. Ad esempio, il Census Bureau potrebbe identificare le contee con il nome per esteso, mentre l'IRS potrebbe usare nomi abbreviati.
All'interno della pipeline, puoi impostare un sistema per standardizzare il modo in cui le contee sono identificate nel repository finale. Oppure, se la popolazione è indicata con unità diverse in voci differenti, puoi standardizzare il sistema di unità usato nella destinazione finale. Questo tipo di modifiche si chiama trasformazioni.
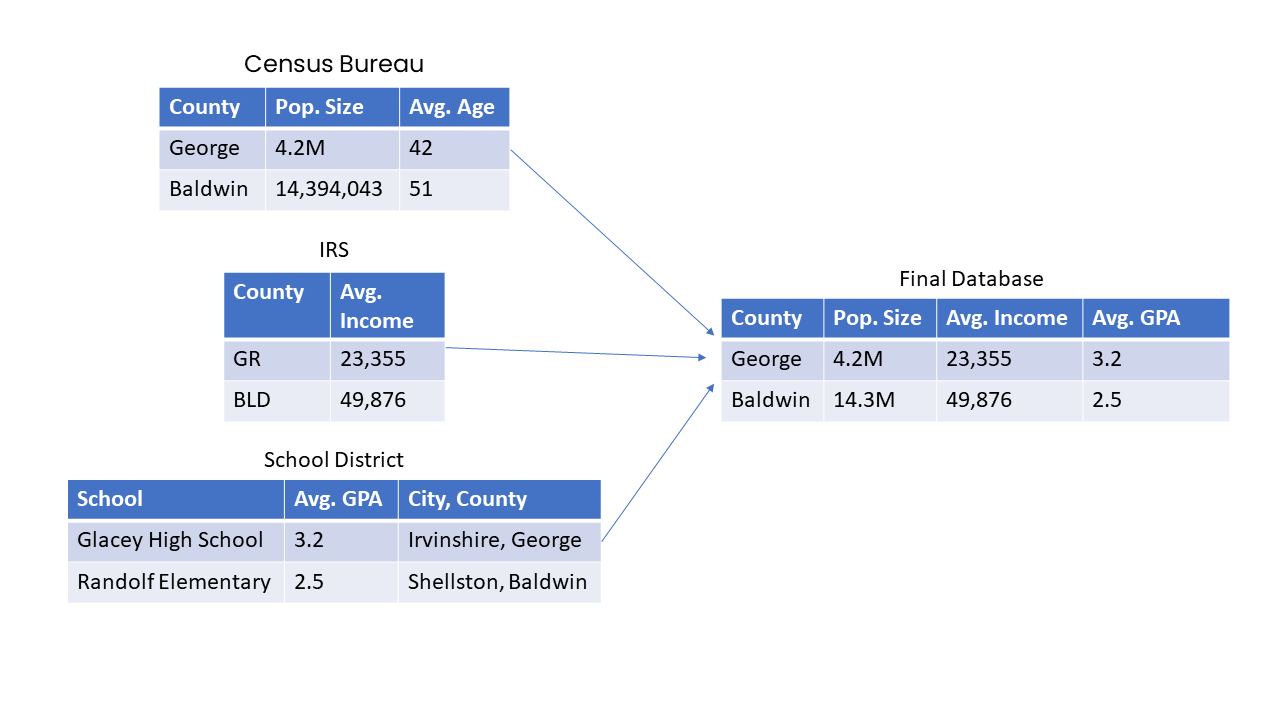
Figura 2: Quando si combinano informazioni da fonti diverse, possono essere necessarie trasformazioni come il cambio di unità e la standardizzazione dei nomi.
Le data pipeline sono generalmente sviluppate e mantenute dai data engineer.
Una volta che i dati sono stati raccolti, puliti e organizzati alla fine della pipeline, possono essere prelevati da vari stakeholder, tra cui data analyst, data scientist o business analyst.
I dati possono poi essere usati per analisi in tempo reale, alimentare una dashboard aggiornata o essere inseriti in un modello di machine learning. A volte, l'endpoint della pipeline può essere un'applicazione o una dashboard usata da un leader aziendale o da un utente.
Le pipeline sono usate praticamente in ogni settore che sfrutta grandi quantità di dati. In alcune grandi organizzazioni, come quelle tech, le pipeline sono complesse, altamente regolamentate e gestite da team di ingegneri specializzati.
Nelle organizzazioni più piccole, ad esempio un singolo ricercatore che cerca di raccogliere dati da più sensori nel mondo, la pipeline può essere molto lineare e semplice, con pochi passaggi. Altri esempi sono un broker che raccoglie informazioni finanziarie per decidere quali titoli acquistare o un sistema ospedaliero che raccoglie cartelle cliniche dalle varie strutture affiliate.
Le pipeline sono anche cruciali per i modelli di machine learning. Questi modelli consumano enormi quantità di dati e una pipeline adeguata è imprescindibile per un funzionamento fluido. Questo tutorial su MLOps spiega in dettaglio come le pipeline vengono usate nel machine learning.
I dati possono essere archiviati in vari modi, a seconda del tipo di dato e dell'uso previsto. Tre termini che incontrerai spesso parlando di archiviazione sono data lake, database e data warehouse. Vediamoli brevemente.
Un data lake è un ampio repository di archiviazione flessibile che può contenere dati sia strutturati sia non strutturati su larga scala. Consente alle organizzazioni di conservare dati grezzi e non elaborati da varie fonti, come log web, sensori, social media e altro, nel loro formato nativo.
I data lake sono noti per la loro versatilità, poiché permettono a data scientist e analisti di esplorare, trasformare e analizzare i dati in diversi modi. Sono particolarmente utili per casi d'uso di big data e analitiche avanzate in cui lo schema e la struttura dei dati non sono predefiniti, offrendo la flessibilità di estrarre insight da fonti eterogenee.
I database sono sistemi più generici usati per archiviare, gestire e recuperare in modo efficiente dati strutturati. Pur condividendo alcune somiglianze con i data warehouse, i database sono tipicamente usati per dati transazionali, operazioni quotidiane e applicazioni in tempo reale. Ne esistono di vari tipi, tra cui database relazionali, NoSQL e in-memory, ciascuno adatto a specifici requisiti di archiviazione e processamento. I database garantiscono l'integrità dei dati, supportano accessi concorrenti e offrono vari meccanismi di interrogazione e recupero.
I data warehouse, invece, sono repository altamente strutturati e ottimizzati per archiviare, organizzare e interrogare dati strutturati principalmente a fini analitici. Seguono in genere uno schema predefinito, impongono qualità e coerenza dei dati e sono ottimizzati per interrogazioni e reportistica complesse.
I data warehouse sono ideali per le aziende che vogliono prendere decisioni informate basate su dati storici, in quanto forniscono un'unica fonte di verità per report e analisi standardizzati. I dati vengono solitamente estratti da diverse fonti, trasformati in un formato coerente e caricati nel data warehouse per l'analisi.
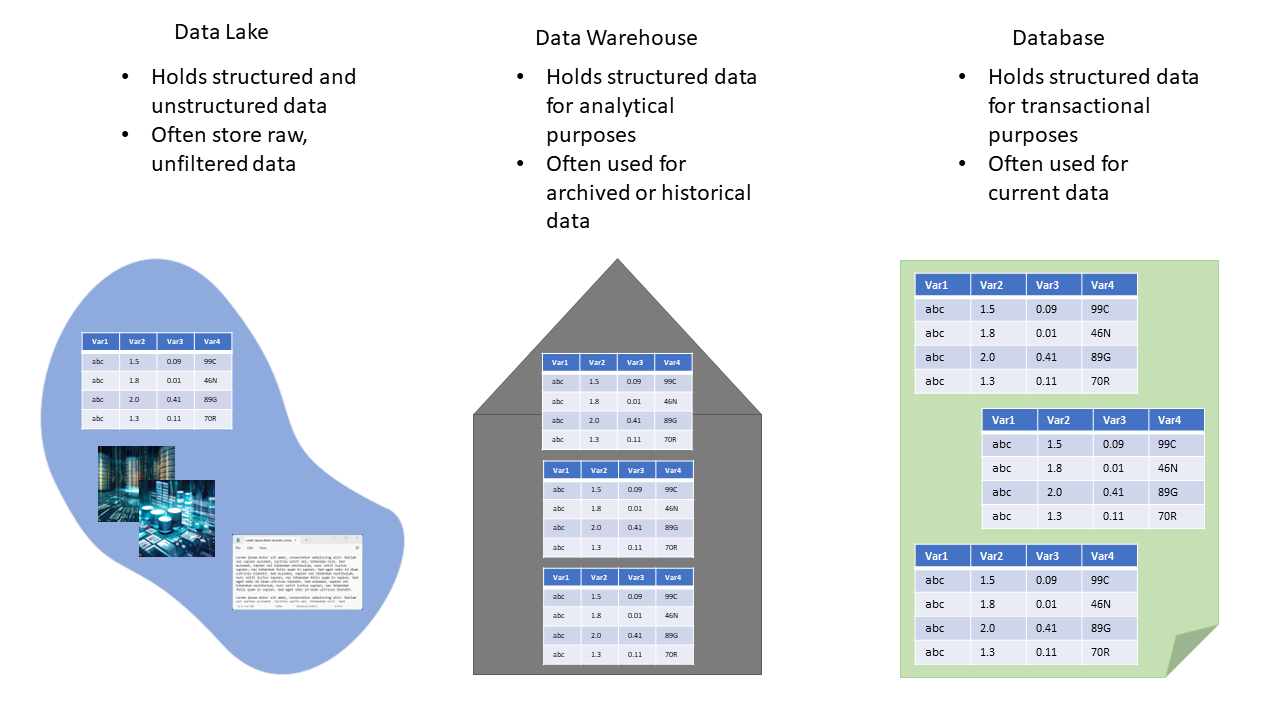
Figura 3: Alcune differenze tra data lake, data warehouse e database. Un data lake può essere uno step precedente in una pipeline che termina in un warehouse o in un database.
Le pipeline seguono in genere uno di due schemi principali: ETL (Extract, Transform, Load) o ELT (Extract, Load, Transform).
ETL segue un approccio sequenziale. Per prima cosa, i dati vengono estratti da vari sistemi sorgente, che possono includere database, file, API o altri repository.
Una volta estratti, i dati vengono trasformati per aderire allo schema, alla qualità e alle regole di business desiderati. Questa trasformazione può comportare pulizia, aggregazione e strutturazione. Infine, i dati trasformati vengono caricati nel data warehouse o sistema di archiviazione di destinazione, spesso in un formato ottimizzato per report e analisi.
L'ETL è utile quando i dati necessitano di una ristrutturazione o pulizia significativa prima di essere archiviati nel data warehouse, perché garantisce che siano pronti per l'analisi. Questo corso su ETL con Python offre una panoramica dettagliata dell'ETL usando Python e SQL.
ELT, invece, inverte l'ordine della trasformazione. Nel processo ELT, i dati sono prima estratti dai sistemi sorgente e caricati, così come sono, in un data warehouse o talvolta in un data lake, senza grandi trasformazioni. La trasformazione e l'elaborazione avvengono quindi all'interno del data warehouse stesso.
Questo approccio sfrutta la potenza di calcolo e la flessibilità dei moderni data warehouse e delle piattaforme big data, risultando adatto a scenari in cui vuoi archiviare grandi volumi di dati grezzi ed effettuare trasformazioni on demand.
ELT è spesso preferito quando disponi di una soluzione di data warehousing capace di gestire in modo efficiente trasformazioni complesse, come i data warehouse cloud o framework distribuiti come Hadoop.
Esistono molti strumenti per sviluppare pipeline. La scelta giusta dipende da dimensioni, esigenze di scalabilità, budget disponibile e obiettivi della pipeline. Puoi creare una pipeline completa usando Python e SQL (o R e SQL), oppure affidarti a vari strumenti commerciali.
Ecco un breve elenco di alcune tecnologie e strumenti commerciali comuni.
Puoi dare un'occhiata al nostro elenco dei migliori strumenti ETL e capire perché sceglierli in un articolo dedicato.
Il primo passo per creare una data pipeline è raccogliere i dati da inserire nella pipeline. Online ci sono diversi luoghi dove reperire informazioni aggiornate, tra cui siti governativi, social media e alcune organizzazioni non profit. Spesso mettono a disposizione un'API relativamente semplice da usare.
Un'API (application programming interface) è sostanzialmente un software che consente la comunicazione tra due o più applicazioni. Ad esempio, potresti integrare un'API di Twitter nella tua applicazione Python per permetterle di pubblicare tweet o "leggere" tweet per tuo conto. È, in pratica, un intermediario.
Puoi usare un'API all'inizio della pipeline per raccogliere dati da varie fonti. Per esempio, potresti usare un'API per raccogliere i dati delle pratiche societarie dalla SEC o per raccogliere dati clinici da tabelle mantenute dal NIH.
Un'altra tecnica per raccogliere dati è il web scraping. Si tratta di una tecnica che usa uno script personalizzato per estrarre informazioni da una pagina web. Librerie Python come BeautifulSoup e Scrapy semplificano il processo, ma devi comunque saper navigare tra HTML o XML per trovare le informazioni di cui hai bisogno.
Se vuoi saperne di più sul web scraping, DataCamp offre materiali su Beautiful Soup in Python, web scraping in R e web scraping per l'NLP.
Esistono anche servizi no-code per il web scraping. Eccone uno che ti consente di raccogliere informazioni da una pagina e monitorarne le modifiche.
Il tuo processo di raccolta può includere un mix di dati strutturati (come fogli di calcolo o database) e non strutturati (come testo o immagini).
A seconda dell'obiettivo finale della pipeline, potresti estrarre informazioni dai dati non strutturati per creare un dataset uniformemente strutturato, oppure lasciare parte dei dati non strutturata assicurando comunque un corretto collegamento incrociato per l'utente finale.
I dati strutturati possono spesso essere estratti con query SQL o strumenti ETL, mentre i dati non strutturati possono richiedere tecniche di elaborazione del linguaggio naturale (NLP) o strumenti specializzati.
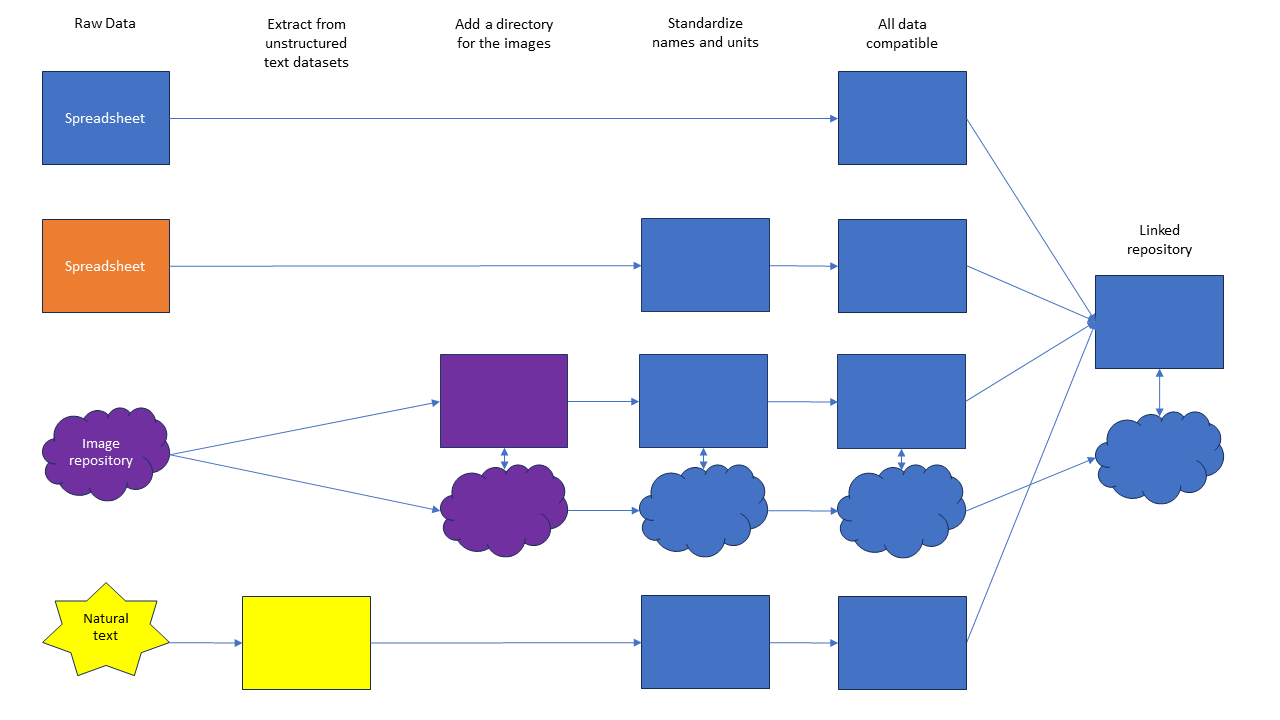
Figura 4: Esempio di data pipeline con dati non strutturati lasciati intatti alla fine. In questo esempio, vogliamo creare un repository di dati strutturati curati e immagini collegate. Potrebbe essere anche un data lake. Quindi, invece di estrarre dati strutturati dalle immagini, abbiamo creato una directory che collega le immagini ai dati pertinenti nel database. L'utente finale può quindi recuperare l'immagine grezza per ogni riga di un foglio di calcolo, secondo necessità. In alternativa, avremmo potuto analizzare le immagini e fornire un'immagine con sezioni isolate o rimosse. Per informazioni su come farlo, consulta questo tutorial sull'analisi delle immagini.
Una volta che hai identificato le fonti e l'obiettivo finale, puoi iniziare a impostare la pipeline.
La prima cosa da fare è pianificare la pipeline. Ti suggerisco di tracciarla su carta. All'estrema sinistra annota le tue fonti di dati e all'estrema destra aggiungi l'obiettivo finale. Nel mezzo, disponi tutti i passaggi necessari per arrivare dalle fonti all'obiettivo.
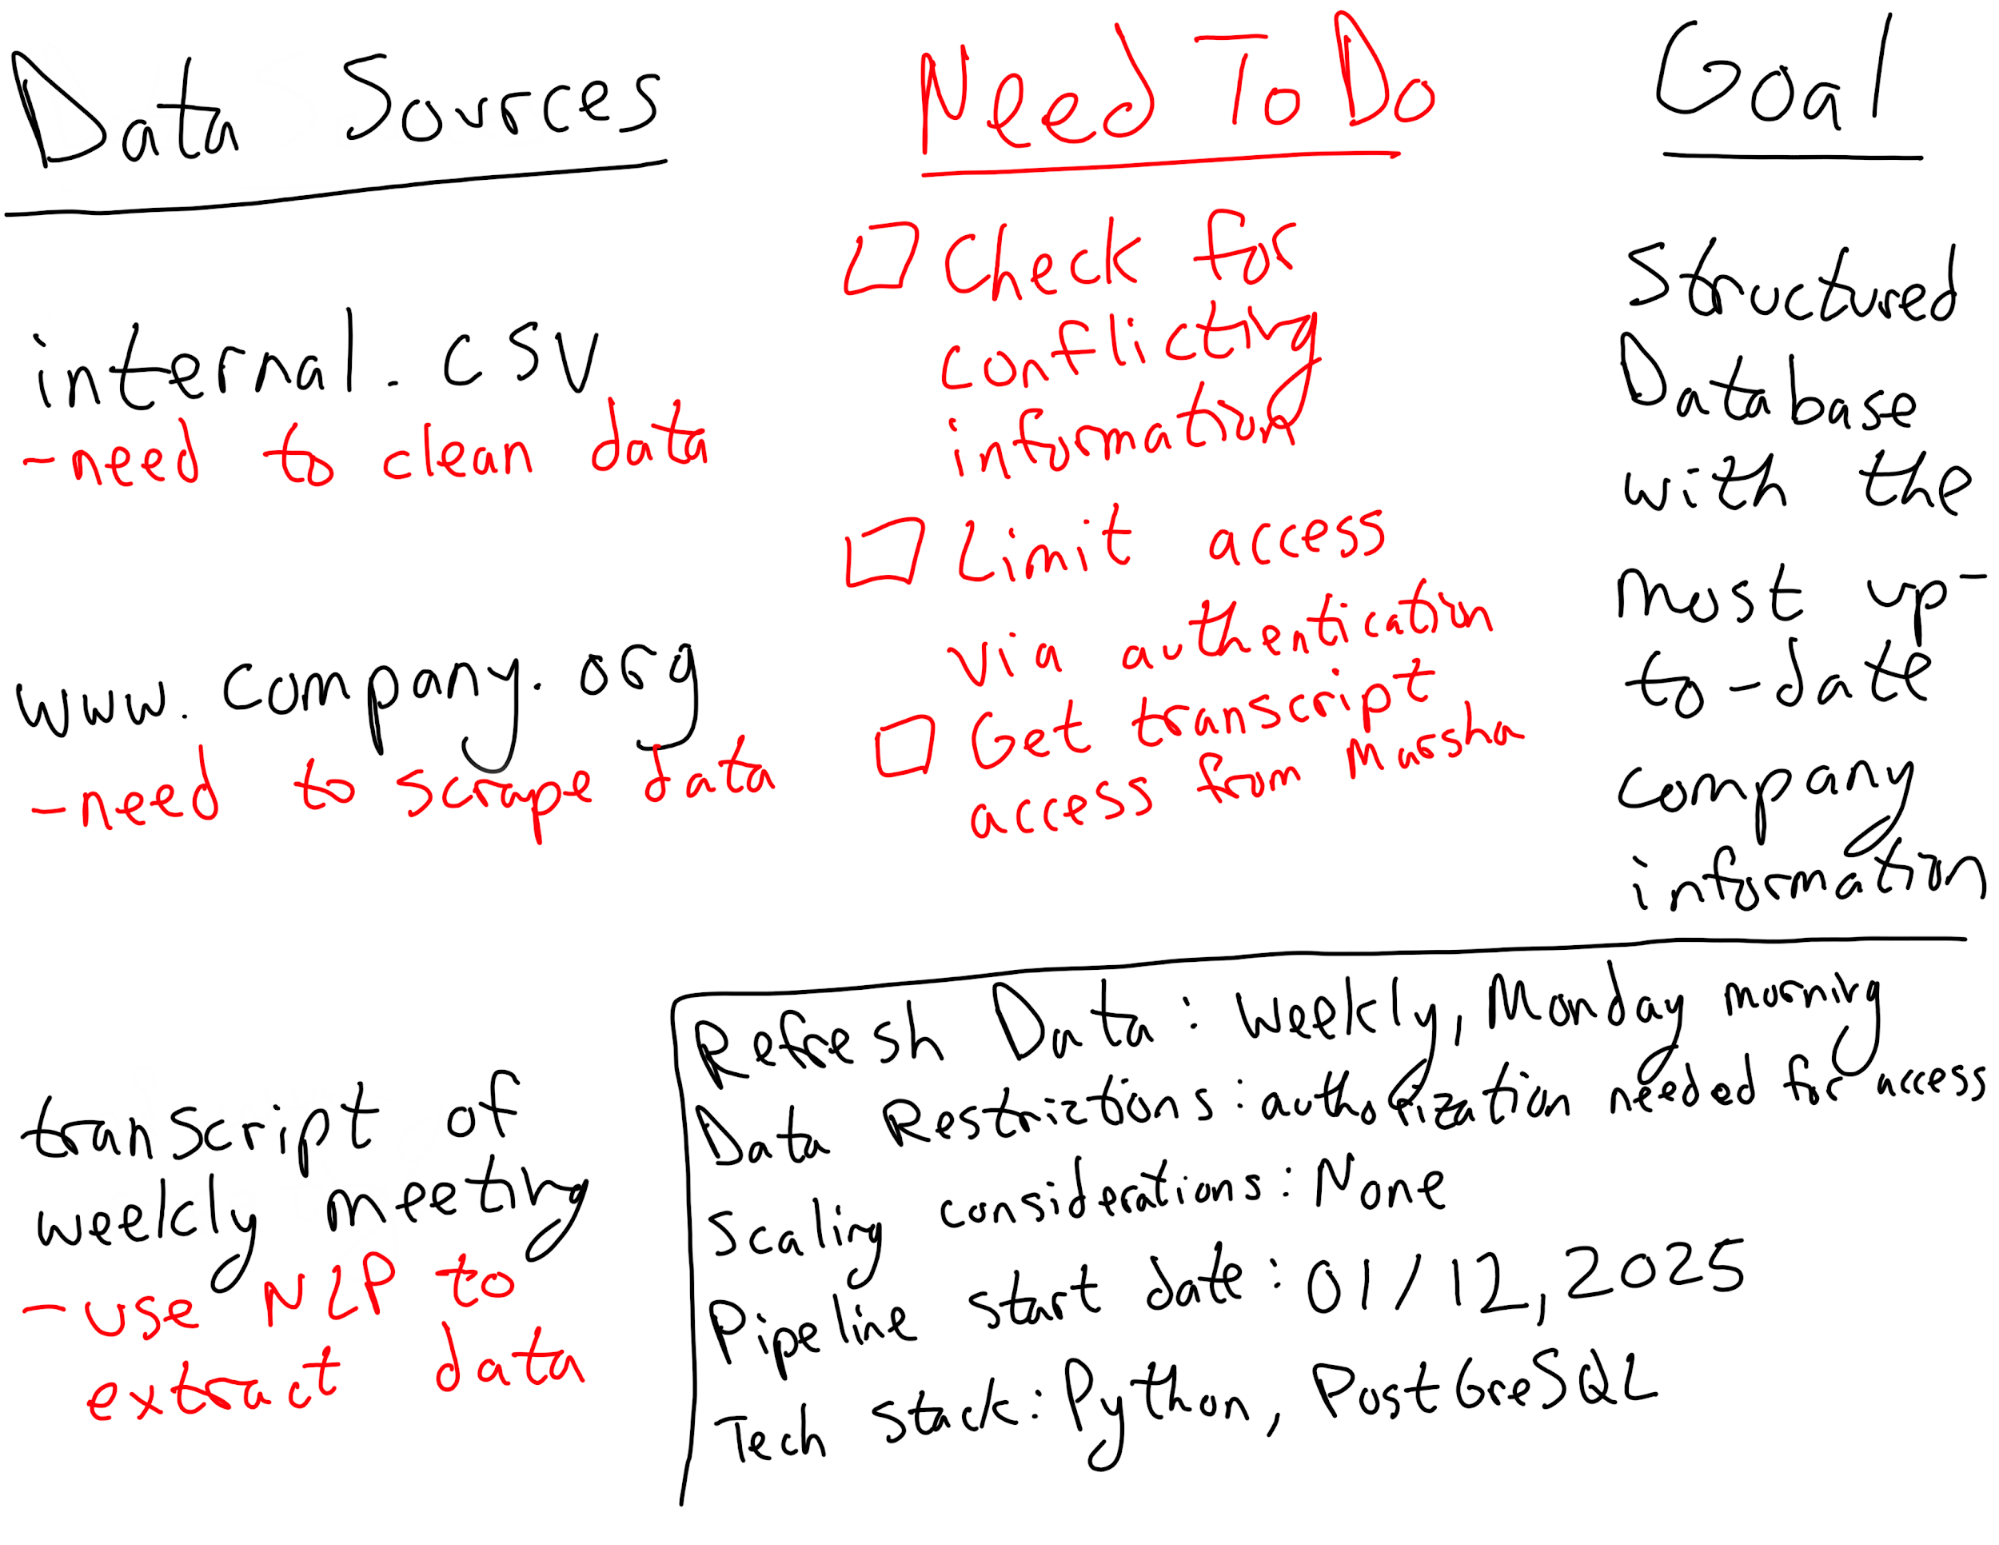
Figura 5: Esempio di piano per una pipeline.
Alcuni passaggi potenziali da includere possono essere:
Una volta definito il piano, si passa alla costruzione. Può essere interamente codificata nel tuo linguaggio preferito, oppure includere uno o più servizi pensati per supportare le pipeline. È importante tenere sempre a mente l'utente finale e ciò di cui avrà bisogno durante la costruzione.
Una decisione chiave è la frequenza di aggiornamento dei dati. Se ti serve la massima attualità, dovrai impostare una pipeline attrezzata per l'elaborazione in tempo reale. Se invece non è necessaria questa precisione, puoi considerare l'elaborazione batch per risparmiare risorse. Significa che i dati attraversano i passaggi della pipeline a lotti, ad esempio una volta a settimana o ogni giorno, anziché continuamente.
Un altro aspetto da considerare durante lo sviluppo è come manterrai la pipeline nel tempo. Vorrai creare un modo per monitorarne il funzionamento e poter rilevare e correggere eventuali problemi imprevisti.
Refusi, voci incomplete o duplicate e tipi di file diversi sono solo alcune delle molte sfide che la pipeline può incontrare ben dopo l'implementazione iniziale. Creare un solido sistema di monitoraggio e gestione degli errori può evitarti molti mal di testa.
Per un approfondimento sulla progettazione di data pipeline, in particolare nel contesto del machine learning, dai un'occhiata al corso di DataCamp Designing Machine Learning Workflows in Python.
Come in tutte le attività sui dati, è importante rendere la pipeline solo tanto complessa quanto serve. Pipeline più semplici sono più facili ed economiche da mantenere, più semplici da aggiornare e più comprensibili se devi passarle a un altro ingegnere.
All'inizio del design della pipeline è importante valutare i requisiti del progetto, inclusa l'eventuale scalabilità futura. Questo ti aiuterà a scegliere il giusto livello di complessità.
Per esempio, se ti serve una pipeline temporanea per raccogliere dati da tre sensori per alcuni mesi, potresti considerare una pipeline semplice in un solo passaggio usando una risorsa gratuita e molto diffusa, come Google Drive.
Se invece hai dati sensibili o devi eseguire più trasformazioni, potresti dover creare codice personalizzato in Python o C# con crittografia per la pipeline.
Infine, potresti impostare una pipeline oggi piccola, ma di cui prevedi un'ampia espansione nei prossimi anni. In questo caso, probabilmente vorrai dotarla dell'infrastruttura necessaria a gestire la crescita.
Può essere allettante progettare inizialmente una pipeline ridotta con l'idea di crearne una nuova, più ampia, quando servirà. Può funzionare, ma fai attenzione!
Molti data engineer si ritrovano a dover rattoppare una pipeline non progettata per la scala attuale perché crearne una nuova è considerato troppo costoso o lungo.
Sebbene la semplicità sia fondamentale, se stai creando una pipeline di lungo periodo è prudente costruirla tenendo conto dei piani di espansione previsti.
Alcune domande da considerare all'inizio di un progetto sono:
Una trappola comune per gli ingegneri junior è piegarsi alle tendenze del momento invece di usare gli strumenti migliori per il lavoro.
Un esempio è il tentativo di molte aziende di inserire a forza l'AI generativa nel proprio stack tecnologico senza un valido caso d'uso.
Come professionista dei dati, è importante restare aggiornato su nuove tecnologie e trend. Tuttavia, assicurati di scegliere lo strumento più adatto al tuo progetto invece di seguire le mode che potrebbero portare a una pipeline scadente.
Una volta definito il piano della pipeline, è importante considerare i metodi di ottimizzazione. Vuoi ottenere i dati necessari, con la risoluzione e la frequenza di aggiornamento preferite, minimizzando al contempo le risorse computazionali o i tempi di attraversamento della pipeline.
Un elemento chiave dell'ottimizzazione è monitorare e registrare il flusso dei dati nella pipeline. Questo ti darà visibilità su dove i colli di bottiglia potrebbero rallentare il flusso o consumare più risorse.
I colli di bottiglia più comuni includono sorgenti lente, vincoli di risorse o trasformazioni inefficienti.
Una volta individuati i colli di bottiglia, puoi valutare modi per ottimizzare le prestazioni:
Un'altra considerazione è la frequenza di refresh dei dati. Se i dati vengono aggiornati ogni minuto ma ti serve un aggiornamento solo ogni cinque, ridurre gli aggiornamenti non necessari può liberare risorse e diminuire i consumi energetici.
Alcuni tipi di dati che fluiscono nelle pipeline possono sollevare preoccupazioni di sicurezza o privacy. I dati medici, per esempio, sono altamente regolamentati dal governo statunitense e richiedono misure di sicurezza molto più rigorose rispetto ai dati sulle abitudini di fruizione dei media. Altri esempi di dati che richiedono maggiore sicurezza sono quelli finanziari e le password.
Le misure di sicurezza da adottare dipendono dalle esigenze del tipo di dato. In alcuni casi, può bastare l'anonimizzazione, in cui le informazioni personali vengono separate o eliminate dal dataset. Questo può essere usato nella ricerca medica quando non servono identificativi personali ma altre informazioni della cartella clinica sì.
Altre misure includono la crittografia e il controllo degli accessi tramite autorizzazioni di login. Questi metodi possono essere usati per dati finanziari o segreti aziendali.
Per tutti i dati sensibili, è importante conoscere e rispettare le normative, come il GDPR (Regolamento generale sulla protezione dei dati) o l'HIPAA (Health Insurance Portability and Accountability Act).
A seconda del settore e dei tipi di dati trattati, potresti dover rispettare regolamenti aggiuntivi, come il CCPA (California Consumer Privacy Act) o il FERPA (Family Educational Rights and Privacy Act).
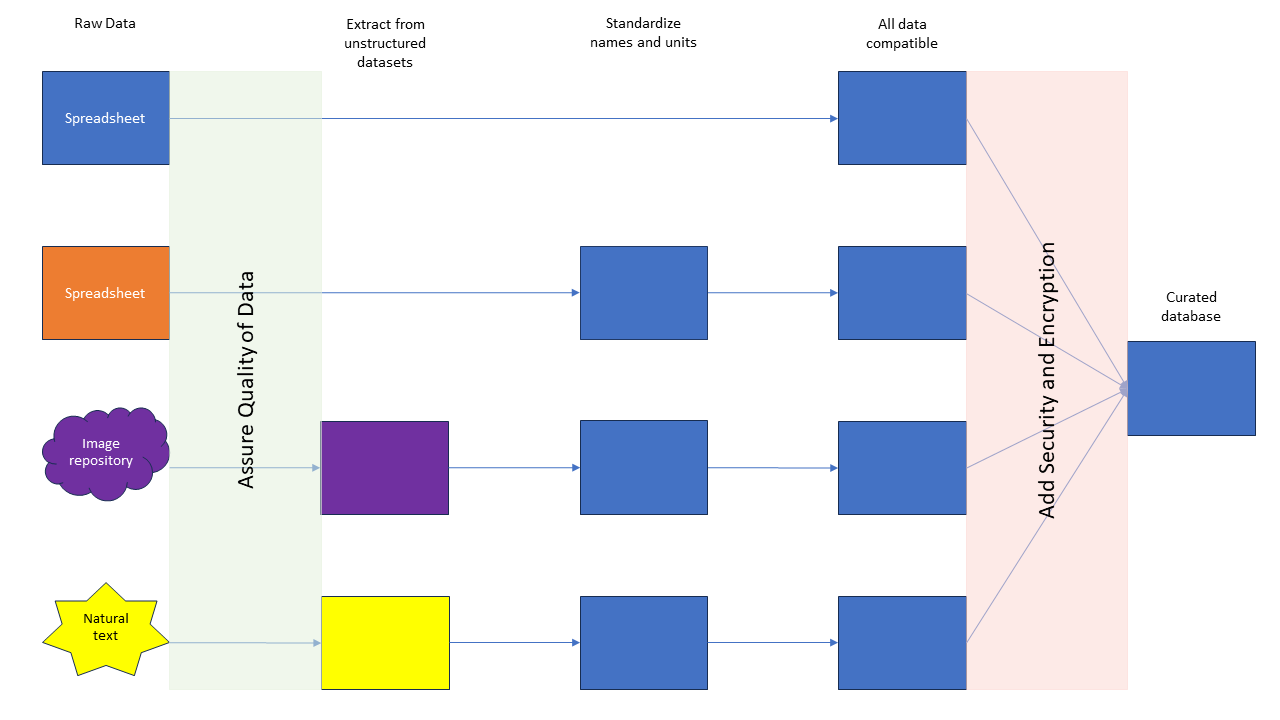
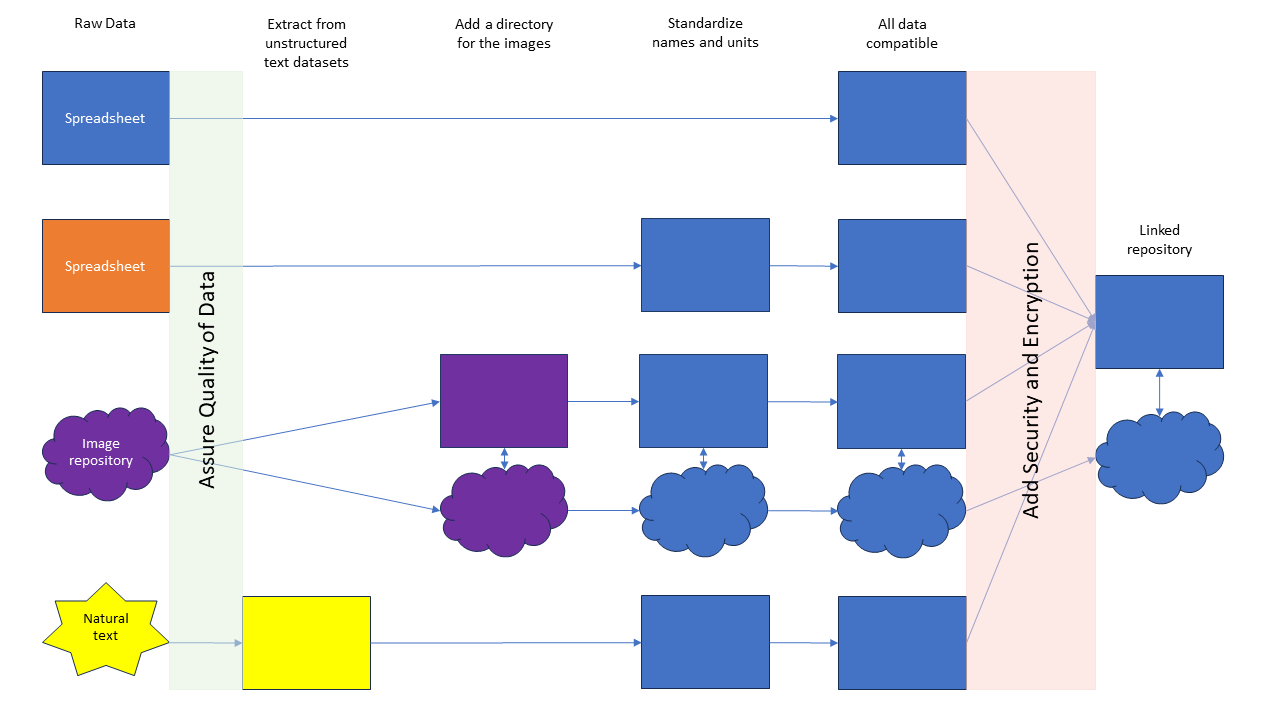
Figura 6: Esempio di aggiunta di passaggi di quality assurance e sicurezza in una pipeline.
Le data pipeline e gli ingegneri che le costruiscono sono gli eroi silenziosi del mondo dei dati. Consentono ai dati di fluire senza soluzione di continuità da un luogo all'altro, organizzandoli e ordinandoli. Secondo Statista, solo nel 2020 il mondo ha generato, consumato e archiviato 64,2 zettabyte di dati, e questa cifra cresce ogni anno.
Costruire e mantenere pipeline robuste è sempre più critico in questo contesto. Se questo tutorial ha stuzzicato il tuo interesse, dai un'occhiata a questo corso introduttivo per un approfondimento. Se vuoi imparare a costruire data pipeline, consulta questo corso di Data Engineering in Python per iniziare. E se vuoi avviare la tua carriera e dimostrare le tue competenze ai datori di lavoro, scopri la nostra Certificazione Data Engineer.
Inizia a imparare a usare le data pipeline oggi stesso!
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



