
कोर्स
जिम्मेदार AI डेटा मैनेजमेंट
1 घंटा
11.1K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंडेटा फेडरेशन एक डेटा इंटीग्रेशन तकनीक है जो बिना भौतिक समेकन के, कई स्रोतों से डेटा का एक एकीकृत दृश्य प्रदान करती है। इसे एक उन्नत तंत्र की तरह समझें जो आपको विभिन्न सिस्टमों में मौजूद डेटा तक वास्तविक समय में ऐसे पहुंच और क्वेरी करने देता है मानो वह सब एक ही स्थान पर संग्रहीत हो।
कई संगठन विभिन्न स्रोतों से विशाल मात्रा में डेटा संभालते हैं। सूचित निर्णय लेने के लिए यह महत्वपूर्ण है कि आप इस डेटा तक वास्तविक समय में बिना डेटा डुप्लीकेशन की झंझट के पहुंचें और उसका विश्लेषण करें। डेटा फेडरेशन यही संभव बनाता है।
कुछ डेटा आर्किटेक्चर में डेटा फेडरेशन का उपयोग डेटा के समेकन के लिए भी होता है, जैसे डेटा फैब्रिक्स में (इस लेख में पढ़ें डेटा फैब्रिक क्या है)।
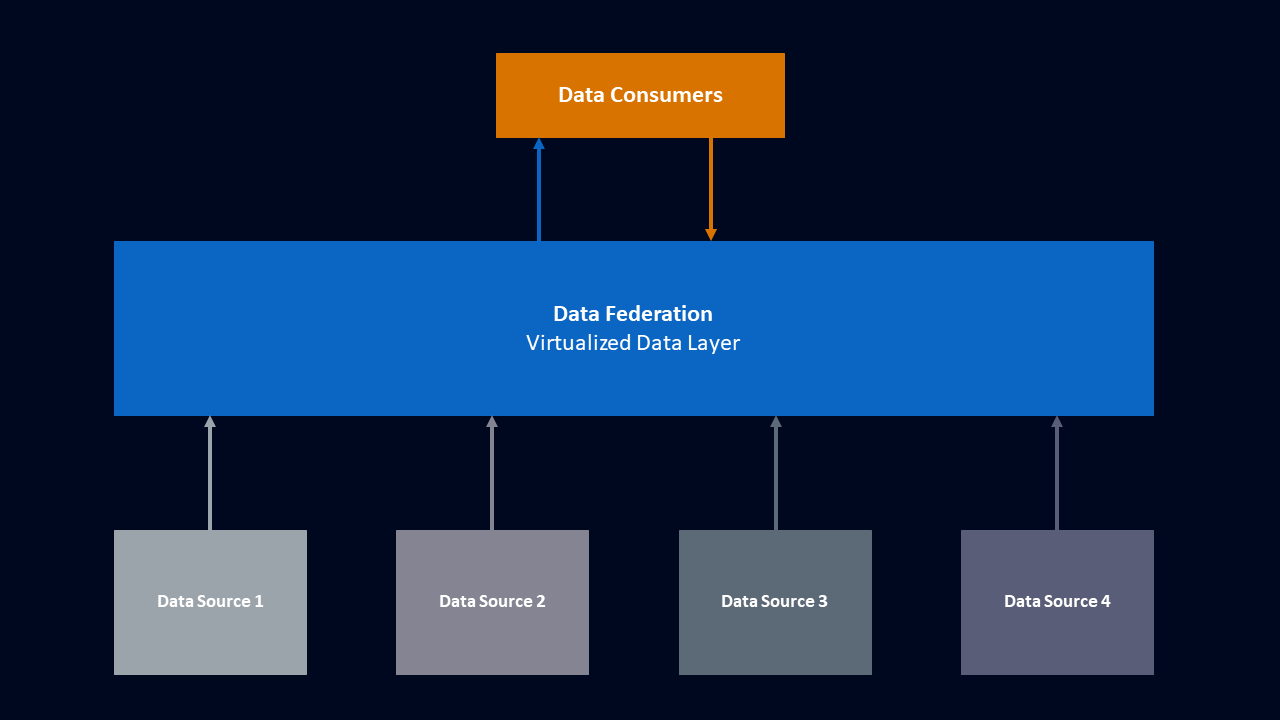
ऊपर दिया गया ग्राफिक डेटा फेडरेशन का एक सरलीकृत दृश्य है। डेटा फेडरेशन कई अलग-अलग स्रोतों से डेटा को वर्चुअलाइज़ और एग्रीगेट करता है ताकि डेटा उपभोक्ता उससे इंटरैक्ट कर सकें।
डेटा फेडरेशन कई मुख्य सिद्धांतों पर कार्य करता है। आइए उनमें से कुछ पर नज़र डालते हैं।
डेटा को भौतिक रूप से स्थानांतरित करने के बजाय, डेटा फेडरेशन उसे मूल स्रोत स्थान पर ही रखता है और एक वर्चुअल लेयर के माध्यम से सुलभ बनाता है। यह दृष्टिकोण डेटा डुप्लीकेशन की आवश्यकता को समाप्त करता है और साथ ही सबसे अद्यतन जानकारी तक वास्तविक समय में पहुंच सुनिश्चित करता है। डेटा एक्सेस को वर्चुअलाइज़ करके, संगठन अपने डेटा की अखंडता और सुरक्षा को मूल स्थान पर बनाए रख सकते हैं और साथ ही एकीकृत दृश्य का लाभ उठा सकते हैं।
उपयोगकर्ता एक ही इंटरफ़ेस या क्वेरी भाषा के साथ इंटरैक्ट करते हैं, जिससे कई स्रोतों से डेटा तक पहुंचने की प्रक्रिया सरल हो जाती है। यह एकीकृत एक्सेस डेटा पुनर्प्राप्ति को सुगम बनाता है। इस प्रक्रिया से विश्लेषक, डेटा वैज्ञानिक और अन्य हितधारक प्रत्येक डेटा स्रोत की जटिलताओं से गुजरे बिना आसानी से डेटा पर क्वेरी और विश्लेषण कर सकते हैं।
स्कीमा एक ब्लूप्रिंट है जो परिभाषित करता है कि किसी डेटाबेस में डेटा कैसे व्यवस्थित होता है। डेटा स्रोत अक्सर अलग-अलग स्कीमा रखते हैं, यानी वे अपने डेटा को अलग तरीके से व्यवस्थित और लेबल करते हैं। स्कीमा मैपिंग में इन स्कीमाओं को संरेखित करना शामिल है ताकि एक सुसंगत डेटा दृश्य बनाया जा सके।
उदाहरण के लिए, एक डेटा स्रोत ग्राहक पहचानकर्ता के लिए "CustomerID" का उपयोग कर सकता है, जबकि दूसरा "CustID" का। स्कीमा मैपिंग इन अलग-अलग लेबलों का अनुवाद करके उन्हें एक ही इकाई के रूप में समझने योग्य बनाता है।
विभिन्न स्कीमाओं को समरस बनाकर, डेटा फेडरेशन टूल यह सुनिश्चित करते हैं कि विविध स्रोतों से डेटा को बिना बाधा के एकीकृत किया जा सके। इससे उपयोगकर्ताओं को सटीक विश्लेषण और रिपोर्टिंग के लिए भरोसेमंद, सुसंगत डेटा मॉडल मिलता है।
डेटा फेडरेशन ऑन-डिमांड प्रोसेसिंग पर जोर देता है। फेडरेटेड स्रोतों पर क्वेरी वास्तविक समय में निष्पादित होती हैं, जिससे डेटा डुप्लीकेशन कम होता है और उपयोगकर्ताओं को सबसे ताज़ा डेटा तक पहुंच मिलती है। यह डायनेमिक प्रोसेसिंग क्षमता समय पर निर्णय लेने और विश्लेषण के लिए महत्वपूर्ण है। ऑन-डिमांड डेटा प्रोसेस करके, डेटा फेडरेशन चुस्त और सूचित निर्णय लेने में सहायक होता है।
अब जब हमें पता है कि डेटा फेडरेशन क्या है, तो देखते हैं यह काम कैसे करता है।
डेटा फेडरेशन विभिन्न स्रोतों से डेटा को सहजता से एकीकृत करता है। इसके केंद्र में एक संरचित आर्किटेक्चर होता है, जिसे कुशलतापूर्वक इस एकीकरण को सुगम बनाने के लिए डिज़ाइन किया गया है। इस आर्किटेक्चर के तीन मुख्य भाग होते हैं:
डेटा स्रोतों को द्वीपों की तरह समझा जा सकता है, जिनमें से प्रत्येक में मूल्यवान जानकारी होती है। ये स्रोत डेटाबेस में संरचित डेटा से लेकर क्लाउड स्टोरेज में असंरचित डेटा और वास्तविक समय के डेटा स्ट्रीम तक फैले होते हैं। डेटा फेडरेशन इन विविध स्रोतों को एकीकृत करता है और डेटा परिदृश्य का एक सुसंगत दृश्य बनाता है।
फेडरेशन लेयर डेटा तक पहुंचने और उस पर क्वेरी करने के लिए एक एकीकृत इंटरफ़ेस प्रदान करता है। यह उपयोगकर्ता क्वेरी को ऐसे कमांड में अनुवाद करता है जिन्हें प्रत्येक डेटा स्रोत समझ सके, जिससे वास्तविक समय में पहुंच और प्रोसेसिंग सुगम होती है। यह लेयर डेटा अखंडता बनाए रखने, कुशल डेटा पुनर्प्राप्ति सुनिश्चित करने और सभी स्रोतों में सुसंगत डेटा दृश्य प्रदान करने के लिए महत्वपूर्ण है।
हम इस फेडरेशन लेयर को प्रत्येक डेटा द्वीप की लाइव वीडियो स्ट्रीम की तरह समझ सकते हैं। यह डेटा उपभोक्ताओं को प्रत्येक द्वीप पर मौजूद डेटा को देखना और उपयोग करना संभव बनाता है, बिना उसे कहीं स्थानांतरित या कॉपी किए।
विभिन्न अनुप्रयोग और टूल, जैसे बिज़नेस इंटेलिजेंस प्लेटफ़ॉर्म, डेटा साइंस परिवेश, और ऑपरेशनल सिस्टम, फेडरेशन लेयर के माध्यम से फेडरेटेड डेटा के साथ इंटरैक्ट करते हैं। इन टूल्स के जरिए डेटा विश्लेषक, डेटा वैज्ञानिक और अन्य डेटा उपभोक्ता डेटा का उपयोग कर सकते हैं। फिर ये डेटा उपभोक्ता विश्लेषण, रिपोर्टिंग और निर्णय लेने के लिए एकीकृत डेटा का लाभ उठा सकते हैं।
जब हम किसी फेडरेटेड सिस्टम को क्वेरी सबमिट करते हैं, तो वह सबसे पहले फेडरेशन लेयर तक जाती है। फेडरेशन लेयर को एक स्मार्ट अनुवादक की तरह समझें। यह हमारी मुख्य क्वेरी को लेकर उसे छोटे-छोटे सबक्वेरी में विभाजित करती है। हर सबक्वेरी को उस स्रोत से डेटा लाने के लिए अनुकूलित किया जाता है जहाँ वह जानकारी संग्रहीत है, जैसे डेटाबेस या क्लाउड स्टोरेज।
ये सबक्वेरी फिर वास्तविक समय में विभिन्न डेटा स्रोतों को भेजी जाती हैं। प्रत्येक स्रोत अपनी क्वेरी का हिस्सा प्रोसेस करता है और परिणाम वापस भेजता है। फेडरेशन लेयर तब इन सभी परिणामों को एकत्र करके एक समेकित परिणाम में जोड़ देती है।
यह सुव्यवस्थित प्रक्रिया हमें कई स्रोतों से डेटा तक पहुंचने और उसका विश्लेषण करने देती है मानो वह एक एकीकृत डेटासेट हो। इससे संगठन भर में बिखरे डेटा को इकट्ठा करना आसान हो जाता है।
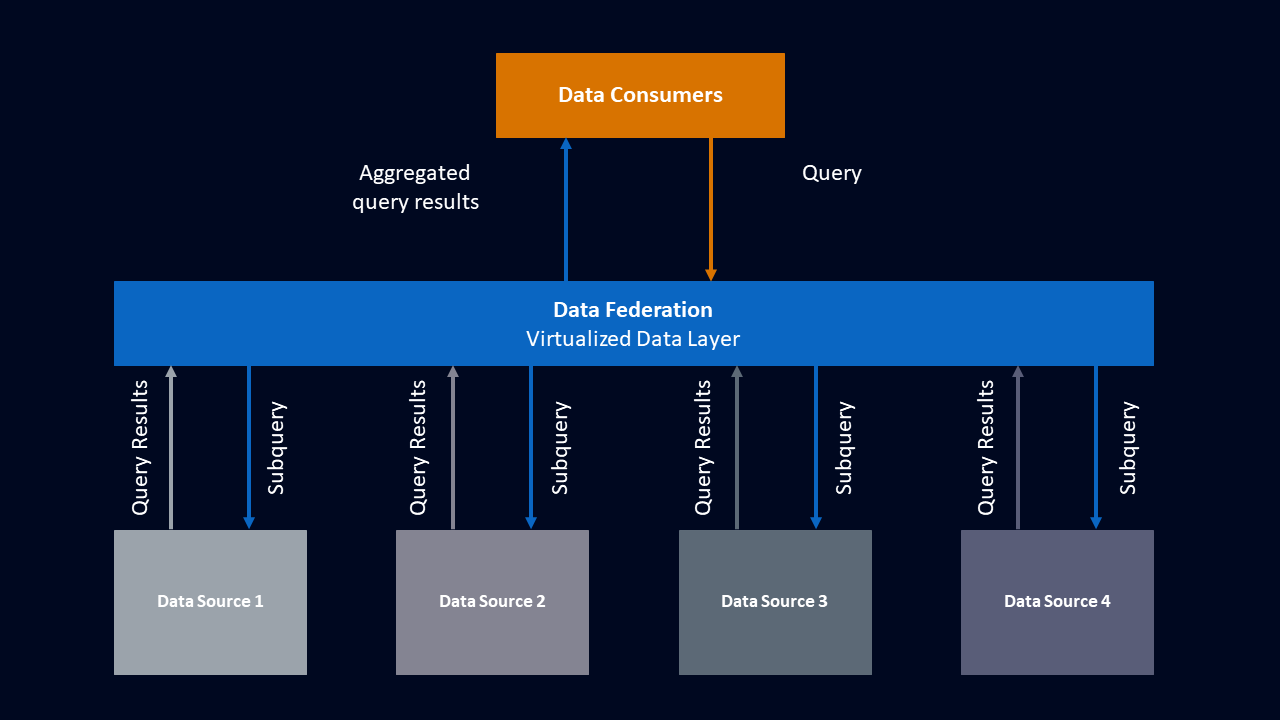
ऊपर दिया गया ग्राफिक इस प्रक्रिया का एक सरलीकृत दृश्य है। एक डेटा उपभोक्ता डेटा फेडरेशन से क्वेरी करता है। यह उस क्वेरी को कई सबक्वेरी में तोड़कर उपयुक्त डेटा स्रोतों को भेज देता है। प्रत्येक स्रोत अपने परिणाम लौटाता है, जिन्हें डेटा फेडरेशन समेकित करके डेटा उपभोक्ता तक पहुँचाता है।
जटिल डेटा परिदृश्य वाले संगठनों के लिए डेटा फेडरेशन कई महत्वपूर्ण लाभ प्रदान करता है।
डेटा की प्रतियों को न्यूनतम रखते हुए, फेडरेशन स्टोरेज लागत घटाता है और डेटासेट्स में असंगतियों के जोखिम को भी कम करता है। यह सुव्यवस्थित दृष्टिकोण संसाधन आवंटन को अनुकूलित करता है और डेटा अखंडता को बढ़ाता है।
डेटा फेडरेशन संगठन भर के डेटा पर क्वेरी करने के लिए एक ही स्थान प्रदान करके डेटा एक्सेस को सरल बनाता है। यह केंद्रीकृत एक्सेस बिंदु डेटा पुनर्प्राप्ति और विश्लेषण को सुव्यवस्थित करता है। डेटा फेडरेशन का वास्तविक समय वाला स्वभाव सुनिश्चित करता है कि उपयोगकर्ताओं को सभी फेडरेटेड स्रोतों में सबसे ताज़ा डेटा तक पहुंच हो, जो समय पर निर्णय लेने के लिए महत्वपूर्ण है।
डेटा फेडरेशन पारंपरिक रूप से डेटा समेकन से जुड़ी जटिल ETL (extract, transform, load) प्रक्रियाओं की आवश्यकता को खत्म करके डेटा इंटीग्रेशन प्रयासों को सरल बनाता है। इससे डेटा इंटीग्रेशन की गति बढ़ती है और त्रुटियों की संभावना कम होती है।
डेटा फेडरेशन की अंतर्निहित लचीलापन संगठनों को मौजूदा अनुप्रयोगों या वर्कफ़्लोज़ में बाधा डाले बिना आवश्यकता अनुसार डेटा स्रोत जोड़ने या हटाने में सक्षम बनाता है। यह लचीलापन संगठनों को बदलती डेटा आवश्यकताओं के अनुरूप तेज़ी से ढलने देता है, बिना कठोर डेटा आर्किटेक्चर द्वारा बाधित हुए।
कई फ़ायदों के बावजूद, डेटा फेडरेशन कुछ चुनौतियाँ भी प्रस्तुत करता है जिनका संगठनों को समाधान करना चाहिए।
कई स्रोतों पर जटिल क्वेरी के कारण परफॉर्मेंस से जुड़ी समस्याएँ उत्पन्न हो सकती हैं। अनुकूलन प्रयास कुशल डेटा पुनर्प्राप्ति और प्रोसेसिंग सुनिश्चित करने में सहायक हो सकते हैं। मज़बूत इन्फ्रास्ट्रक्चर में निवेश करना और क्वेरी ऑप्टिमाइज़ेशन तकनीकों का उपयोग करना महत्वपूर्ण है। ये परफॉर्मेंस बाधाओं को कम कर सकते हैं और डेटा एक्सेस तथा विश्लेषण में प्रतिक्रियाशीलता बनाए रख सकते हैं।
एक अन्य महत्वपूर्ण चुनौती स्कीमा की जटिलता है। विविध स्रोतों से स्कीमा को मैप करना कठिन हो सकता है। डेटा स्रोतों की भिन्न संरचनाएँ स्कीमा को समरस करने और फेडरेटेड डेटा में सुसंगतता सुनिश्चित करने के लिए उन्नत टूल और तकनीकों की मांग करती हैं। डेटा पेशेवर इन चुनौतियों से निपटने के लिए डेटा मॉडलिंग और स्कीमा मैपिंग रणनीतियों का उपयोग कर सकते हैं। इस तरह, हम डेटा का एक एकीकृत दृश्य बना सकते हैं जो उसकी अंतर्निहित तात्पर्य को सटीक रूप से दर्शाता है।
स्कीमा मैपिंग के बारे में और जानने के लिए, मैं आपको यह Database Design कोर्स देखने का सुझाव देता/देती हूँ।
फेडरेटेड डेटा के साथ डेटा गवर्नेंस चुनौतीपूर्ण हो सकता है। संगठनों को फेडरेटेड स्रोतों में डेटा गुणवत्ता, सुरक्षा और गोपनीयता के लिए नीतियाँ स्थापित और लागू करनी चाहिए। डेटा गवर्नेंस प्रक्रियाएँ लागू करना महत्वपूर्ण है, जैसे डेटा लीनिएज ट्रैकिंग, एक्सेस कंट्रोल और गोपनीयता उपाय। ये जोखिमों को कम करने और फेडरेटेड डेटा की अखंडता बनाए रखने में सहायक होते हैं।
डेटा गवर्नेंस पर अधिक जानकारी के लिए देखें Making Data Governance Fun और How Data Leaders Can Make Data Governance a Priority। यह डेटा गवर्नेंस चीट शीट भी एक अच्छा संसाधन है।
डेटा फेडरेशन किसी संगठन के सभी स्तरों पर उपयोगी है।
डेटा फेडरेशन विश्लेषकों को ऐसे व्यापक रिपोर्ट और डैशबोर्ड बनाने में सक्षम बनाता है जो अलग-अलग विभागों या सिस्टमों से डेटा को एग्रीगेट करते हैं। जानकारी का एकीकृत दृश्य प्रदान करके, संगठन अपने संचालन के बारे में मूल्यवान अंतर्दृष्टि प्राप्त करते हैं, जो सूचित निर्णय लेने और रणनीतिक योजना में सहायक है।
मॉडल प्रशिक्षण और वैलिडेशन के लिए विविध डेटा स्रोतों तक आसान पहुंच के साथ, डेटा वैज्ञानिक अपनी संस्था में उपलब्ध जानकारी के पूरे स्पेक्ट्रम का उपयोग कर सकते हैं। यह एग्रीगेटेड डेटा डेटा मॉडलों की सटीकता और मज़बूती में सुधार कर सकता है, जिससे पूर्वानुमान क्षमता बढ़ती है। डेटा फेडरेशन उन डेटा वैज्ञानिकों का समय भी बचाता है जिन्हें अन्यथा अपने मॉडलों को चलाने के लिए जटिल डेटा पाइपलाइन्स बनानी पड़तीं।
अलग-अलग स्रोतों से डेटा स्ट्रीम को एग्रीगेट करके, संगठन अपने संचालन का समग्र दृश्य प्राप्त करते हैं, बाधाओं की पहचान करते हैं और वर्कफ़्लोज़ को अनुकूलित करते हैं। इससे संगठन की समग्र दक्षता में सुधार होता है। डेटा की वास्तविक समय दृश्यता निर्णयकर्ताओं को बदलती परिस्थितियों पर शीघ्र प्रतिक्रिया देने में सक्षम बनाती है।
डेटा फेडरेशन सहायक होता है जब ऑडिटरों को विभिन्न स्रोतों में आपके डेटा का संपूर्ण दृश्य चाहिए होता है। डेटा तक पहुँचने और उसका विश्लेषण करने के लिए एक एकीकृत प्लेटफ़ॉर्म प्रदान करके, डेटा फेडरेशन नियमों का पालन करने और ऑडिट करने को आसान बना सकता है। अनुपालन ऑडिट को सरल बनाने के लिए डेटा फेडरेशन को डेटा लीनिएज और उचित डॉक्यूमेंटेशन के साथ जोड़ा जाना चाहिए।
यह भी देखें What Is Data Lineage और Data Governance Concepts अधिक जानकारी के लिए।
डेटा फेडरेशन को कभी-कभी डेटा वेयरहाउसिंग के साथ भ्रमित किया जाता है। हालांकि, दोनों के बीच कुछ महत्वपूर्ण अंतर हैं।
डेटा फेडरेशन वर्चुअलाइज़ेशन के सिद्धांत पर काम करता है, जहाँ डेटा अपने मूल स्थानों पर बना रहता है और एक वर्चुअल लेयर के माध्यम से वास्तविक समय में एक्सेस किया जाता है। यह दृष्टिकोण उपयोगकर्ताओं को डुप्लीकेशन की आवश्यकता के बिना सबसे ताज़ा डेटा तक पहुंचने में सक्षम बनाता है, स्टोरेज लागत को कम करता है और डेटासेट्स में असंगतियों को घटाता है।
डेटा वेयरहाउसिंग डेटा को एक केंद्रीकृत रिपॉज़िटरी में समेकित करता है। यह केंद्रीकृत दृष्टिकोण ऐतिहासिक डेटा को संग्रहीत करने के लिए उपयुक्त है और पिछले रुझानों का व्यापक दृश्य प्रदान करता है। हालांकि, डेटा वेयरहाउसिंग में आमतौर पर विभिन्न स्रोतों से डेटा को वेयरहाउस में समेकित करने के लिए व्यापक ETL प्रक्रियाएँ आवश्यक होती हैं।
आप डेटा वेयरहाउस के बारे में और जान सकते हैं इस Introduction to Data Warehousing Concepts कोर्स में या इस ट्यूटोरियल में सही क्लाउड डेटा वेयरहाउस समाधान का चुनाव।
डेटा फेडरेशन और डेटा वेयरहाउसिंग, डेटा इंटीग्रेशन के अलग-अलग दृष्टिकोण पेश करते हैं। प्रत्येक के अपने गुण और सीमाएँ हैं।
डेटा फेडरेशन, डेटा डुप्लीकेशन को न्यूनतम रखते हुए, ताज़ा डेटा तक वास्तविक समय की पहुंच प्रदान करने में उत्कृष्ट है। यह गतिशील और चुस्त परिवेशों के लिए आदर्श है।
डेटा वेयरहाउसिंग ऐतिहासिक डेटा को संग्रहीत और विश्लेषित करने के लिए सबसे उपयुक्त है। इसमें अधिक व्यापक ETL प्रक्रियाओं की आवश्यकता हो सकती है और यह डेटा फेडरेशन जितना लचीला नहीं होता।
डेटा फेडरेशन और डेटा वेयरहाउसिंग में से चुनाव करते समय, विशिष्ट उपयोग का मामला, डेटा वॉल्यूम और वास्तविक समय बनाम ऐतिहासिक विश्लेषण की आवश्यकता पर विचार करें।
आपके डेटा परिदृश्य के आधार पर, डेटा फेडरेशन को लागू करना चुनौतीपूर्ण हो सकता है। लेकिन सावधानीपूर्वक योजना, उपयुक्त टूल्स के चयन, और हमारी संस्था की आवश्यकताओं पर विचार के साथ, यह एक प्रबंधनीय कार्य है जो अच्छे परिणाम देगा। किसी भी फेडरेशन इम्प्लीमेंटेशन में विचार करने के लिए यहाँ कुछ चरण दिए गए हैं।
हमें अपनी संस्था के वर्तमान डेटा परिदृश्य का पूरी तरह से आकलन करके शुरू करना चाहिए। अलग-अलग सिस्टम, डेटाबेस और अनुप्रयोगों में मौजूद डेटा स्रोतों की पहचान करें। प्रत्येक स्रोत में संग्रहीत डेटा के प्रकार और उनके अपडेट की आवृत्ति जानें। इससे यह सुनिश्चित करने में मदद मिलेगी कि हमारा डेटा फेडरेशन समाधान सबसे ताज़ा डेटा तक वास्तविक समय पहुंच को समायोजित कर सके।
किसी भी परियोजना की तरह, हमारे लक्ष्यों को स्पष्ट रूप से परिभाषित करना महत्वपूर्ण है। संगठन के भीतर डेटा फेडरेशन के लिए उपयोग के मामले और आवश्यकताएँ तय करें। वे विशिष्ट व्यावसायिक उद्देश्यों का निर्धारण करें जिन्हें आप डेटा फेडरेशन के माध्यम से प्राप्त करना चाहते हैं। इनमें डेटा एक्सेसिबिलिटी में सुधार, डेटा इंटीग्रेशन प्रक्रियाओं को सुव्यवस्थित करना, या वास्तविक समय एनालिटिक्स सक्षम करना शामिल हो सकता है। प्रमुख हितधारकों की पहचान करें और उनकी आवश्यकताओं की पूर्ति सुनिश्चित करने के लिए उन्हें इस चरण में शामिल करें।
संगठन की आवश्यकताओं और बजट सीमाओं के आधार पर उपयुक्त टूल्स और तकनीकों का चयन करें। डेटा वर्चुअलाइज़ेशन क्षमताएँ, स्केलेबिलिटी, मौजूदा सिस्टमों के साथ इंटीग्रेशन की सहजता, और विभिन्न डेटा स्रोतों के लिए समर्थन जैसे कारकों पर विचार करें। हमारी जरूरतों के लिए सबसे उपयुक्त विकल्प खोजने के लिए व्यावसायिक और ओपन-सोर्स दोनों विकल्पों का मूल्यांकन करें। नीचे डेटा फेडरेशन में उपयोग होने वाले कुछ लोकप्रिय टूल्स की तालिका दी गई है।
|
टूल |
फीचर्स |
लाइसेंसिंग मॉडल |
|
रीयल-टाइम डेटा एक्सेस, स्कीमा मैपिंग, क्वेरी ऑप्टिमाइज़ेशन |
पेड |
|
|
लचीला और एक्स्टेंसिबल, कस्टम डेटा फेडरेशन समाधान |
ओपन-सोर्स |
|
|
मानक SQL का उपयोग करके Amazon S3 में संग्रहीत डेटा पर क्वेरी |
पेड |
ऐसा फेडरेशन डिज़ाइन करें जो संगठन की आवश्यकताओं और उपयोग के मामलों के अनुरूप हो। मौजूदा इन्फ्रास्ट्रक्चर में फेडरेशन लेयर का स्थान निर्धारित करें और डेटा स्रोतों तथा डेटा उपभोक्ताओं के साथ इंटीग्रेशन बिंदु परिभाषित करें। डेटा सुरक्षा, परफॉर्मेंस ऑप्टिमाइज़ेशन और स्केलेबिलिटी पर विचार करें ताकि फेडरेशन वर्तमान और भविष्य की डेटा आवश्यकताओं का समर्थन कर सके।
एक बार हमारा डेटा फेडरेशन सेटअप हो जाए और हमारे डेटा स्रोतों से कनेक्ट होने के लिए कॉन्फ़िगर कर दिया जाए, तो यह सुनिश्चित करना महत्वपूर्ण है कि यह सही ढंग से काम कर रहा है। समाधान का अच्छी तरह परीक्षण करें ताकि किसी भी समस्या या परफॉर्मेंस बाधा की पहचान हो सके और आवश्यकता अनुसार इम्प्लीमेंटेशन को परिष्कृत करें।
डेटा फेडरेशन समाधान को प्रोडक्शन में परिनियोजित करें और उसके परफॉर्मेंस और विश्वसनीयता की निगरानी करें। किसी भी समस्या का सक्रिय रूप से पता लगाने और समाधान करने के लिए मॉनिटरिंग और अलर्टिंग तंत्र स्थापित करें। समाधान को प्रभावी बनाए रखने और बदलती व्यावसायिक आवश्यकताओं के अनुरूप रखने के लिए फेडरेशन आर्किटेक्चर और डेटा इंटीग्रेशन प्रक्रियाओं का निरंतर अनुकूलन करें।
डेटा फेडरेशन उन संगठनों के लिए महत्वपूर्ण लाभ प्रदान करता है जो अलग-अलग सिस्टमों में बिखरे डेटा के मूल्य को अनलॉक करना चाहते हैं। कई स्रोतों से डेटा का वर्चुअलाइज़्ड, एकीकृत दृश्य प्रदान करके, डेटा फेडरेशन डेटा एक्सेस को बेहतर बनाता है, अनावश्यकता कम करता है और इंटीग्रेशन प्रयासों को सरल बनाता है।
डेटा प्रबंधन के बारे में और जानें An Introduction to Data Pipelines for Aspiring Data Professionals के साथ। मैं इस कोर्स की भी अनुशंसा करता/करती हूँ Responsible AI Data Management।
इन कोर्सेज़ के साथ डेटा प्रबंधन सीखें!
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें