
课程
负责任的 AI 数据管理
1 小时
11.2K
实践并学习路径你的进步。
使用 Google 继续数据联邦是一种数据集成技术,可在无需进行物理合并的情况下,提供来自多个来源的数据统一视图。您可以将其想象为一种高级机制,使您能够像在单一位置存储一样,实时访问并查询各系统中的数据。
许多组织需要处理来自不同来源的大量数据。为做出明智决策,能够在不复制数据的前提下实时访问与分析这些数据至关重要。数据联邦正是实现这一点的方式。
在某些数据架构中,数据联邦也用于整合数据,例如数据织体(可在本文了解什么是数据织体)。
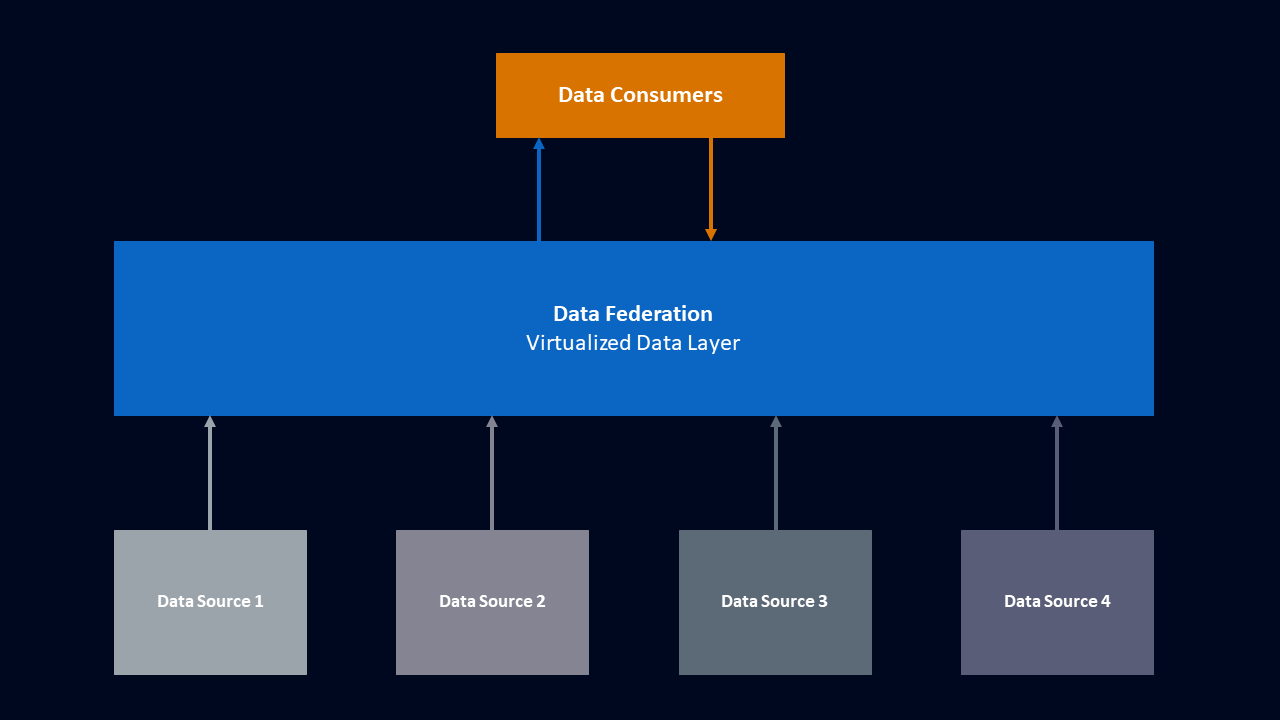
上图是数据联邦的简化视图。数据联邦将来自众多不同来源的数据进行虚拟化与聚合,供数据使用者交互使用。
数据联邦基于若干核心原则运作。我们来依次了解。
数据联邦不对数据进行物理迁移,而是将其保留在原始来源位置,并通过虚拟层进行访问。此方法无需复制数据,同时确保实时获取最新信息。通过虚拟化数据访问,组织既可在数据原地维持其完整性与安全性,又能受益于统一视图。
用户通过单一界面或查询语言进行交互,简化从多个来源访问数据的过程。统一访问使数据获取更为顺畅,使分析师、数据科学家及其他相关方无需处理各数据源的复杂性即可轻松查询与分析数据。
模式是定义数据库中数据如何组织的蓝图。不同数据源往往拥有不同的模式,即它们组织与标注数据的方式各异。模式映射旨在对齐这些模式,从而创建一致的数据视图。
例如,一个数据源可能使用 "CustomerID" 指代客户标识,另一个则使用 "CustID"。模式映射会将这些不同标签转换为同一实体的统一含义。
通过统一不同的模式,数据联邦工具可确保来自多源的数据能够无缝集成,提供一致、可靠的数据模型,便于用户进行准确的分析与报告。
数据联邦强调按需处理。查询会在联邦范围内实时执行,从而最大限度减少数据复制,并确保用户访问到最新数据。这种动态处理能力对于及时决策与分析至关重要。通过按需处理,数据联邦支持敏捷而明智的决策制定。
了解了什么是数据联邦之后,我们来看看其工作原理。
数据联邦能够无缝整合来自不同来源的数据。其核心是为高效集成而设计的结构化架构,该架构由三部分组成:
可以将数据源视为一座座岛屿,每座都承载着有价值的信息。这些来源既包括数据库中的结构化数据,也包括云存储中的非结构化数据以及实时数据流。数据联邦将这些多样化来源整合起来,形成一致的数据全景视图。
联邦层为数据访问与查询提供统一接口。它会将用户查询转换为各数据源可理解的指令,促进实时访问与处理。此层对于维护数据完整性、确保高效的数据检索,以及在所有来源之间提供一致的数据视图至关重要。
我们可以将联邦层类比为各个“数据岛屿”的实时视频流。它让数据使用者无需移动或复制数据,就能查看并使用各岛上的数据。
各类应用与工具(如商业智能平台、数据科学环境和运营系统)通过联邦层与联邦化数据进行交互。借助这些工具,数据分析师、数据科学家以及其他数据使用者可以利用这些数据开展分析、报告与决策。
当我们向联邦系统提交查询时,查询首先到达联邦层。可将联邦层视为一位智能翻译:它会将主查询拆解为更小的子查询。每个子查询都被定制用于从存放相关信息的不同来源(如数据库或云存储)提取数据。
这些子查询随后会实时发送至各数据源。每个来源处理自己的一部分查询并返回结果。联邦层再收集这些结果并将其合并为一个聚合结果。
这一流程使我们能够像处理单一统一数据集那样访问并分析来自多个来源的数据,从而更轻松地汇集整个组织的数据。
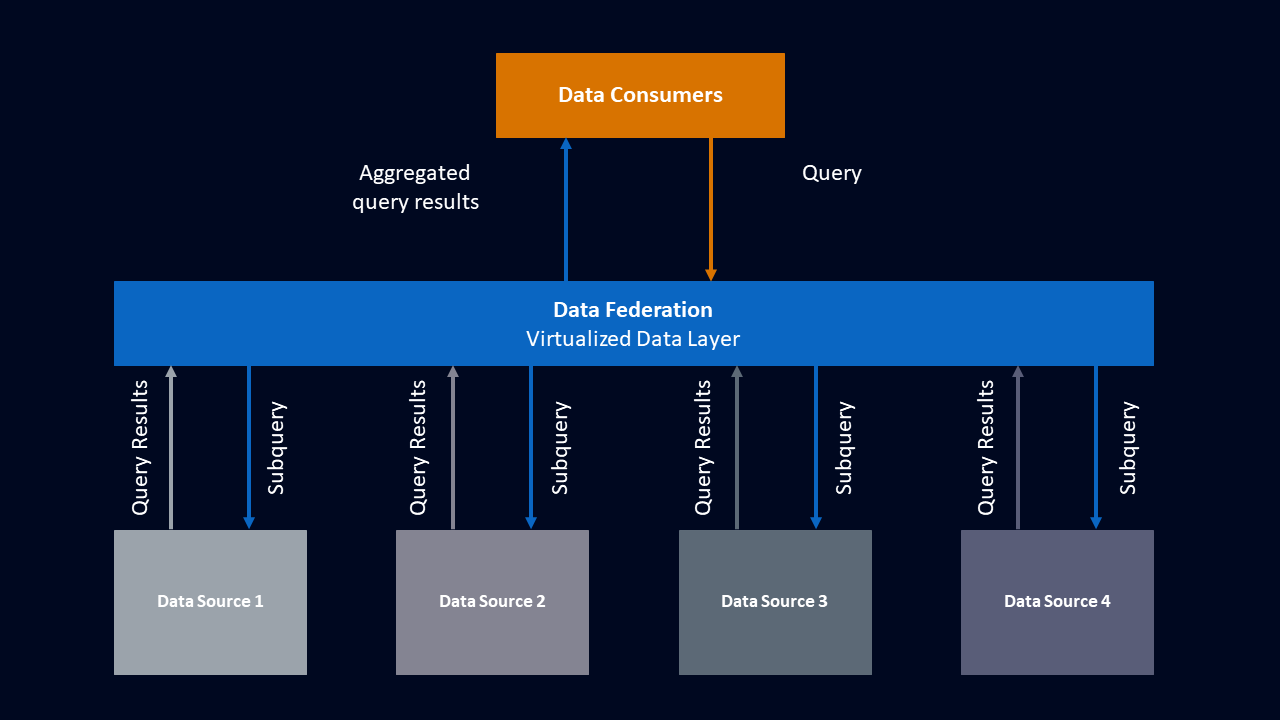
上图是该流程的简化视图。数据使用者向数据联邦发起查询,联邦层将其拆分为一系列子查询,并发送至相应数据源。各来源返回结果后,数据联邦再将其聚合并反馈给数据使用者。
对于数据环境复杂的组织,数据联邦带来多项关键益处。
通过减少数据副本,联邦能够降低存储成本,并减少数据集之间的不一致风险。这种精简方法优化了资源配置并提升了数据完整性。
数据联邦通过提供一个统一的查询入口,简化跨组织的数据访问。该集中式入口使数据检索与分析更为顺畅。数据联邦的实时特性确保用户能够访问到所有联邦来源中的最新数据,这对于及时决策十分重要。
数据联邦无需传统上与数据整合密切相关的复杂 ETL(抽取、转换、加载)流程,从而加速数据集成步伐并降低出错可能性。
数据联邦具备的灵活性使组织能够按需轻松新增或移除数据源,而不必中断既有应用或工作流程。这种灵活性使组织能快速适应不断变化的数据需求,而不受僵化数据架构的限制。
尽管优势众多,数据联邦也存在一些需要组织加以应对的挑战。
跨多个来源的复杂查询可能引发性能问题。通过优化可确保高效的数据检索与处理。重要的是投入稳健的基础设施并采用查询优化技术,以缓解性能瓶颈,保持数据访问与分析的响应性。
另一个重要挑战是模式复杂性。对齐来自多样化来源的模式可能相当艰巨。数据源结构的差异需要采用复杂的工具与技术来统一模式,并确保联邦数据的一致性。数据专业人士可运用数据建模与模式映射策略来应对这些挑战,从而创建能够准确反映底层语义的统一数据视图。
如需进一步了解模式映射,建议您查看这门 Database Design课程。
在联邦化数据环境中,数据治理也充满挑战。组织必须在各联邦来源间建立并执行数据质量、安全与隐私方面的政策。落实数据治理流程(如数据血缘追踪、访问控制与隐私保护措施)至关重要,有助于降低风险并维护联邦数据的完整性。
关于数据治理的更多信息,欢迎收听 Making Data Governance Fun 和 How Data Leaders Can Make Data Governance a Priority。这份 数据治理速查表也是不错的资源。
数据联邦在组织各层面都很有用。
数据联邦使分析师能够创建整合不同部门或系统数据的综合报告与仪表板。通过提供统一的信息视图,组织可对运营获得有价值的洞察,支持明智决策与战略规划。
在便捷访问多样化训练与验证数据源的前提下,数据科学家可以充分利用组织内可用的信息全谱系。聚合后的数据有助于提升数据模型的准确性与稳健性,从而增强预测能力。数据联邦也能为部分数据科学家节省时间,无需搭建复杂的数据管道来驱动其模型。
通过聚合来自不同来源的数据流,组织能够获得运营的全局视图,识别瓶颈并优化工作流,从而提升整体效率。数据的实时可见性也使决策者能够迅速响应变化的状况。
当审计人员需要访问跨多种来源的完整数据视图时,数据联邦尤为有用。通过提供统一的平台来访问与分析数据,数据联邦可使合规与审计更为容易。为便于合规审计,数据联邦应与数据血缘及完善的文档相配合。
请参阅 什么是数据血缘 与 Data Governance Concepts了解更多信息。
数据联邦有时会与数据仓库混淆,但二者之间存在重要区别。
数据联邦遵循虚拟化原则,数据保留在其原始位置,并通过虚拟层进行实时访问。此方法使用户无需复制数据即可访问最新信息,最大限度降低存储成本,并减少数据集之间的不一致。
数据仓库则将数据整合到集中式存储库中。集中式方法适合存放历史数据,提供对过去趋势的全景视图。但数据仓库通常需要大量 ETL 流程来将各来源的数据整合入库。
您可以在这门 Data Warehousing Concepts入门课程或这篇教程 选择合适的云数据仓库方案中了解更多数据仓库知识。
数据联邦与数据仓库代表了不同的数据集成路径,各有优劣。
数据联邦擅长提供对当前数据的实时访问,同时最大限度减少数据复制,适合动态、敏捷的环境。
数据仓库最适合存储与分析历史数据,通常需要更广泛的 ETL 流程,且灵活性不及数据联邦。
在二者之间进行选择时,应综合考虑具体用例、数据量以及对实时或历史分析的需求。
根据您的数据版图,实施数据联邦可能具有一定挑战。但通过周密规划、选择合适的工具,并充分考虑组织需求,这一任务是可控且行之有效的。以下是任何联邦实施中都应考虑的几个步骤。
首先需要全面评估组织当前的数据版图。识别分布在不同系统、数据库与应用中的数据源。了解各来源存储的数据类型及其更新频率,这将有助于确保数据联邦方案能够满足对最新数据的实时访问需求。
与任何项目一样,清晰定义目标至关重要。梳理组织内数据联邦的用例与需求,明确希望通过数据联邦实现的具体业务目标,例如提升数据可访问性、精简数据集成流程或支持实时分析。识别关键相关方并让他们参与此步骤,以确保解决方案同样满足其需求。
基于组织需求与预算选择合适的工具与技术。考虑数据虚拟化能力、可扩展性、与既有系统的集成便利性以及对多种数据源的支持等因素。评估商业与开源选项,找到最契合我们需求的方案。下表列出了一些用于数据联邦的常见工具。
|
工具 |
功能 |
授权模式 |
|
实时数据访问、模式映射、查询优化 |
付费 |
|
|
灵活且可扩展,可构建自定义数据联邦方案 |
开源 |
|
|
使用标准 SQL 查询存储在 Amazon S3 中的数据 |
付费 |
设计与组织需求和用例相匹配的联邦。确定联邦层在现有基础设施中的位置,并定义与数据源及数据使用者的集成点。综合考虑数据安全、性能优化与可扩展性,确保联邦既能满足当前也能支撑未来的数据需求。
当数据联邦搭建完成并配置好与数据源的连接后,务必确保其正常运行。对解决方案进行全面测试,识别潜在问题或性能瓶颈,并按需优化实施方案。
将数据联邦方案部署至生产环境,并对其性能与可靠性进行监控。建立监测与告警机制,主动发现并处理问题。持续优化联邦架构与数据集成流程,以确保解决方案始终有效,并与不断演进的业务需求保持一致。
对于希望释放分散在不同系统中的数据价值的组织而言,数据联邦大有裨益。通过提供来自多个来源的虚拟化统一视图,数据联邦提升了数据可访问性、降低了冗余,并简化了集成工作。
通过以下内容进一步学习数据管理: 面向新晋数据从业者的数据管道入门。我也推荐这门课程: Responsible AI Data Management。
通过这些课程学习数据管理!
课程
课程
实践并学习路径你的进步。
使用 Google 继续