
Cours
Gestion responsable des données pour l’IA
1 h
10.7K
Permettez à votre équipe d'accéder à l'ensemble de la bibliothèque DataCamp, avec des rapports centralisés, des missions, des projets et bien d'autres choses encore.
La fédération de données est une technique d’intégration qui fournit une vue unifiée de données issues de multiples sources sans les consolider physiquement. Imaginez un mécanisme avancé permettant d’accéder et d’interroger, en temps réel, des données réparties sur différents systèmes comme si elles étaient stockées en un seul endroit.
De nombreuses organisations gèrent de grands volumes de données provenant de sources variées. Pour prendre des décisions éclairées, il est essentiel d’y accéder et de les analyser en temps réel, sans dupliquer les données. La fédération de données rend cela possible.
La fédération de données est également utilisée dans certaines architectures pour consolider les données, comme les data fabrics (à lire dans cet article sur ce qu’est un data fabric).
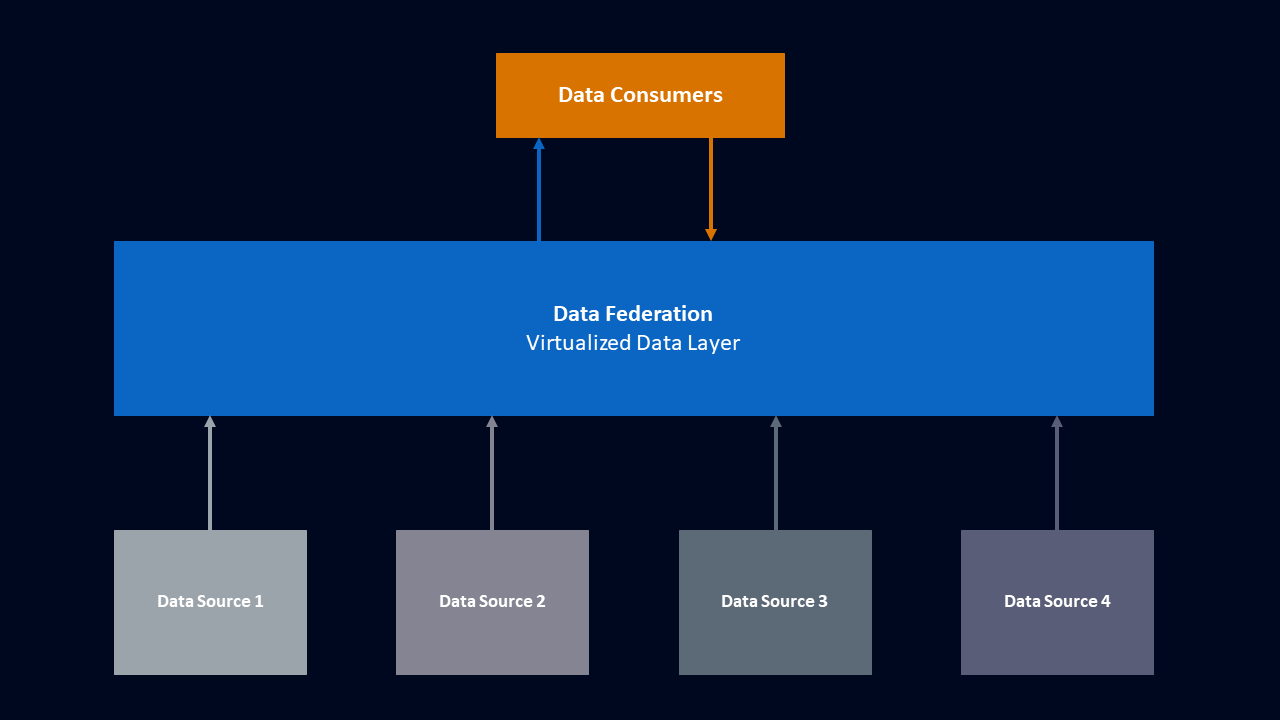
Le schéma ci-dessus montre une vue simplifiée d’une fédération de données. La couche de fédération virtualise et agrège des données issues de nombreuses sources, avec lesquelles les consommateurs de données peuvent interagir.
Une fédération de données repose sur plusieurs principes fondamentaux. Passons-en quelques-uns en revue.
Plutôt que de déplacer physiquement les données, la fédération les laisse à leur emplacement d’origine et y donne accès via une couche virtuelle. Cette approche élimine la duplication tout en garantissant un accès en temps réel à l’information la plus à jour. En virtualisant l’accès, les organisations préservent l’intégrité et la sécurité des données à la source tout en bénéficiant d’une vue unifiée.
Les utilisateurs interagissent avec une interface ou un langage de requête unique, ce qui simplifie l’accès à des données issues de multiples sources. Cet accès unifié fluidifie la récupération des données et permet aux analystes, data scientists et autres parties prenantes d’interroger et d’analyser facilement les données sans gérer la complexité propre à chaque source.
Un schéma est un plan qui définit l’organisation des données dans une base. Les sources utilisent souvent des schémas différents, c’est‑à‑dire qu’elles structurent et nomment leurs données autrement. Le mappage de schémas consiste à aligner ces schémas pour créer une vue cohérente.
Par exemple, une source peut utiliser "CustomerID" pour désigner l’identifiant client, tandis qu’une autre emploiera "CustID". Le mappage permet de traduire ces libellés pour les reconnaître comme une même entité.
En harmonisant les schémas, les outils de fédération assurent une intégration fluide des données hétérogènes et offrent un modèle fiable sur lequel s’appuyer pour des analyses et des rapports précis.
La fédération privilégie le traitement à la demande. Les requêtes sont exécutées en temps réel sur les sources fédérées, minimisant la duplication et garantissant un accès aux données les plus récentes. Cette dynamique est cruciale pour des décisions et analyses opportunes et soutient une prise de décision agile et informée.
Maintenant que nous avons défini la fédération de données, voyons comment elle fonctionne.
La fédération intègre de manière transparente des données issues de sources disparates. Son cœur est une architecture structurée conçue pour faciliter cette intégration efficacement. Elle comporte trois éléments principaux :
Pensez aux sources comme à des îlots, chacun détenant des informations précieuses. Elles vont des données structurées en bases aux données non structurées dans le cloud, en passant par des flux en temps réel. La fédération intègre ces sources diverses pour proposer une vision cohérente du paysage data.
La couche de fédération fournit une interface unifiée d’accès et de requêtage. Elle traduit les requêtes des utilisateurs en commandes compréhensibles par chaque source, facilitant l’accès et le traitement en temps réel. Elle est essentielle pour préserver l’intégrité des données, garantir une récupération efficace et offrir une vue cohérente sur l’ensemble des sources.
On peut l’imaginer comme un flux vidéo en direct de chacun des îlots de données : elle permet de voir et d’utiliser les données sur chaque îlot, sans les déplacer ni les copier.
Divers outils et applications — plateformes de business intelligence, environnements de data science, systèmes opérationnels — accèdent aux données fédérées via cette couche. Les analystes, data scientists et autres consommateurs peuvent alors exploiter ces données pour l’analyse, le reporting et la prise de décision.
Lorsqu’une requête est soumise à un système fédéré, elle arrive d’abord dans la couche de fédération. Considérez-la comme un traducteur intelligent : elle décompose la requête principale en sous‑requêtes adaptées à chaque source pertinente, qu’il s’agisse de bases de données ou de stockages cloud.
Ces sous‑requêtes sont envoyées en temps réel aux différentes sources. Chacune traite sa part et renvoie ses résultats. La couche de fédération rassemble ensuite ces réponses et les combine en un résultat agrégé.
Ce processus fluide permet d’accéder et d’analyser des données provenant de multiples sources comme s’il s’agissait d’un jeu de données unique et unifié — facilitant ainsi la collecte à l’échelle de l’organisation.
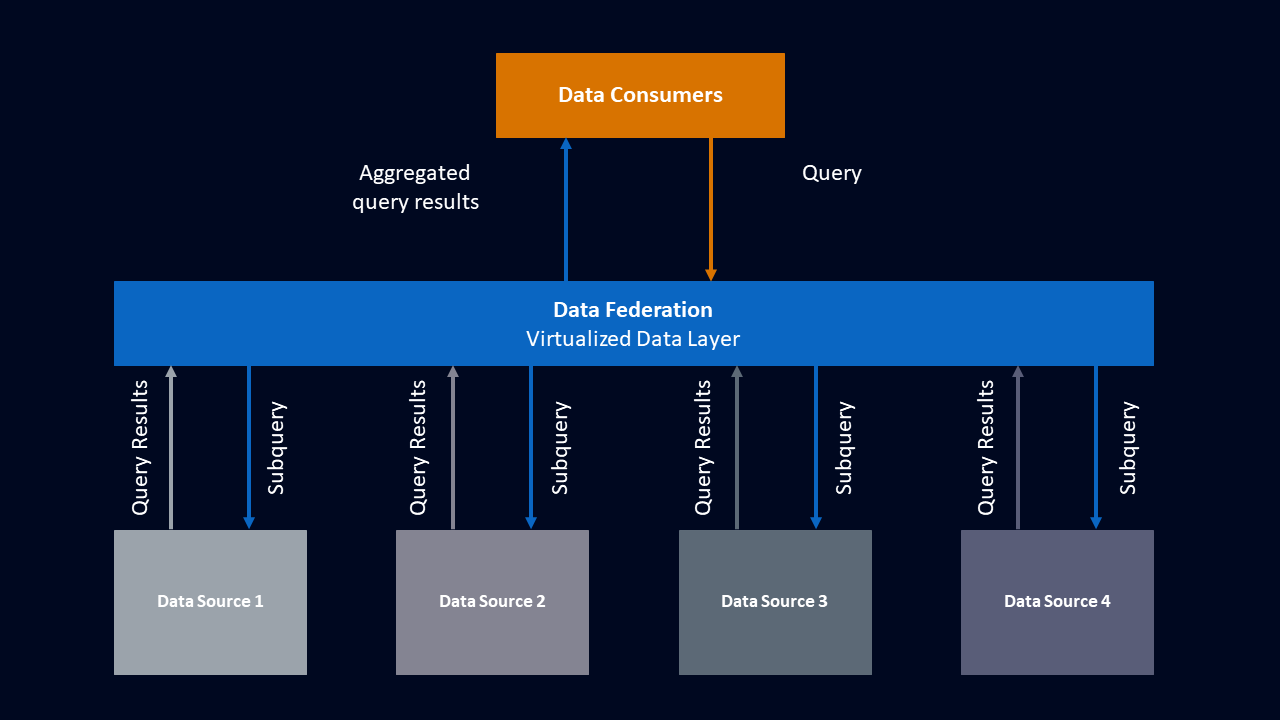
Le schéma ci‑dessus illustre ce processus : un consommateur de données interroge la fédération, qui fragmente la requête en sous‑requêtes envoyées aux sources appropriées. Chaque source renvoie ses résultats, que la fédération agrège avant de les restituer au consommateur.
La fédération de données présente plusieurs atouts majeurs pour les organisations aux environnements data complexes.
En limitant les copies, la fédération réduit les coûts de stockage et le risque d’incohérences entre jeux de données. Cette approche rationalisée optimise l’usage des ressources et renforce l’intégrité des données.
La fédération simplifie l’accès en offrant un point unique pour interroger les données de toute l’organisation. Ce point central accélère la récupération et l’analyse. Le caractère temps réel garantit un accès aux données les plus récentes sur l’ensemble des sources fédérées — indispensable pour décider au bon moment.
La fédération rationalise l’intégration en supprimant la dépendance à des processus ETL (extract, transform, load) complexes traditionnellement requis pour la consolidation. Elle accélère ainsi les délais d’intégration et réduit le risque d’erreurs.
La flexibilité inhérente à la fédération permet d’ajouter ou de retirer des sources aisément, sans perturber les applications ni les processus existants. Les organisations s’adaptent plus vite à l’évolution de leurs besoins data, sans être contraintes par des architectures rigides.
Malgré ses nombreux avantages, la fédération comporte aussi des défis à relever.
Des problèmes de performance peuvent survenir en raison de la complexité des requêtes multi‑sources. Des efforts d’optimisation sont nécessaires pour garantir une récupération et un traitement efficaces. Il est important d’investir dans une infrastructure robuste et d’appliquer des techniques d’optimisation des requêtes afin d’atténuer les goulots d’étranglement et de préserver la réactivité.
Un autre défi majeur tient à la complexité des schémas. Le mappage de schémas hétérogènes peut être ardu. La diversité des structures impose des outils et techniques avancés pour harmoniser les schémas et assurer la cohérence des données fédérées. Les professionnels des données peuvent s’appuyer sur la modélisation et des stratégies de mappage pour créer une vue unifiée qui reflète fidèlement la sémantique sous‑jacente.
Pour en savoir plus sur le mappage de schémas, nous vous conseillons ce cours Database Design.
La gouvernance peut s’avérer complexe dans un contexte fédéré. Les organisations doivent définir et appliquer des politiques de qualité, de sécurité et de confidentialité sur l’ensemble des sources. Il est crucial de mettre en place des processus de gouvernance — traçabilité des données, contrôles d’accès, mesures de confidentialité — afin de réduire les risques et de préserver l’intégrité des données fédérées.
Pour plus d’informations sur la gouvernance des données, écoutez Making Data Governance Fun et How Data Leaders Can Make Data Governance a Priority. Cette antisèche sur les fondamentaux de la gouvernance est également une bonne ressource.
La fédération est utile à tous les niveaux de l’organisation.
Elle permet aux analystes de créer des rapports et tableaux de bord complets agrégeant des données de différents services ou systèmes. En offrant une vue unifiée, les organisations obtiennent des insights précieux sur leurs opérations, favorisant des décisions éclairées et une planification stratégique.
Avec un accès facilité à des sources variées pour l’entraînement et la validation, les data scientists peuvent exploiter pleinement l’information disponible. Cet agrégat améliore la précision et la robustesse des modèles, renforçant les capacités prédictives. La fédération libère aussi du temps à ceux qui, autrement, devraient construire des pipelines complexes pour alimenter leurs modèles.
En agrégeant des flux issus de sources disparates, les organisations obtiennent une vision holistique de leurs opérations, identifient les goulets d’étranglement et optimisent les processus. L’efficacité globale s’en trouve améliorée. La visibilité en temps réel permet en outre de réagir rapidement aux évolutions.
La fédération est précieuse lorsque les auditeurs ont besoin d’une vue complète de vos données à travers diverses sources. En fournissant une plateforme unifiée d’accès et d’analyse, elle facilite le respect des réglementations et la conduite des audits. Pour simplifier encore les contrôles, associez la fédération à la traçabilité des données et à une documentation adéquate.
Consultez Qu’est-ce que la traçabilité des données et Data Governance Concepts pour en savoir plus.
La fédération de données est parfois confondue avec l’entreposage de données (data warehousing). Pourtant, des différences importantes existent.
La fédération repose sur la virtualisation : les données restent à leur emplacement d’origine et sont accessibles en temps réel via une couche virtuelle. Cette approche permet d’accéder aux données les plus récentes sans duplication, de réduire les coûts de stockage et de limiter les incohérences entre jeux de données.
Le data warehousing consolide les données dans un référentiel centralisé. Cette approche est adaptée au stockage des historiques et à l’analyse des tendances passées. Elle nécessite toutefois des processus ETL étendus pour intégrer les données de sources variées dans l’entrepôt.
Pour en savoir plus sur les entrepôts de données, consultez ce cours d’introduction Data Warehousing Concepts ou ce tutoriel sur choisir la bonne solution d’entrepôt de données cloud.
Fédération et data warehousing proposent des approches différentes de l’intégration des données, chacune avec ses forces et ses limites.
La fédération excelle pour l’accès en temps réel à des données à jour tout en minimisant la duplication. Elle est idéale pour des environnements dynamiques et agiles.
Le data warehousing est mieux adapté au stockage et à l’analyse des historiques. Il requiert souvent davantage d’ETL et offre moins de souplesse que la fédération.
Pour trancher, tenez compte du cas d’usage, du volume de données et du besoin d’analyse en temps réel versus historique.
Selon votre paysage data, la mise en place peut être exigeante. Avec une planification soignée, le choix des bons outils et la prise en compte des besoins de l’organisation, elle reste maîtrisable et rapidement rentable. Voici quelques étapes à considérer.
Commencez par un état des lieux complet des sources présentes dans les systèmes, bases et applications. Identifiez les types de données stockées et la fréquence de mise à jour. Cela garantit que la solution de fédération pourra offrir un accès en temps réel aux données les plus récentes.
Comme pour tout projet, clarifiez les objectifs. Décrivez les cas d’usage et exigences de la fédération dans l’organisation. Déterminez les objectifs métiers : améliorer l’accessibilité, simplifier l’intégration, activer l’analytique temps réel, etc. Identifiez les parties prenantes et associez‑les pour que la solution réponde à leurs besoins.
Sélectionnez les outils et technologies adaptés à vos exigences et à votre budget. Évaluez les capacités de virtualisation, la scalabilité, la facilité d’intégration avec l’existant et la compatibilité avec diverses sources. Comparez solutions commerciales et open source pour trouver le meilleur compromis. Ci‑dessous, quelques outils populaires en fédération de données.
|
Outil |
Fonctionnalités |
Modèle de licence |
|
Accès en temps réel, mappage de schémas, optimisation des requêtes |
Payant |
|
|
Flexible et extensible, solutions de fédération personnalisées |
Open source |
|
|
Interroger les données stockées dans Amazon S3 avec du SQL standard |
Payant |
Concevez une fédération alignée sur vos exigences et cas d’usage. Déterminez l’emplacement de la couche de fédération dans l’infrastructure existante et définissez les points d’intégration avec les sources et les consommateurs de données. Prenez en compte la sécurité, la performance et la scalabilité pour répondre aux besoins actuels et futurs.
Une fois la fédération configurée et connectée aux sources, assurez‑vous de son bon fonctionnement. Testez minutieusement afin d’identifier d’éventuels problèmes ou goulots d’étranglement et ajustez l’implémentation si nécessaire.
Déployez en production et surveillez performance et fiabilité. Mettez en place des mécanismes de supervision et d’alerte pour détecter et traiter proactivement les incidents. Optimisez en continu l’architecture et les processus d’intégration afin de conserver l’efficacité de la solution et son alignement avec l’évolution des besoins métiers.
La fédération de données apporte des bénéfices tangibles aux organisations qui veulent tirer parti de données disséminées. En offrant une vue unifiée et virtualisée de sources multiples, elle améliore l’accès, réduit les redondances et simplifie les efforts d’intégration.
Approfondissez la gestion des données avec Introduction aux data pipelines pour les professionnels des données. Nous recommandons aussi le cours Responsible AI Data Management.
Permettez à votre équipe d'accéder à l'ensemble de la bibliothèque DataCamp, avec des rapports centralisés, des missions, des projets et bien d'autres choses encore.
Formez-vous à la gestion des données avec ces cours !
Cours
Cours
Cours