
Last chance! 50% off DataCamp Premium
Sale ends in
framework di archiviazione e calcolo basati sul cloud per offrire capacità di archiviazione e analisi dei dati flessibili e ad alte prestazioni.
Oggi le aziende possono consolidare i dati in un archivio cloud centralizzato ed eseguire le analisi nello stesso ambiente. Il data warehousing nel cloud è fondamentale per l’analisi dei dati moderna perché supporta l’elaborazione in tempo reale, l’analisi avanzata e le applicazioni di machine learning.
Snowflake e Google BigQuery sono due delle principali opzioni per i data warehouse cloud. Snowflake ha un’architettura unica che separa le risorse di storage e calcolo ed è cloud agnostic, offrendo flessibilità in qualsiasi ambiente.
Google BigQuery è una soluzione completamente gestita e serverless all’interno di Google Cloud Platform, eccelle nell’analisi di dataset complessi e di grandi dimensioni e integra funzionalità di machine learning. Entrambi i prodotti offrono funzionalità potenti per archiviazione, elaborazione e analisi dei dati, consentendo ai professionisti dei dati di rispondere in modo più efficiente ed efficace alle domande di business con i propri dati.
Man mano che le organizzazioni accumulano quantità sempre maggiori di dati, imparare a usare queste piattaforme è cruciale per iniziare una carriera nel data.
Questa guida esaminerà Snowflake vs BigQuery, esplorandone funzionalità, somiglianze e differenze chiave. Presenteremo entrambi i prodotti, ne illustreremo vantaggi e svantaggi e li confronteremo su aspetti critici come prestazioni, sicurezza e costi.
Snowflake è un servizio di data warehouse cloud con un’architettura propria incentrata su scalabilità flessibile delle risorse, gestione dei costi e riduzione della latenza. Se vuoi saperne di più, dai un’occhiata al nostro articolo Introduzione a Snowflake per principianti.
L’architettura di Snowflake si basa su tre principi principali: calcolo multi-cluster, dati condivisi e separazione tra storage e compute.
Il calcolo multi-cluster è un’architettura scalabile in cui più cluster di calcolo indipendenti, noti come virtual warehouses, forniscono risorse computazionali per soddisfare la domanda. Un’ottima funzionalità è l’auto-scaling di Snowflake, in cui vengono create più copie dello stesso cluster per far fronte al fabbisogno di calcolo.
Il data layer di Snowflake è un componente cruciale della sua architettura, progettato per una gestione e un’archiviazione dei dati efficienti. Comprende sia un repository centrale sia una rete di dati distribuita. Il repository centrale contiene tutti i dati dell’azienda ed è accessibile a tutti i virtual warehouses. Per migliori prestazioni e scalabilità, i virtual warehouses memorizzano una porzione del set di dati complessivo più utilizzato.
Snowflake separa lo storage dal compute, consentendo a ciascun cluster di calcolo di scalare indipendentemente dal volume di archiviazione. Il livello di storage utilizza lo storage cloud per mantenere i dati in modo persistente, mentre il livello di compute è costituito da virtual warehouses che elaborano le query. Questa separazione consente una gestione delle risorse più flessibile e un migliore controllo dei costi.
Snowflake offre diverse funzionalità chiave che lo rendono una soluzione di data warehousing potente e flessibile:
I virtual warehouses sono cluster MPP (massively parallel processing) di Snowflake che eseguono query SQL. Possono essere scalati verso l’alto o verso il basso in modo indipendente, consentendo di adeguare la potenza di calcolo a esigenze di carico specifiche.
Inoltre, ogni virtual warehouse è completamente indipendente e non condivide risorse con altri, assicurando che le prestazioni di ciascun virtual warehouse non influenzino le altre. Questa flessibilità consente un’allocazione efficiente delle risorse e una migliore gestione dei costi, poiché è possibile regolare la capacità di calcolo on demand senza influire sull’archiviazione dei dati.
Time Travel è una funzionalità che consente di accedere ai dati storici in qualsiasi momento all’interno di un periodo definito. È utile per il ripristino dei dati, la verifica e l’analisi delle modifiche nel tempo. Gli utenti possono interrogare i dati così come esistevano in specifici momenti del passato o persino ripristinare tabelle, schemi o database a uno stato precedente.
La condivisione sicura dei dati di Snowflake consente alle organizzazioni di condividere dati live e governati con altri account Snowflake senza spostare o copiare i dati. Questa condivisione avviene direttamente all’interno di Snowflake, mantenendo integrità e sicurezza. Abilita l’accesso ai dati in tempo reale per partner, fornitori o clienti, favorendo la collaborazione nel rispetto della governance e del controllo dei dati.
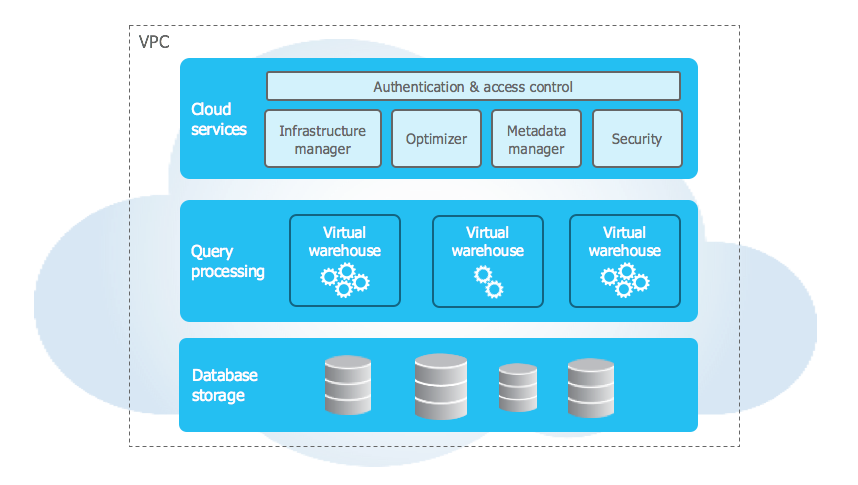
Architettura primaria di Snowflake (Fonte: docs.snowflake.com)
Snowflake offre molti vantaggi rispetto ad altre soluzioni di data warehouse cloud grazie al design della sua architettura e alla base cloud-agnostic. Tuttavia, presenta anche dei punti deboli, tra cui costi potenzialmente elevati e complessità.
Snowflake ha numerosi vantaggi grazie alla capacità di integrarsi facilmente con qualsiasi sistema cloud, alla scalabilità flessibile e alla gestione di carichi di lavoro eterogenei.
Esistono alcuni svantaggi di Snowflake legati ai costi di scalabilità e alla complessità di gestione. La maggiore flessibilità aggiunge un po’ di complessità nella gestione e il pricing può essere difficile da prevedere.
BigQuery è il data warehouse enterprise di Google con potenti funzionalità analitiche e di machine learning all’interno di Google Cloud Platform. Poiché BigQuery fa parte dell’ecosistema Google Cloud, può interagire con altri componenti di Google Cloud come Google Drive, Sheets e Cloud Storage. Questo permette agli utenti di trasferire, analizzare e condividere i dati in modo rapido e semplice all’interno di Google Cloud Platform.
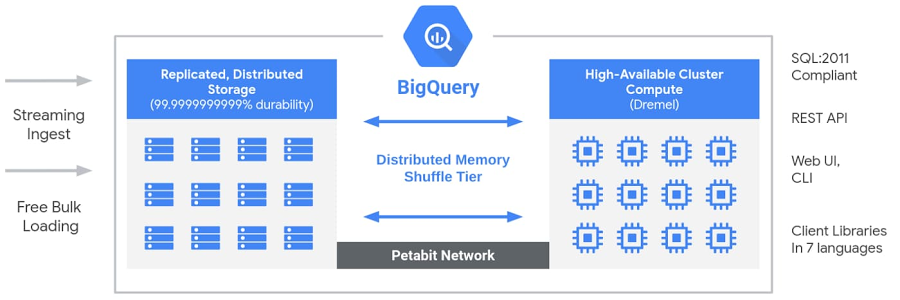
Architettura BigQuery (Fonte: Google Cloud Blog)
BigQuery è costruito sul motore Dremel di Google, che punta su risorse computazionali scalabili per consentire analisi in tempo reale di dati colonnari in sola lettura.
Per utilizzare BigQuery, hai un’interfaccia basata su SQL in cui eseguire GoogleSQL ottimizzato. Funziona in modo simile a MapReduce, utilizzando un motore di esecuzione delle query, un pianificatore logico e un parser di query per l’ottimizzazione.
La principale differenza è che Dremel utilizza alberi aggregatori per l’esecuzione delle query, consentendo analisi in tempo reale, mentre il framework MapReduce ha intrinsecamente una certa latenza.
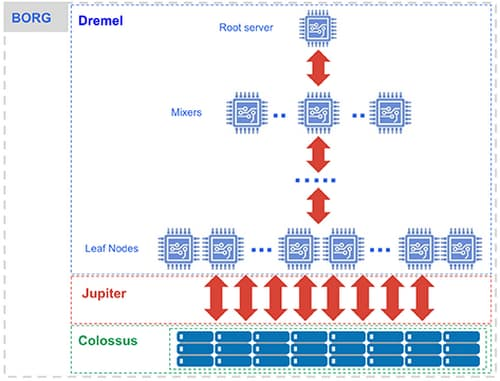
BigQuery Dremel (Fonte: Google Cloud Blog)
Eseguire SQL in BigQuery offre il vantaggio di utilizzare la sintassi SQL esclusiva di Google. Fornisce molte delle stesse funzionalità di altri linguaggi SQL con qualche extra. Una funzione recente di Google SQL molto utile è GROUP BY ALL.
Inoltre, GoogleSQL offre la possibilità di eseguire in modo più semplice cicli iterativi e di usare variabili rispetto ad alcuni altri linguaggi SQL. Anche senza una conoscenza approfondita di GoogleSQL, puoi sfruttare facilmente BigQuery con SQL standard. Non perderti questo articolo su come iniziare con BigQuery.
Creare modelli di machine learning nativamente in BigQuery è piuttosto semplice. Puoi usare la sintassi SQL per CREATE modelli di ogni tipo. Offre modelli semplici come regressione lineare e logistica, oltre a modelli complessi come alberi potenziati e reti neurali. I modelli vengono quindi archiviati in BigQuery stesso e possono essere utilizzati facilmente per generare risultati che vengono poi salvati come tabelle. Tutto avviene nativamente in BigQuery, senza bisogno di importare pacchetti esterni.
BigQuery ha numerosi vantaggi che lo rendono uno strumento potente grazie all’integrazione con GCP e al sistema Dremel:
Nonostante questi vantaggi, ci sono alcune debolezze. Alcune dipendono dal fatto che BigQuery è stato progettato per esistere nel Google Cloud. Lavorare con i dati al di fuori di quell’ecosistema può essere impegnativo per i professionisti dei dati meno tecnici:
Sia BigQuery sia Snowflake offrono prestazioni e scalabilità simili, con lievi sfumature. Nelle situazioni più semplici, Snowflake è una scelta migliore. Con la crescita e la complessità dei dati, BigQuery guadagna vantaggio grazie alla struttura dei costi più efficiente e a una scalabilità praticamente illimitata.
Le prestazioni di Snowflake nei benchmark TPC-H superano BigQuery. Ciò significa che, per la maggior parte delle domande di business standard, Snowflake offrirà prestazioni migliori. Grazie al calcolo multi-cluster e all’architettura a dati condivisi, Snowflake scala facilmente per soddisfare le esigenze di qualsiasi enterprise.
Sebbene BigQuery possa essere meno efficiente di Snowflake su alcune query semplici, eccelle nelle analisi complesse. Lo scaling automatico nativo richiede pochissima gestione per aumentare le risorse computazionali. Anche se esistono alcuni limiti, dovuti alle risorse condivise all’interno di un’organizzazione, scrivere query efficienti che elaborino il minimo indispensabile di dati aiuta a mantenere prestazioni ottimali.
Snowflake opera in un ecosistema cloud-agnostic non legato a una piattaforma specifica. Questo significa che può essere integrato con altre piattaforme cloud in modo semplice tramite i connettori appropriati. Ne risulta un’esperienza fluida nella creazione di pipeline ETL e analitiche che alimentano le altre parti dell’enterprise in cloud.
Intorno a Snowflake esiste un ecosistema di oltre 60 strumenti e tecnologie di terze parti che offrono connettività nativa a Snowflake. Queste integrazioni rendono più semplice preparare, migrare e visualizzare i dati con tali strumenti. Per funzionalità BI più avanzate, Snowflake offre anche lo Snowflake Marketplace, che fornisce accesso a dataset, app e prodotti di AI unici costruiti specificamente per l’ambiente Snowflake.
Essendo costruito su Google Cloud Platform, BigQuery è più adatto a chi è fortemente investito in GCP. Se la maggior parte dei tuoi processi si trova in Google Cloud Platform, come Google Compute Engine, Cloud Storage e Cloud Run, può essere vantaggioso usare BigQuery per mantenere le pipeline di dati nello stesso ambiente. Mantenendo tutto all’interno dell’ambiente, è possibile ottimizzare costi e tempi di calcolo. Inoltre, l’integrazione nativa con gli strumenti AI/ML in BigQuery lo rende perfetto per le organizzazioni che utilizzano analitiche basate su AI. Le pipeline possono alimentare direttamente BigQuery, che può quindi addestrare modelli/predire risultati sui dati.
La sicurezza è una priorità per gli utenti dei servizi Cloud. Garantire la conformità agli standard governativi è importante. Fortunatamente, i provider cloud forniscono ampie indicazioni su sicurezza e conformità, consentendo di configurare facilmente i dati in modo conforme ai propri standard di sicurezza. Sia Snowflake sia BigQuery offrono funzionalità simili, con gestione degli accessi basata sui ruoli e funzionalità di ripristino dei dati.
Snowflake offre funzionalità per creare un’esperienza sicura e affidabile per le organizzazioni. Tra queste c’è Time Travel, che consente il recupero dei dati in caso di eliminazione accidentale.
Un’altra funzionalità di protezione dei dati è Fail-safe, che conserva i dati storici per sette giorni dopo la scadenza del periodo di retention di Time Travel. Questi dati non sono direttamente accessibili ma possono essere recuperati da Snowflake, garantendo la resilienza dei dati.
Per il controllo degli accessi, Snowflake combina il controllo discrezionale e quello basato sui ruoli in un unico sistema robusto. Ciò consente di gestire con precisione i privilegi di accesso in modo semplice e basato sui ruoli.
Snowflake dà inoltre priorità alla sicurezza impiegando standard di crittografia robusti per proteggere i dati sia in transito che a riposo. Per i dati a riposo, Snowflake cifra tutti i dati archiviati con un modello di chiavi gerarchico, ruotato e gestito automaticamente da Snowflake senza necessità di intervento del cliente.
BigQuery offre anch’esso un certo recupero dei dati grazie alle funzionalità di time travel, che consentono di recuperare tabelle eliminate entro la finestra di sette giorni. Tuttavia, se viene eliminato l’intero dataset, non è possibile recuperare i dati persi, a differenza di Snowflake. Ciò significa che l’eliminazione va gestita con maggiore cautela in BigQuery.
La sicurezza di BigQuery per i dati a riposo è gestita principalmente da Google. Google fornisce IAM, che offre un controllo degli accessi e un monitoraggio completi. Questo accesso può essere gestito a qualsiasi livello, dall’intero progetto fino alle singole tabelle. Tutti i dati a riposo nell’ambiente Google Cloud sono cifrati con chiavi gestite da Google Cloud. Se serve maggiore sicurezza, è possibile fornire chiavi private proprie per cifrare ulteriormente i dati in Google Cloud.
Sia Snowflake sia BigQuery hanno due componenti di costo: storage e compute. Lo storage è il costo per conservare i dati nel warehouse indipendentemente dall’utilizzo. I costi di compute sono calcolati in base alla quantità di calcolo utilizzata o alla quantità di dati elaborati.
Ora che abbiamo esaminato alcuni componenti principali di entrambi gli strumenti, rivediamo i punti chiave. Questo dovrebbe aiutarti a decidere quale strumento utilizzare per la tua azienda:
|
Componenti |
Snowflake |
BigQuery |
|
Prestazioni |
Progettato per attività aziendali usuali e job di big data |
Progettato per analisi complesse, con ML integrato nativamente nel motore di query |
|
Scalabilità |
Può scalare automaticamente tramite virtual warehouses con architettura multi-cluster |
Scala in modo nativo in base alle esigenze |
|
Integrazione ed ecosistema |
Cloud-agnostic, si integra con altre piattaforme cloud tramite vari connettori |
Focalizzato principalmente su Google Cloud Platform; i dati possono essere trasferiti all’esterno ma è più semplice gestirli in GCP |
|
Sicurezza e conformità |
Protocolli di sicurezza basati sugli utenti e ripristino a livello organizzativo e di ruolo. Dispone di protocolli di recupero dati entro sette giorni |
Google IAM con chiavi gestite da Google Cloud o dall’utente. Fornisce anche una finestra di recupero di sette giorni |
|
Costo di storage |
Storage on-demand a $23/TB/mese con prezzi contrattuali inferiori |
Basato sul tipo di storage: $20/TB per attivo e $10 per lungo termine. C |
|
Costo di compute |
Basato sul tempo di calcolo utilizzato, a livelli in base alle prestazioni |
Basato sui dati elaborati a $5/TB |
Snowflake e BigQuery hanno entrambi vantaggi e svantaggi unici. Se il tuo business è interessato principalmente ad analisi lineari, grandi volumi di dati e query rapide, Snowflake può essere l’opzione migliore grazie ai virtual warehouses con auto-scaling e al pricing basato sul compute.
Se i tuoi obiettivi sono analisi più complesse con machine learning o una forte integrazione nell’ecosistema Google Cloud Platform, allora BigQuery è la scelta ideale grazie alla gestione automatica del compute, all’integrazione nativa di ML e al pricing basato sui dati elaborati.
Imparare a usare entrambi è la soluzione migliore per trovare lavoro come data professional e DataCamp offre numerose risorse per approfondire.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min




