Cours
Introduction à Snowflake SQL
2 h
59.2K
S'entraîner et cursus vos progrès.
Continuer Avec Googledes cadres de stockage et de calcul cloud pour offrir des capacités de stockage et d’analyse de données flexibles et performantes.
Les entreprises peuvent désormais centraliser leurs données dans un stockage cloud et réaliser leurs analyses dans le même environnement. L’entreposage de données dans le cloud est essentiel à l’analytique moderne, car il prend en charge le traitement des données en temps réel, l’analytique avancée et les applications de machine learning.
Snowflake et Google BigQuery font partie des principales options en matière d’entrepôts de données cloud. Snowflake se distingue par une architecture qui sépare le stockage et le calcul, et par son agnosticisme cloud, offrant une grande souplesse dans tout environnement.
Google BigQuery est une solution entièrement gérée et serverless au sein de Google Cloud Platform, particulièrement performante pour l’analyse de jeux de données massifs et complexes et dotée de fonctionnalités de machine learning intégrées. Les deux produits proposent des fonctions puissantes de stockage, de traitement et d’analyse, permettant aux professionnels des données de répondre plus efficacement aux questions métier.
Alors que les organisations accumulent toujours plus de données, maîtriser ces plateformes est un atout clé pour démarrer une carrière dans la data.
Ce guide compare Snowflake et BigQuery, en présentant leurs fonctionnalités, leurs points communs et leurs différences majeures. Nous introduirons chaque produit, mettrons en avant leurs avantages et limites, et proposerons des comparaisons sur des aspects critiques comme la performance, la sécurité et les coûts.
Snowflake est un service d’entrepôt de données cloud doté d’une architecture propre, conçue pour offrir un dimensionnement flexible des ressources, une gestion fine des coûts et une latence minimale. Pour en savoir plus, consultez notre article Introduction à Snowflake pour débutants.
L’architecture de Snowflake repose sur trois principes : le multi-cluster, les données partagées et la séparation du stockage et du calcul.
Le calcul multi‑cluster est une architecture évolutive où plusieurs clusters de calcul indépendants, appelés « entrepôts virtuels », fournissent les ressources nécessaires à la demande. L’auto‑scaling de Snowflake est un atout majeur : des copies supplémentaires d’un même cluster sont créées automatiquement pour répondre aux pics de charge.
La couche de données de Snowflake, élément clé de son architecture, est conçue pour une gestion et un stockage efficaces. Elle combine un référentiel central et un réseau distribué. Le référentiel central regroupe l’ensemble des données de l’entreprise, accessibles à tous les entrepôts virtuels. Pour optimiser la performance et l’évolutivité, ces entrepôts conservent en cache les segments de données les plus utilisés.
Snowflake sépare le stockage du calcul, ce qui permet à chaque cluster de calcul d’évoluer indépendamment du volume stocké. La couche de stockage s’appuie sur le stockage cloud pour conserver durablement toutes les données, tandis que la couche de calcul est constituée d’entrepôts virtuels qui exécutent les requêtes. Cette séparation offre une gestion plus flexible des ressources et un meilleur pilotage des coûts.
Snowflake propose plusieurs fonctionnalités clés qui en font une solution d’entreposage de données puissante et flexible :
Les entrepôts virtuels sont les clusters MPP (traitement massivement parallèle) de Snowflake qui exécutent les requêtes SQL. Ils peuvent être dimensionnés à la hausse ou à la baisse de façon indépendante, afin d’ajuster la puissance de calcul aux besoins de chaque charge.
Chaque entrepôt virtuel est entièrement indépendant et ne partage pas ses ressources, évitant tout impact croisé sur les performances. Cette souplesse favorise une allocation efficace des ressources et une meilleure maîtrise des coûts, puisque la capacité de calcul s’ajuste à la demande sans affecter le stockage.
Time Travel permet d’accéder aux données historiques sur une période donnée. C’est utile pour la restauration, l’audit et l’analyse de l’évolution des données. Vous pouvez interroger l’état passé des données ou restaurer des tables, des schémas ou des bases dans un état antérieur.
La fonction de partage sécurisé de Snowflake permet de partager des données vivantes et gouvernées avec d’autres comptes Snowflake sans déplacement ni copie. Le partage se fait directement dans Snowflake, en préservant l’intégrité et la sécurité. Les partenaires, fournisseurs ou clients peuvent accéder aux données en temps réel, favorisant la collaboration tout en respectant la gouvernance.
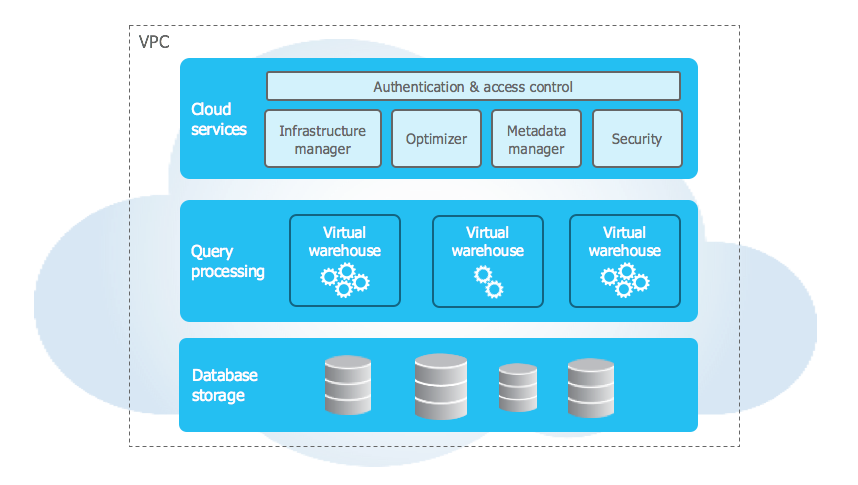
Architecture principale de Snowflake (Source : docs.snowflake.com)
Grâce à son architecture et à son agnosticisme cloud, Snowflake présente de nombreux avantages face aux autres entrepôts de données cloud. Il comporte toutefois des limites, notamment des coûts qui peuvent grimper à grande échelle et une certaine complexité de gestion.
Snowflake se distingue par sa capacité à s’intégrer aisément à tout écosystème cloud, sa flexibilité de mise à l’échelle et sa prise en charge de charges de travail variées.
Snowflake présente quelques inconvénients liés aux coûts à l’échelle et à la complexité de gestion. La souplesse accrue ajoute des exigences de pilotage, et la tarification peut être difficile à prévoir.
BigQuery est l’entrepôt de données d’entreprise de Google, doté de puissantes fonctionnalités analytiques et de machine learning au sein de Google Cloud Platform. Parce qu’il fait partie de l’écosystème Google Cloud, BigQuery interagit avec d’autres composants comme Google Drive, Sheets et Cloud Storage. Les utilisateurs peuvent ainsi transférer, analyser et partager des données rapidement au sein de la plateforme.
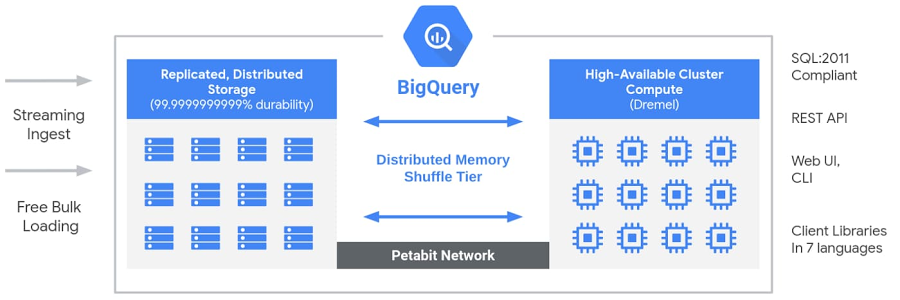
Architecture BigQuery (Source : Google Cloud Blog)
BigQuery s’appuie sur le moteur Dremel de Google, centré sur l’évolutivité des ressources de calcul pour permettre l’analyse quasi temps réel de données colonnes en lecture seule.
Pour exploiter BigQuery, vous disposez d’une interface SQL pour exécuter GoogleSQL optimisé. Son fonctionnement rappelle MapReduce, avec un moteur d’exécution, un planificateur logique et un parseur de requêtes pour l’optimisation.
La différence majeure réside dans l’usage par Dremel d’arbres d’agrégation pour l’exécution des requêtes, autorisant l’analyse en quasi temps réel, là où le cadre MapReduce introduit naturellement de la latence.
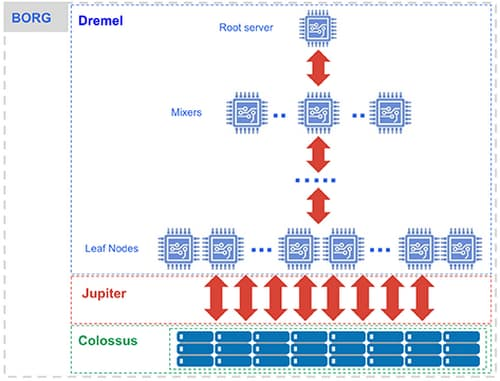
BigQuery Dremel (Source : Google Cloud Blog)
Exécuter du SQL dans BigQuery permet de bénéficier de la syntaxe spécifique de Google. Elle reprend les capacités des autres dialectes SQL avec quelques raffinements supplémentaires. Une nouveauté utile de GoogleSQL est la fonction GROUP BY ALL.
GoogleSQL facilite également l’usage de boucles itératives et de variables, parfois plus simplement que d’autres langages SQL. Même sans expertise poussée de GoogleSQL, vous pouvez exploiter BigQuery en SQL standard. Consultez cet article pour savoir comment bien débuter sur BigQuery.
La création de modèles de machine learning nativement dans BigQuery est très simple. Vous pouvez utiliser la syntaxe SQL pour CREATE des modèles de toutes sortes. Sont proposés des modèles simples (régression linéaire, régression logistique) comme des modèles complexes (arbres boostés, réseaux de neurones). Les modèles sont stockés dans BigQuery et permettent de générer des résultats enregistrés ensuite en tables, sans packages externes.
BigQuery présente de nombreux atouts, dus notamment à son intégration à GCP et à Dremel :
Malgré ces avantages, certaines limites subsistent, liées au fait que BigQuery est pensé pour exister dans Google Cloud. Travailler hors de cet écosystème peut être plus difficile pour les profils moins techniques :
BigQuery et Snowflake offrent des performances et une évolutivité proches, avec des nuances. Pour des cas simples, Snowflake est souvent un meilleur choix. À mesure que le volume et la complexité augmentent, BigQuery prend l’avantage grâce à sa structure de coûts et à sa capacité de montée en charge quasi illimitée.
Sur le benchmark TPC‑H, Snowflake surpasse BigQuery. Concrètement, pour la plupart des questions métier standard, Snowflake sera plus performant. Grâce à son calcul multi‑cluster et son architecture de données partagées, Snowflake se dimensionne facilement pour répondre aux besoins des grandes entreprises.
Si BigQuery peut être moins efficace que Snowflake pour des requêtes simples, il excelle sur les analyses complexes. La mise à l’échelle automatique native demande peu d’intervention. Bien qu’il existe des limites liées aux ressources partagées d’une organisation, écrire des requêtes efficaces qui traitent un minimum de données permet de conserver des performances optimales.
Snowflake évolue dans un écosystème agnostique, indépendant de toute plateforme cloud. Il s’intègre facilement aux autres clouds via des connecteurs adaptés. Cela fluidifie la création de pipelines ETL et analytiques connectés au reste du système d’information cloud.
Un écosystème de plus de 60 outils et technologies tiers offre une connectivité native à Snowflake. Ces intégrations facilitent la préparation, la migration et la visualisation des données. Pour des besoins BI plus avancés, le Snowflake Marketplace donne accès à des jeux de données, applications et produits IA conçus pour l’environnement Snowflake.
Parce qu’il est natif de Google Cloud Platform, BigQuery convient davantage aux organisations fortement investies dans GCP. Si vos processus reposent majoritairement sur Google Compute Engine, Cloud Storage ou Cloud Run, utiliser BigQuery permet de garder vos pipelines dans le même environnement, optimisant coûts et temps de calcul. Son intégration native aux outils IA/ML en fait une option idéale pour les analyses pilotées par l’IA : les pipelines alimentent BigQuery qui peut entraîner des modèles et produire des prédictions.
La sécurité est une préoccupation majeure avec les services cloud. Le respect des normes réglementaires est crucial. Les fournisseurs cloud proposent heureusement des guides détaillés pour configurer aisément la sécurité et la conformité. Snowflake et BigQuery offrent des fonctionnalités similaires, notamment la gestion des accès par rôles et des mécanismes de récupération des données.
Snowflake propose des fonctionnalités pour une expérience sécurisée et fiable. Time Travel permet par exemple de récupérer des données en cas de suppression accidentelle.
Autre mécanisme : Fail‑safe conserve les données historiques sept jours après la fin de la période de rétention Time Travel. Ces données ne sont pas accessibles directement mais peuvent être restaurées par Snowflake, renforçant la résilience.
Pour le contrôle d’accès, Snowflake combine des modèles discrétionnaires et basés sur les rôles dans un système robuste et simple à administrer.
Snowflake met aussi l’accent sur le chiffrement des données, en transit et au repos. Au repos, toutes les données sont chiffrées via un modèle hiérarchique de clés, automatiquement renouvelées et gérées par Snowflake, sans intervention du client.
BigQuery propose également une récupération via Time Travel, permettant de restaurer des tables supprimées dans une fenêtre de sept jours. En revanche, si l’ensemble du dataset est supprimé, il n’est pas possible de le récupérer, contrairement à Snowflake. La suppression doit donc être gérée avec davantage de précautions.
La sécurité de BigQuery pour les données au repos est principalement gérée par Google. IAM fournit un contrôle d’accès et une supervision complets, du projet jusqu’à la table. Toutes les données au repos dans Google Cloud sont chiffrées avec des clés gérées par Google. Pour plus de sécurité, vous pouvez fournir vos propres clés privées.
Snowflake et BigQuery facturent deux composantes : le stockage et le calcul. Le stockage correspond à la conservation des données, indépendamment de l’usage. Les coûts de calcul sont, eux, liés soit au temps/puissance consommés, soit au volume de données traité.
Après ce tour d’horizon, récapitulons les points clés pour vous aider à choisir l’outil adapté à votre organisation :
|
Composants |
Snowflake |
BigQuery |
|
Performances |
Pensé pour les tâches métier courantes et les jobs big data |
Conçu pour l’analytique complexe, avec ML intégré au moteur de requêtes |
|
Évolutivité |
Mise à l’échelle automatique via des entrepôts virtuels et une architecture multi‑cluster |
S’adapte nativement selon les besoins |
|
Intégration et écosystème |
Agnostique au cloud, s’intègre aux autres plateformes via divers connecteurs |
Focalisé sur Google Cloud Platform ; export possible mais gestion optimale dans GCP |
|
Sécurité et conformité |
Contrôles basés sur l’utilisateur et les rôles, récupération sur 7 jours |
Google IAM avec clés gérées par Google ou par l’utilisateur, fenêtre de récupération de 7 jours |
|
Coût de stockage |
À la demande : 23 $ / To / mois, avec tarifs contractuels dégressifs |
Selon le type de stockage : 20 $ / To actif et 10 $ long terme. C |
|
Coût de calcul |
Fondé sur le temps de calcul utilisé, avec paliers de performance |
Fondé sur le volume de données traité (5 $ / To) |
Snowflake et BigQuery ont chacun leurs forces et limites. Si vous visez surtout des analyses simples, de gros volumes et des requêtes rapides, Snowflake peut être préférable grâce à ses entrepôts virtuels auto‑scalés et sa tarification orientée calcul.
Si vos objectifs impliquent des analyses complexes avec machine learning ou une forte intégration à Google Cloud Platform, BigQuery s’impose avec sa gestion automatique du calcul, son intégration ML native et sa tarification basée sur le volume de données traité.
Maîtriser les deux est la meilleure option pour booster votre carrière dans la data, et DataCamp propose de nombreuses ressources pour vous former.
Meilleurs cours DataCamp
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Nisha Arya Ahmed
15 min
blog
Kurtis Pykes
15 min
blog
Zoumana Keita
15 min
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Laiba Siddiqui
14 min
Tutoriel
Matt Crabtree
5 min