
Kurs
Einführung in Snowflake SQL
2 Std.
59.1K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleCloudbasierte Speicher- und Compute-Frameworks bieten flexible, leistungsstarke Datenhaltung und Analysen.
Unternehmen können Daten heute in zentralen Cloudspeichern konsolidieren und Analysen in derselben Umgebung ausführen. Cloud-Data-Warehousing ist für moderne Datenanalyse unverzichtbar, da es Echtzeitverarbeitung, Advanced Analytics und Machine-Learning-Anwendungen unterstützt.
Snowflake und Google BigQuery gehören zu den wichtigsten Optionen für Cloud-Data-Warehouses. Snowflake setzt auf eine besondere Architektur mit getrennter Speicherung und Rechenleistung und ist cloud-agnostisch – das ermöglicht maximale Flexibilität in jeder Umgebung.
Google BigQuery ist eine vollständig verwaltete, serverlose Lösung innerhalb der Google Cloud Platform, die in der Analyse riesiger, komplexer Datensätze glänzt und integrierte Machine-Learning-Funktionen bietet. Beide Produkte liefern starke Features für Speicherung, Verarbeitung und Analyse von Daten – und helfen Datenprofis, Geschäftsfragen schneller und präziser mit Daten zu beantworten.
Da Organisationen weiterhin enorme Datenmengen anhäufen, ist das Erlernen dieser Plattformen ein wichtiger Einstieg in eine Karriere im Datenbereich.
Dieser Leitfaden beleuchtet Snowflake vs. BigQuery: Funktionen, Gemeinsamkeiten und zentrale Unterschiede. Wir stellen beide Produkte vor, zeigen Stärken und Schwächen und vergleichen wichtige Kriterien wie Performance, Sicherheit und Kosten.
Snowflake ist ein Cloud-Data-Warehouse-Service mit eigener Architektur, die auf flexible Ressourcenskalierung, Kostenkontrolle und geringe Latenzen ausgelegt ist. Wenn du tiefer einsteigen willst, wirf einen Blick in unseren Artikel Introduction to Snowflake for Beginners.
Die Architektur von Snowflake beruht auf drei Grundprinzipien: Multi-Cluster-Computing, geteilte Daten und Trennung von Speicher und Rechenressourcen.
Multi-Cluster-Computing ist eine skalierbare Architektur, bei der mehrere unabhängige Compute-Cluster – sogenannte Virtual Warehouses – Rechenressourcen bedarfsgerecht bereitstellen. Besonders praktisch ist das Auto-Scaling von Snowflake: Bei höherer Last werden automatisch weitere Kopien desselben Clusters erstellt.
Die Datenebene ist ein zentrales Element der Snowflake-Architektur und auf effizientes Datenmanagement und -speicherung ausgelegt. Sie kombiniert ein zentrales Repository mit einem verteilten Datennetz. Im zentralen Repository liegt der gesamte Unternehmensdatenbestand, auf den alle Virtual Warehouses zugreifen. Für bessere Performance und Skalierung halten die Virtual Warehouses die am häufigsten genutzten Daten lokal vor.
Snowflake trennt Speicherung und Rechenleistung, sodass jeder Compute-Cluster unabhängig vom Speichervolumen skaliert. Die Speicherebene nutzt Cloud Storage für die persistente Datenhaltung, während die Compute-Ebene aus Virtual Warehouses besteht, die Abfragen verarbeiten. Diese Trennung erlaubt flexible Ressourcensteuerung und bessere Kostentransparenz.
Snowflake bietet mehrere Schlüsselfunktionen, die es zu einer leistungsfähigen und flexiblen Data-Warehousing-Lösung machen:
Virtual Warehouses sind die MPP-(Massively Parallel Processing) Compute-Cluster von Snowflake, die SQL-Abfragen ausführen. Sie lassen sich unabhängig hoch- oder herunterskalieren, sodass die Rechenleistung gezielt an die jeweilige Workload angepasst werden kann.
Zudem ist jedes Virtual Warehouse vollständig unabhängig und teilt keine Ressourcen mit anderen. So beeinflussen sich Workloads nicht gegenseitig. Diese Flexibilität ermöglicht eine effiziente Ressourcenallokation und Kostensteuerung, da sich die Compute-Kapazität bei Bedarf anpassen lässt, ohne den Datenspeicher zu tangieren.
Time Travel ermöglicht den Zugriff auf historische Datenpunkte innerhalb eines definierten Zeitraums. Das ist hilfreich für Datenwiederherstellung, Audits und die Analyse von Änderungen über die Zeit. Nutzer können Daten abfragen, wie sie zu einem bestimmten Zeitpunkt existierten, oder Tabellen, Schemata bzw. Datenbanken auf einen früheren Stand zurücksetzen.
Mit sicherem Data Sharing können Organisationen Live-Daten unter Governance direkt mit anderen Snowflake-Accounts teilen – ohne Verschieben oder Kopieren. Das Sharing erfolgt nahtlos innerhalb von Snowflake und wahrt Datenintegrität und Sicherheit. So erhalten Partner, Lieferanten oder Kunden in Echtzeit Zugriff, während Daten-Governance und -Kontrolle gewährleistet bleiben.
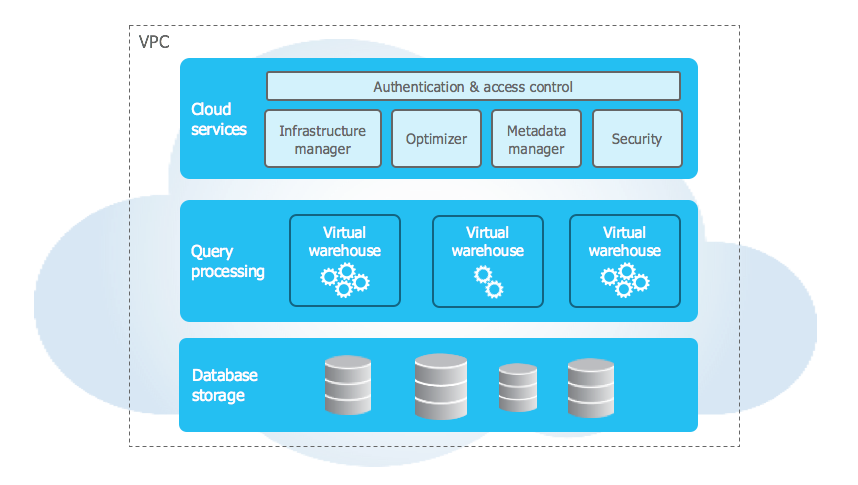
Die Kernarchitektur von Snowflake (Quelle: docs.snowflake.com)
Dank Architektur und cloud-agnostischer Basis hat Snowflake viele Vorteile gegenüber anderen Cloud-Data-Warehouse-Lösungen. Es gibt jedoch auch Schwächen – insbesondere potenziell hohe Kosten bei großem Umfang und ein höherer Managementaufwand.
Snowflake punktet mit einfacher Integration in jede Cloud, flexibler Skalierung und der Fähigkeit, vielfältige Workloads zu verarbeiten.
Einige Nachteile betreffen Skalierungskosten und Managementkomplexität. Mehr Flexibilität bedeutet mehr Konfiguration – und die Preisplanung kann mitunter schwer vorhersehbar sein.
BigQuery ist Googles Enterprise-Data-Warehouse mit leistungsstarker Analytik und Machine Learning innerhalb der Google Cloud Platform. Als Teil des Google-Cloud-Ökosystems interagiert BigQuery nahtlos mit Google Drive, Sheets und Cloud Storage. Dadurch lassen sich Daten schnell und einfach in der Google Cloud Platform übertragen, analysieren und teilen.
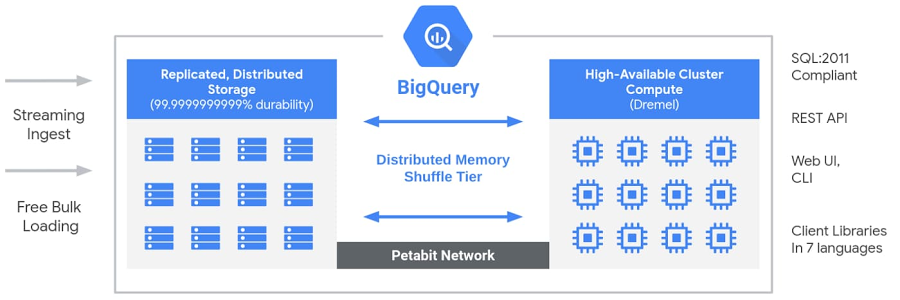
BigQuery-Architektur (Quelle: Google Cloud Blog)
BigQuery basiert auf Googles Dremel-Engine, die skalierbare Rechenressourcen für Echtzeitanalysen von schreibgeschützten, spaltenorientierten Daten bereitstellt.
Zur Nutzung steht eine SQL-basierte Oberfläche bereit, in der du optimiertes GoogleSQL ausführen kannst. Das System arbeitet ähnlich wie MapReduce und nutzt Query-Engine, Logical Planner und Parser für Optimierung.
Der wesentliche Unterschied: Dremel setzt Aggregatorbäume für die Abfrageausführung ein und ermöglicht dadurch Echtzeitanalysen, während MapReduce naturgemäß Latenzen mit sich bringt.
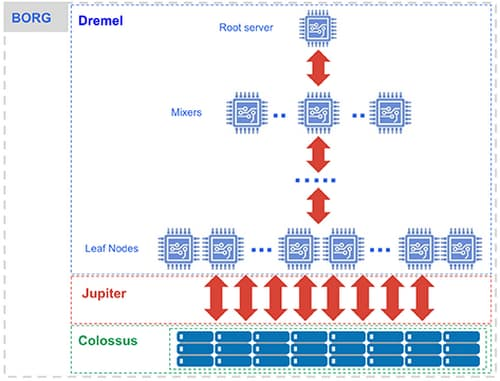
BigQuery Dremel (Quelle: Google Cloud Blog)
SQL in BigQuery zu nutzen hat den Vorteil der einzigartigen GoogleSQL-Syntax. Sie bietet vieles, was andere SQL-Dialekte auch liefern – plus einige Extras. Ein nützliches, jüngeres Feature ist die Funktion GROUP BY ALL.
Zudem erleichtert GoogleSQL Iterationsschleifen und Variablen im Vergleich zu manch anderem SQL-Dialekt. Auch ohne tiefes GoogleSQL-Wissen kannst du BigQuery mit Standard-SQL gut nutzen. Sieh dir unbedingt diesen Artikel zum Einstieg in BigQuery an.
Maschinelles Lernen direkt in BigQuery ist sehr unkompliziert. Per SQL-Syntax kannst du Modelle unterschiedlichster Art CREATEn. Von linearen und logistischen Regressionen bis hin zu Boosted Trees und neuronalen Netzen ist alles dabei. Die Modelle werden in BigQuery gespeichert und lassen sich leicht nutzen, um Ergebnisse zu erzeugen und als Tabellen abzulegen – nativ in BigQuery, ohne externe Pakete.
BigQuery überzeugt durch die enge GCP-Integration und das Dremel-System mit mehreren Vorteilen:
Trotz der Vorteile gibt es auch Schwächen. Einige ergeben sich daraus, dass BigQuery im Google-Cloud-Kosmos verankert ist. Die Arbeit mit Daten außerhalb dieses Ökosystems kann für weniger technisch versierte Datenprofis anspruchsvoll sein:
Beide Lösungen liefern ähnliche Performance und Skalierung – mit Nuancen. Für einfachere Szenarien ist Snowflake oft die bessere Wahl. Wachsen Datenvolumen und Komplexität, spielt BigQuery seine Stärken aus: eine effizientere Kostenstruktur und nahezu grenzenlose Skalierung.
In TPC-H-Benchmarks liegt Snowflake vor BigQuery. Für die meisten Standardfragen im Business-Kontext performt Snowflake daher besser. Dank Multi-Cluster-Computing und Shared-Data-Architektur skaliert Snowflake problemlos auf Enterprise-Anforderungen.
Bei einfacheren Abfragen ist BigQuery teils weniger effizient als Snowflake, überzeugt aber bei komplexen Analysen. Das automatische, native Skalieren erfordert kaum Management. Es gibt zwar Limits durch geteilte Ressourcen innerhalb einer Organisation, doch mit effizienten Abfragen, die nur notwendige Daten verarbeiten, bleibt die Performance stabil hoch.
Snowflake ist cloud-agnostisch und nicht an eine bestimmte Plattform gebunden. Über passende Konnektoren lässt es sich leicht mit anderen Cloudplattformen integrieren. So entstehen reibungslose ETL- und Analyse-Pipelines, die weitere Teile der Cloud-Landschaft versorgen.
Rund um Snowflake existiert ein Ökosystem aus 60+ Drittanbieter-Tools und -Technologien mit nativer Konnektivität. Damit wird das Aufbereiten, Migrieren und Visualisieren von Daten einfacher. Für fortgeschrittene BI-Funktionen gibt es zudem den Snowflake Marketplace mit speziellen Datensätzen, Apps und KI-Produkten, die für die Snowflake-Umgebung gebaut wurden.
Da BigQuery in der Google Cloud Platform beheimatet ist, eignet es sich besonders für Teams, die stark in GCP investieren. Wenn zentrale Prozesse bereits auf Google Compute Engine, Cloud Storage und Cloud Run laufen, lohnt sich BigQuery, um Datenpipelines in derselben Umgebung zu halten. Das optimiert Kosten und Rechenzeit. Die native Integration von KI/ML in BigQuery macht es zudem ideal für KI-getriebene Analytik: Pipelines speisen Daten direkt in BigQuery, wo Modelle trainiert und Vorhersagen erzeugt werden.
Sicherheit steht bei der Nutzung von Cloud-Services ganz oben. Die Einhaltung von Standards und regulatorischen Vorgaben ist essenziell. Glücklicherweise liefern Cloud-Anbieter umfangreiche Leitfäden, damit sich Sicherheits- und Compliance-Anforderungen einfach umsetzen lassen. Sowohl Snowflake als auch BigQuery bieten ähnliche Sicherheitsfunktionen mit rollenbasierter Zugriffssteuerung und Features zur Datenwiederherstellung.
Snowflake stellt zahlreiche Funktionen für eine sichere, zuverlässige Nutzung bereit. Dazu gehört Time Travel zur Wiederherstellung versehentlich gelöschter Daten.
Ein weiteres Schutzfeature ist Fail-safe: Historische Daten bleiben sieben Tage nach Ablauf der Time-Travel-Aufbewahrung erhalten. Sie sind nicht direkt zugänglich, können aber von Snowflake wiederhergestellt werden – das erhöht die Resilienz.
Für Zugriffskontrollen kombiniert Snowflake Discretionary Access Control und Role-Based Access Control zu einem robusten System. So lassen sich Berechtigungen präzise und dennoch einfach rollenbasiert steuern.
Snowflake setzt zudem auf starke Verschlüsselung – für Daten in Bewegung und in Ruhe. Ruhende Daten werden mit einem hierarchischen Schlüsselmodell verschlüsselt; die Schlüsselrotation und -verwaltung übernimmt Snowflake automatisch, ohne Zutun der Kunden.
Auch BigQuery bietet dank Time-Travel-Funktionen eine gewisse Datenwiederherstellung: Gelöschte Tabellen lassen sich innerhalb des siebentägigen Fensters zurückholen. Wird jedoch ein gesamtes Dataset gelöscht, ist – anders als bei Snowflake – keine Wiederherstellung möglich. Entsprechend sorgfältig sollte man Löschvorgänge handhaben.
Die Sicherheit ruhender Daten verwaltet primär Google. Über IAM bietet Google umfassende Zugriffskontrollen und Monitoring, vom Projekt bis zur einzelnen Tabelle. Alle ruhenden Daten in der Google Cloud sind mit von Google verwalteten Schlüsseln verschlüsselt. Bei höheren Anforderungen können eigene Schlüssel eingebracht und zusätzlich genutzt werden.
Sowohl Snowflake als auch BigQuery haben zwei Kostenkomponenten: Storage und Compute. Storage sind die reinen Speicherkosten – unabhängig von der Nutzung. Compute-Kosten richten sich entweder nach der genutzten Rechenleistung oder nach dem verarbeiteten Datenvolumen.
Nachdem wir die wichtigsten Aspekte beider Tools betrachtet haben, hier die Kernaussagen – zur Unterstützung deiner Entscheidung:
|
Komponenten |
Snowflake |
BigQuery |
|
Performance |
Ausgelegt für typische Business-Aufgaben und Big-Data-Jobs |
Für komplexe Analysen konzipiert, inkl. nativ in die Query-Engine integriertem ML |
|
Skalierbarkeit |
Automatisches Skalieren über Virtual Warehouses dank Multi-Cluster-Architektur |
Skaliert nativ je nach Bedarf |
|
Integration und Ökosystem |
Cloud-agnostisch, Integration in andere Clouds über verschiedene Konnektoren |
Fokus auf Google Cloud Platform; Daten lassen sich auslagern, am einfachsten ist das Management jedoch in GCP |
|
Sicherheit und Compliance |
Benutzer- und rollenbasierte Sicherheit mit Wiederherstellung auf Organisations- und Rollenebene. Datenwiederherstellung innerhalb von sieben Tagen |
Google IAM mit von Google verwalteten oder nutzerverwalteten Schlüsseln. Ebenfalls siebentägiges Wiederherstellungsfenster |
|
Speicherkosten |
On-Demand: 23 $/TB/Monat; vertragliche Konditionen senken den Effektivpreis |
Abhängig vom Speichertyp: 20 $/TB aktiv, 10 $ langfristig. F |
|
Compute-Kosten |
Nach genutzter Rechenzeit, gestaffelt nach Performance-Level |
Nach verarbeiteten Daten: 5 $/TB |
Snowflake und BigQuery haben jeweils klare Stärken und Schwächen. Geht es dir primär um unkomplizierte Analysen, hohe Datenvolumina und schnelle Abfragen, ist Snowflake mit Auto-Scaling-Virtual-Warehouses und compute-basierter Abrechnung oft die bessere Wahl.
Verfolgst du eher komplexe Analytics mit Machine Learning oder bist stark in der Google-Cloud-Welt unterwegs, ist BigQuery die erste Adresse – dank automatischer Compute-Steuerung, nativer ML-Integration und Abrechnung nach verarbeitetem Datenvolumen.
Am besten ist es, beides zu lernen – für starke Jobchancen im Datenbereich. DataCamp bietet zahlreiche Ressourcen dafür.
Top-DataCamp-Kurse
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Nisha Arya Ahmed
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Josef Waples
8 Min.


