Curso
Introdução ao Snowflake SQL
2 h
55.7K
estruturas de armazenamento e computação em nuvem que oferecem capacidades flexíveis e de alto desempenho para armazenamento e análise de dados.
Agora, as empresas podem consolidar dados em um armazenamento centralizado na nuvem e realizar análises no mesmo ambiente. Data warehousing em nuvem é essencial para a análise moderna, pois dá suporte a processamento em tempo real, analytics avançado e aplicações de machine learning.
Snowflake e Google BigQuery são duas das principais opções quando o assunto é data warehouse em nuvem. O Snowflake tem uma arquitetura exclusiva que separa armazenamento e computação, além de ser agnóstico à nuvem, oferecendo flexibilidade em qualquer ambiente.
O Google BigQuery é uma solução totalmente gerenciada e sem servidor (serverless) dentro do Google Cloud Platform, excelente para analisar grandes volumes de dados complexos e com recursos de machine learning integrados. Ambos oferecem recursos robustos para armazenamento, processamento e análise de dados, permitindo que profissionais de dados respondam a perguntas de negócio com mais eficiência e precisão.
À medida que as organizações acumulam quantidades massivas de dados, dominar essas plataformas se torna essencial para iniciar uma carreira em dados.
Este guia compara Snowflake e BigQuery, explorando seus recursos, semelhanças e principais diferenças. Vamos apresentar ambos os produtos, destacar pontos fortes e fracos e fazer comparações em aspectos críticos como performance, segurança e custo.
Snowflake é um serviço de data warehouse em nuvem com arquitetura própria, focada em oferecer escalabilidade flexível de recursos, controle de custos e baixa latência. Se quiser saber mais, confira nosso artigo Introdução ao Snowflake para iniciantes.
A arquitetura do Snowflake tem três princípios centrais: computação multi-cluster, dados compartilhados e separação entre armazenamento e computação.
Computação multi-cluster é uma arquitetura escalável em que vários clusters de computação independentes, chamados de virtual warehouses, fornecem recursos de processamento conforme a demanda. Um grande diferencial é o auto scaling do Snowflake, que cria mais cópias do mesmo cluster para atender ao aumento de uso computacional.
A camada de dados do Snowflake é fundamental para sua arquitetura, projetada para gerenciamento e armazenamento eficientes. Ela combina um repositório central com uma rede de dados distribuída. O repositório central guarda todos os dados da empresa e é acessível a todos os virtual warehouses. Para melhorar performance e escalabilidade, os virtual warehouses mantêm porções do conjunto de dados mais utilizadas.
O Snowflake separa armazenamento de computação, permitindo que cada cluster de computação escale independentemente do volume armazenado. A camada de armazenamento usa storage em nuvem para manter todos os dados de forma persistente, enquanto a camada de computação é composta por virtual warehouses que processam consultas. Essa separação possibilita gestão de recursos mais flexível e maior controle de custos.
O Snowflake oferece diversos recursos que o tornam uma solução poderosa e flexível de data warehousing:
Virtual warehouses são os clusters MPP (processamento massivo paralelo) do Snowflake que executam consultas SQL. Eles podem ser escalados para cima ou para baixo de forma independente, permitindo ajustar o poder de computação às necessidades de cada workload.
Além disso, cada virtual warehouse é totalmente independente e não compartilha recursos com os demais, garantindo que um não afete a performance do outro. Essa flexibilidade permite alocação eficiente de recursos e controle de custos, já que você pode ajustar a capacidade de computação sob demanda sem impactar o armazenamento.
Time Travel é um recurso que permite acessar dados históricos em qualquer ponto dentro de um período definido. Isso é útil para recuperação de dados, auditoria e análise de mudanças ao longo do tempo. Você pode consultar dados como estavam em momentos específicos do passado ou até restaurar tabelas, schemas ou bancos de dados a um estado anterior.
O recurso de compartilhamento seguro de dados do Snowflake permite que organizações compartilhem dados vivos e governados com outras contas Snowflake sem mover ou copiar nada. Esse compartilhamento acontece diretamente na plataforma, mantendo integridade e segurança. Parceiros, fornecedores e clientes podem ter acesso em tempo real, promovendo colaboração com governança e controle.
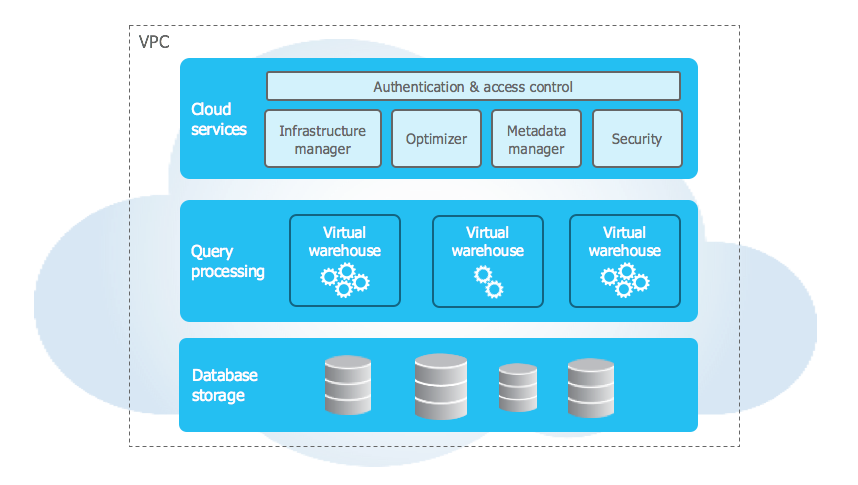
Arquitetura principal do Snowflake (Fonte: docs.snowflake.com)
O Snowflake traz muitas vantagens sobre outros data warehouses em nuvem graças ao seu design arquitetural e à base agnóstica à nuvem. Porém, tem pontos fracos, incluindo custos potencialmente altos em grande escala e alguma complexidade.
O Snowflake se destaca pela facilidade de integração com qualquer nuvem, escalabilidade flexível e capacidade de lidar com workloads variados.
Algumas desvantagens estão ligadas aos custos de escala e à complexidade de gestão. A maior flexibilidade traz camadas extras de configuração, e a precificação pode ser difícil de prever.
BigQuery é o data warehouse corporativo do Google, com funcionalidades poderosas de analytics e machine learning dentro do Google Cloud Platform. Por fazer parte do ecossistema Google Cloud, ele se integra a componentes como Google Drive, Sheets e Cloud Storage. Isso permite transferir, analisar e compartilhar dados no GCP com rapidez e facilidade.
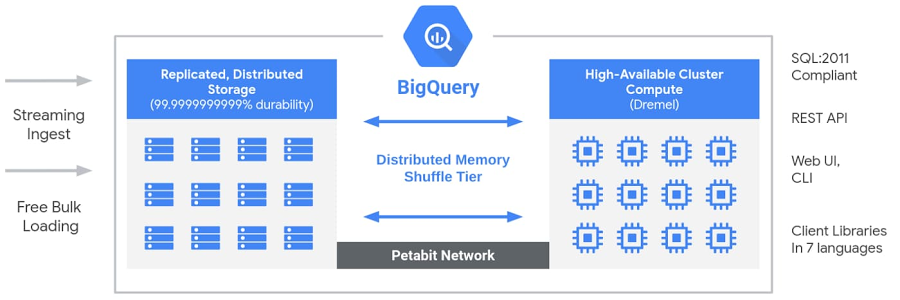
Arquitetura do BigQuery (Fonte: Google Cloud Blog)
O BigQuery é construído sobre o mecanismo Dremel do Google, focado em recursos de computação escaláveis para permitir análise em tempo real de dados colunares somente leitura.
Para usar o BigQuery, você conta com uma interface baseada em SQL para rodar o GoogleSQL otimizado. Ele opera de forma semelhante ao MapReduce, com mecanismo de execução de consultas, planejador lógico e parser de consultas para otimização.
A principal diferença é que o Dremel utiliza árvores agregadoras na execução das consultas, possibilitando análise em tempo real, enquanto o MapReduce naturalmente introduz alguma latência.
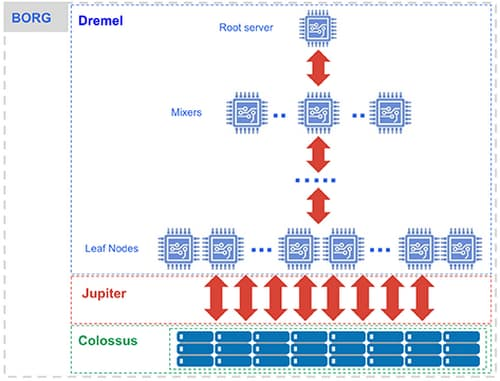
BigQuery Dremel (Fonte: Google Cloud Blog)
Rodar SQL no BigQuery traz a vantagem de usar a sintaxe exclusiva do Google. Ela inclui muitos dos recursos de outras variantes de SQL, com alguns diferenciais. Um recurso recente e útil do GoogleSQL é a função GROUP BY ALL.
Além disso, o GoogleSQL facilita a criação de loops iterativos e o uso de variáveis em comparação com alguns outros dialetos. Mesmo sem conhecimento profundo de GoogleSQL, é fácil aproveitar o BigQuery com SQL padrão. Não deixe de conferir este artigo sobre como começar no BigQuery.
Criar modelos de machine learning nativamente no BigQuery é bem simples. Você pode usar sintaxe SQL para CREATE modelos de vários tipos. Há desde modelos simples, como regressão linear e logística, até modelos complexos, como boosted trees e redes neurais. Os modelos são armazenados no próprio BigQuery e facilmente utilizados para gerar resultados que podem ser salvos como tabelas. Tudo isso acontece de forma nativa, sem necessidade de importar pacotes externos.
O BigQuery tem várias vantagens que o tornam uma ferramenta poderosa graças à integração com o GCP e ao Dremel:
Mesmo com essas vantagens, há algumas limitações. Parte delas se deve ao fato de o BigQuery ter sido projetado para o ecossistema Google Cloud. Trabalhar com dados fora desse ambiente pode ser desafiador para profissionais menos técnicos:
BigQuery e Snowflake oferecem performance e escalabilidade semelhantes, com nuances. Em cenários mais simples, o Snowflake tende a levar vantagem. À medida que os dados crescem e ficam mais complexos, o BigQuery ganha destaque com sua estrutura de custos mais eficiente e escalabilidade praticamente ilimitada.
Nos benchmarks TPC-H, o Snowflake supera o BigQuery. Ou seja, para a maioria das perguntas de negócio padronizadas, o Snowflake tende a performar melhor. Graças à computação multi-cluster e à arquitetura de dados compartilhados, o Snowflake escala com facilidade para atender a demandas corporativas.
Embora o BigQuery possa não ser tão eficiente quanto o Snowflake em consultas simples, ele brilha em análises complexas. O escalonamento automático nativo exige pouca gestão para ampliar recursos computacionais. Apesar de haver limites compartilhados dentro da organização, escrever consultas eficientes que processem o mínimo de dados possível ajuda a manter a performance ideal.
O Snowflake roda em um ecossistema agnóstico à nuvem, sem vínculo a uma plataforma específica. Isso significa que ele pode ser integrado a outras nuvens facilmente usando conectores apropriados. Assim, a criação de pipelines de ETL e analytics que alimentam outros componentes na nuvem acontece de forma fluida.
Em torno do Snowflake existe um ecossistema com mais de 60 ferramentas e tecnologias de terceiros com conectividade nativa. Essas integrações facilitam preparar, migrar e visualizar dados usando esses parceiros. Para BI mais avançado, há também o Snowflake Marketplace, que dá acesso a datasets, apps e produtos de IA criados especificamente para o ambiente Snowflake.
Como é construído no Google Cloud Platform, o BigQuery é mais indicado para quem já está profundamente investido no GCP. Se a maior parte dos seus processos roda no Google Cloud — como Compute Engine, Cloud Storage e Cloud Run — pode ser vantajoso usar o BigQuery para manter os pipelines de dados no mesmo ambiente. Mantendo tudo dentro do GCP, custos e tempo de computação tendem a ser otimizados. Além disso, a integração nativa com ferramentas de IA/ML torna o BigQuery ideal para organizações que utilizam analytics orientado por IA. Pipelines podem enviar dados diretamente para o BigQuery, que por sua vez treina modelos e gera previsões com base nesses dados.
Segurança é uma grande preocupação para usuários de serviços de nuvem. Garantir conformidade com normas governamentais é essencial. Felizmente, os provedores de nuvem oferecem ampla orientação sobre segurança e compliance, facilitando a configuração dos dados conforme os padrões exigidos. Snowflake e BigQuery contam com recursos semelhantes, como gestão de acesso baseada em papéis e mecanismos de recuperação de dados.
O Snowflake traz recursos para uma experiência segura e confiável. Um deles é o Time Travel, que permite recuperar dados em caso de exclusões acidentais.
Outro recurso é o Fail-safe, que retém dados históricos por sete dias após o término do período do Time Travel. Esses dados não são acessíveis diretamente, mas podem ser recuperados pelo Snowflake, garantindo resiliência.
Para controle de acesso, o Snowflake combina controle discricionário com controle baseado em papéis em um sistema robusto único. Assim, é possível gerenciar privilégios com precisão de forma simples e baseada em funções.
O Snowflake também prioriza segurança com padrões fortes de criptografia para proteger dados em trânsito e em repouso. Para dados em repouso, todo o conteúdo é criptografado com um modelo hierárquico de chaves, rotacionadas e gerenciadas automaticamente pelo Snowflake, sem necessidade de intervenção do cliente.
O BigQuery também oferece recuperação de dados via time travel, permitindo recuperar tabelas excluídas dentro de uma janela de sete dias. Porém, se todo o dataset for excluído, não é possível recuperar os dados — diferente do Snowflake. Portanto, é preciso ter mais cuidado com exclusões no BigQuery.
A segurança do BigQuery para dados em repouso é gerenciada principalmente pelo Google. O Google oferece o IAM, com controle de acesso e monitoramento abrangentes. Esse acesso pode ser gerenciado em qualquer nível, de projetos inteiros até tabelas específicas. Todos os dados em repouso no ambiente Google Cloud também são criptografados com chaves gerenciadas pelo próprio Cloud. Se for necessário, os usuários podem fornecer chaves privadas para criptografia adicional.
Tanto o Snowflake quanto o BigQuery têm dois componentes de custo: armazenamento e computação. Armazenamento é o custo de manter os dados no warehouse, independentemente do uso. Os custos de computação são calculados com base no uso de processamento ou no volume de dados processados.
Depois de ver os principais componentes de cada ferramenta, vamos revisar os destaques. Isso deve ajudar você a decidir qual solução adotar na sua empresa:
|
Componentes |
Snowflake |
BigQuery |
|
Performance |
Projetado para tarefas de negócio usuais e jobs de big data |
Projetado para analytics complexos, incluindo ML nativo no mecanismo de consulta |
|
Escalabilidade |
Escala automaticamente usando virtual warehouses na arquitetura multi-cluster |
Escala de forma nativa conforme a demanda |
|
Integração e ecossistema |
Agnóstico à nuvem, integra com outras plataformas via diversos conectores |
Foco principal no Google Cloud Platform; é possível extrair dados, mas a gestão é mais simples no GCP |
|
Segurança e conformidade |
Protocolos de segurança por usuário e recuperação em nível organizacional e de papéis. Janela de recuperação de até sete dias |
Google IAM com chaves gerenciadas pelo Google Cloud ou pelo usuário. Também oferece janela de recuperação de sete dias |
|
Custo de armazenamento |
Sob demanda a US$ 23/TB/mês, com preços contratuais reduzidos |
Depende do tipo de storage: US$ 20/TB (ativo) e US$ 10 (longo prazo) |
|
Custo de computação |
Baseado no tempo de computação usado, com faixas por nível de performance |
Baseado em dados processados a US$ 5/TB |
Snowflake e BigQuery têm vantagens e desvantagens próprias. Se o foco do seu negócio é análise direta, grandes volumes de dados e consultas rápidas, o Snowflake pode ser a melhor opção, com seus virtual warehouses autoescaláveis e precificação baseada em computação.
Se os objetivos envolvem analytics mais complexos com machine learning ou forte integração ao Google Cloud Platform, o BigQuery é a escolha ideal, com gestão de computação autoescalável, ML nativo e preços baseados em dados processados.
Aprender sobre ambos é a melhor estratégia para conquistar uma vaga como profissional de dados — e a DataCamp oferece diversos recursos para você se aprofundar.
Top DataCamp Courses
Curso
Curso
Curso
blog
Matt Crabtree
11 min
blog
Nisha Arya Ahmed
15 min
blog
Austin Chia
8 min
blog
Joleen Bothma
4 min
blog
Mona Khalil
5 min
Tutorial
Zoumana Keita
15 min