Curso
Introducción a Snowflake SQL
2 h
55.9K
marcos de almacenamiento y computación en la nube que ofrecen capacidades flexibles y de alto rendimiento para el almacenamiento y el análisis de datos.
Ahora las empresas pueden centralizar sus datos en la nube y realizar análisis en ese mismo entorno. La gestión de datos en la nube es clave para la analítica moderna, ya que permite el procesamiento en tiempo real, la analítica avanzada y el uso de aplicaciones de aprendizaje automático.
Snowflake y Google BigQuery son dos de las principales opciones de almacenes de datos en la nube. Snowflake cuenta con una arquitectura única que separa almacenamiento y cómputo y es independiente de la nube, lo que aporta flexibilidad en cualquier entorno.
Google BigQuery es una solución totalmente gestionada y sin servidores dentro de Google Cloud Platform, excelente para analizar conjuntos de datos masivos y complejos, e integra capacidades de aprendizaje automático. Ambos productos ofrecen potentes funciones para almacenar, procesar y analizar datos, lo que permite a los profesionales de datos responder a las preguntas del negocio de forma más eficiente y eficaz.
A medida que las organizaciones acumulan cantidades ingentes de datos, aprender estas plataformas es clave para iniciar una carrera profesional en datos.
En esta guía comparamos Snowflake y BigQuery: veremos sus características, similitudes y diferencias clave. Presentaremos ambos productos, sus ventajas e inconvenientes, y los compararemos en aspectos críticos como rendimiento, seguridad y coste.
Snowflake es un servicio de almacén de datos en la nube con una arquitectura propia orientada a ofrecer un escalado flexible de recursos, control de costes y mínima latencia. Si te interesa saber más, échale un vistazo a nuestro artículo Introduction to Snowflake for Beginners.
La arquitectura de Snowflake se basa en tres principios: computación multiclúster, datos compartidos y separación entre almacenamiento y cómputo.
La computación multiclúster es una arquitectura escalable donde varios clústeres de cómputo independientes, llamados almacenes virtuales, aportan recursos para cubrir la demanda. Una gran ventaja es el autoescalado de Snowflake: se crean más réplicas del mismo clúster cuando aumenta la necesidad de cómputo.
La capa de datos de Snowflake es un componente esencial de su arquitectura, diseñada para una gestión y almacenamiento eficientes. Combina un repositorio central con una red de datos distribuida. El repositorio central aloja todos los datos de la empresa y es accesible para todos los almacenes virtuales. Para mejorar el rendimiento y el escalado, los almacenes virtuales almacenan porciones de los datos que se usan con más frecuencia.
Snowflake separa el almacenamiento del cómputo, lo que permite que cada clúster escale de forma independiente del volumen almacenado. La capa de almacenamiento usa almacenamiento en la nube para conservar los datos, mientras que la capa de cómputo son los almacenes virtuales que procesan consultas. Esta separación habilita una gestión de recursos más flexible y un mejor control de costes.
Snowflake ofrece varias funciones clave que lo convierten en una solución de data warehousing potente y flexible:
Los almacenes virtuales son los clústeres MPP (procesamiento masivo en paralelo) de Snowflake que ejecutan consultas SQL. Se pueden escalar hacia arriba o abajo de forma independiente, de modo que ajustas la potencia de cómputo a cada carga de trabajo.
Además, cada almacén virtual es totalmente independiente y no comparte recursos con otros, garantizando que el rendimiento de uno no afecte al de los demás. Esta flexibilidad permite asignar recursos de forma eficiente y controlar el gasto, ya que puedes ajustar la capacidad de cómputo bajo demanda sin afectar al almacenamiento.
Time Travel permite acceder a datos históricos en cualquier punto dentro de un periodo definido. Es muy útil para recuperación, auditoría y análisis de cambios en el tiempo. Puedes consultar los datos tal como existían en un momento concreto del pasado o restaurar tablas, esquemas o bases de datos a un estado anterior.
La función de uso compartido seguro de datos de Snowflake permite compartir datos en vivo y gobernados con otras cuentas de Snowflake sin mover ni copiar la información. Este intercambio se realiza directamente dentro de Snowflake manteniendo la integridad y la seguridad. Facilita el acceso en tiempo real a socios, proveedores o clientes, fomentando la colaboración con garantías de gobierno y control.
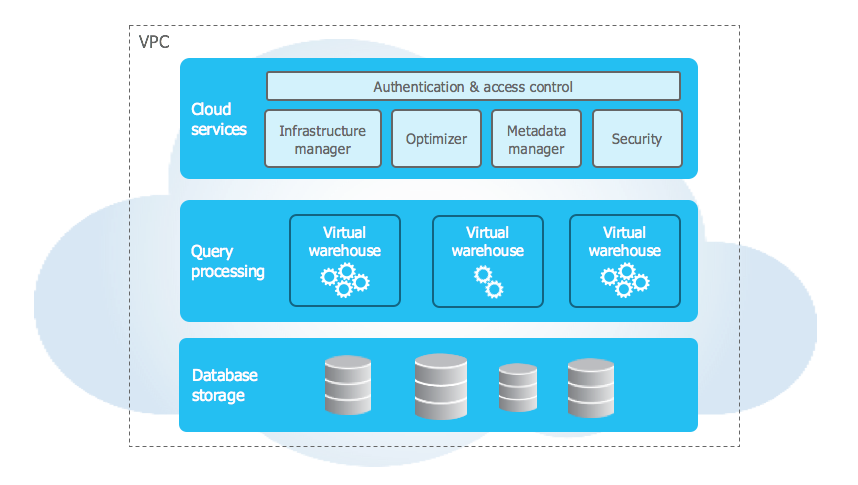
Arquitectura principal de Snowflake (Fuente: docs.snowflake.com)
Snowflake ofrece muchas ventajas frente a otros almacenes de datos en la nube gracias a su diseño arquitectónico y a su base independiente de la nube. No obstante, también presenta debilidades, como costes potencialmente altos y mayor complejidad.
Snowflake destaca por su fácil integración con cualquier sistema en la nube, su escalado flexible y su capacidad para gestionar cargas de trabajo diversas.
Snowflake presenta algunos inconvenientes relacionados con costes a gran escala y complejidad operativa. La mayor flexibilidad añade cierta complejidad de gestión y la tarificación puede ser difícil de prever.
BigQuery es el almacén de datos empresarial de Google, con potentes funciones de analítica y machine learning dentro de Google Cloud Platform. Al formar parte del ecosistema de Google Cloud, puede integrarse con otros servicios como Google Drive, Sheets y Cloud Storage. Así, es muy sencillo transferir, analizar y compartir datos dentro de Google Cloud Platform.
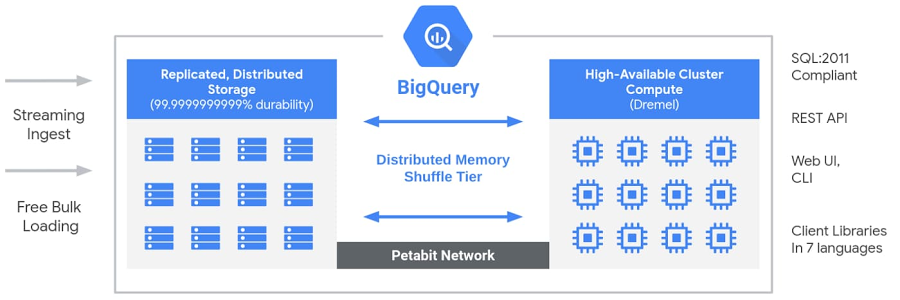
Arquitectura de BigQuery (Fuente: Google Cloud Blog)
BigQuery se construye sobre el motor Dremel de Google, que prioriza recursos de cómputo escalables para permitir análisis en tiempo real de datos columnares de solo lectura.
Para usar BigQuery dispones de una interfaz basada en SQL donde puedes ejecutar GoogleSQL optimizado. Funciona de manera similar a MapReduce, con un motor de ejecución de consultas, planificador lógico y analizador para la optimización.
La diferencia principal es que Dremel utiliza árboles agregadores para ejecutar consultas, lo que permite análisis en tiempo real, mientras que el marco MapReduce introduce latencia de forma natural.
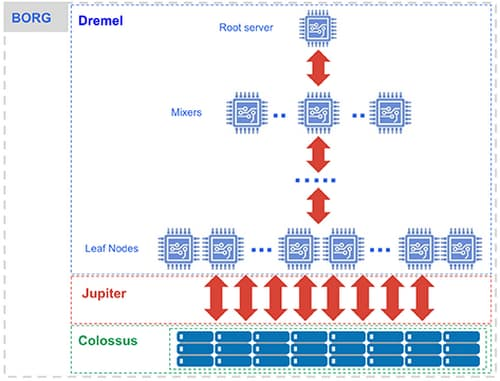
BigQuery Dremel (Fuente: Google Cloud Blog)
Ejecutar SQL en BigQuery tiene la ventaja de usar la sintaxis propia de Google. Ofrece muchas de las funciones de otros dialectos de SQL, con algunos extras. Una función reciente y útil en GoogleSQL es GROUP BY ALL.
Además, GoogleSQL permite bucles iterativos y uso de variables con más facilidad que otros dialectos. Incluso sin un conocimiento profundo de GoogleSQL, puedes aprovechar BigQuery con SQL estándar. No te pierdas este artículo sobre cómo empezar con BigQuery.
Crear modelos de machine learning de forma nativa en BigQuery es muy sencillo. Con sintaxis SQL puedes CREATE modelos de todo tipo. Ofrece modelos simples como regresión lineal y logística, y otros más complejos como árboles potenciados y redes neuronales. Los modelos se almacenan en BigQuery y puedes usarlos para generar resultados que se guardan como tablas, todo de forma nativa y sin paquetes externos.
BigQuery tiene varias ventajas que lo hacen muy potente gracias a su integración con GCP y al sistema Dremel:
Pese a sus ventajas, presenta algunos puntos débiles, en parte por estar diseñado para operar dentro de Google Cloud. Trabajar fuera de ese ecosistema puede ser más complejo para perfiles menos técnicos:
BigQuery y Snowflake ofrecen un rendimiento y escalabilidad similares, con matices. En escenarios sencillos, Snowflake suele ser mejor opción. A medida que tus datos crecen y se vuelven más complejos, BigQuery gana ventaja por su estructura de costes más eficiente y su escalado prácticamente ilimitado.
En pruebas TPC-H, Snowflake supera a BigQuery. Es decir, en la mayoría de preguntas de negocio estándar, Snowflake rendirá mejor. Gracias a su computación multiclúster y su arquitectura de datos compartidos, Snowflake escala con facilidad para cubrir las necesidades de cualquier empresa.
Aunque en consultas sencillas pueda no ser tan eficiente como Snowflake, BigQuery brilla en análisis complejos. El escalado automático nativo exige muy poca gestión para aumentar recursos. Aunque existen ciertos límites por recursos compartidos dentro de una organización, escribir consultas eficientes que procesen el mínimo de datos ayudará a mantener un rendimiento óptimo.
Snowflake opera en un ecosistema independiente de la nube, no ligado a un proveedor concreto. Esto permite integrarse fácilmente con otras plataformas mediante conectores. Así, es fluido crear pipelines de ETL y analítica que alimenten otros componentes de la organización en la nube.
En torno a Snowflake existe un ecosistema de más de 60 herramientas y tecnologías de terceros con conectividad nativa. Estas integraciones simplifican la preparación, migración y visualización de datos. Para BI más avanzado, Snowflake también cuenta con Snowflake Marketplace, que da acceso a conjuntos de datos, apps y productos de IA diseñados específicamente para su entorno.
Al estar construido en Google Cloud Platform, BigQuery encaja mejor para quienes están muy invertidos en GCP. Si la mayoría de tus procesos están en Google Cloud (Compute Engine, Cloud Storage, Cloud Run), puede ser ventajoso usar BigQuery para mantener los data pipelines en el mismo entorno. Mantener todo dentro de GCP ayuda a optimizar costes y tiempos de cómputo. Además, su integración nativa con herramientas de IA/ML lo hace ideal para organizaciones con analítica impulsada por IA: los pipelines alimentan BigQuery y desde ahí se entrenan modelos y se generan predicciones.
La seguridad es una prioridad para quienes usan servicios en la nube. Cumplir con las normativas es fundamental. Por suerte, los proveedores ofrecen abundante guía sobre seguridad y cumplimiento, lo que permite configurar los datos para cumplir los estándares. Tanto Snowflake como BigQuery ofrecen funciones similares de seguridad con gestión de acceso basada en roles y opciones de recuperación.
Snowflake incorpora funciones para una experiencia segura y fiable. Una de ellas es Time Travel, que permite recuperar datos en caso de borrados accidentales.
Otra medida es Fail-safe, que conserva datos históricos siete días después de que expire el periodo de Time Travel. Estos datos no son accesibles directamente, pero Snowflake puede recuperarlos, asegurando la resiliencia.
Para el control de acceso, Snowflake combina control de acceso discrecional y basado en roles en un único sistema robusto. Esto permite gestionar privilegios con precisión de forma sencilla, basada en roles.
Snowflake también prioriza la seguridad con cifrado fuerte para proteger los datos en tránsito y en reposo. Para los datos en reposo, cifra toda la información con un modelo jerárquico de claves que Snowflake rota y gestiona automáticamente sin intervención del cliente.
BigQuery también permite cierta recuperación gracias a su time travel, con el que puedes recuperar tablas borradas dentro de una ventana de siete días. Sin embargo, si se elimina todo el dataset, no es posible recuperar los datos, a diferencia de Snowflake. Por ello conviene extremar la precaución con los borrados en BigQuery.
La seguridad de BigQuery para datos en reposo la gestiona principalmente Google. Ofrece IAM, con control de acceso y monitorización exhaustivos. Este acceso puede gestionarse a cualquier nivel: desde proyectos completos hasta tablas concretas dentro de un proyecto. Todos los datos en reposo en Google Cloud están cifrados con claves gestionadas por Google; si necesitas seguridad adicional, puedes aportar tus propias claves privadas para un cifrado extra.
Tanto Snowflake como BigQuery estructuran sus costes en dos componentes: almacenamiento y cómputo. El almacenamiento es lo que pagas por guardar datos, independientemente del uso. El cómputo se calcula según el cómputo utilizado o la cantidad de datos procesados.
Ahora que hemos visto los componentes clave de ambas herramientas, repasemos sus puntos fuertes. Esto debería ayudarte a decidir cuál utilizar en tu organización:
|
Componentes |
Snowflake |
BigQuery |
|
Rendimiento |
Diseñado para tareas habituales de negocio y trabajos de big data |
Diseñado para analítica compleja, con ML integrado de forma nativa en el motor de consultas |
|
Escalabilidad |
Escala automáticamente con almacenes virtuales y arquitectura multiclúster |
Escala de forma nativa según las necesidades |
|
Integración y ecosistema |
Independiente de la nube; se integra con otras plataformas mediante conectores |
Enfocado principalmente en Google Cloud Platform; se puede exportar, pero lo más fácil es gestionarlo en GCP |
|
Seguridad y cumplimiento |
Protocolos basados en usuarios y roles; recuperación de datos en una ventana de siete días |
Google IAM con claves gestionadas por Google o por el usuario; también ofrece una ventana de recuperación de siete días |
|
Coste de almacenamiento |
Bajo demanda a 23 $/TB/mes, con precios por contrato más bajos |
Según tipo de almacenamiento: 20 $/TB activo y 10 $ a largo plazo |
|
Coste de cómputo |
Según tiempo de cómputo usado, con niveles por rendimiento |
Según datos procesados a 5 $/TB |
Snowflake y BigQuery tienen ventajas e inconvenientes propios. Si tu negocio busca análisis directos, grandes volúmenes y consultas rápidas, Snowflake puede ser mejor opción por sus almacenes virtuales con autoescalado y su precio basado en cómputo.
Si tus objetivos requieren analítica más compleja con machine learning o tienes una fuerte integración con Google Cloud Platform, BigQuery es la apuesta segura gracias a su gestión de cómputo con autoescalado, su ML nativo y su precio basado en datos procesados.
Aprender ambas es la mejor vía para impulsar tu carrera en datos, y DataCamp ofrece multitud de recursos para seguir avanzando.
Top DataCamp Courses
Curso
Curso
Curso
blog
Gus Frazer
14 min
blog
Kurtis Pykes
12 min
blog
Nisha Arya Ahmed
15 min
blog
Shaun Edmond
14 min
blog
Samuel Shaibu
10 min
blog
Joleen Bothma
12 min