
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
cloudgebaseerde opslag- en rekenframeworks om flexibele en krachtige mogelijkheden voor dataopslag en -analyse te bieden.
Bedrijven kunnen nu data consolideren in gecentraliseerde cloudopslag en analyses in dezelfde omgeving uitvoeren. Cloud datawarehousing is cruciaal voor moderne data-analyse omdat het realtime dataverwerking, geavanceerde analytics en machinelearning-toepassingen kan ondersteunen.
Snowflake en Google BigQuery zijn twee van de belangrijkste opties als het gaat om cloud datawarehouses. Snowflake heeft een unieke architectuur die opslag en rekenresources scheidt en is cloud-agnostisch, wat flexibiliteit in elke omgeving mogelijk maakt.
Google BigQuery is een volledig beheerde, serverloze oplossing binnen Google Cloud Platform die uitblinkt in het analyseren van enorme, complexe datasets en geïntegreerde machinelearning-mogelijkheden heeft. Beide producten bieden krachtige functies voor dataopslag, -verwerking en -analyse, waardoor dataprofessionals bedrijfsvragen efficiënter en effectiever met hun data kunnen beantwoorden.
Naarmate organisaties enorme hoeveelheden data blijven verzamelen, speelt het leren van deze platforms een cruciale rol bij het starten van een carrière in data.
Deze gids onderzoekt Snowflake vs BigQuery en gaat in op hun functies, overeenkomsten en belangrijkste verschillen. We introduceren beide producten, laten hun voor- en nadelen zien en maken enkele belangrijke vergelijkingen op cruciale punten zoals prestaties, veiligheid en kosten.
Snowflake is een cloud datawarehouse-service met een eigen architectuur die is gericht op flexibele resourceschaalbaarheid, kostenbeheer en het minimaliseren van latentie. Als je meer wilt weten, bekijk dan ons artikel Introductie tot Snowflake voor beginners.
De architectuur van Snowflake draait om drie hoofdprincipes: multi-cluster computing, gedeelde data en scheiding van opslag en compute.
Multi-cluster computing is een schaalbare architectuur waarbij meerdere, onafhankelijke computeclusters, zogenaamde virtual warehouses, rekenkracht leveren om aan de vraag te voldoen. Een geweldig kenmerk is Snowflakes autoscaling, waarbij meer kopieën van hetzelfde cluster worden gemaakt om aan de computevraag te voldoen.
De datalaag van Snowflake is een cruciaal onderdeel van de architectuur, ontworpen voor efficiënte databeheer en -opslag. Het heeft zowel een centrale repository als een gedistribueerd datanetwerk. De centrale datarepository bevat alle data van de onderneming en is toegankelijk voor alle virtual warehouses. Voor betere prestaties en schaalbaarheid slaan de virtual warehouses een deel van de volledige dataset op die het vaakst wordt gebruikt.
Snowflake scheidt opslag van compute, waardoor elk computecluster onafhankelijk kan schalen van het opslagvolume. De opslaglaag gebruikt cloudopslag om alle data persistent te bewaren, terwijl de computelaag bestaat uit virtual warehouses die queries verwerken. Deze scheiding maakt flexibel resourcemanagement en kostenbeheersing mogelijk.
Snowflake biedt verschillende kernfuncties die het tot een krachtige en flexibele datawarehouse-oplossing maken:
Virtual warehouses zijn Snowflakes MPP- (massively parallel processing) computeclusters die SQL-queries uitvoeren. Ze kunnen onafhankelijk worden opgeschaald of afgeschaald, zodat gebruikers de rekenkracht kunnen afstemmen op specifieke workloadbehoeften.
Daarnaast is elk virtual warehouse volledig onafhankelijk en deelt het geen resources met andere warehouses, waardoor de prestaties van andere warehouses niet worden beïnvloed. Deze flexibiliteit maakt efficiënte toewijzing van resources en kostenbeheer mogelijk, omdat gebruikers de rekencapaciteit on demand kunnen aanpassen zonder invloed op de dataopslag.
Time Travel is een functie waarmee gebruikers historische data kunnen benaderen op elk moment binnen een ingestelde periode. Dit is handig voor dataherstel, auditing en het analyseren van datawijzigingen in de tijd. Gebruikers kunnen data opvragen zoals die op specifieke momenten in het verleden bestond, of zelfs tabellen, schema’s of databases herstellen naar een eerdere staat.
Met de functie voor veilig datadelen van Snowflake kunnen organisaties live, gereguleerde data delen met andere Snowflake-accounts zonder de data te verplaatsen of te kopiëren. Dit naadloze delen gebeurt rechtstreeks binnen Snowflake, met behoud van dataintegriteit en -beveiliging. Het maakt realtime datatoegang mogelijk voor partners, leveranciers of klanten, stimuleert samenwerking en waarborgt tegelijk datagovernance en -controle.
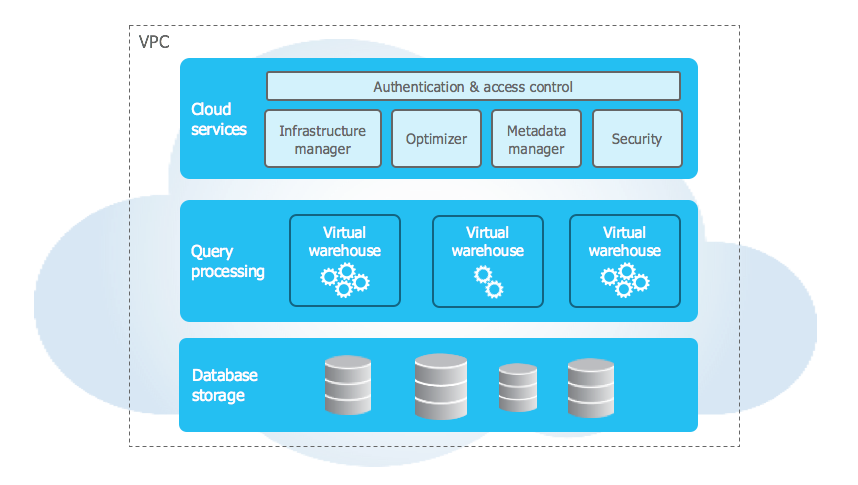
De primaire architectuur van Snowflake (Bron: docs.snowflake.com)
Snowflake biedt veel voordelen ten opzichte van andere cloud datawarehouse-oplossingen dankzij het architectuurontwerp en de cloud-agnostische basis. Toch zijn er ook zwakke punten, waaronder mogelijk hoge kosten en complexiteit.
Snowflake heeft een aantal voordelen dankzij de mogelijkheid om eenvoudig met elk cloudsysteem te integreren, flexibel te schalen en diverse workloads te verwerken..
Er zijn enkele nadelen aan Snowflake die samenhangen met schaalkosten en beheercomplexiteit. De grotere flexibiliteit voegt wat extra complexiteit toe aan het beheer en de prijsstelling kan lastig te voorspellen zijn.
BigQuery is Google’s enterprise datawarehouse met krachtige analytische en machinelearningfunctionaliteit binnen het Google Cloud Platform. Omdat BigQuery deel uitmaakt van het Google Cloud-ecosysteem, kan het interageren met andere componenten van Google Cloud zoals Google Drive, Sheets en Cloud Storage. Dit stelt gebruikers in staat om snel en eenvoudig data te verplaatsen, analyseren en delen binnen het Google Cloud Platform.
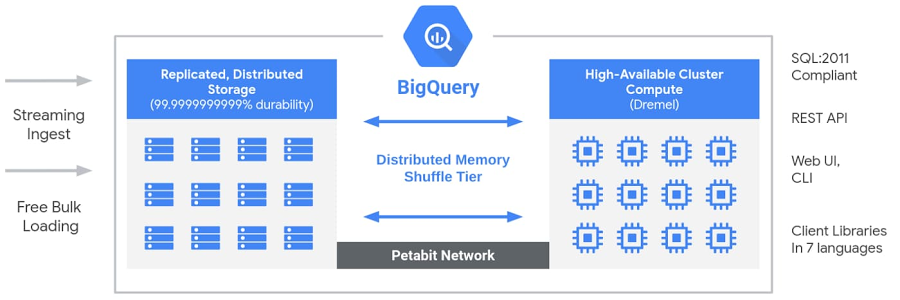
BigQuery-architectuur (Bron: Google Cloud Blog)
BigQuery is gebouwd op Google’s Dremel-engine, die zich richt op schaalbare rekenresources om realtime analyse van read-only kolomgeoriënteerde data mogelijk te maken.
Om BigQuery te gebruiken, hebben gebruikers een SQL-gebaseerde interface waarin je geoptimaliseerde GoogleSQL kunt draaien. Het werkt vergelijkbaar met MapReduce, waarbij het een query execution engine, logical planner en query parser gebruikt voor optimalisatie.
Het belangrijkste verschil is dat Dremel aggregator trees gebruikt voor query-executie, waardoor realtime analyse mogelijk is, terwijl het MapReduce-framework van nature wat latentie heeft.
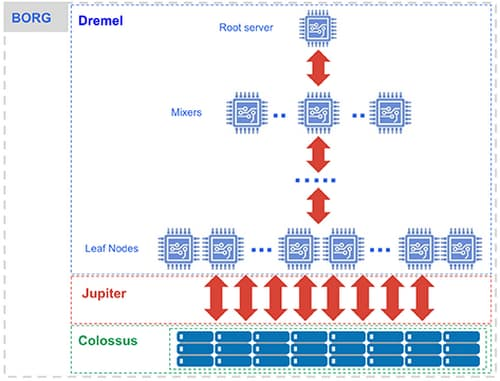
BigQuery Dremel (Bron: Google Cloud Blog)
SQL draaien in BigQuery heeft als voordeel dat je Google’s unieke SQL-syntaxis kunt gebruiken. Het biedt veel van dezelfde functies als andere SQL-talen, met een paar extra toeters en bellen. Een recente functie van GoogleSQL die handig is, is de functie GROUP BY ALL.
Daarnaast biedt GoogleSQL de mogelijkheid om zaken als iteratieve lussen en het gebruik van variabelen eenvoudiger te doen dan sommige andere SQL-talen. Zelfs zonder diepgaande kennis van GoogleSQL kunnen gebruikers BigQuery nog steeds eenvoudig benutten met standaard SQL. Bekijk zeker dit artikel over hoe je aan de slag gaat met BigQuery.
Machinelearningmodellen native in BigQuery maken is vrij eenvoudig. Je kunt SQL-syntaxis gebruiken om modellen van allerlei soorten te CREATE. Het biedt eenvoudige modellen zoals lineaire regressie en logistische regressie, evenals complexe modellen zoals boosted trees en neurale netwerken. Modellen worden vervolgens in BigQuery zelf opgeslagen en kunnen eenvoudig worden gebruikt om resultaten te genereren die vervolgens als tabellen worden opgeslagen. Dit gebeurt native in BigQuery zonder dat externe packages hoeven te worden geïmporteerd.
BigQuery heeft een aantal voordelen die het tot een krachtig hulpmiddel maken dankzij de integratie met GCP en het Dremel-systeem:
Zelfs met deze voordelen zijn er een paar zwakke punten. Sommige daarvan komen voort uit het feit dat BigQuery is ontworpen om te bestaan binnen Google Cloud. Werken met data buiten dat ecosysteem kan uitdagend zijn voor een minder technisch ingestelde dataprofessional:
Zowel BigQuery als Snowflake bieden vergelijkbare prestaties en schaalbaarheid, met subtiele nuances. In eenvoudigere situaties is Snowflake een betere keuze. Naarmate je data groeit en complexer wordt, krijgt BigQuery een voorsprong met zijn efficiëntere kostenstructuur en vrijwel grenzeloze schaalbaarheid.
Snowflakes benchmarkprestaties op de TPC-H overtreffen BigQuery. Dit betekent dat Snowflake bij de meeste standaard bedrijfsvragen beter zal presteren. Dankzij de multi-cluster computing en gedeelde data-architectuur kan Snowflake eenvoudig opschalen om aan de eisen van elke onderneming te voldoen.
Hoewel BigQuery mogelijk niet zo efficiënt is als Snowflake bij sommige eenvoudigere query’s, blinkt het uit bij complexe analyses. De native automatische schaalbaarheid vereist zeer weinig beheer om rekenresources te vergroten. Hoewel er enkele limieten zijn, door gedeelde resources binnen een organisatie, zorgt het schrijven van efficiënte query’s die de minimale hoeveelheid data verwerken ervoor dat de prestaties optimaal blijven.
Snowflake draait in een cloud-agnostisch ecosysteem dat niet aan een specifiek cloudplatform is gebonden. Dat betekent dat het eenvoudig kan worden geïntegreerd met andere cloudplatforms via de juiste connectors. Dit zorgt voor een soepele ervaring bij het creëren van ETL- en analytische pijplijnen die andere delen van de cloudomgeving voeden.
Rondom Snowflake bestaat een ecosysteem van 60+ tools en technologieën van derden die native connectiviteit met Snowflake bieden. Deze integraties maken het eenvoudiger om data voor te bereiden, te migreren en te visualiseren met deze tools. Voor meer geavanceerde BI-functionaliteit is er ook de Snowflake Marketplace, die toegang biedt tot unieke datasets, apps en AI-producten die specifiek voor de Snowflake-omgeving zijn gebouwd.
Omdat het is gebouwd binnen Google Cloud Platform, is BigQuery meer geschikt voor wie zwaar inzet op GCP. Als je de meeste processen binnen Google Cloud Platform hebt, zoals Google Compute Engine, Cloud Storage en Cloud Run, kan het voordelig zijn om BigQuery te gebruiken om je datapijplijnen binnen dezelfde omgeving te houden. Door alles binnen de omgeving te houden, kunnen kosten en rekentijd worden geoptimaliseerd. Bovendien maken de native integraties met AI/ML-tools in BigQuery het perfect voor organisaties die AI-gedreven analytics gebruiken. Datapijplijnen kunnen data rechtstreeks naar BigQuery voeren, dat vervolgens modellen kan trainen/uitkomsten kan voorspellen op basis van die data.
Beveiliging is een topzorg voor gebruikers van clouddiensten. Zorgen voor naleving van overheidsnormen is belangrijk. Gelukkig bieden cloudproviders doorgaans ruime richtlijnen over beveiliging en compliance, zodat gebruikers hun data eenvoudig kunnen configureren op een manier die aan hun beveiligingsnormen voldoet. Zowel Snowflake als BigQuery hebben vergelijkbare beveiligingsfuncties met rolgebaseerd toegangsbeheer en functies voor dataherstel.
Snowflake biedt functies voor een veilige en betrouwbare ervaring voor organisaties. Een daarvan is de Time Travel-functie, die dataherstel mogelijk maakt in het geval van per ongeluk verwijderen.
Een andere databeschermingsfunctie is Fail-safe, dat historische data zeven dagen bewaart nadat de Time Travel-bewaarperiode is verlopen. Deze data is niet direct toegankelijk, maar kan door Snowflake worden hersteld, wat datarobuustheid waarborgt.
Voor toegangscontrole combineert Snowflake discretionair toegangsbeheer en rolgebaseerd toegangsbeheer tot één robuust toegangscontrolesysteem. Dit stelt organisaties in staat om toegangsrechten precies te beheren op een eenvoudige, rolgebaseerde manier.
Snowflake geeft ook prioriteit aan beveiliging door sterke versleutelingsstandaarden te hanteren om data zowel tijdens transport als in rust te beschermen. Voor data in rust versleutelt Snowflake alle opgeslagen data met een hiërarchisch sleutemodel dat automatisch door Snowflake wordt geroteerd en beheerd, zonder tussenkomst van de klant.
BigQuery biedt ook dataherstel dankzij time-travelmogelijkheden, waarmee gebruikers verwijderde tabellen kunnen herstellen binnen het venster van zeven dagen. Als echter de volledige dataset wordt verwijderd, kunnen gebruikers verloren data niet herstellen, in tegenstelling tot in Snowflake. Dat betekent dat verwijderen in BigQuery iets voorzichtiger moet worden behandeld.
De beveiliging van BigQuery wordt voor data in rust primair door Google beheerd. Google biedt IAM, dat uitgebreide toegangscontrole en monitoring levert. Deze toegang kan op elk niveau worden beheerd, van volledige projecten tot aan specifieke tabellen binnen een bepaald project. Alle data in rust binnen de Google Cloud-omgeving wordt ook versleuteld met door Google Cloud beheerde sleutels. Als extra beveiliging nodig is, kunnen gebruikers hun eigen privésleutels leveren die data binnen Google Cloud verder kunnen versleutelen.
Zowel Snowflake als BigQuery hebben twee kostencomponenten: opslag en compute. Opslag is de kosten voor het bewaren van data in het warehouse ongeacht gebruik. Computekosten worden berekend op basis van de hoeveelheid gebruikte compute of de hoeveelheid verwerkte data.
Nu we enkele belangrijke onderdelen van beide tools hebben doorgenomen, bekijken we hun belangrijkste hoogtepunten. Dit zou moeten helpen om te beslissen welke tool je voor jouw organisatie gebruikt:
|
Componenten |
Snowflake |
BigQuery |
|
Prestaties |
Ontworpen voor gebruikelijke bedrijfstaken en bigdata-jobs |
Ontworpen voor complexe analytics, inclusief ML dat native in de query-engine is ingebouwd |
|
Schaalbaarheid |
Kan automatisch schalen via virtual warehouses met zijn multi-clusterarchitectuur |
Schaalt native op basis van behoeften |
|
Integratie en ecosysteem |
Cloud-agnostisch, integreert met andere cloudplatforms via diverse connectors |
Primair gericht op Google Cloud Platform; data kan worden overgezet, maar is het makkelijkst te beheren in GCP |
|
Beveiliging en compliance |
Gebruikersgebaseerde beveiligingsprotocollen en herstel op organisatie- en rolniveau. Heeft dataherstelprotocollen binnen zeven dagen |
Google IAM met door Google Cloud beheerde sleutels of door de gebruiker beheerde sleutels. Biedt ook een herstelvenster van zeven dagen |
|
Opslagkosten |
On-demand opslag voor $23/TB/maand met contractgebaseerde prijsstelling die lager is |
Gebaseerd op type opslag: $20/TB actief en $10 voor langetermijn. C |
|
Computekosten |
Gebaseerd op gebruikte rekentijd, getrapt naar prestatieniveaus |
Gebaseerd op verwerkte data à $5/TB |
Zowel Snowflake als BigQuery hebben hun unieke voor- en nadelen. Als je bedrijf vooral geïnteresseerd is in rechttoe rechtaan analyses, grote hoeveelheden data en snelle query’s, dan is Snowflake mogelijk een betere optie met zijn autoscalende virtual warehouses en compute-gebaseerde prijsstelling.
Als je bedrijfsdoelen complexere analytics met machinelearning zijn of een sterke integratie binnen de Google Cloud Platform-omgeving, dan is BigQuery de beste keuze met zijn autoscalende computebeheer, native ML-integratie en prijsstelling op basis van verwerkte data.
Over beide leren is de beste optie om een baan als dataprofessional te krijgen en DataCamp biedt tal van bronnen om meer te leren.
Topcursussen op DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


