

Corso
Introduzione ai modelli Claude
3 ore
15K
Pratica and corso your progress.
Continua Con GoogleAnthropic ha di nuovo un nuovissimo secondo miglior modello.
Questa volta è Claude Opus 5, presentato come un'intelligenza vicina alla frontiera, ma a metà del prezzo di Claude Fable 5 e, per di più, Opus 5 supera effettivamente Fable 5 in diverse valutazioni di codice e lavori di conoscenza, tra cui Frontier-Bench e GDPval-AA. È semplicemente al secondo posto rispetto al non ancora ampiamente disponibile Mythos 5.
Di seguito trovi una panoramica di cosa c'è di nuovo in Opus 5, di come si comporta in altri test di benchmark, di cosa dice Anthropic sul suo allineamento e profilo di sicurezza, e dei relativi costi.
Opus 5 è l'ultimo rilascio nel tier Opus di Anthropic che, in termini di capacità complessiva, si colloca sotto Mythos, ma sopra Sonnet e Haiku.
Anthropic ci dice che il suo nuovo modello è "riflessivo e proattivo" (tendono sempre un po' ad antropomorfizzare). Aggiungono che il modello è pensato per l'uso quotidiano, il che, per un ingegnere AI, significa che è abbastanza efficiente da poter girare in continuo.
Nelle valutazioni di codice e lavori di conoscenza come Frontier-Bench e GDPval-AA, Anthropic afferma che Opus 5 è ora lo stato dell'arte tra i suoi modelli, anche se resta indietro rispetto a Mythos 5 in compiti specifici di cybersecurity, che trattiamo nel dettaglio nel nostro articolo su Mythos 5.
Per vedere il confronto diretto con modelli concorrenti e "fratelli", leggi le nostre guide:
Due aspetti spiccano nel modo in cui Anthropic inquadra le novità: un orientamento a portare a termine i compiti invece di fermarsi a una risposta plausibile, e un salto nella qualità dell'output visivo.
Il cambiamento qualitativo più grande di Opus 5 è la disponibilità a continuare a lavorare finché un compito non riesce davvero. Anthropic ci fornisce un'idea di cosa significa:
Questa disponibilità a iterare, invece di accontentarsi di una risposta plausibile, sembra essere ciò che spinge il salto di Opus 5 nei benchmark agentici come Frontier-Bench.
Anthropic segnala anche che Opus 5 è in grado di produrre output visivi significativamente migliori rispetto ai modelli precedenti, indicando esempi come una visualizzazione in stile galleria del vento del flusso d'aria su oggetti aerodinamici, come un'auto. È stato un esempio convincente e una buona notizia se il tuo lavoro implica la creazione di diagrammi generativi.
Questa tabella include solo i modelli di Anthropic. Ho esaminato i rispettivi annunci di rilascio e allineato ciò che era possibile. Confronterò Opus 5 con i modelli concorrenti nella prossima sezione.
Nota: "non divulgato" o "non pubblicato" significa che quel modello non è stato incluso in quello specifico benchmark nell'annuncio da cui proviene, non che abbia totalizzato zero.
| Benchmark | Haiku 4.5 | Sonnet 4.6 | Opus 4.7 | Opus 4.8 | Sonnet 5 | Fable 5 | Opus 5 |
|---|---|---|---|---|---|---|---|
| SWE-bench Verified | 73.3% | 79.6% | 87.6% | 88.6% | — | 95.0% | 96.0% |
| SWE-bench Pro | — | 58.1% | 64.3% | 69.2% | 63.2% | 80.3% | 79.2% |
| Terminal-Bench | 41% | 67.0% (2.1) | 69.4% (2.0) | 74.6% (2.1) | 80.4% (2.1) | 88.0% (2.1) | non pubblicato |
| Frontier-Bench v0.1 (nuova valutazione) | — | — | — | 18.7% | — | 33.7% | 43.3% |
| GDPval-AA / v2 (Elo, /2000) | — | — | 1.753 | 1.890 (v1) / 1.593 (v2) | 1.618 (v2) | 1.747 (v2) | 1.861 (v2) |
| Audit di comportamenti disallineati (più basso = meglio) | — | — | — | non divulgato | non divulgato | non divulgato | 2,3 (finora il migliore) |
| Prezzo ($/MTok in/out) | $1/$5 | $3/$15 | $5/$25 | $5/$25 | $2–3/$10–15 | $10/$50 | $5/$25 |
Come si vede nella tabella sopra, Opus 5 batte il suo "fratello" più costoso su Frontier-Bench v0.1 (43,3% vs 33,7%) e GDPval-AA v2 (1861 vs 1747) — ancora una volta a metà del prezzo di Fable 5.
Questo è il salto generazionale più chiaro: Opus 5 supera il suo predecessore su ARC-AGI-3, passando dall'1,5% al 30,2%, e su Frontier-Bench v0.1, che, come si vede nella tabella sopra, più che raddoppia (43,3% vs 18,7%). Tieni presente che Opus 4.8 è stato rilasciato solo due mesi fa.
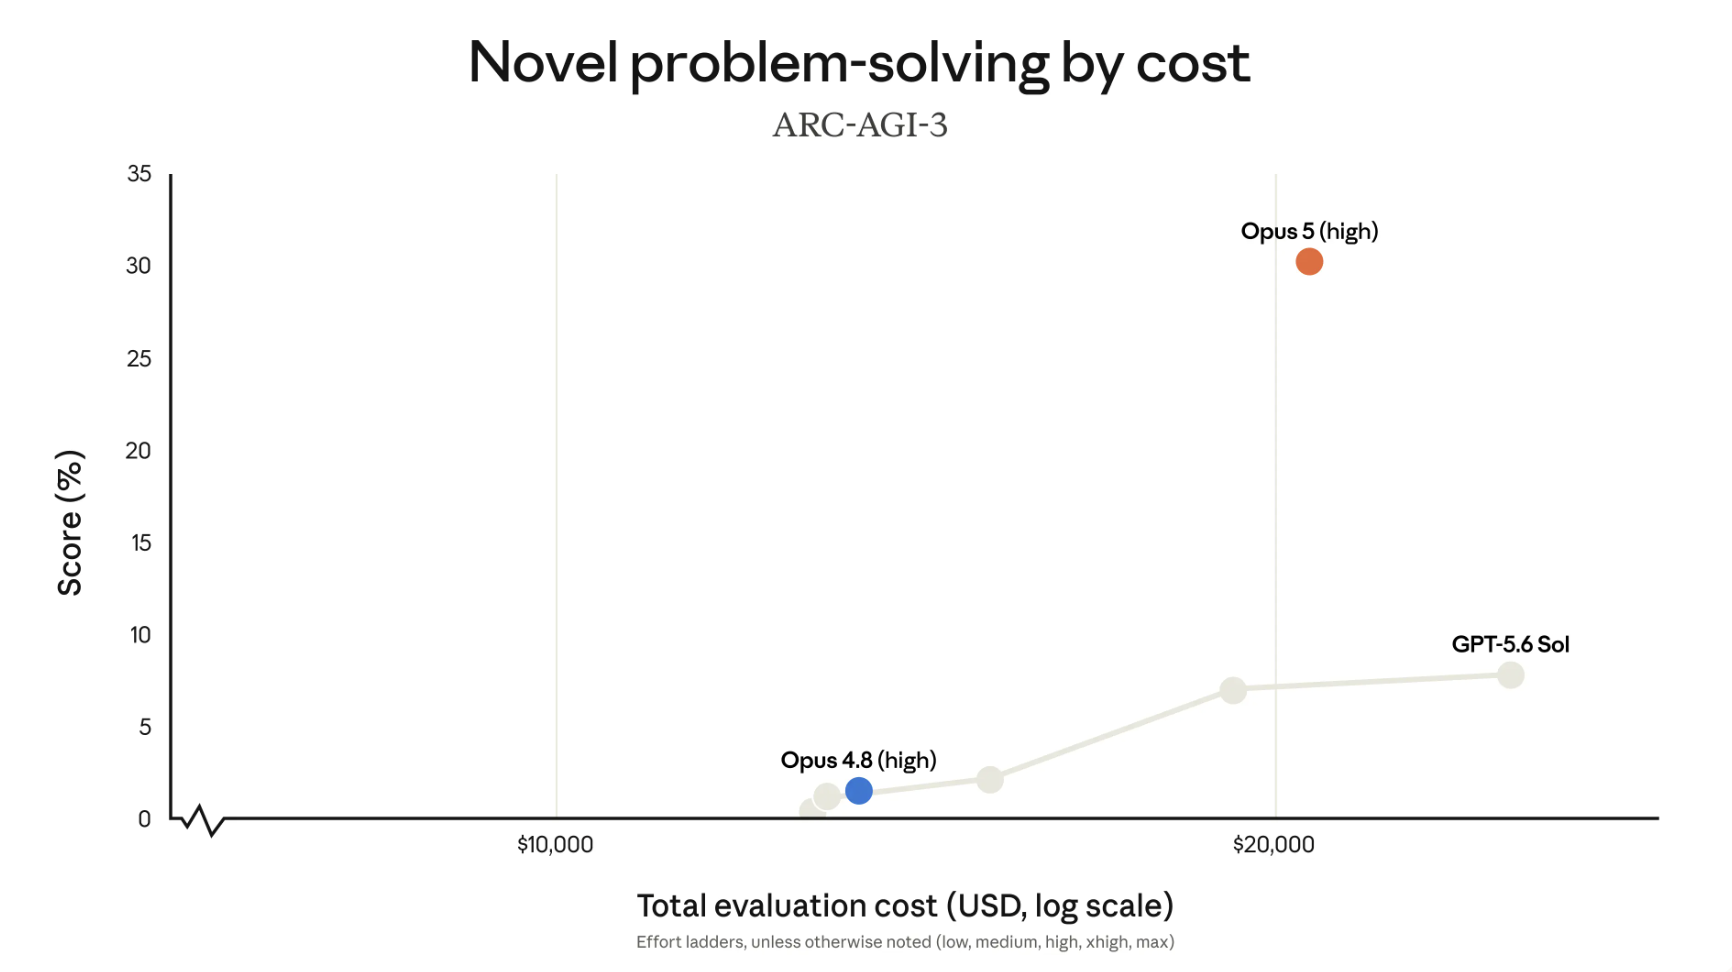
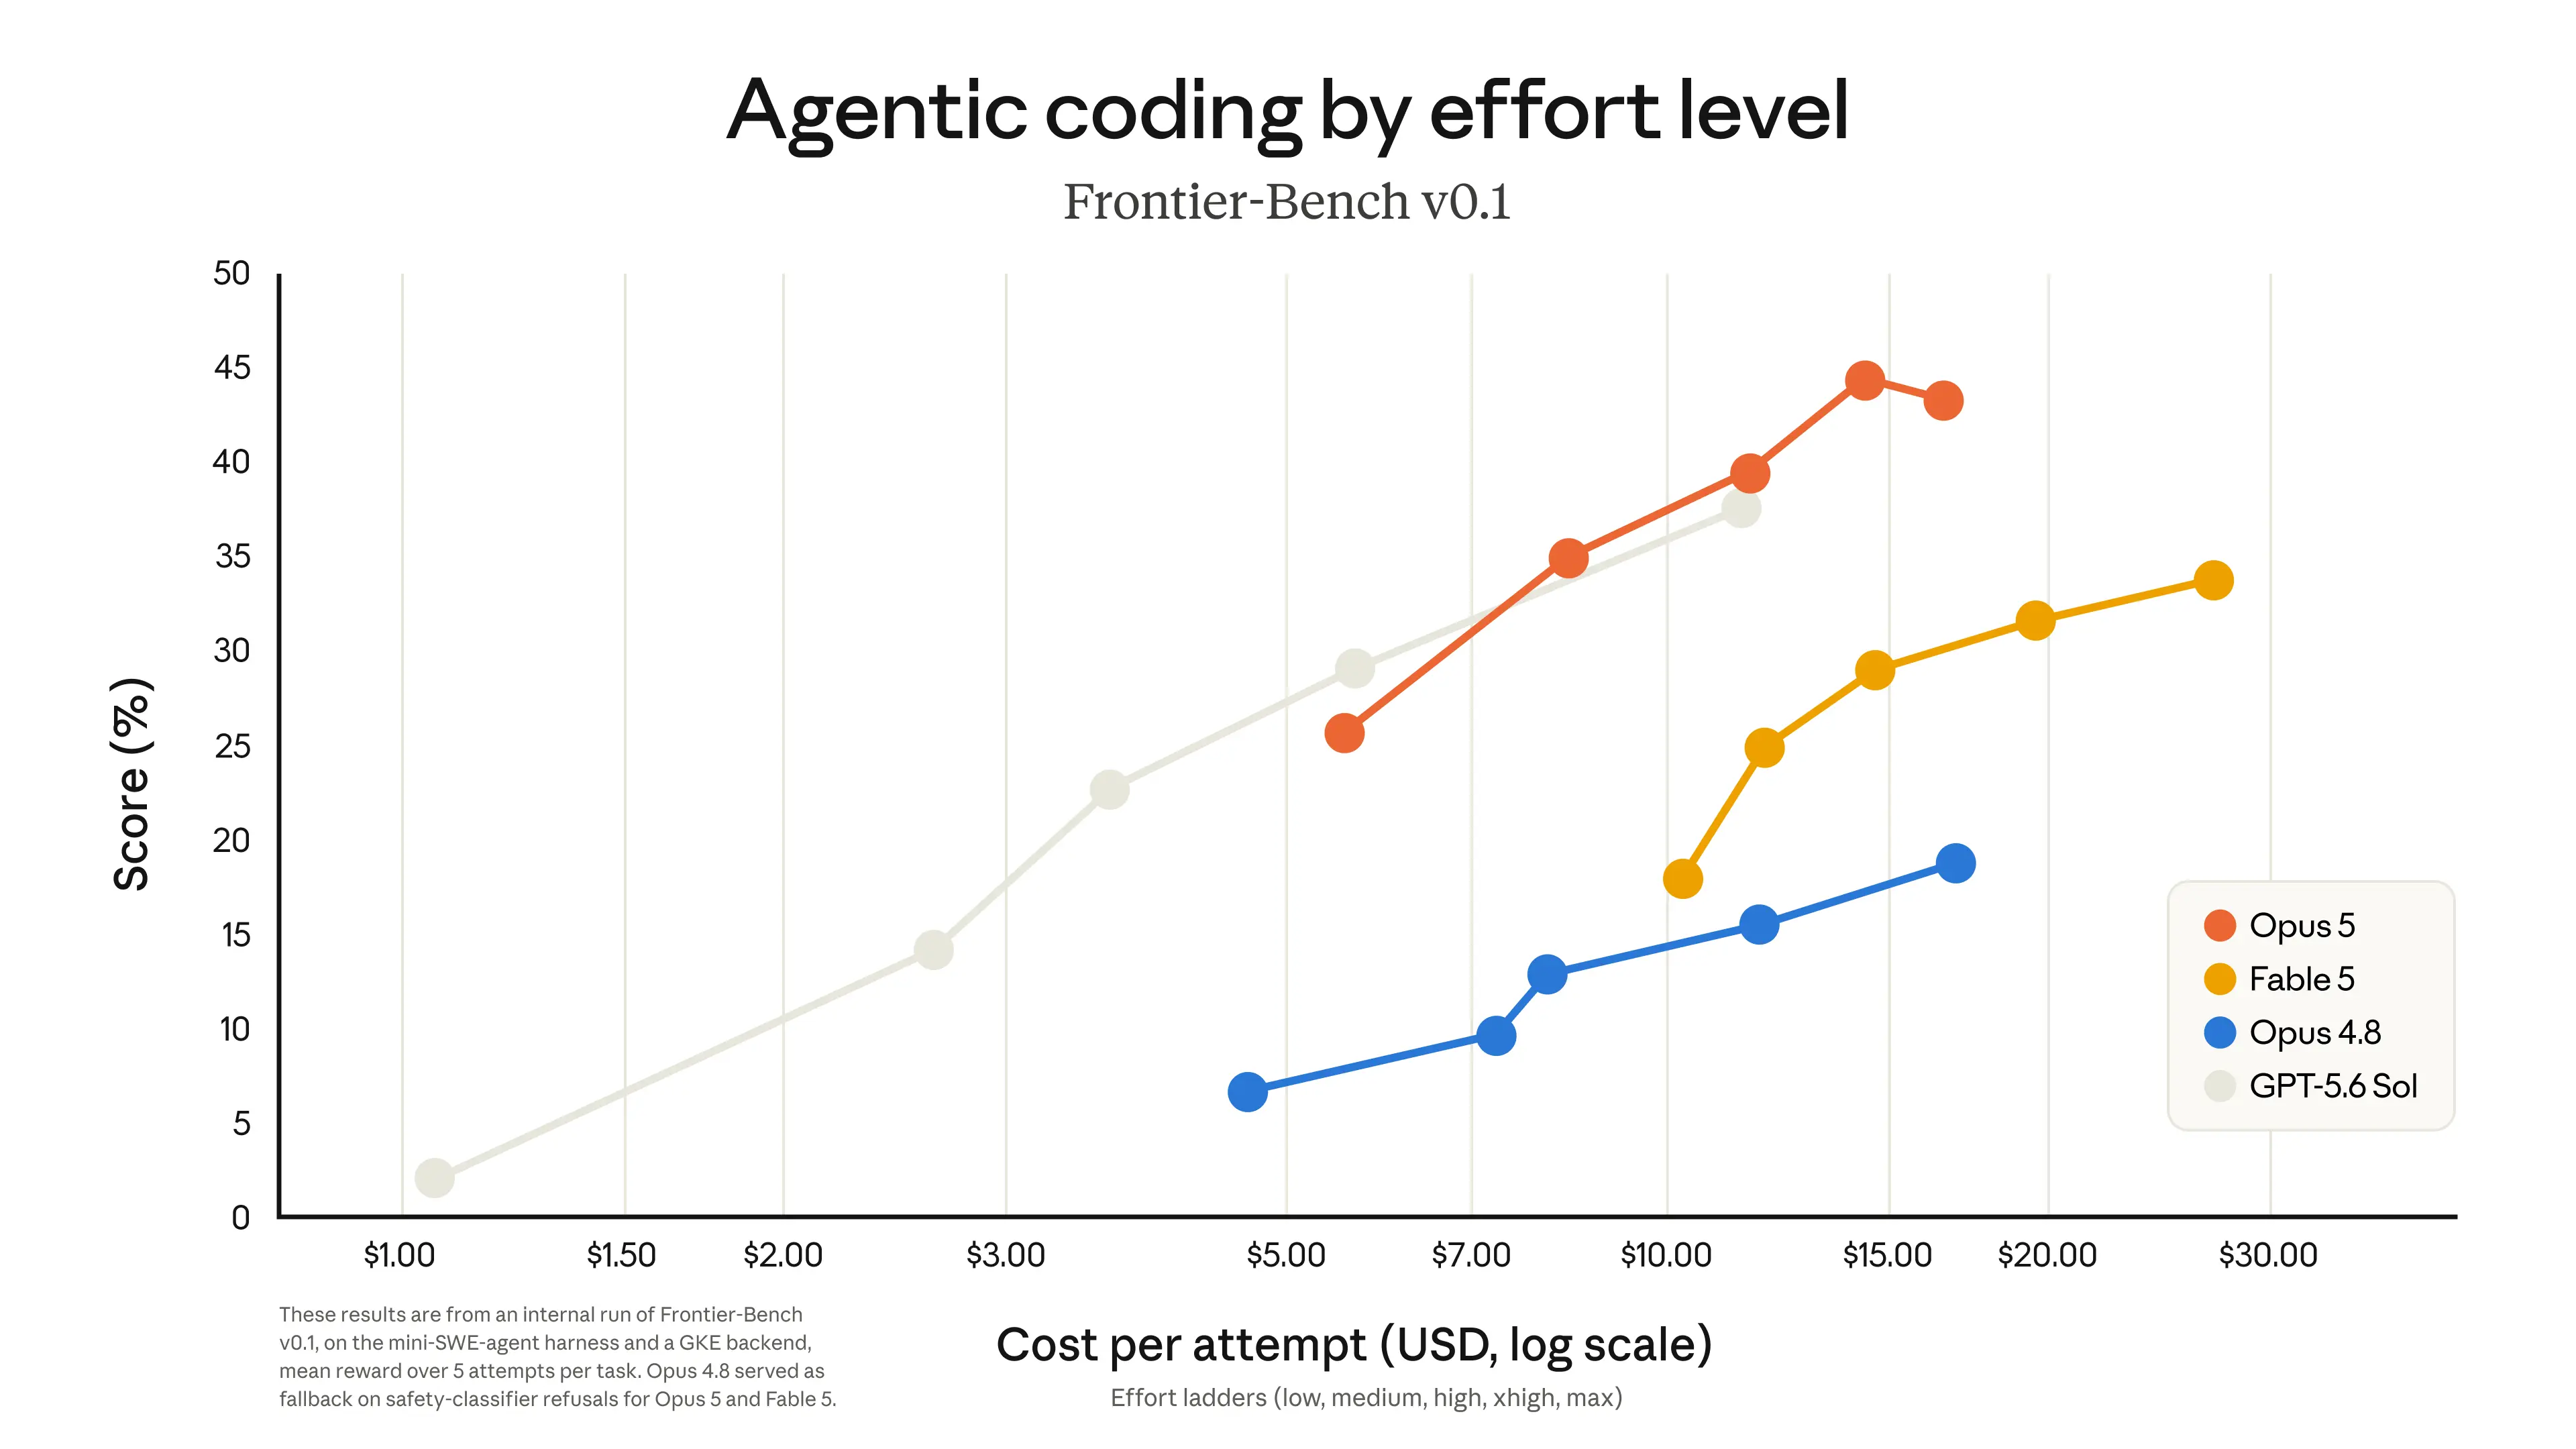
Questo confronto è stato compilato estraendo i risultati dei benchmark direttamente dagli annunci di rilascio pubblicati da Anthropic, OpenAI e Google. Ho scelto di includere le righe in cui abbastanza modelli avevano un punteggio pubblicato e confrontabile, in modo da renderle significative. Ho escluso i benchmark riportati solo come affermazioni relative vaghe.
| Categoria | Benchmark | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Sol Ultra | GPT-5.6 Terra | GPT-5.6 Luna | GPT-5.5 | Gemini 3.6 Flash | Gemini 3.5 Flash-Lite | Gemini 3.5 Flash | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Lavoro di conoscenza | GDPval-AA v2 (Elo) | 1861 | 1736 | — | 1593 | 1591,8 | 1493,7 | 1421 | — | 1348,8 | 962,3 |
| Codice | SWE-Bench Pro | 79,2% | 64,6% | — | 63,4% | 62,7% | 59,4% | — | 54,2% | — | 54,2% |
| Codice | DeepSWE v1.1 | 68,8% | 72,7% | — | 69,6% | 67,2% | 67% | 49% | — | 37% (baseline) | 11,8% |
| Codice | Terminal-Bench 2.1 | — | 88,8% | 91,9% | 87,4% | 84,7% | 85,6% | — | 54% (vs 3.1 Flash-Lite baseline 31%) | — | 70,7% |
| Codice | Frontier-Bench v0.1 (terminal coding) | 43,3% | 37,5% | — | — | — | — | — | — | — | — |
| Uso del computer | BrowseComp | 90,8% | 90,4% | 92,2% | 87,5% | 83,3% | 84,4% | — | — | — | 85,9% |
| Uso del computer | OSWorld 2.0* | 70,6% | 62,6% | — | 50,2% | 45,6% | 47,5% | — | — | — | — |
| Ragionamento astratto | ARC-AGI-3 | 30,2% | 7,78% | — | 0,8% | 0,18% | 0,43% | — | — | — | 0,42% |
| Uso di strumenti | AutomationBench | 26,0% | 18,1% | — | 15,2% | 14,9% | 12,9% | — | — | 14,5% |
— |
Devo precisare: ogni numero qui è autodichiarato dal laboratorio che ha rilasciato il modello, eseguito con il proprio harness di valutazione, setup di prompting e (in alcuni casi) configurazione di sforzo o livello di ragionamento.
Opus 5 è in testa sui compiti di ragionamento più difficili e innovativi (ARC-AGI-3, Frontier-Bench, AutomationBench), mentre GPT-5.6 Sol è leggermente avanti su benchmark di coding più consolidati come SWE-Bench Pro e DeepSWE. Questo potrebbe suggerire che Opus 5 abbia un vantaggio nella risoluzione di problemi aperti o meno standardizzati, mentre Sol appare forte su compiti di coding ben definiti e ampiamente addestrati.
Il recente rilascio di Gemini si concentra su modelli della fascia Flash, efficienti in termini di costo, piuttosto che su un modello di punta di frontiera, quindi molte righe non hanno dati Gemini o riportano solo valori Flash/Flash-Lite che restano molto indietro rispetto a Opus 5 e GPT-5.6. Questo confronto dice più del livello di modello che della capacità di frontiera di Google.
Dove i due modelli di punta si sovrappongono, Opus 5 guida su compiti di ragionamento innovativo e agentici (ARC-AGI-3, BrowseComp, OSWorld 2.0, AutomationBench), mentre GPT-5.6 Sol è leggermente avanti sul coding di lungo respiro (DeepSWE). Sol Ultra, Terra e Luna compaiono per lo più su benchmark di codice separati dove Opus 5 non ha uno score pubblicato, quindi è davvero "l'unico flagship di Anthropic vs l'intera famiglia di OpenAI" più che un confronto uno a uno pulito.
Opus 5 è disponibile da oggi sulle piattaforme di Claude allo stesso prezzo del suo predecessore:
La modalità Fast funziona a circa 2,5 volte la velocità predefinita, con un prezzo pari al doppio della tariffa base di Opus 5 sulla piattaforma Claude (o tramite crediti d'uso in Claude Code) — la stessa struttura di Opus 4.8.
Gli sviluppatori possono accedere al modello via API usando la stringa del modello claude-opus-5.
Due funzionalità correlate vengono lanciate in beta insieme a Opus 5:
Come per i precedenti rilasci di Opus, Opus 5 non prevede requisiti di conservazione dei dati per l'accesso generale.
Se ti sembra che ultimamente stiamo scrivendo molto sui modelli Claude, è perché è così. Anthropic è fortemente focalizzata su miglioramenti rapidi per ottimizzare capacità ed efficienza dei modelli.
Ora, Anthropic ha prodotto qualcosa di complessivamente migliore del suo precedente miglior modello, Fable 5. Arriva con un prezzo sensibilmente più basso e, al contempo, riporta i migliori numeri di allineamento di sempre.
Cosa ci aspetta? Be', il modello Haiku è il più vecchio tra quelli di Anthropic e stiamo ancora aspettando un upgrade alla serie 5. È una possibile ipotesi su cosa arriverà, ma Anthropic continua a sorprenderci.
Impara con DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



