
Corso
Software Development with Claude Code
4 ore
8.7K
Aggiornamento (1 luglio 2026): L'accesso a Claude Fable 5 è stato ripristinato ed è ora disponibile a livello globale su Claude Platform, Claude.ai, Claude Code e Claude Cowork dopo la revoca dell'ordine di controllo all'esportazione. Mythos 5 resta limitato a partner Project Glasswing selezionati.
Aggiornamento (2 settembre 2026): Anthropic ha pubblicato il successore del modello. Scopri tutto nella nostra guida a Claude Fable 5.1 e nel nostro tutorial sull'API di Claude Fable 5.1.
Abbiamo iniziato a sentire parlare di Claude Mythos ad aprile quando abbiamo scritto del rilascio di Claude Opus 4.7. Sapevamo allora che Opus 4.7, pur essendo estremamente impressionante di per sé, era solo il miglior modello disponibile pubblicamente perché i modelli classe Mythos venivano trattenuti da un rilascio ampio.
Ebbene, Anthropic ci ha ora dato Claude Fable 5, un modello classe Mythos sicuro per l'uso generale. È senza dubbio il nuovo leader nei test benchmark più importanti, inclusi ambiti come knowledge work, ingegneria del software e ricerca scientifica. È una grande vittoria per Anthropic, che solo otto giorni fa ha presentato domanda per un'IPO negli Stati Uniti.
In questo articolo analizzeremo da vicino Claude Fable 5, come si confronta con altri modelli sul mercato, come GPT-5.5 e Gemini 3.1 Pro, nonché con i modelli di Claude stessi, come Opus 4.8. Daremo anche qualche indicazione su quando usare il modello, visto che è più costoso. Se sei alle prime armi con Claude e vuoi imparare, ti consiglio di consultare la nostra guida su come imparare Claude.
Claude Fable 5 è il nome che Anthropic dà al suo modello più nuovo e capace. È un modello classe Mythos, ma include importanti salvaguardie in aree cruciali, in particolare la cybersecurity.
Per l'utente, questo significa che a certe domande risponderà il modello immediatamente successivo, Claude Opus 4.8. Anthropic stima che questo tipo di instradamento avvenga in meno del 5% di tutte le query, e ritiene che sia una stima prudente. Ed è un bene, dato che sono coinvolte preoccupazioni di sicurezza informatica. Inoltre, ovviamente, quella percentuale varia molto a seconda del tipo di lavoro che fai.
Siamo particolarmente entusiasti di Claude Fable 5. Il modello è ora così capace da aprire nuove aree di utilità: i difensori informatici lo useranno per mettere in sicurezza sistemi critici, e i ricercatori in scienze della vita potrebbero usarlo per migliorare nuove terapie. Gli astrofisici possono usare questi modelli per mappare galassie. E così via.
Se hai letto il comunicato, potresti aver sentito parlare anche di Claude Mythos 5. Se ti stai chiedendo: Claude Mythos 5 è lo stesso modello sottostante ma con alcune salvaguardie rimosse. Non è per uso generale: è distribuito come parte di Project Glasswing in partnership con il governo degli Stati Uniti, sostituendo di fatto Claude Mythos Preview. Non sappiamo molto di Claude Mythos 5, ma sappiamo che ha le capacità di cybersecurity più forti di qualsiasi modello al mondo. La partnership di Anthropic con il governo USA ne è di per sé una prova.
Fable 5 introduce diversi aggiornamenti notevoli in termini di sicurezza, trasparenza, memoria e gestione dei dati.
La più grande novità strutturale in Fable 5 è un sistema di classificazione a due stadi progettato per prevenire l'uso improprio delle capacità più pericolose del modello. Una sonda monitora le attivazioni interne del modello su tutto il traffico e qualsiasi richiesta contrassegnata viene inoltrata a un classificatore LLM addestrato separatamente che prende la decisione finale. Quando una richiesta viene bloccata, è reindirizzata a Opus 4.8 invece di essere rifiutata del tutto, così l'utente ottiene comunque una risposta utile.
È simile al punto sopra. Quando i classificatori di Fable 5 instradano una query a Opus 4.8, gli utenti vengono informati su quale modello ha gestito la loro richiesta. È un nuovo comportamento di trasparenza, così gli utenti non devono chiedersi se una risposta sembra diversa.
Fable 5 può scrivere appunti su un file a metà attività e tornarci in seguito, cosa diversa dall'avere semplicemente una finestra di contesto lunga. È una memoria di lavoro attiva. I test interni di Anthropic hanno mostrato un miglioramento delle prestazioni significativamente maggiore rispetto a Opus 4.8.
Anthropic introduce una nuova politica di conservazione dei dati che si applica a tutto il traffico di Fable 5. I dati sono conservati per 30 giorni per aiutare a rilevare nuovi jailbreak e ridurre i falsi positivi. Anthropic afferma che questi dati non saranno utilizzati per l'addestramento del modello e che l'accesso umano è tracciato.
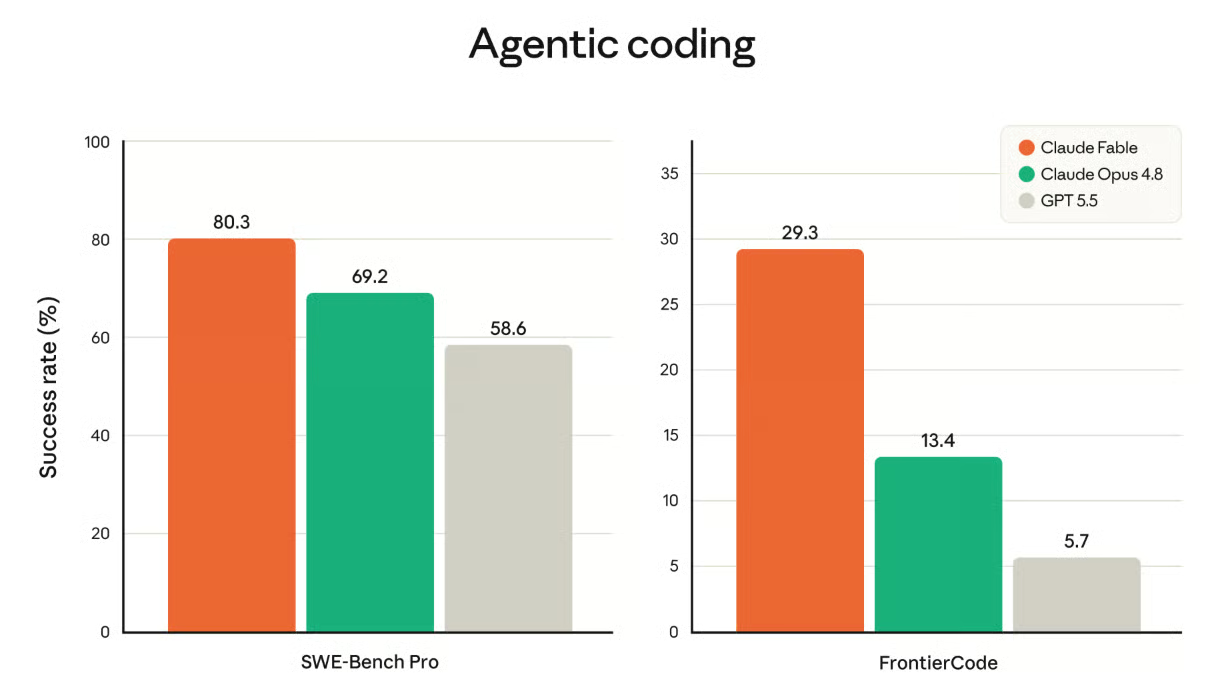
Claude Fable 5 vince nettamente in tutti i benchmark che seguiamo da vicino. Su SWE-Bench Pro ottiene l'80,3%, davanti al 69,2% di Opus 4.8. Su Humanity's Last Exam con strumenti, ottiene il 64,5%, rispetto al 57,9% di Opus 4.8 e al 52,2% di GPT-5.5.
| Categoria | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Agentic coding | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
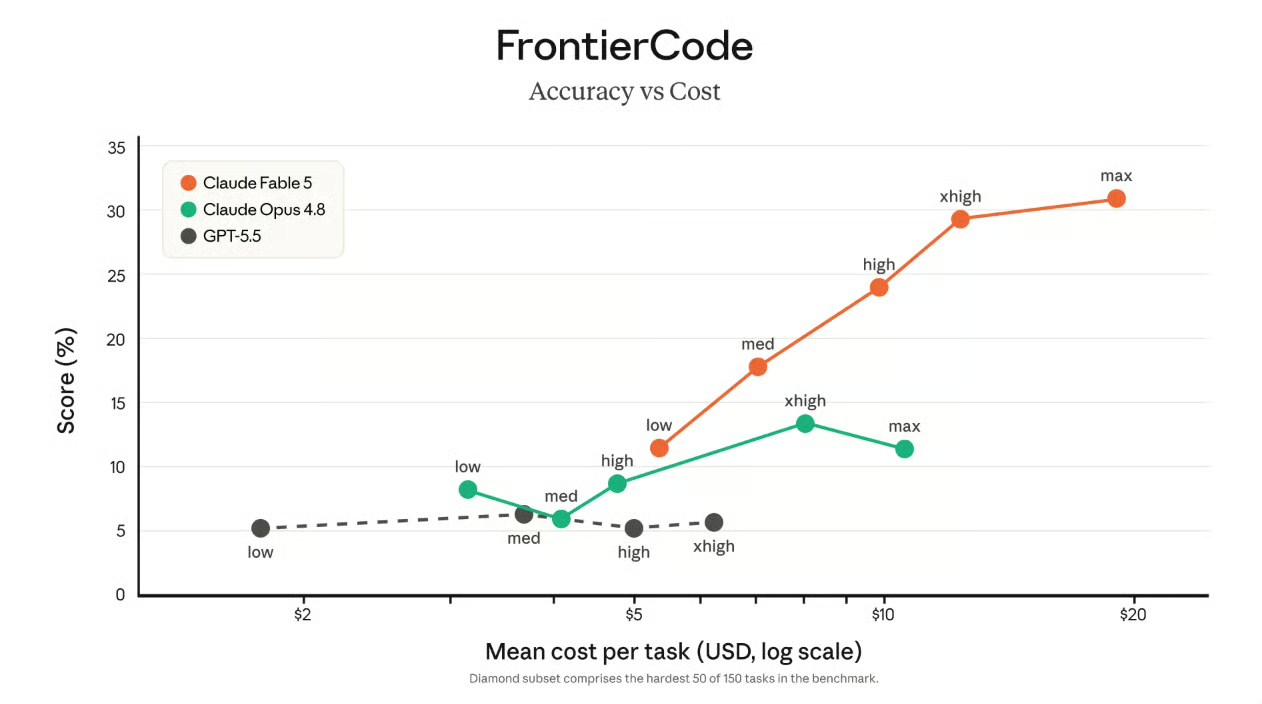
| Agentic coding | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| Knowledge work | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Vision per il knowledge work | GDP.pdf | 29.8% (no tools) | — | 22.5% (no tools) | 24.9% (no tools) | 16.7% (no tools) |
| Ragionamento spaziale | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| Uso di strumenti | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| Uso del computer | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| Legale | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| Ragionamento multidisciplinare | Humanity's Last Exam (no tools) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| Ragionamento multidisciplinare | Humanity's Last Exam (with tools) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| Biologia | BioMysteryBench (hard) | 46.1%* | 29.6% | 40.0% | — | — |
| Biologia | BioMysteryBench (human solved) | 83.9%* | 82.6% | 80.4% | — | — |
| Agentic coding | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| Cybersecurity | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| Salute | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
Ho menzionato il benchmark FrontierCode ma non ho avuto modo di approfondire. FrontierCode verifica se un modello non solo può superare un test di programmazione, di per sé difficile, ma anche se può soddisfare standard più ampi e generali per codebase di produzione di alta qualità, il che significa che il codice deve essere performante su larga scala, idiomatico, strutturato per la manutenibilità a lungo termine, ecc.
Claude Fable 5 ottiene un punteggio più alto nel test FrontierCode rispetto a qualsiasi altro modello senza nemmeno usare i parametri di sforzo high o xhigh.
Claude Fable 5 è il nuovo miglior modello per i compiti di visione. Nei test di Anthropic, Fable 5 è riuscito a ricostruire il codice sorgente di un'app web partendo solo da screenshot, senza scaffold. È la stessa capacità che emerge nel suo 93,2% su CharXiv Reasoning con strumenti.
Il modello Fable 5 va anche estremamente bene in un problema che probabilmente molti incontrano: può estrarre numeri precisi da figure scientifiche dettagliate senza commettere molti errori.
Abbiamo parlato molto, per tutto l'anno, della memoria e delle capacità di long-context dei modelli di AI. Con Fable 5, Anthropic ci porta alcune novità di cui parlare.
Per cominciare, Fable 4 rimane concentrato su milioni di token. Se non conosci il concetto, i modelli di AI, quando svolgono compiti lunghi, possono “dimenticare” o perdere traccia del contesto iniziale man mano che la conversazione si allunga. Ma Fable 5 è migliore nel mantenere un comportamento coerente e consistente anche quando il compito è molto lungo. Quanto è lungo “molto lungo”? Per dare un'idea, un milione di token corrisponde a un romanzo di 700 pagine.
Anthropic ci dice anche, in modo interessante, che Fable 5 migliora i suoi output usando i propri appunti. Quindi, il modello può scrivere cose a metà attività (su un file, per esempio) e tornarci sopra più tardi (alle cose che ha scritto). È simile a una persona che annota appunti mentre risolve un problema. Questo è diverso dall'avere una memoria lunga. Il modello usa l'archiviazione esterna come strumento di ragionamento.
La tabella sopra mostra già Fable 5 in testa in ogni categoria. Ma una domanda utile riguarda l'entità di ogni vantaggio: dove è un abisso, dove è un testa o croce, e perché.
GPT-5.5 è il concorrente più vicino e, sulla maggior parte dei compiti, i due sono quasi alla pari. Nel ragionamento spaziale di Blueprint-Bench 2 è 36,2 per GPT-5.5 e 38,6 per Fable 5. Restano vicini anche sui compiti agentici lunghi, purché il modello riceva feedback mentre lavora. Su Terminal-Bench 2.1, dove il terminale segnala subito gli errori, è 83,4 contro 88,0.
Una situazione rompe lo schema: un compito lungo valutato solo alla fine. Lì, il modello non può correggere i propri errori, che si accumulano, e il modello più forte prende il largo. SWE-Bench Pro è il caso più chiaro: 58,6 per GPT-5.5 contro 80,3 per Fable 5.
Per un confronto dettagliato, leggi il nostro post: Claude Fable 5 vs GPT-5.5: benchmark, prezzi e quale scegliere.
Gemini 3.1 Pro è dietro a Fable 5 su tutta la linea, e il divario si allarga nel lavoro che conta di più. Su GDPval-AA per il knowledge work ottiene 1314 contro i 1932 di Fable 5. Su Terminal-Bench 2.1 è 70,7 contro 88,0. Il divario è più piccolo su compiti più brevi e circoscritti — il ragionamento spaziale è 26,5 contro 38,6 — ma non si chiude mai. Il pattern indica un modello che gestisce abbastanza bene i problemi brevi ma perde il filo sui flussi di lavoro lunghi e ricchi di strumenti, dove Fable 5 è progettato per eccellere.
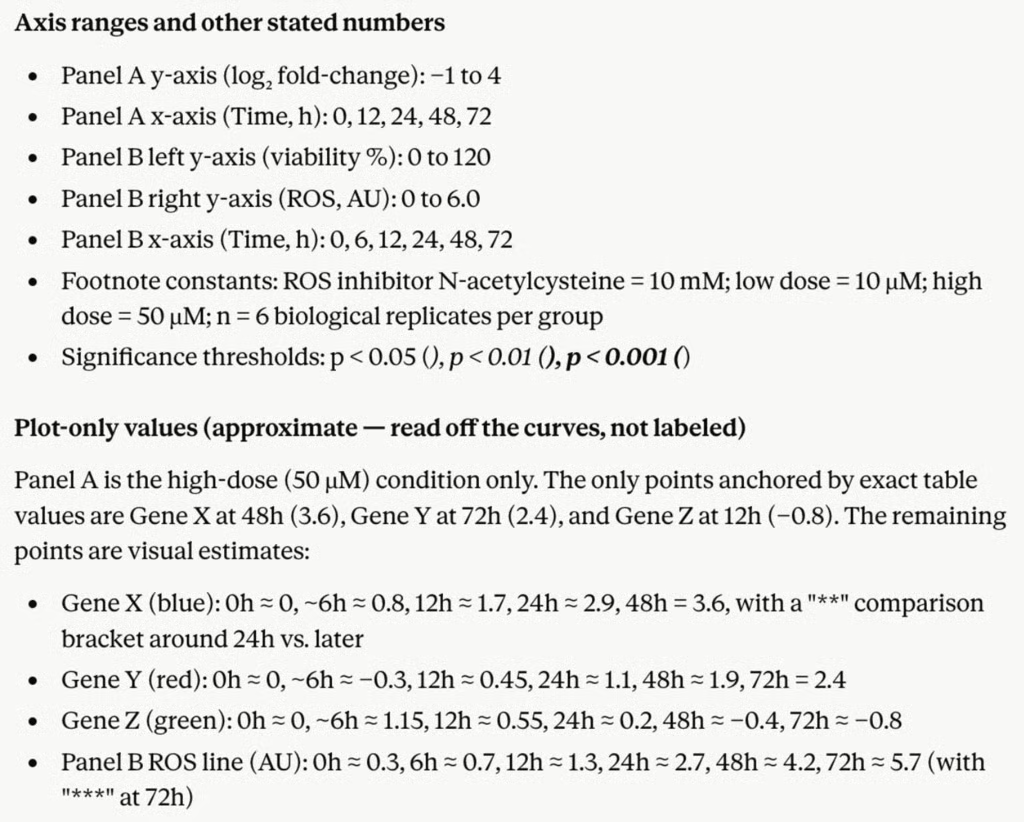
Una delle affermazioni specifiche nel comunicato di Anthropic è che Fable 5 può estrarre numeri precisi da figure scientifiche dettagliate senza commettere molti errori.
Per metterlo alla prova, abbiamo creato una figura scientifica a due pannelli modellata sul tipo di output che troveresti in un articolo di biologia cellulare: serie temporali di espressione genica sovrapposte su un asse log₂, un pannello a doppio asse che accoppia percentuali con altre misure in unità arbitrarie, ecc.
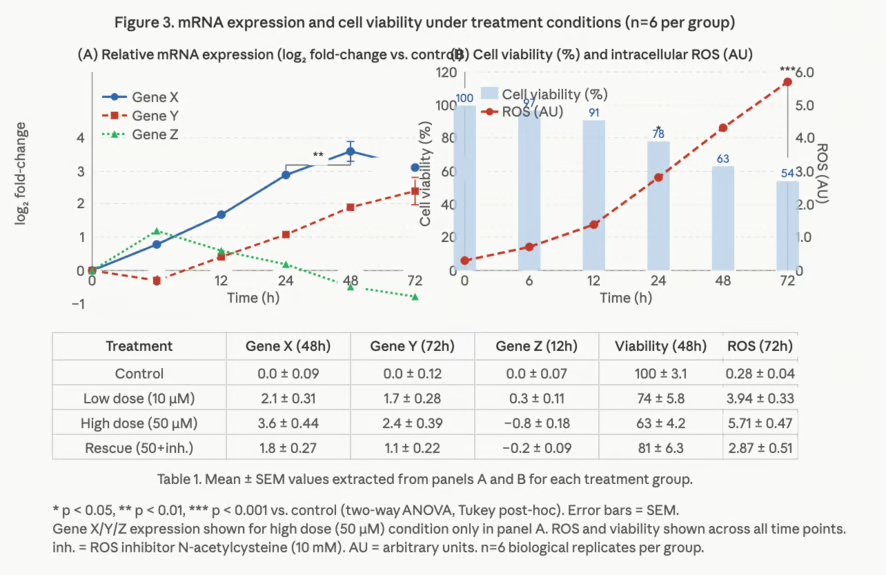
Pensavamo sarebbe stato ostico. I due assi y nel pannello B usano scale e unità diverse. Il Gene Z entra in territorio log₂ negativo in certi punti.
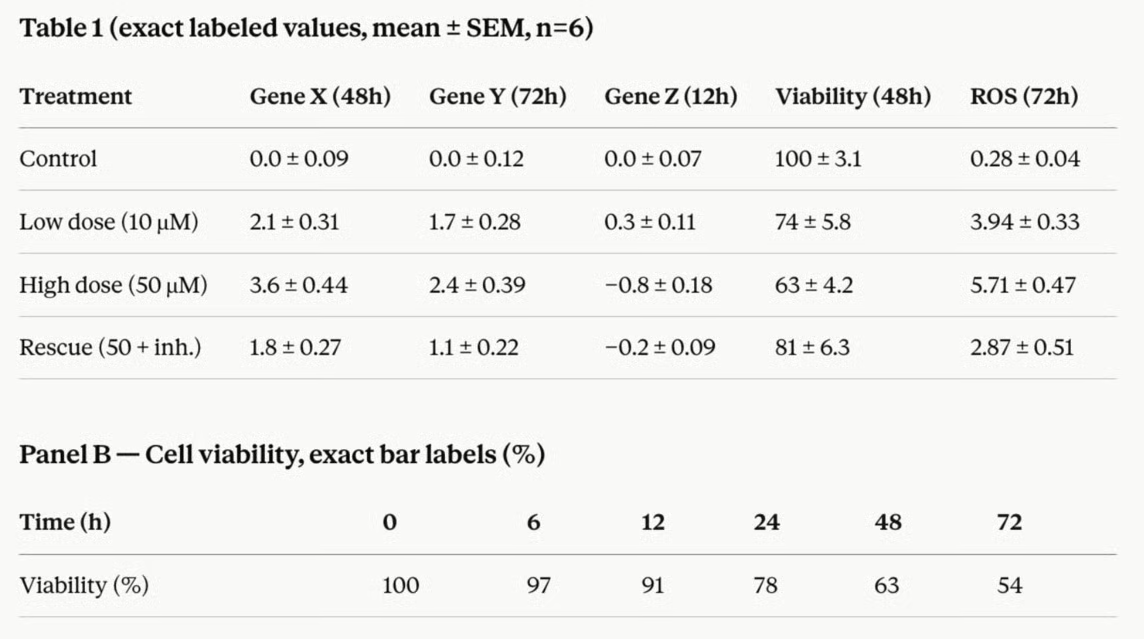
Abbiamo chiesto a Fable 5 di estrarre tutti i valori numerici da entrambi i pannelli e dalla tabella.
please extract all numeric valuesIl risultato è stato praticamente perfetto. La mia tabella usata per creare il grafico riportava Gene Z con un valore di -0,05 a 48 ore. Fable 5 mi ha detto che in quel punto era -0,04, non -0,05.
Nel comunicato, Anthropic ci mostra i feedback/testimonianze di accesso anticipato di clienti o partner, come GitHub e Figma. Dicono cose positive, ma era prevedibile. Ogni rilascio di un modello Anthropic ha questa sezione.
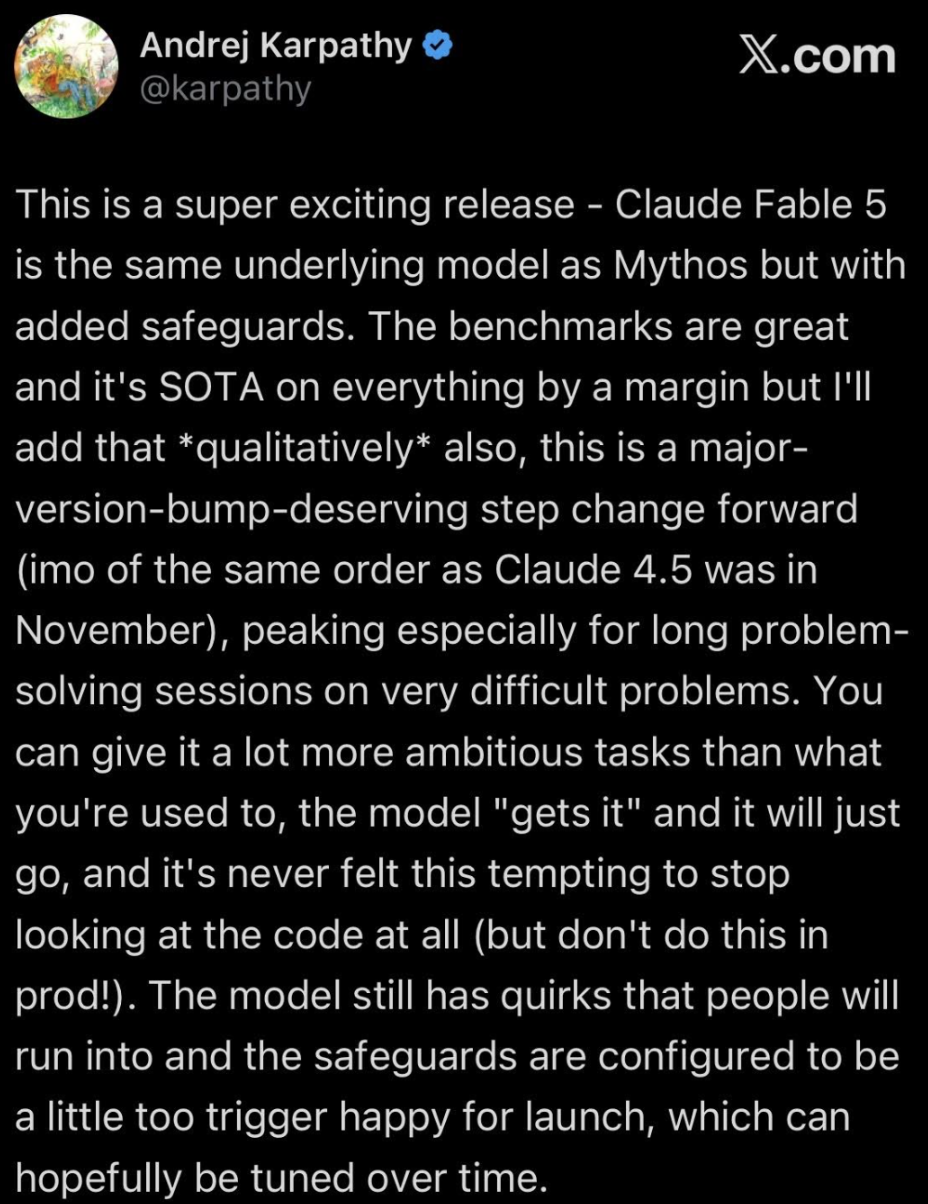
X ci dà un'opinione meno curata. Quel che salta subito all'occhio, Andrej Karpathy ha dato al modello una recensione praticamente entusiasta, riconoscendo che Fable 5 è allo stato dell'arte su tutti i benchmark rilevanti con un buon margine, e definendo anche il modello un cambiamento di passo come lo fu Opus 4.5 a novembre. Nel resto del post, dà molte altre idee su cosa puoi fare con Fable 5, come:
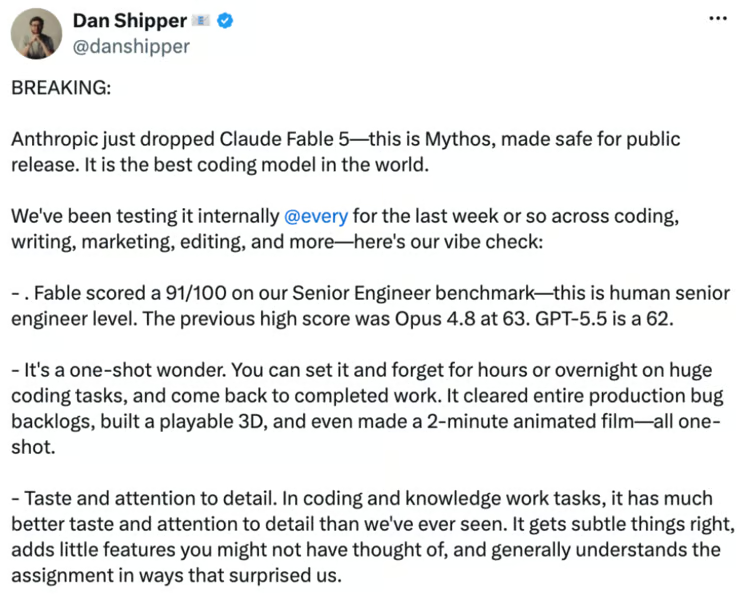
Dan Shipper, CEO di Every, dice cose simili, ovvero che Fable 5 ha stracciato i benchmark, per cominciare, e che è una “one-shot wonder” — puoi affidargli un grande progetto e tornare la mattina dopo con il lavoro completato. (Aveva accesso anticipato, ed è così che lo sa.)
C'è un po' di critica a bilanciare: dice che il modello è lento e avido di token, che è un altro modo per dire costoso. Dice che costa il doppio di Opus. Quindi riconosce, giustamente, che dovresti usarlo solo per ciò che lo richiede davvero.
Ho menzionato che Claude Fable 5 è Claude Mythos 5, ma con salvaguardie. Significa che Fable 5 è abbastanza potente che, senza restrizioni, potrebbe fornire un aiuto significativo ad attori malintenzionati in aree come cybersecurity e biologia. Questa è la convinzione.
Ecco come funzionano le salvaguardie a un livello alto. È un sistema di classificazione a due stadi:
Ora, ci sono tre aree principali coperte dai classificatori.
Guarda la storia prima/dopo delle salvaguardie in un'unica grafica. Le barre rosa sono Claude Mythos 5 senza salvaguardie — il modello grezzo sottostante. È estremamente capace su tutti e quattro i benchmark: 88,4% sullo sviluppo di exploit per Firefox, 83,8% sulla riproduzione di vulnerabilità su CyberGym e così via.
Le barre arancioni sono Claude Fable 5 con i classificatori attivi, e sono tutte allo 0,0% su ogni benchmark. Le salvaguardie azzerano le prestazioni, il che è positivo — zero è l'obiettivo.
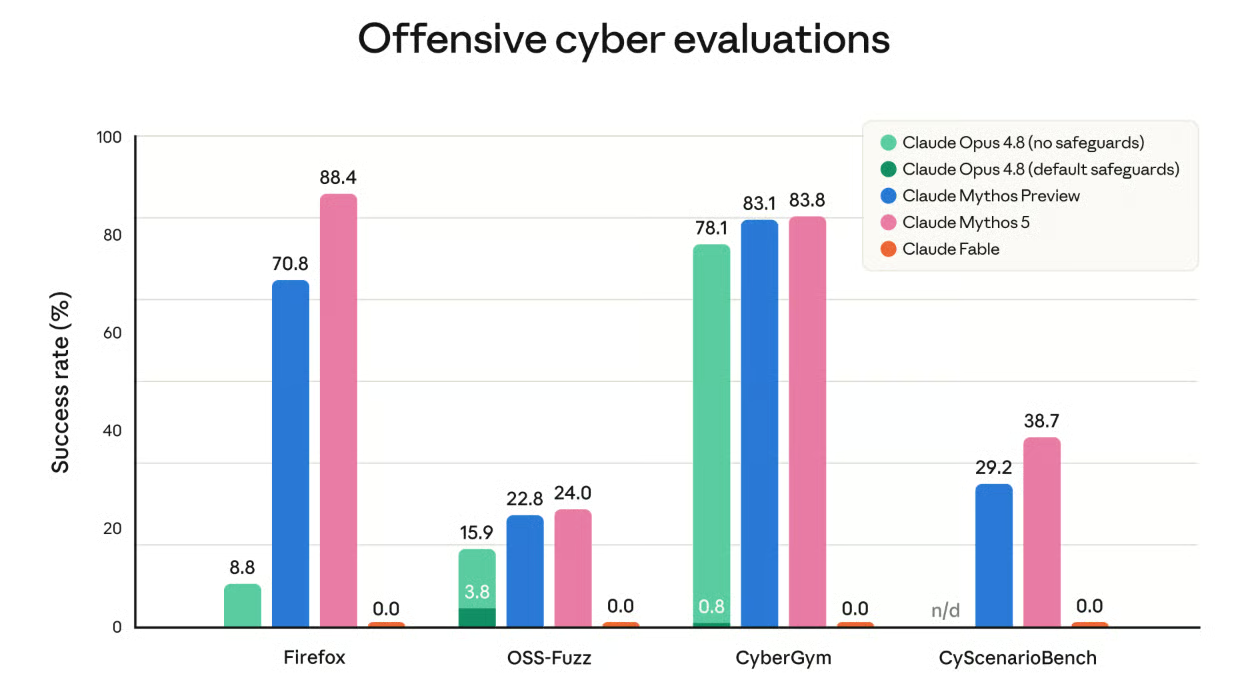
Mi piace questo grafico perché mette Opus 4.8 nel contesto. Anche senza salvaguardie, Opus 4.8 ottiene punteggi molto più bassi di Mythos 5. Questo ci mostra perché i classificatori erano necessari sin dall'inizio. Il salto di capacità tra Opus e Mythos è ciò che ha reso rischioso e ritardato il rilascio su vasta scala.
Se sei su un piano Pro, Max, Team o Enterprise, Fable 5 è disponibile da subito senza costi aggiuntivi — ma solo fino al 22 giugno.
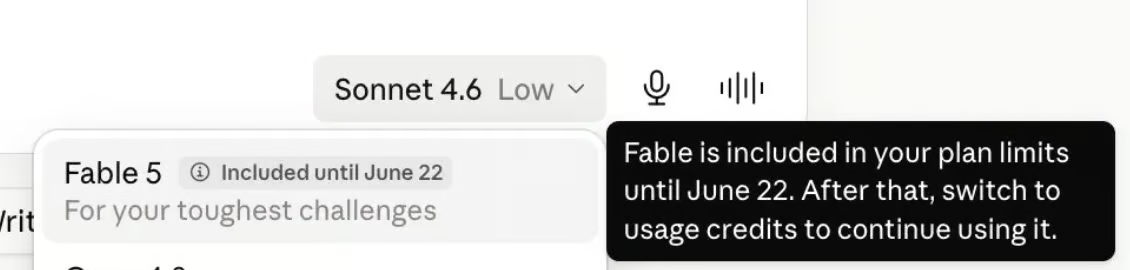
Dopo il 22 giugno, l'accesso richiederà i usage credits, il sistema pay-as-you-go di Anthropic che si aggiunge al tuo abbonamento esistente. Probabilmente è anche per questo che Dan Shipper ci ha avvertiti sui costi.
Per gli sviluppatori sull'API, è più semplice:
Se confronti con i prezzi standard di Opus 4.8 (5 $ input / 25 $ output), Fable 5 è davvero due volte più costoso, come dice Dan. Ma se stai già usando Opus 4.8 in modalità fast, Fable 5 costa lo stesso pur essendo un modello più capace.
Nota importante, nel caso te lo stessi chiedendo come me: quando una query fa fallback a Opus 4.8, come avviene con il sistema di classificazione di sicurezza, ti viene addebitata la tariffa di Opus 4.8 e non quella di Fable 5.
Claude Mythos 5, la versione Mythos del modello senza salvaguardie, non è disponibile al pubblico. L'accesso è limitato ai partner di Project Glasswing.
Anthopic ci ha stuzzicati con Project Glasswing e il modello dal nome intrigante Mythos. Ma per mesi questo modello migliore al mondo — e lo è davvero — è rimasto bloccato dietro una partnership governativa.
Questo è cambiato, una settimana dopo che Anthropic ha presentato domanda per un'IPO negli Stati Uniti. Ora, il modello classe Mythos è disponibile con un piano Pro. (L'accesso è anche basato su usage credits. Vedi l'ultima sezione per tutti i dettagli.)
La situazione: Anthropic ha modelli abbastanza capaci da poter causare danni seri senza restrizioni. Sappiamo che non è marketing, perché l'azienda ha costruito un intero sistema di classificazione parallelo per aggiungere salvaguardie.
Dove stiamo andando: il tetto delle capacità continua ad alzarsi, i benchmark vengono continuamente sostituiti con versioni più difficili e la timeline dei rilasci dei modelli continua ad accorciarsi. Inoltre, l'infrastruttura delle salvaguardie diventa sempre più complessa per compensare. Con l'IPO forse in arrivo già quest'anno, si parlerà molto di come la pressione competitiva contrasti con i temi della sicurezza.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



