
Corso
Introduzione all'AI per il lavoro
2 ore
127.2K
OpenAI ha lanciato GPT-6 Astra, che definisce il modello più intelligente e allineato al mondo.
Astra arriva nel segmento frontier più affollato, dove Claude Fable 5.1 di Anthropic (rilasciato il 1° settembre 2026) e Claude Opus 5 sono i riferimenti per coding e lavoro agentico.
Le dichiarazioni principali sono aggressive.
Astra satura FrontierMath Tier 4 con un punteggio del 97,6%, satura ARC-AGI-3 con un 99,9% sotto l'harness provider adapter di OpenAI e raggiunge il 100% su ExploitBench. Segna inoltre un nuovo primato nell'uso del computer e del browser, con il 72,6% su OSWorld 2.0 in circa il 47% di tempo in meno per task rispetto al suo predecessore GPT-5.6 Sol.
Sia ARC-AGI-3 che FrontierMath Tier 4 sono stati progettati appositamente per restare avanti rispetto alle capacità dell'IA, quindi saturarli segnala qualcosa di qualitativamente diverso dal battere una classifica standard.
In questo articolo, vedrò tutte le novità di GPT-6 Astra, passando in rassegna le nuove funzionalità, esplorando i benchmark e mostrando alcuni casi d'uso.
Se vuoi vedere il modello in azione, segui il nostro tutorial sull'API di GPT-6 Astra e dai un'occhiata ad alcuni progetti GPT-6 Astra che puoi provare. Per capire come si confronta con la concorrenza, consulta il nostro confronto tra GPT-6 Astra e Claude Fable 5.1. Ti consiglio anche la nostra guida su come imparare Claude, la nostra copertura del nuovo modello Jev System One e il confronto tra Jev e GPT-6 Astra.
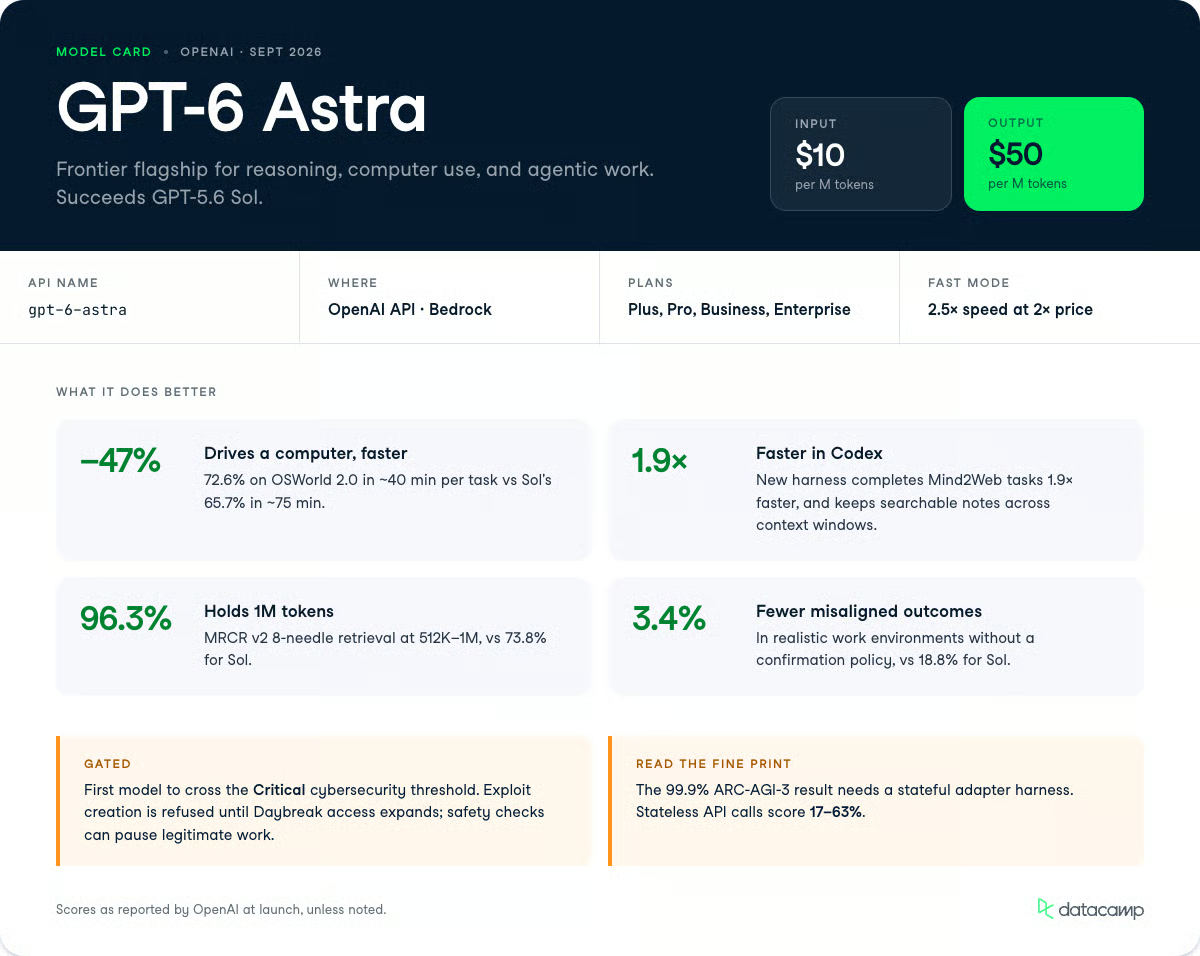
GPT-6 Astra è il nuovo modello di punta frontier di OpenAI, successore di GPT-5.6 Sol come miglior modello per ragionamento, uso del computer e lavoro agentico.
OpenAI lo posiziona su tre aree:
Il benchmark più utile per i praticanti è OSWorld 2.0, dove Astra ottiene il 72,6% in circa 40 minuti per task, rispetto al 65,7% di GPT-5.6 Sol in circa 75 minuti.
Quella combinazione di maggiore accuratezza e minor tempo a orologio è la differenza tra un agente da sorvegliare e uno a cui puoi affidare un compito.
Astra arriva insieme a un harness Codex aggiornato che, secondo OpenAI, offre una velocità di completamento dei task 1,9x superiore rispetto all'attuale esperienza GPT-5.6 Sol sul benchmark Mind2Web.
È disponibile come gpt-6-astra nell'API di OpenAI e tramite Amazon Bedrock, con un livello GPT-6 Astra Pro per i piani Pro, Business ed Enterprise.
Se ti interessano anche i nuovi modelli di fascia inferiore di OpenAI, dai un'occhiata alla nostra guida a GPT-6 Sol e Luna.
Le novità di Astra si concentrano sull'esecuzione agentica: usare un computer, produrre artefatti professionali finiti, mantenere il contesto in lunghe sessioni di coding e restare entro i limiti autorizzati.
Ecco le capacità che spiccano.
Astra può operare direttamente un computer, gestendo quel lavoro noioso a più passaggi che di solito ti occupa un pomeriggio.
Alcuni buoni esempi includono:
Su simulazioni di latenza su OSWorld 2.0, Astra raggiunge il 72,6% in circa 40 minuti per task contro il 65,7% di GPT-5.6 Sol in circa 75 minuti, un taglio del 47% del tempo per task.
OSWorld 2.0 misura se un modello può effettivamente usare un computer, ad esempio navigando interfacce reali, cliccando, digitando e completando task multi-step come farebbe un umano.
Il taglio del 47% del tempo per task conta quanto il guadagno in accuratezza perché il costo dell'agente scala con il tempo a orologio; un modello che finisce in 40 minuti invece che in 75 non è solo più veloce, costa anche circa la metà per eseguire lo stesso carico di lavoro.
Detto questo, test indipendenti dell'ARC Prize mostrano che i numeri di punta di Astra su uso del computer e ragionamento dipendono fortemente dall'harness.
Su ARC-AGI-3, l'harness stateless standard ha prodotto punteggi dal 17% circa al 63% a seconda del livello di ragionamento, mentre l'harness provider adapter che preserva lo stato di ragionamento ha raggiunto il ~99,9% pubblicizzato.
Se chiami il modello in modalità stateless, aspettati numeri più bassi rispetto ai grafici di lancio.
Astra è addestrato per generare artefatti professionali rifiniti che seguono i tuoi template invece di bozze generiche.
Crea documenti, presentazioni, fogli di calcolo e analisi che corrispondono al tuo stile di scrittura e visivo, e inserisce nell'output solo il contesto che serve invece di gonfiarlo con tutto ciò che sa.
La demo di OpenAI mostra Astra che costruisce un deck di slide su un modello fittizio partendo da una manciata di slide modello, mantenendo tono e layout coerenti.
Per chiunque abbia passato un'ora a riformattare il dump markdown di un LLM in un template aziendale, la fedeltà al template è la prima cosa che vorrei testare.
Con Sites in ChatGPT, Astra può creare, ospitare e condividere siti web, web app e giochi direttamente da un prompt, applicando un giudizio visivo più solido ai rendering rispetto ai modelli precedenti.
Astra decide quando farti una domanda e quando procedere con assunzioni ragionevoli.
Quando le istruzioni lasciano margine di interpretazione, colma da solo le lacune di routine e fa domande mirate solo quando la risposta potrebbe cambiare l'esito.
Nella comparativa di OpenAI, GPT-5.6 Sol ha costruito autonomamente un sito personale per la carriera in 13 minuti e 15 secondi, mentre Astra si è fermato dopo 20 secondi per chiedere verso quale carriera stava passando l'utente.
In Codex, Astra può porre domande in modo asincrono, continuando il lavoro che non dipende dalla tua risposta e aspettando solo per decisioni consequenziali.
Astra resta anche orientato quando un task cambia.
I modelli precedenti a volte trattavano un messaggio di correzione a metà task come un nuovo obiettivo e perdevano i vincoli originali; Astra incorpora nuovi requisiti e risponde a domande collaterali senza abbandonare il lavoro più ampio.
GPT-6 Astra introduce un nuovo modo per Codex di preservare e recuperare contesto quando la finestra di contesto si riempie, sostituendo i riassunti ripetuti con note ricercabili.
Storicamente, i modelli usano la compattazione per comprimere lunghe sessioni di debug o grandi refactoring in un unico sommario, che può far perdere dettagli sul perché una correzione è fallita o come si comporta un componente.
Con Astra, Codex mantiene note tra le finestre e lascia ricercabili le finestre precedenti, così può trovare un requisito o un risultato di test da un messaggio precedente anche se la nota non lo aveva catturato.
Attivi questa funzionalità sperimentale nel tuo config.toml di Codex, e OpenAI afferma che diventerà l'impostazione predefinita per Astra nelle prossime settimane.
Astra raggiunge la soglia Critical in cybersecurity secondo il Preparedness Framework di OpenAI, che è al tempo stesso la sua capacità più forte e la più vincolata.
Al lancio, aiuterà con revisione del codice sicura e patching, ma rifiuta task più avanzati come la creazione di exploit proof-of-concept.
OpenAI prevede di ampliare l'accesso tramite il suo programma Daybreak con tutele meno restrittive, abilitando validazione di vulnerabilità e proof-of-concept, analisi di malware e detection engineering.
A causa del rischio elevato, controlli di sicurezza extra possono mettere in pausa o fermare lavoro legittimo: in ChatGPT o Codex potresti dover rivedere un'azione, e nell'API il task verrà interrotto del tutto.
Astra stabilisce nuovi massimi su uso del computer, matematica, coding e cybersecurity nelle valutazioni riportate da OpenAI, spesso usando meno token in output rispetto a GPT-5.6 Sol o ai modelli Claude.
I punteggi seguenti provengono dalle tabelle di lancio di OpenAI, quindi considerali come dati del fornitore e tieni presenti le avvertenze sull'harness dove applicabili.
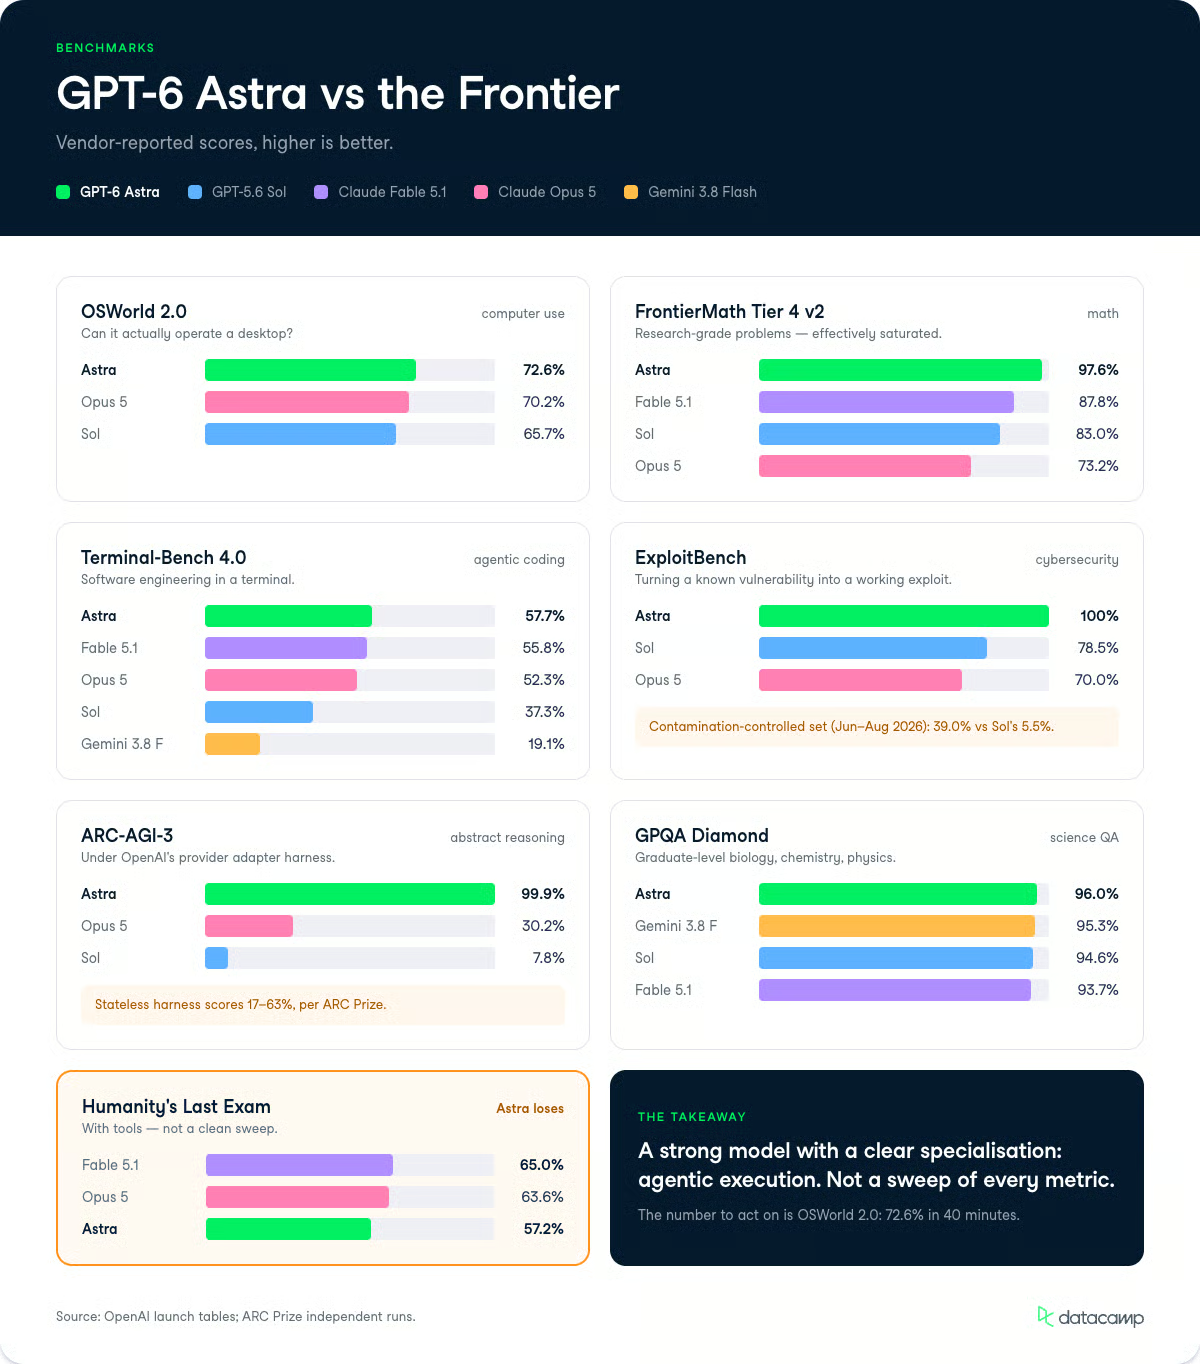
Astra ottiene il 72,6% sul set offline di OSWorld 2.0, contro il 65,7% di GPT-5.6 Sol e il 70,2% di Claude Opus 5.
OSWorld misura se un agente può completare task desktop reali come navigare tra app e manipolare file, quindi è il proxy più vicino a "può davvero usare un computer al posto mio".
Su ScreenSpot-Pro, che testa il grounding degli elementi UI su uno schermo senza strumenti, Astra raggiunge il 92,7% contro il 76,9% di GPT-5.6 Sol e l'87,3% di Claude Fable 5.
Su Agents' Last Exam, arriva al 59,3%, davanti al 55,5% di Claude Opus 5 e al 53,6% di GPT-5.6 Sol, usando circa il 65% di token in output in meno rispetto a Opus 5.
Astra ottiene il 97,6% su FrontierMath Tier 4 v2, il livello più difficile di un benchmark matematico di ricerca, contro l'87,8% sia di Claude Fable 5.1 che di Fable 5, e il 73,2% di Claude Opus 5.
OpenAI lo descrive come saturazione, e dato il soffitto, è una lettura corretta.
Su GPQA Diamond, un set di domande a livello graduate in biologia, chimica e fisica, Astra arriva al 96,0% contro il 95,3% di Gemini 3.8 Flash e il 94,6% di GPT-5.6 Sol.
Non primeggia però in tutte le metriche. Su Humanity's Last Exam con strumenti, Astra segna il 57,2%, dietro al 65,0% di Claude Fable 5.1 e al 63,6% di Opus 5, quindi non domina ogni valutazione di ragionamento.
Su Terminal-Bench 4.0, che testa agenti su ingegneria del software, configurazione di sistema e analisi dei dati in un terminale, Astra segna il 57,7% contro il 37,3% di GPT-5.6 Sol, il 55,8% di Claude Fable 5.1 e il 19,1% di Gemini 3.8 Flash.
È un ampio vantaggio su Gemini Flash e uno moderato su Fable 5.1.
Il quadro del coding è più ravvicinato altrove.
Su FrontierCode 1.1 Main, Astra ottiene il 53,3% contro il 53,5% di Fable 5 e il 53,4% di Opus 5, di fatto un pari, e su DeepSWE v1.1 arriva al 74,1% contro il 73,8% di Gemini 3.8 Flash e il 69,9% di Fable 5.
Quando abbiamo recensito GPT-5.6 Terra nel nostro confronto Terra vs Claude Sonnet 5, Terra ha ottenuto l'87,4% su Terminal-Bench 2.1, una versione diversa, quindi i confronti tra versioni qui non sono omogenei.
Astra segna il 100% su ExploitBench contro il 78,5% di GPT-5.6 Sol e il 70% di Claude Opus 5, e il 42,4% su ExploitGym contro il 30,3% di Sol.
ExploitBench misura se un modello può trasformare una vulnerabilità nota in un exploit funzionante, quindi un punteggio perfetto è esattamente il motivo per cui OpenAI limita questa capacità al lancio.
Sul ExploitBench controllato per contaminazione (giugno-agosto 2026), costruito da vulnerabilità dei tre mesi precedenti, Astra ottiene il 39,0% contro il 5,5% di Sol.
Su SRE-Bench, che misura il reverse engineering di binari senza sorgente, Astra risolve l'88,0% al primo tentativo contro il 55,9% di Sol.
Il laboratorio indipendente Irregular ha riportato che Astra ha risolto 86 delle 226 sfide FrontierCyber contro le 34 di Sol, inclusi zero-day nei browser e in un database cloud.
Astra segna il 99,9% su ARC-AGI-3 con l'harness provider adapter di OpenAI, contro il 7,8% di GPT-5.6 Sol e il 30,2% di Claude Opus 5.
Questo è il numero da leggere con cautela: le esecuzioni indipendenti dell'ARC Prize mostrano che l'harness stateless standard segna dal 17% circa al 63% a seconda del livello di ragionamento, con la cifra ~99,9% che richiede l'harness adapter stateful e una run completa dal costo di decine di migliaia di dollari.
Sul contesto lungo, Astra raggiunge il 100% su OpenAI MRCR v2 8-needle nella banda 256K-512K e il 96,3% nella banda 512K-1M, contro il 91,5% e il 73,8% di GPT-5.6 Sol.
Quella affidabilità di retrieval a 1M token è un vero passo avanti rispetto a Sol per pipeline ricche di documenti.
Astra registra il 2,4% sul benchmark interno di sicurezza per l'uso del computer di OpenAI (più basso è meglio) contro il 22,0% di GPT-5.6 Sol, il 9,5% di Fable 5.1 e l'11,5% di Opus 5.
In ambienti di lavoro realistici, il suo tasso complessivo di esiti non allineati senza una policy di conferma è del 3,4%, contro il 18,8% di Sol e il 13,5% di GPT-5.6 Terra.
L'unica regressione segnalata da OpenAI è la monitorabilità della chain-of-thought.
Astra produce ragionamenti più brevi e meno verbosi e controlla la sua CoT molto meglio di Sol; su CoT-Control tra 750 e 1.250 token ha seguito i vincoli nel 60,9% dei casi contro il 16,1% di Sol.
UK AISI ha rilevato che Astra poteva eludere il monitoraggio sotto prompting avversariale, e OpenAI prende il calo abbastanza seriamente da indicarlo come priorità di ricerca.
Ecco come i punteggi riportati di Astra si allineano ai rivali a cui è indirizzato su alcuni benchmark chiave.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72,6% | 65,7% | - | 70,2% | - |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | 73,2% | - |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 93,7% | 95,3% |
| Terminal-Bench 4.0 | 57,7% | 37,3% | 55,8% | 52,3% | 19,1% |
| ExploitBench | 100,0% | 78,5% | - | 70,0% | - |
| ARC-AGI-3 (adapter harness) | 99,9% | 7,8% | - | 30,2% | - |
GPT-6 Astra è in rollout iniziale a un set limitato di organizzazioni, poi a tutti gli utenti ChatGPT Plus, Pro, Business ed Enterprise nei prossimi giorni, oltre che all'API di OpenAI e ad AWS.
Gli admin Enterprise possono abilitarlo per workspace, ed è disattivato di default al lancio. I piani Pro, Business ed Enterprise includono anche GPT-6 Astra Pro.
Per gli sviluppatori, il modello è disponibile come gpt-6-astra nell'API di OpenAI e in Amazon Bedrock.
I prezzi standard dell'API sono:
Per contesto, è ben sopra le tariffe $2/$12 di GPT-5.6 Terra dalla nostra precedente copertura, e sopra le $5/$25 di Claude Opus 5.
Astra è prezzato come modello frontier per ragionamento e automazione, non come cavallo di battaglia per testi in massa.
Supporta Zero Data Retention per i clienti API idonei, e l'uso è incluso nelle quote degli abbonamenti esistenti con possibilità di acquistare crediti aggiuntivi.
I miei feed sui social sono pieni di esempi d'uso di GPT-6 Astra. Anche se non l'ho ancora provato in prima persona, ci sono esempi interessanti che vale la pena evidenziare qui:
Ho visto molti post in cui le persone hanno usato GPT-6 Astra in Blender per creare modelli 3D altamente dettagliati e realistici.
Nel clip qui sotto, l'utente X Tom Krcha ha dato a GPT-6 "un'immagine di una casa e ha chiesto di ricrearla in 3D con tutti i dettagli, inclusi giocattoli, elettrodomestici e mobili. Questa è una ricostruzione 3D completa in Blender con geometria che puoi modificare manualmente ed eseguire a 60 fps come un "gioco" renderizzato in locale sul dispositivo."
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



