

Programma
Nozioni di base sull'intelligenza artificiale
10 ore
Pratica and corso your progress.
Continua Con GoogleMythos 5 rappresenta un salto in avanti rispetto a Mythos Preview in tutte le principali aree di capacità testate da Anthropic. I guadagni sono più visibili nel lavoro autonomo a lungo orizzonte, soprattutto nei domini scientifici del ragionamento scientifico e dei compiti di visione. Ecco cosa significa in pratica.
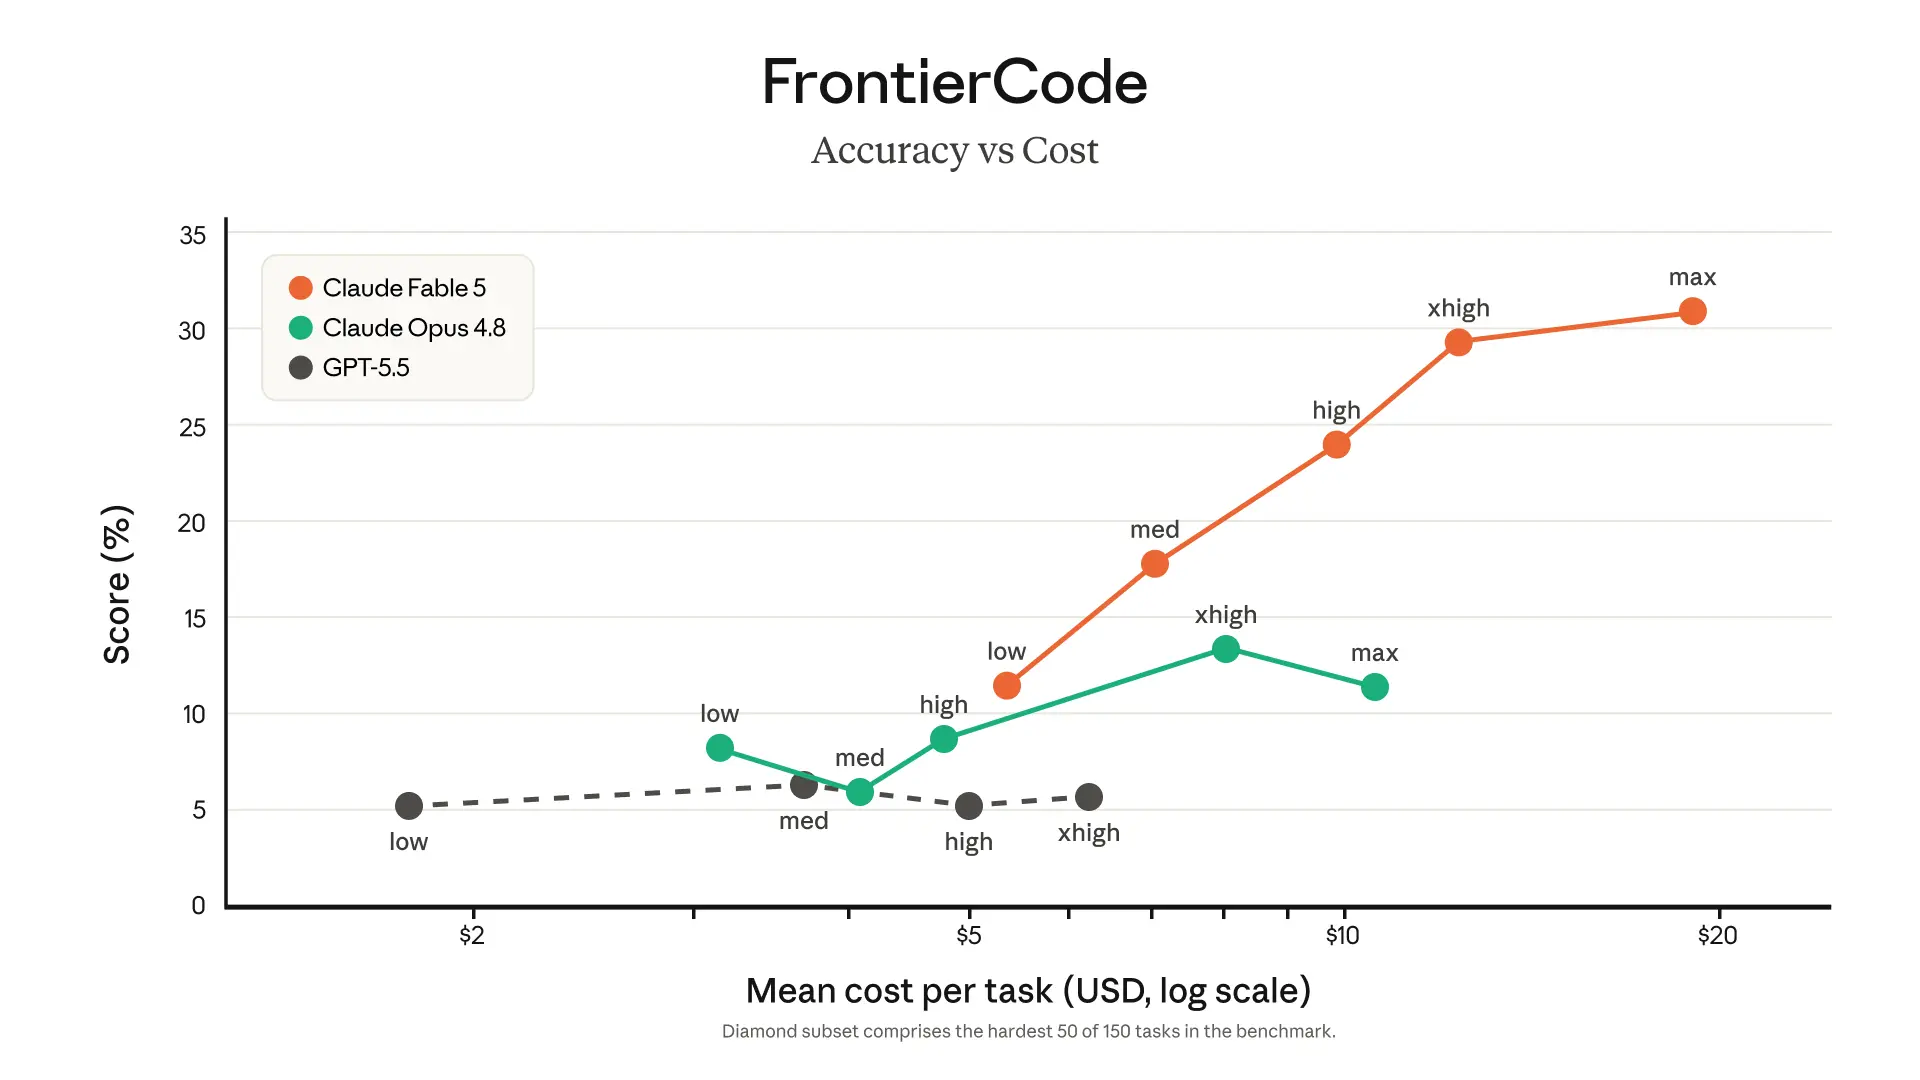
Mythos 5 può lavorare in autonomia su codebase di grandi dimensioni più a lungo di qualsiasi precedente modello Claude. Stripe ha riportato che il modello ha compresso mesi di lavoro di ingegneria in giorni, completando una migrazione a livello di codebase in un codebase Ruby da 50 milioni di righe in un solo giorno. Su FrontierCode (Diamond), ottiene il punteggio più alto tra i modelli d'avanguardia anche a sforzo medio.
Per il lavoro di sicurezza, Mythos 5 estende le capacità che hanno reso Mythos Preview prezioso per i partner di Project Glasswing. Quei partner hanno usato Mythos Preview per identificare oltre 10.000 vulnerabilità di sicurezza ad alta e critica gravità nei sistemi in produzione.
Il team interno di progettazione proteica di Anthropic ha usato Mythos 5 per accelerare la progettazione di farmaci di circa dieci volte. In un confronto controllato, Mythos 5 ha eguagliato o superato operatori umani esperti su 14 target proteici lungo l'intera pipeline:
Nove hanno prodotto forti candidati per la progettazione di farmaci attualmente in fase di indagine.
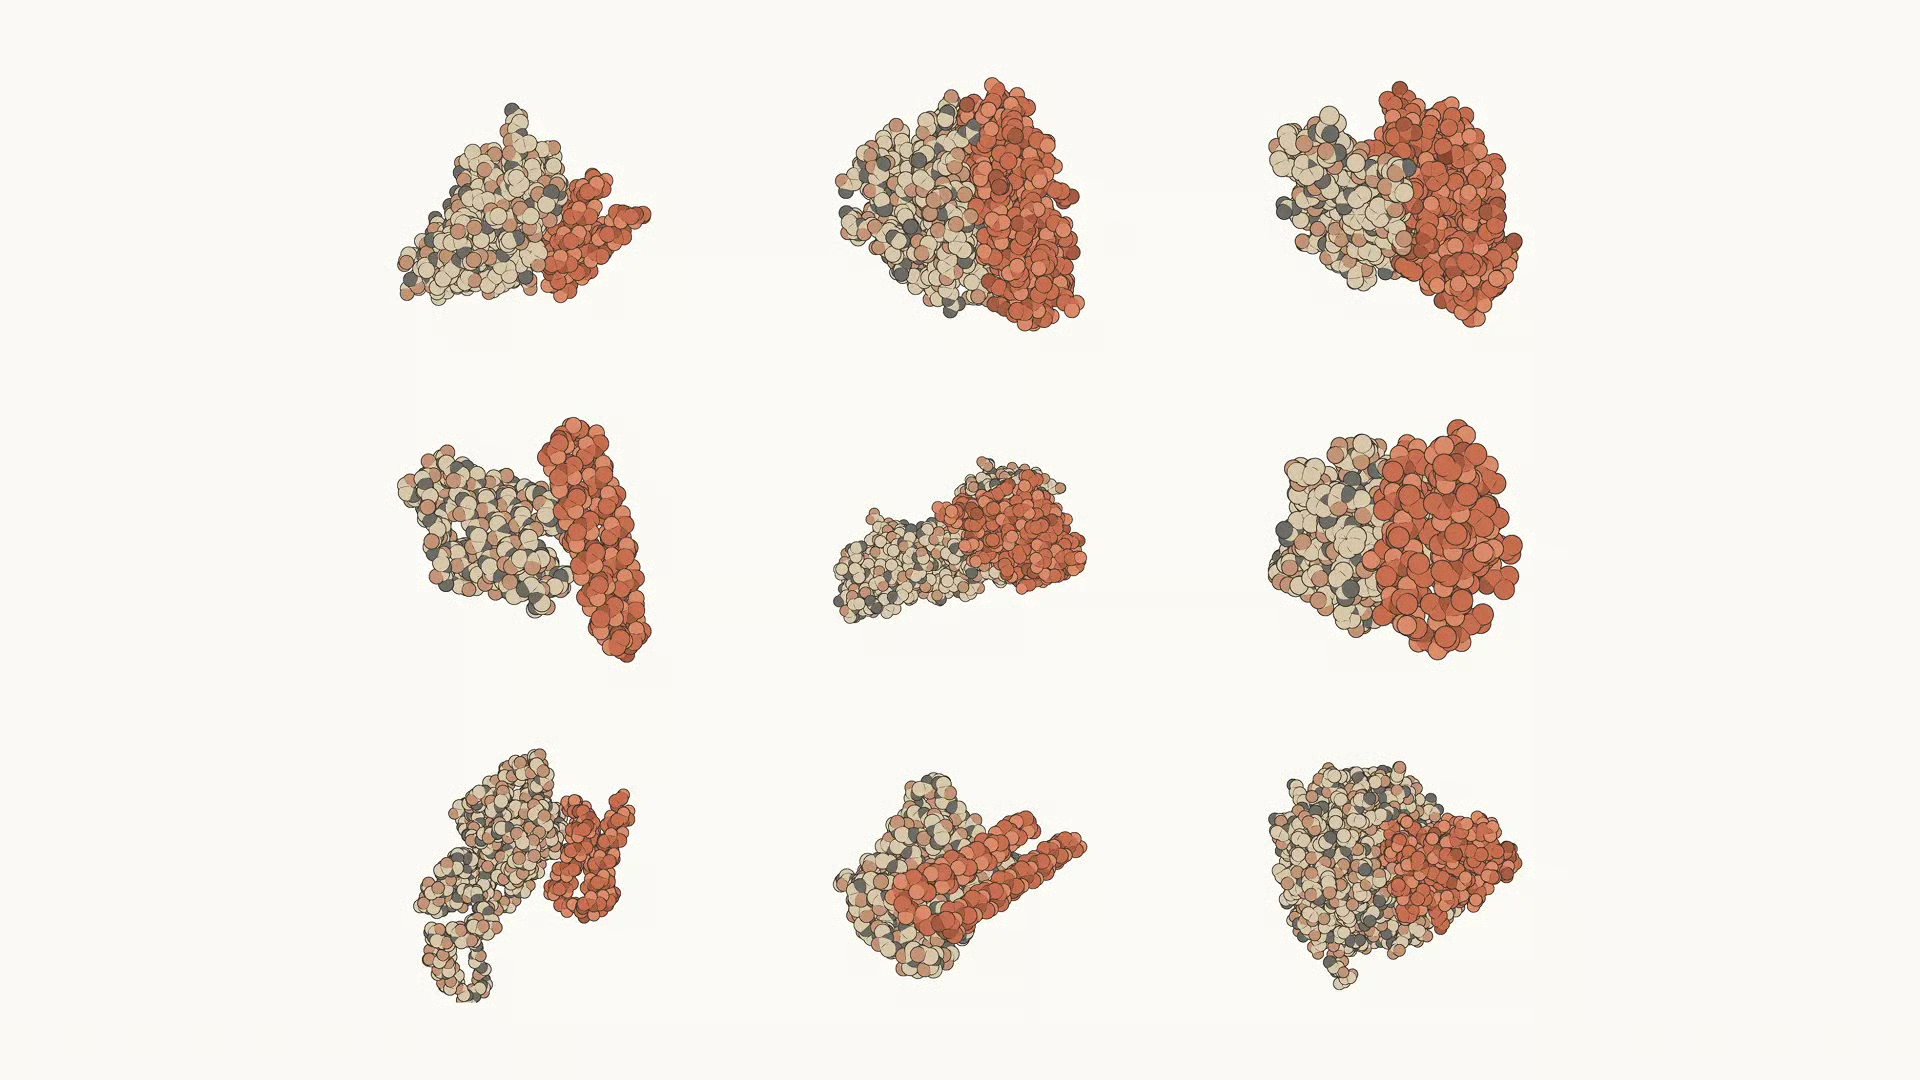
Mythos 5 è il primo modello di Anthropic a produrre in modo coerente ipotesi scientifiche inedite anziché riassumere la letteratura esistente. In confronti alla cieca, gli scienziati di Anthropic hanno preferito le sue ipotesi di biologia molecolare circa l'80% delle volte e diverse sono passate alla valutazione sperimentale. Un'ipotesi su un nuovo meccanismo proteico di E. coli è stata corroborata in modo indipendente da un laboratorio che lavorava sullo stesso problema.
Mythos 5 ha condotto nuova ricerca genomica per oltre una settimana di lavoro in gran parte autonomo, assemblando dati a singola cella per milioni di cellule in 138 specie animali e addestrando un modello ML personalizzato per identificare tipi cellulari equivalenti tra organismi lontanamente correlati. Il modello addestrato ha superato un modello recentemente pubblicato su Science nonostante fosse 100 volte più piccolo.
Mythos 5 ottiene il 93,2% su CharXiv Reasoning con strumenti e può estrarre numeri precisi da figure scientifiche dettagliate o ricostruire un'app web partendo solo da screenshot. Nei compiti a lungo contesto, fornire a Mythos 5 una memoria basata su file ha migliorato le sue prestazioni tre volte più di quanto lo stesso setup abbia migliorato Opus 4.8, e ha raggiunto l'atto finale di Slay the Spire tre volte più spesso.
Mythos 5 guida o è a pari merito in quasi tutti i benchmark testati da Anthropic, con vantaggi su Opus 4.8 coerenti tra le categorie, non concentrati in un'area sola. La tabella di confronto lo mette a confronto con Claude Mythos Preview, Claude Opus 4.8, GPT 5.5 e Gemini 3.1 Pro.
| Categoria | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Agentic coding | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
| Agentic coding | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| Lavoro di conoscenza | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Lavoro di conoscenza con visione | GDP.pdf | 29.8% (no tools) | — | 22.5% (no tools) | 24.9% (no tools) | 16.7% (no tools) |
| Ragionamento spaziale | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| Uso di strumenti | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| Uso del computer | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| Legale | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| Ragionamento multidisciplinare | Humanity's Last Exam (no tools) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| Ragionamento multidisciplinare | Humanity's Last Exam (with tools) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| Biologia | BioMysteryBench (hard) | 46.1%* | 29.6% | 40.0% | — | — |
| Biologia | BioMysteryBench (human solved) | 83.9%* | 82.6% | 80.4% | — | — |
| Agentic coding | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| Cybersecurity | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| Salute | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
Anthropic riporta insieme i punteggi di Mythos 5 e Fable 5, notando che nella maggior parte dei casi rientrano in un intervallo di 1–3 punti percentuali. I benchmark contrassegnati da asterisco (*) mostrano un divario maggiore perché i classificatori di sicurezza di Fable 5 instradano le query sensibili verso Opus 4.8; su quei benchmark, Fable 5 si comporta più vicino alla classe Opus.
Su SWE-Bench Pro, Mythos 5 ottiene l'80,3%, contro il 77,8% di Mythos Preview, il 69,2% di Opus 4.8, il 58,6% di GPT 5.5 e il 54,2% di Gemini 3.1 Pro. L'11 punti di vantaggio su Opus 4.8 è sostanziale su un benchmark progettato per resistere alla fuoriuscita della verità a terra.
Per codice agentico di alta qualità e manutenibile, misurato da FrontierCode (Diamond), la separazione è ancora più netta. Mythos 5 ottiene il 29,3% al livello di sforzo xhigh, rispetto al 13,4% di Opus 4.8 e al 5,7% di GPT 5.5.
Per il lavoro da terminale, Mythos 5 riporta la corona ad Anthropic da OpenAI: Mythos 5 ottiene l'88,0%* su Terminal-Bench 2.1, rispetto all'82,7% di Opus 4.8, all'83,4% di GPT 5.5 (Codex CLI) e al 70,7% di Gemini 3.1 Pro (con Gemini CLI).
GDPval-AA misura le prestazioni nel lavoro di conoscenza su una scala numerica. Mythos 5 ottiene 1932, rispetto a 1890 per Opus 4.8, 1769 per GPT 5.5 e 1314 per Gemini 3.1 Pro.
Questo divario aumenta per il lavoro di conoscenza su documenti PDF senza accesso a strumenti. Mythos 5 ottiene il 29,8% su GDPpdf, contro il 22,5% di Opus 4.8, il 24,9% di GPT 5.5 e il 16,7% di Gemini 3.1 Pro.
Humanity's Last Exam (HLE) testa il ragionamento a livello di laurea magistrale in scienze, matematica e discipline umanistiche. Mythos 5 ottiene il 59,0%* senza strumenti e il 64,5%* con strumenti. Mythos Preview ottiene rispettivamente il 56,8% e il 64,7%—praticamente a pari con strumenti ma indietro di 2 punti senza. La distanza da Opus 4.8 è già significativa (49,8% senza, 57,9% con), ma è ancora maggiore rispetto ai modelli concorrenti di punta (GPT 5.5: 41,4% e 52,2%, Gemini 3.1 Pro: 44,4% e 51,4%).
Il divario tra Mythos 5 e il resto del campo è più evidente nella condizione senza strumenti, dove guida Opus 4.8 di oltre 9 punti. Si tratta di punteggi con asterisco, quindi Fable 5 rende un po' meno a causa dei suoi classificatori di sicurezza.
Su OSWorld-Verified, che testa la capacità del modello di completare attività su un'interfaccia di un computer reale, Mythos 5 ottiene l'85,0%. Mythos Preview lo supera di poco con l'85,4%, rendendolo l'unico benchmark in cui Mythos Preview è in testa. Opus 4.8 è molto vicino (83,4%), mentre i concorrenti restano un po' indietro. GPT 5.5 ottiene il 78,7% e Gemini 3.1 Pro il 76,2%.
AutomationBench misura le capacità di uso degli strumenti. Mythos 5 ottiene il 17,4%, rispetto al 15,5% di Opus 4.8, al 12,9% di GPT 5.5 e al 9,6% di Gemini 3.1 Pro. I valori assoluti bassi su tutta la linea suggeriscono che l'uso degli strumenti resta un problema difficile per tutti i modelli d'avanguardia.
Il ragionamento spaziale è un'area in cui il vantaggio di Mythos 5 è maggiore. Ottiene il 38,6% in Blueprint-Bench 2, più del doppio rispetto al 14,5% di Opus 4.8. GPT 5.5 è più vicino al 36,2% e Gemini 3.1 Pro ottiene il 26,5%.
Sono le due aree che probabilmente hanno ricevuto più attenzione nelle note di rilascio, e i risultati spiegano il perché.
ExploitBench misura la frazione di exploit che il modello può riprodurre con successo (Cap%). Mythos 5 ottiene il 78,0%*, che è un miglioramento significativo anche rispetto a Mythos Preview (69,0%) e un aumento drastico rispetto al 40,0% di Opus 4.8 e al 34,0% di GPT 5.5.
Il divario di 38 punti su Opus 4.8 è il più grande vantaggio su un singolo benchmark nella tabella di confronto, e spiega perché esistono le salvaguardie cyber per Fable 5. Il red teaming esterno di Anthropic non ha trovato jailbreak universali su compiti agentici di lunga durata, sebbene l'UK AISI abbia fatto progressi verso uno in una finestra di test iniziale.
BioMysteryBench testa il ragionamento biologico su due livelli di difficoltà. Sul sottoinsieme difficile, Mythos 5 ottiene il 46,1%*, rispetto al 29,6% di Mythos Preview e al 40,0% di Opus 4.8. Sul sottoinsieme risolto da umani, Mythos 5 ottiene l'83,9%*, Mythos Preview l'82,6% e Opus 4.8 l'80,4%. GPT 5.5 e Gemini 3.1 Pro non hanno punteggi riportati su nessuno dei due sottoinsiemi.
Come per ExploitBench, i punteggi di Fable 5 sono più vicini a Opus 4.8 a causa dei classificatori di sicurezza legati alla biologia.
Claude Mythos 5 mostra una forza notevole in due domini professionali ad alto rischio in cui accuratezza e qualità del ragionamento hanno conseguenze nel mondo reale: medicina e diritto.
In HealthBench Professional, Mythos 5 ottiene il 66,0%*, poco sopra il 64,7% di Mythos Preview. Opus 4.8 ottiene il 56,9% e GPT 5.5 il 51,8%.
Nel Legal Agent Benchmark, Mythos 5 ottiene il 13,3%, rispetto al 10,4% di Opus 4.8 e al solo 2,1% di GPT 5.5. I punteggi assoluti sono bassi, ma la distanza tra Mythos 5 e GPT 5.5 o Gemini è netta. Il ragionamento legale resta un fronte impegnativo per tutti i modelli.
Claude Mythos 5 costa 10 $ per milione di token in input e 50 $ per milione di token in output. È meno della metà del prezzo di Claude Mythos Preview (25$/125$), il che rende l'aggiornamento semplice per gli attuali partner Glasswing. Gli sviluppatori possono accedere al modello tramite l'API di Claude usando l'ID modello claude-mythos-5.
L'accesso è attualmente limitato a due gruppi:
Anthropic prevede di espandere entrambi i programmi nel tempo.
È previsto un programma di accesso fidato più ampio per consentire alle organizzazioni di cybersecurity di candidarsi in modo più sistematico, in consultazione con il governo degli Stati Uniti. Anthropic non ha annunciato una tempistica per la disponibilità generale. Per la maggior parte degli sviluppatori, oggi Claude Fable 5 è l'opzione pratica, con lo stesso modello di base e accesso tramite abbonamenti e piani API standard.
Un dettaglio operativo da segnalare: Anthropic ha introdotto una policy di conservazione dei dati di 30 giorni per tutto il traffico dei modelli di classe Mythos. I dati non vengono usati per l'addestramento e vengono eliminati dopo 30 giorni nella quasi totalità dei casi, ma sono conservati per il monitoraggio della sicurezza. Se stai costruendo su Mythos 5 con dati sensibili, consulta la documentazione di supporto di Anthropic su questa policy prima del deployment.
Claude Mythos 5 è la dichiarazione più chiara di Anthropic che l'azienda fa sul serio nel distribuire IA d'avanguardia in contesti professionali ad alto rischio, e i risultati lo confermano.
Il divario su SWE-bench Pro (80,3% vs 69,2%), su Terminal-Bench 2.1 (88,0% vs 82,7%) e su ExploitBench (78,0% vs 40,0%) indicano tutti un modello che gestisce i compiti più difficili in modo più affidabile di qualsiasi altra cosa disponibile.
Il modello di accesso ristretto è un approccio ragionevole dato il rischio di doppio uso, e i punteggi su ExploitBench sostengono in modo convincente che gli strumenti di sicurezza offensiva più potenti non dovrebbero essere pubblici. La domanda più difficile è se Anthropic riuscirà ad espandere abbastanza rapidamente il programma di accesso fidato da essere utile alle comunità più ampie della sicurezza e della ricerca biomedica prima che i concorrenti colmino il divario.
Per le organizzazioni idonee, l'aggiornamento da Mythos Preview è semplice e costa meno della metà.
I migliori corsi di IA
Programma
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



