

Corso
Lavorare con DeepSeek in Python
3 ore
1.4K
Pratica and corso your progress.
Continua Con GoogleA gennaio 2025, DeepSeek ha rilasciato DeepSeek-R1, il passo successivo nel loro lavoro sui modelli di ragionamento. È un aggiornamento rispetto al precedente DeepSeek-R1-Lite-Preview e mostra che puntano seriamente a competere con o1 di OpenAI.
Da allora, DeepSeek ha continuato a migliorare il modello. A maggio 2025, hanno rilasciato DeepSeek-R1-0528, una versione aggiornata con prestazioni migliori nei benchmark, meno allucinazioni e nuove funzionalità come il function calling e il supporto per l’output JSON.
Anche se DeepSeek potrebbe essere leggermente indietro rispetto ai concorrenti in alcune aree, la sua natura open source e i prezzi significativamente più bassi lo rendono un’opzione interessante per la community AI.
In questo blog, analizzerò le funzionalità chiave di DeepSeek-R1, il processo di sviluppo, i modelli distillati, come accedervi, i prezzi e come si confronta con i modelli di OpenAI.
Ho scritto questo articolo il giorno in cui è stato rilasciato DeepSeek-R1, ma ora l’ho aggiornato con una nuova sezione sulle conseguenze del lancio—come ha influenzato il mercato azionario, l’economia dell’AI (incluso il paradosso di Jevons e la commoditizzazione dei modelli AI) e l’accusa di OpenAI secondo cui DeepSeek avrebbe distillato i loro modelli. Ho anche aggiunto una sezione aggiornata sul nuovo DeepSeek-R1-0528.
Teniamo i nostri lettori aggiornati sulle ultime novità dell’AI con The Median, la nostra newsletter gratuita del venerdì che spiega le storie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
DeepSeek-R1 è un modello di ragionamento open source sviluppato da DeepSeek, un'azienda cinese di AI, per affrontare compiti che richiedono inferenza logica, risoluzione di problemi matematici e decisioni in tempo reale.
Ciò che distingue i modelli di ragionamento come DeepSeek-R1 e o1 di OpenAI dai modelli linguistici tradizionali è la loro capacità di mostrare come sono arrivati a una conclusione.
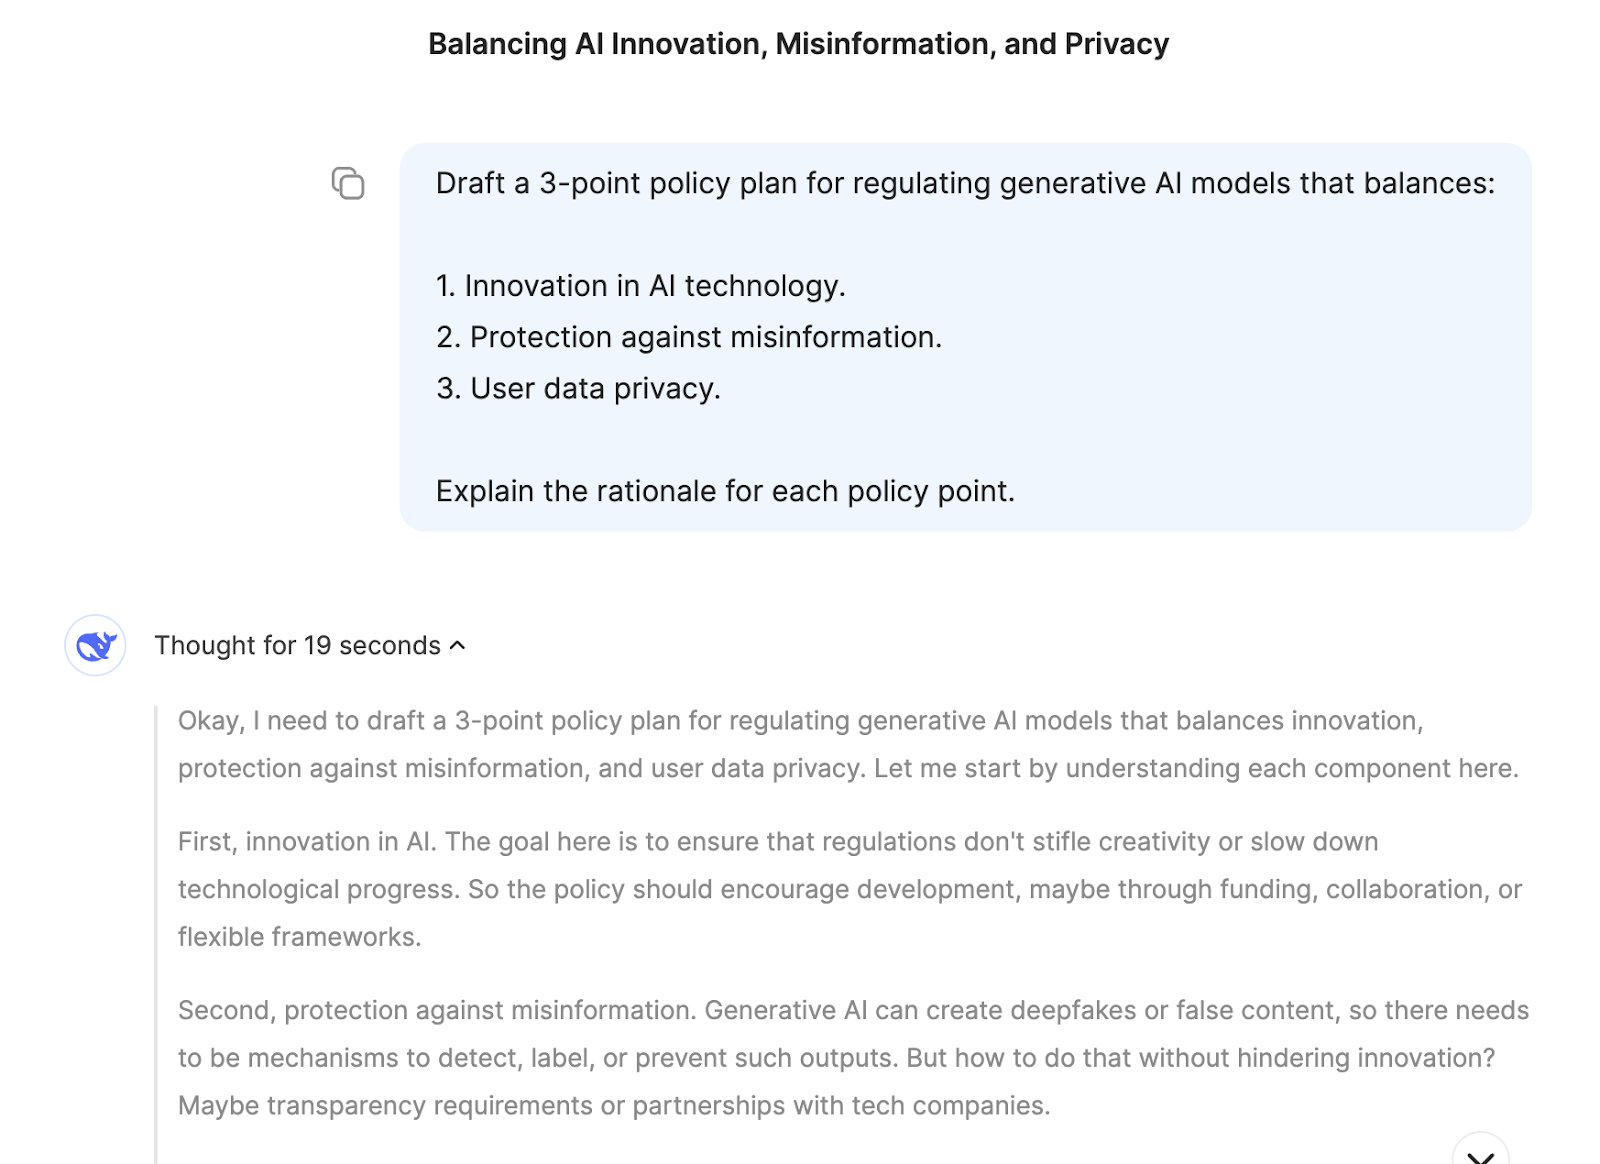
Con DeepSeek-R1 puoi seguire la sua logica, rendendo più facile capire e, se necessario, mettere in discussione l’output. Questa capacità dà ai modelli di ragionamento un vantaggio nei campi in cui i risultati devono essere spiegabili, come la ricerca o le decisioni complesse.
Ciò che rende DeepSeek-R1 particolarmente competitivo e interessante è la sua natura open source. A differenza dei modelli proprietari, l’open source consente a sviluppatori e ricercatori di esplorarlo, modificarlo e distribuirlo entro determinati limiti tecnici, come i requisiti di risorse.
In questa sezione ti spiego come è stato sviluppato DeepSeek-R1, partendo dal suo predecessore, DeepSeek-R1-Zero.
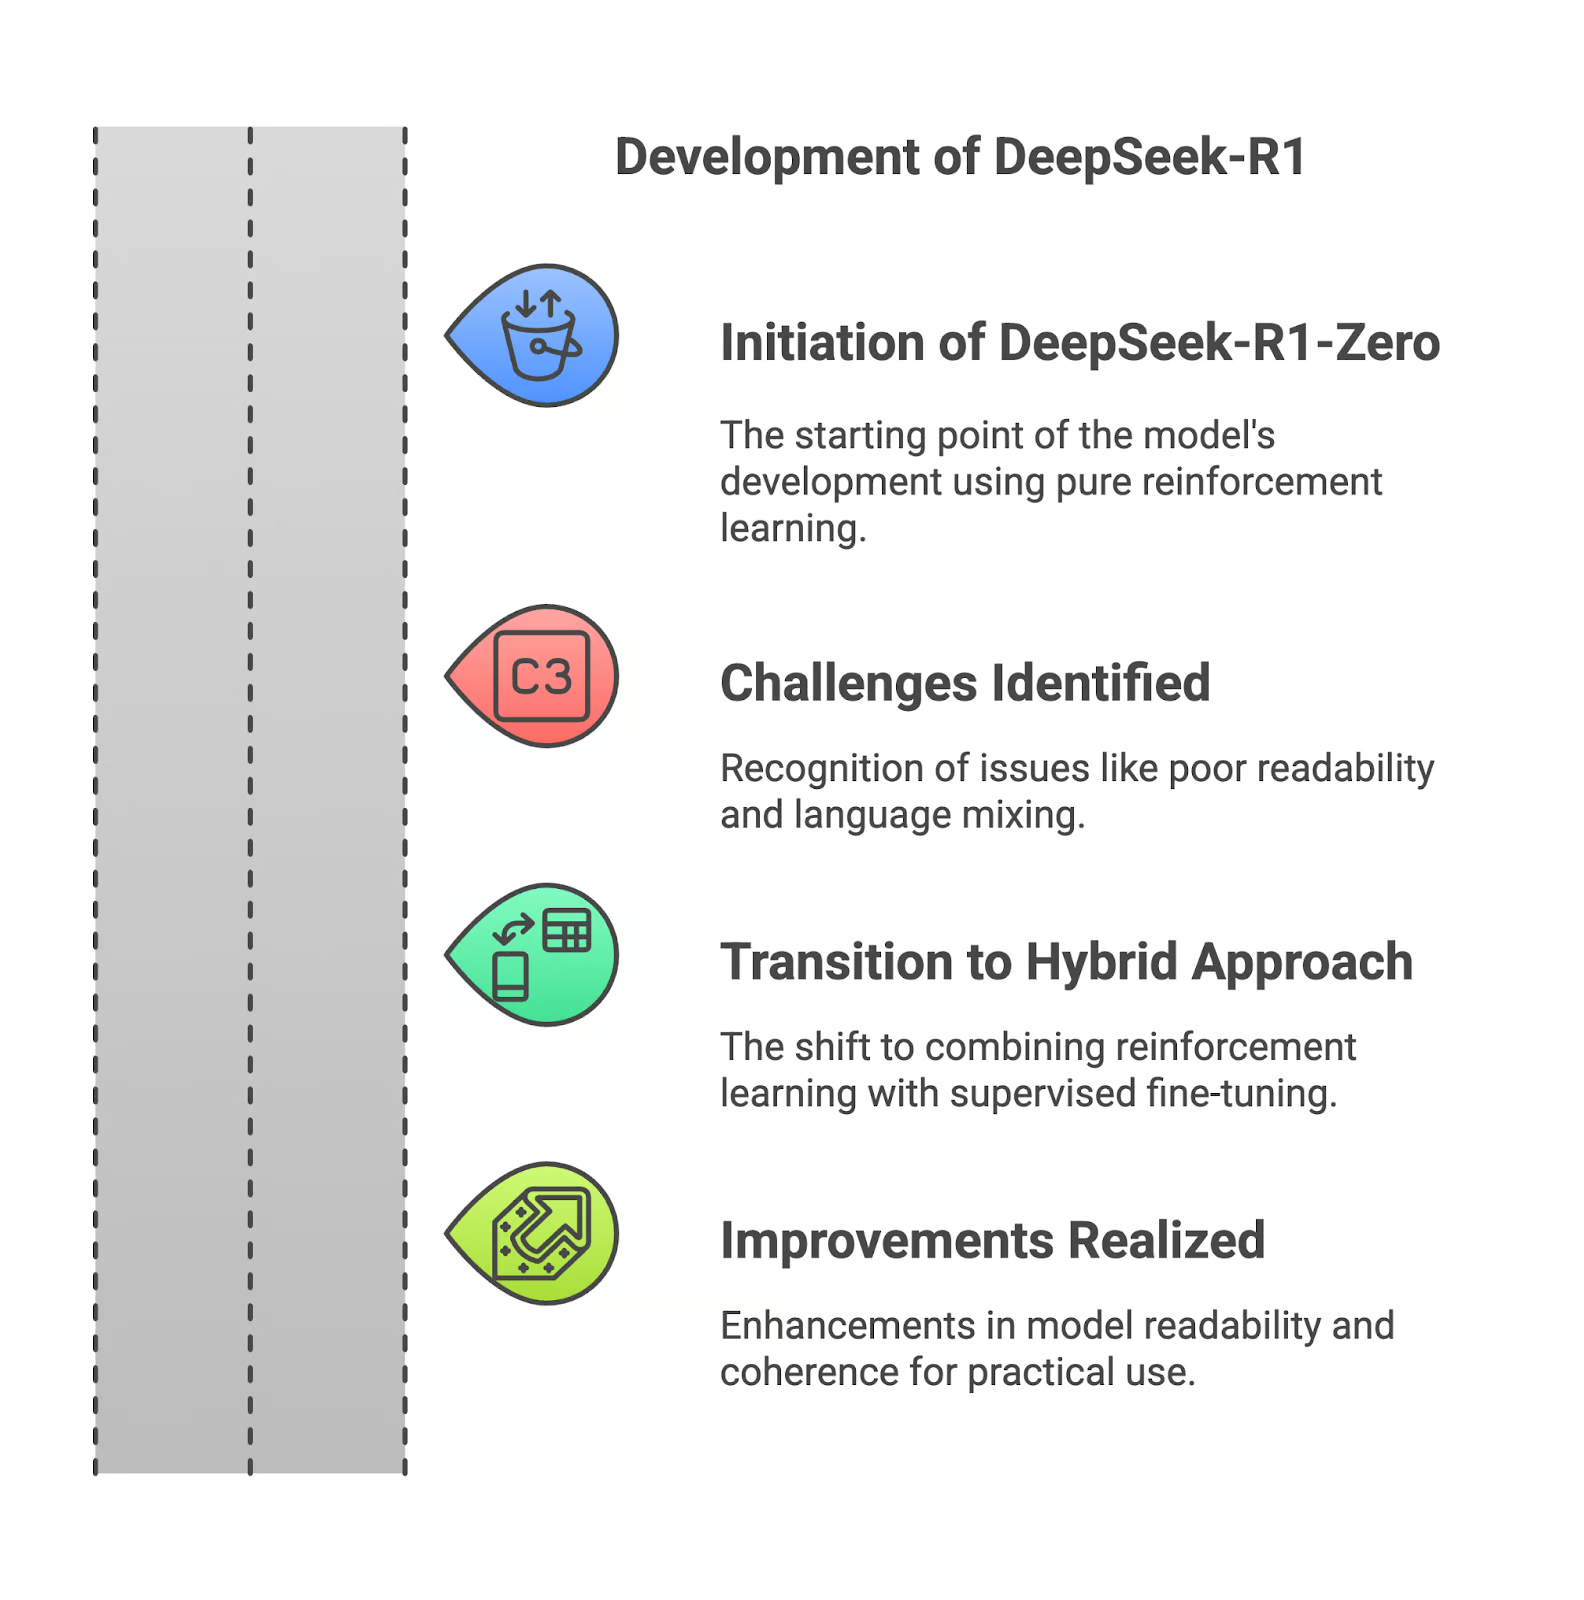
DeepSeek-R1 è iniziato con R1-Zero, un modello addestrato interamente tramite reinforcement learning. Sebbene questo approccio gli abbia consentito di sviluppare forti capacità di ragionamento, presentava grandi svantaggi. Gli output erano spesso difficili da leggere e talvolta il modello mescolava lingue nelle risposte. Queste limitazioni rendevano R1-Zero meno pratico per applicazioni reali.
L’affidarsi al reinforcement learning puro generava output logicamente validi ma poco strutturati. Senza la guida di dati supervisionati, il modello faticava a comunicare efficacemente il proprio ragionamento. Questo era un ostacolo per chi aveva bisogno di chiarezza e precisione nei risultati.
Per affrontare questi problemi, DeepSeek ha modificato lo sviluppo di R1 combinando reinforcement learning e fine-tuning supervisionato. Questo approccio ibrido ha incorporato dataset curati, migliorando leggibilità e coerenza del modello. Problemi come la commistione di lingue e il ragionamento frammentato sono stati ridotti in modo significativo, rendendo il modello più adatto all’uso pratico.
Se vuoi approfondire lo sviluppo di DeepSeek-R1, ti consiglio di leggere il paper di rilascio.
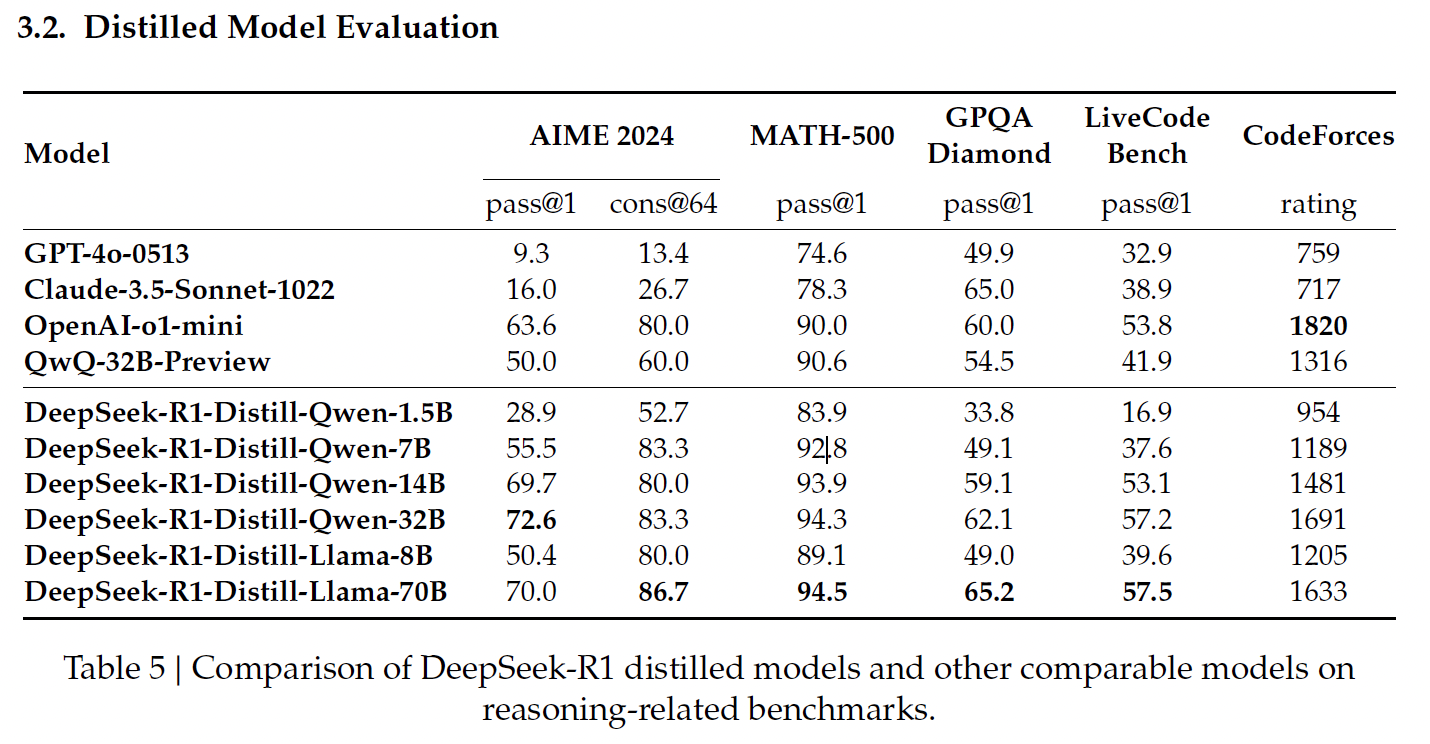
La distillazione nell’AI è il processo di creazione di modelli più piccoli ed efficienti a partire da modelli più grandi, preservandone gran parte del potere di ragionamento e riducendo al contempo le esigenze computazionali. DeepSeek ha applicato questa tecnica per creare una suite di modelli distillati da R1, usando le architetture Qwen e Llama.
Fonte: paper di rilascio di DeepSeek
I modelli distillati di DeepSeek basati su Qwen puntano su efficienza e scalabilità, offrendo un equilibrio tra prestazioni e requisiti computazionali.
È il modello distillato più piccolo, che raggiunge l’83,9% su MATH-500. MATH-500 testa la capacità di risolvere problemi matematici di livello liceale con ragionamento logico e soluzioni a più passaggi. Questo risultato mostra che il modello gestisce bene i compiti matematici di base nonostante le dimensioni compatte.
Tuttavia, le sue prestazioni calano significativamente su LiveCodeBench (16,9%), un benchmark progettato per valutare le abilità di coding, evidenziando capacità limitate nei compiti di programmazione.
Qwen-7B brilla su MATH-500, con un punteggio del 92,8%, a dimostrazione di solide capacità di ragionamento matematico. Va abbastanza bene anche su GPQA Diamond (49,1%), che valuta il question answering fattuale, indicando un buon equilibrio tra ragionamento matematico e fattuale.
Tuttavia, i risultati su LiveCodeBench (37,6%) e CodeForces (rating 1189) suggeriscono che è meno adatto a compiti di coding complessi.
Questo modello va bene su MATH-500 (93,9%), riflettendo la capacità di gestire problemi matematici complessi. Il 59,1% su GPQA Diamond indica inoltre competenza nel ragionamento fattuale.
Le prestazioni su LiveCodeBench (53,1%) e CodeForces (rating 1481) mostrano margini di crescita nel coding e nel ragionamento specifico per la programmazione.
Il più grande modello basato su Qwen ottiene il punteggio più alto tra i suoi pari su AIME 2024 (72,6%), che valuta il ragionamento matematico avanzato a più passaggi. Eccelle anche su MATH-500 (94,3%) e GPQA Diamond (62,1%), dimostrando forza sia nel ragionamento matematico che fattuale.
I risultati su LiveCodeBench (57,2%) e CodeForces (rating 1691) suggeriscono versatilità, ma non un'ottimizzazione per i compiti di programmazione rispetto a modelli specializzati nel coding.
I modelli distillati di DeepSeek basati su Llama danno priorità ad alte prestazioni e capacità di ragionamento avanzate, eccellendo in particolare nei compiti che richiedono precisione matematica e fattuale.
Llama-8B si comporta bene su MATH-500 (89,1%) e discretamente su GPQA Diamond (49,0%), a indicare la capacità di gestire il ragionamento matematico e fattuale. Tuttavia, ottiene punteggi più bassi su benchmark di coding come LiveCodeBench (39,6%) e CodeForces (rating 1205), evidenziando limiti nei compiti di programmazione rispetto ai modelli basati su Qwen.
Il modello distillato più grande, Llama-70B, offre prestazioni di livello top su MATH-500 (94,5%), il migliore tra tutti i modelli distillati, e raggiunge un solido 86,7% su AIME 2024, rendendolo un'ottima scelta per il ragionamento matematico avanzato.
Si comporta bene anche su LiveCodeBench (57,5%) e CodeForces (rating 1633), suggerendo maggiore competenza nei compiti di coding rispetto alla maggior parte degli altri modelli. In questo ambito, è paragonabile a o1-mini di OpenAI o GPT-4o.
Puoi accedere a DeepSeek-R1 tramite due metodi principali: la piattaforma web DeepSeek Chat e la DeepSeek API, così da scegliere l’opzione più adatta alle tue esigenze.
La piattaforma DeepSeek Chat offre un modo semplice per interagire con DeepSeek-R1. Per accedervi, puoi andare direttamente alla pagina chat o cliccare Start Now nella home page.
Dopo la registrazione, puoi selezionare la modalità “Deep Think” per provare le capacità di ragionamento passo passo di DeepSeek-R1.
Per integrare DeepSeek-R1 nelle tue applicazioni, l’API di DeepSeek offre accesso programmabile.
Per iniziare, dovrai ottenere una chiave API registrandoti sulla DeepSeek Platform.
L’API è compatibile con il formato di OpenAI, rendendo l’integrazione semplice se hai familiarità con gli strumenti di OpenAI. Puoi trovare ulteriori istruzioni nella documentazione dell’API di DeepSeek.
A maggio 2025, la piattaforma chat è gratuita da usare con il modello R1.
L’API offre due modelli—deepseek-chat (DeepSeek-V3) e deepseek-reasoner (DeepSeek-R1)—con la seguente struttura di prezzo (per 1M di token):
|
MODELLO |
LUNGHEZZA CONTESTO |
MAX COT TOKEN |
MAX OUTPUT TOKEN |
1M TOKEN PREZZO INPUT (CACHE HIT) |
1M TOKEN PREZZO INPUT (CACHE MISS) |
1M TOKEN PREZZO OUTPUT |
|
deepseek-chat |
64K |
- |
8K |
$0.07 $0.014 |
$0.27 $0.14 |
$1.10 $0.28 |
|
deepseek-reasoner |
64K |
32K |
8K |
$0.14 |
$0.55 |
$2.19 |
Fonte: pagina prezzi di DeepSeek
Per avere le informazioni sui prezzi più aggiornate e capire come calcolare il costo del ragionamento CoT (Chain-of-Thought), visita la pagina prezzi di DeepSeek.
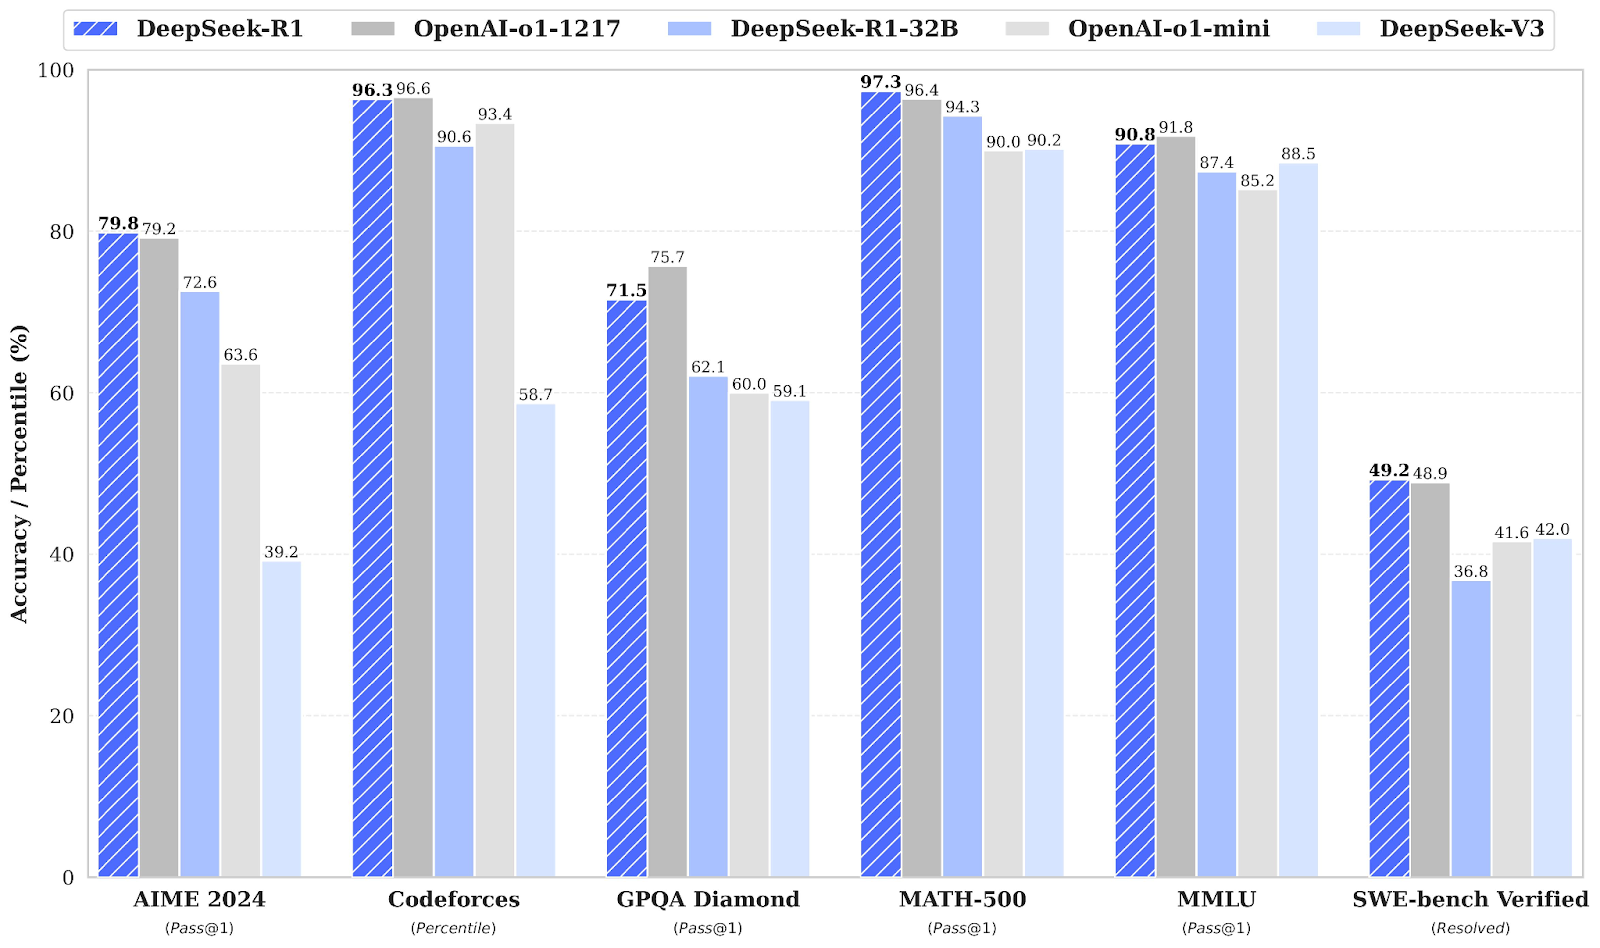
DeepSeek-R1 compete direttamente con o1 di OpenAI su diversi benchmark, spesso eguagliando o superando o1 di OpenAI.
Fonte: paper di rilascio di DeepSeek
Nei benchmark di matematica, DeepSeek-R1 mostra ottime prestazioni. Su AIME 2024, che valuta il ragionamento matematico avanzato a più passaggi, DeepSeek-R1 ottiene il 79,8%, leggermente avanti a o1-1217 di OpenAI al 79,2%.
Su MATH-500, DeepSeek-R1 prende il comando con un notevole 97,3%, superando di poco o1-1217 di OpenAI al 96,4%. Questo benchmark mette alla prova i modelli con vari problemi matematici di livello liceale che richiedono ragionamento dettagliato.
Il benchmark Codeforces valuta le capacità di coding e di ragionamento algoritmico di un modello, rappresentate come percentile rispetto ai partecipanti umani. OpenAI o1-1217 guida con il 96,6%, mentre DeepSeek-R1 raggiunge un competitivo 96,3%, con una differenza minima.
Il benchmark SWE-bench Verified valuta il ragionamento in compiti di ingegneria del software. DeepSeek-R1 si comporta molto bene con un punteggio del 49,2%, leggermente avanti al 48,9% di OpenAI o1-1217. Questo risultato posiziona DeepSeek-R1 come un forte contendente in compiti specializzati di ragionamento come la verifica del software.
Per il ragionamento fattuale, GPQA Diamond misura la capacità di rispondere a domande di conoscenza generale. DeepSeek-R1 ottiene il 71,5%, dietro a OpenAI o1-1217 che raggiunge il 75,7%. Questo risultato evidenzia un leggero vantaggio di o1-1217 nei compiti di ragionamento fattuale.
Su MMLU, un benchmark che copre varie discipline e valuta la comprensione linguistica multitask, o1-1217 di OpenAI supera di poco DeepSeek-R1, con il 91,8% contro il 90,8% di DeepSeek-R1.
Il rilascio di DeepSeek-R1 ha avuto conseguenze di ampia portata, influenzando i mercati azionari, rimodellando l’economia dell’AI e generando controversie sulle pratiche di sviluppo dei modelli.
L’introduzione da parte di DeepSeek del modello R1, che offre capacità AI avanzate a una frazione del costo dei concorrenti, ha portato a un calo sostanziale dei prezzi delle azioni delle principali aziende tech statunitensi.
Nvidia, per esempio, ha registrato un calo di quasi il 18% del valore azionario, pari a una perdita di circa 600 miliardi di dollari di capitalizzazione. Il calo è stato guidato dalle preoccupazioni degli investitori che i modelli AI efficienti di DeepSeek possano ridurre la domanda di hardware ad alte prestazioni tradizionalmente fornito da aziende come Nvidia.
Modelli a pesi aperti come DeepSeek-R1 stanno abbassando i costi e costringendo le aziende di AI a ripensare le strategie di prezzo. Questo è evidente nel netto contrasto dei prezzi:
Alcuni leader del settore hanno richiamato il paradosso di Jevons—l’idea che all’aumentare dell’efficienza, il consumo complessivo possa crescere invece di diminuire. Il CEO di Microsoft Satya Nadella lo ha lasciato intendere, sostenendo che man mano che l’AI diventa più economica, la domanda esploderà.
Tuttavia, ho apprezzato questa analisi equilibrata dell’Economist, secondo cui un pieno effetto Jevons è molto raro e dipende dal fatto che il prezzo sia la principale barriera all’adozione. Con solo “il 5% delle aziende americane che attualmente utilizza l’AI e il 7% che prevede di adottarla”, l’effetto Jevons sarà probabilmente basso. Molte imprese trovano ancora l’integrazione dell’AI difficile o non necessaria.
Accanto al suo impatto dirompente, DeepSeek si è trovata anche al centro di una controversia. OpenAI ha accusato DeepSeek di distillare i suoi modelli—in sostanza estrarre conoscenza dai sistemi proprietari di OpenAI e replicarne le prestazioni in un modello più compatto ed efficiente.
Finora, OpenAI non ha fornito prove dirette di questa affermazione e, per molti, l’accusa sembra più una mossa strategica per rassicurare gli investitori in un panorama dell’AI in rapido cambiamento.
Il 28 maggio 2025, DeepSeek ha rilasciato una versione aggiornata del suo modello di ragionamento: DeepSeek-R1-0528. Questo aggiornamento introduce diversi miglioramenti chiave:
Nonostante queste aggiunte, non ci sono cambiamenti agli endpoint API—DeepSeek-R1-0528 è pienamente retrocompatibile. Gli sviluppatori possono continuare a usare la stessa interfaccia, con i vantaggi del nuovo modello.
Puoi provarlo sulla piattaforma DeepSeek Chat o esplorare i pesi open source su Hugging Face.
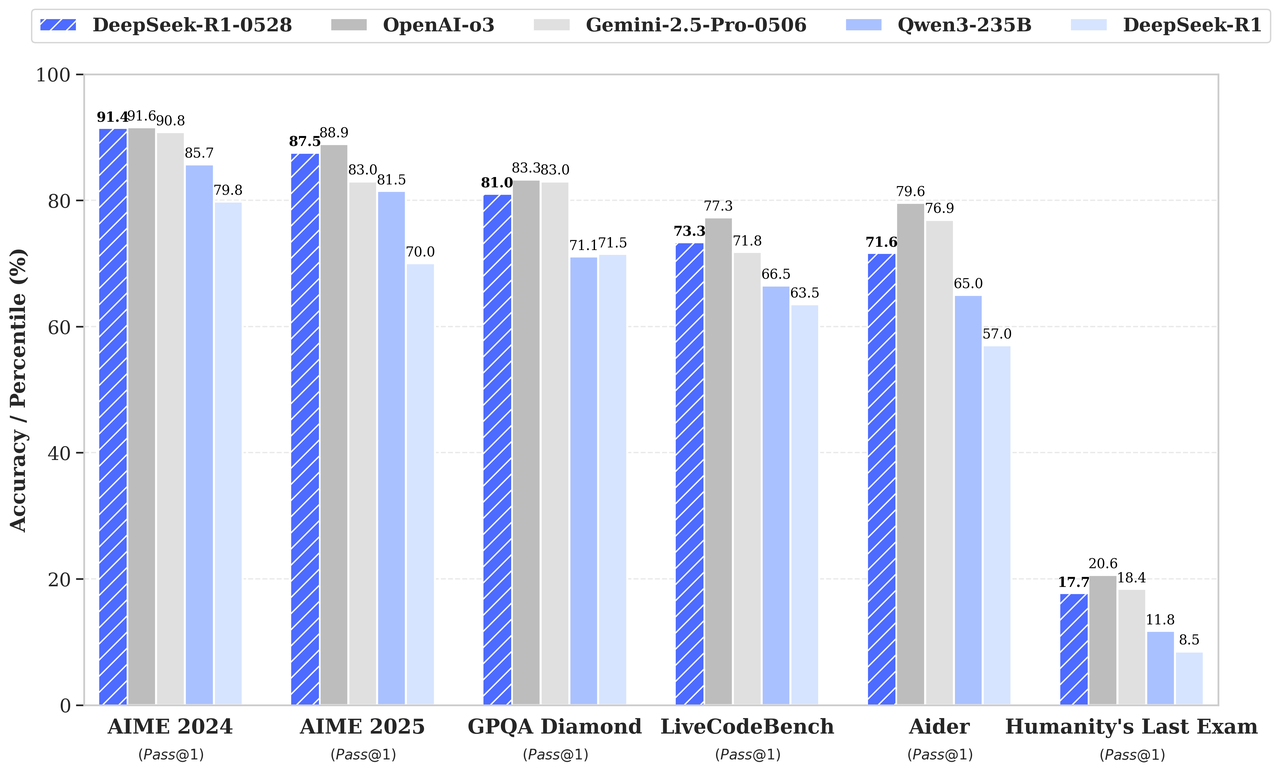
Secondo il grafico dei benchmark nell’annuncio di rilascio, DeepSeek-R1-0528 supera il suo predecessore e compete alla grande con o3 di OpenAI e Gemini 2.5 Pro:
Fonte: DeepSeek
DeepSeek-R1 è un forte concorrente nell’AI incentrata sul ragionamento, con prestazioni paragonabili a o1 di OpenAI. Anche se o1 di OpenAI potrebbe avere un leggero vantaggio nel coding e nel ragionamento fattuale, penso che la natura open source di DeepSeek-R1 e l’accesso conveniente lo rendano un’opzione molto attraente.
Impara l’AI con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



